
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
ChatGPT의 전두엽(장기기억 저장소)으로 각광받고 있는 Vector DB에 대해 알아보자
벡터 데이터베이스란?
벡터 데이터베이스는 방대한 양의 고차원 데이터를 벡터 형태로 최적화 하여 보관하고 쿼리하기 위해 특화된 DB
벡터는 서로 다른 특성이나 품질을 기반으로 개체를 설명하는 수학적 데이터 표현입니다.
각 벡터는 단어나 그림과 같은 단일 데이터 요소를 나타내며 여러 특성을 설명하는 값 모음으로 구성됩니다. 이러한 변수를 "기능" 또는 "치수"라고도 합니다.
예를 들어, 그림은 픽셀 값의 벡터로 표현될 수 있지만 전체 문장은 단어 임베딩의 벡터로 표현될 수 있습니다.
벡터 데이터베이스는 인덱싱 전략을 사용하여 특정 쿼리 벡터와 유사한 벡터를 쉽게 찾을 수 있습니다. 이는 기계 학습 과 같은 경우에 특히 유익합니다.
유사한 데이터 포인트를 발견하거나 제안을 생성하기 위해 유사성 검색이 자주 사용되기 때문입니다.
AI 어플리케이션들은 Vector Embeddings에 의존
임베딩은 AI 모델에 의해 생성되며, 많은 수의 속성/피쳐가 있어서 관리하기가 어려움
AI 및 ML에서 이 피쳐들은 패턴, 관계 및 기본 구조를 이해하는데 필수적인 데이터의 다양한 디멘젼들을 표현
벡터DB를 통해서 AI에 시맨틱 정보 검색, 장기 메모리 등의 고급 기능들을 구현 가능
임베딩 모델을 통해서 인덱싱할 콘텐츠의 벡터 임베딩을 생성
벡터 임베딩들을 벡터DB에 삽입.
임베딩이 어디에서 생성되었는지 오리지널 콘텐츠에 대한 레퍼런스를 포함
어플리케이션이 쿼리를 하면, 같은 임베딩 모델을 이용하여 쿼리에 대한 임베딩을 생성하고, 이 임베딩으로 DB를 검색해서 비슷한 벡터 임베딩을 찾음
이 임베딩들은 오리지널 콘텐츠에 연결되어 있음
벡터 데이터베이스의 내부 작동
벡터 데이터베이스는 다음과 같은 기술로 생성된 고차원 벡터를 저장하고 인덱싱하는 데 사용됩니다.
이러한 벡터는 임베딩 기술을 통해 중요한 정보를 유지하면서 저차원 공간으로 변환되는 복잡한 데이터 항목의 수치 표현입니다.
따라서 벡터 데이터베이스는 벡터 임베딩의 특정 구조를 수용하도록 구축되었으며 인덱싱 알고리즘을 사용하여 쿼리 벡터와의 유사성을 기반으로 벡터를 효과적으로 검색하고 검색합니다.
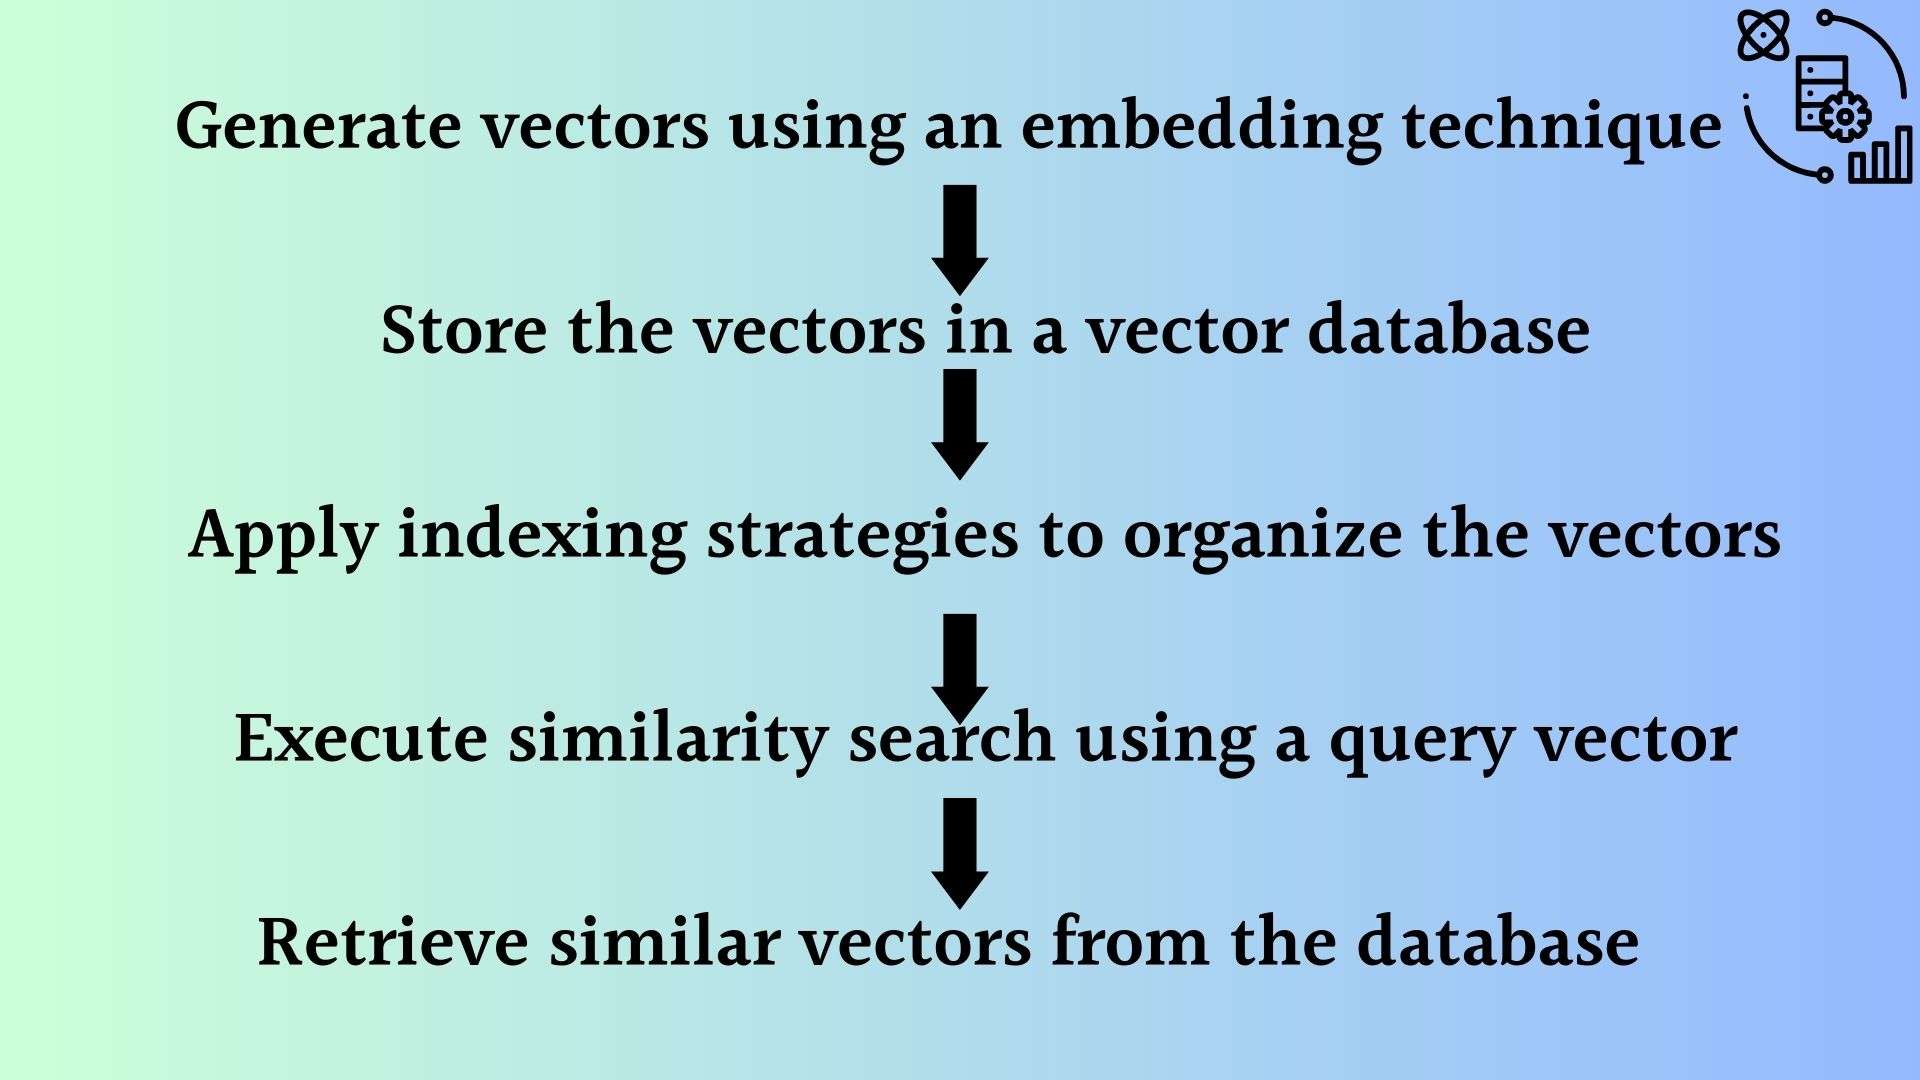

어떻게 작동하는가?
벡터 데이터베이스는 ANN(Approximate Nearest Neighbor) 검색에 모두 참여하는 서로 다른 알고리즘의 조합을 사용합니다.
이러한 알고리즘은 해싱, 양자화 또는 그래프 기반 검색을 통해 검색을 최적화합니다.
벡터 데이터베이스는 대략적인 결과를 제공
주요 트레이드 오프 : 정확도와 속도결과 정확도 - 쿼리 속도 반비례
벡터 데이터베이스에 대한 일반적인 파이프라인

Indexing: 벡터 데이터베이스는 PQ, LSH 또는 HNSW와 같은 알고리즘을 사용하여 벡터를 인덱싱합니다.
이 단계는 더 빠른 검색을 가능하게 하는 데이터 구조에 벡터를 매핑합니다.
Querying: 벡터 데이터베이스는 가장 가까운 이웃을 찾기 위해 인덱스 쿼리 벡터를 데이터 세트의 인덱스 벡터와 비교합니다.
(해당 인덱스에서 사용하는 유사성 메트릭 적용).
Post Processing: 경우에 따라 벡터 데이터베이스는 데이터 세트에서 가장 가까운 최종 이웃을 검색하고 사후 처리하여 최종 결과를 반환합니다.
이 단계에는 다른 유사성 척도를 사용하여 가장 가까운 이웃의 순위를 재지정하는 작업이 포함될 수 있음
벡터 인덱스 생성에서 사용하는 알고리즘
Random Projection
무작위 투영의 기본 아이디어는 무작위 투영 행렬을 사용하여 고차원 벡터를 저차원 공간에 투영하는 것입니다.
난수 행렬을 만듭니다. 행렬의 크기는 우리가 원하는 목표 저차원 값이 될 것입니다.
그런 다음 입력 벡터와 행렬의 내적을 계산하여 원래 벡터보다 차원이 적지만 유사성을 유지하는 투영 행렬을 생성합니다.

Product Quantization
벡터 임베딩과 같은 고차원 벡터에 대한 손실 압축 기술인 제품 양자화(PQ)입니다.
원본 벡터를 가져와서 더 작은 청크로 나누고 각 청크에 대한 대표 "코드"를 생성하여 각 청크의 표현을 단순화한 다음 유사성 작업에 중요한 정보를 잃지 않고 모든 청크를 다시 결합하는 것

Loclity-sensitive hashing
LSH(Locality-Sensitive Hashing)는 근사 최근접 이웃 검색 컨텍스트에서 인덱싱하는 기술입니다. 속도에 최적화되어 있으면서도 대략적이고 포괄적이지 않은 결과를 제공합니다.

Hierarchical Navigable Small World (HSNW)
HSNW는 트리의 각 노드가 벡터 세트를 나타내는 계층적 트리와 같은 구조를 생성합니다. 노드 사이의 모서리는 벡터 간의 유사성을 나타냅니다

유사성 측정
코사인 유사성
벡터 공간에서 두 벡터 간의 각도의 코사인을 측정합니다. 범위는 -1에서 1까지이며,
여기서 1은 동일한 벡터를 나타내고, 0은 직교 벡터를 나타내고, -1은 정반대의 벡터를 나타냅니다.
유클리드 거리
벡터 공간에서 두 벡터 사이의 직선 거리를 측정합니다. 범위는 0에서 무한대까지이며,
여기서 0은 동일한 벡터를 나타내고 값이 클수록 점점 더 다른 벡터를 나타냅니다.
내적
두 벡터 크기의 곱과 두 벡터 사이 각도의 코사인 값을 측정합니다.
범위는 -∞에서 ∞까지이며 양수 값은 같은 방향을 가리키는 벡터를 나타내고 0은 직교 벡터를 나타내고 음수 값은 반대 방향을 가리키는 벡터를 나타냅니다.
메타데이터를 통한 필터링

Post-filtering:
벡터 검색 후에 메타데이터 필터링이 수행됩니다.
이렇게 하면 모든 관련 결과를 고려하는 데 도움이 될 수 있지만 검색이 완료된 후 관련 없는 결과를 필터링해야 하므로 추가 오버헤드가 발생하고 쿼리 프로세스 속도가 느려질 수도 있습니다.
Pre-filtering:
벡터 검색 전에 메타데이터 필터링이 수행됩니다. 이렇게 하면 검색 공간을 줄이는 데 도움이 되지만 시스템에서 메타데이터 필터 기준과 일치하지 않는 관련 결과를 간과할 수도 있습니다.
또한 광범위한 메타데이터 필터링으로 인해 계산 오버헤드가 추가되어 쿼리 프로세스가 느려질 수 있습니다.
데이터베이스 관련

성능 및 내결함성
샤딩
Replication
모니터링
액세스 제어
백업 및 컬렉션
API 및 SDK
Vector Index 와 Vector DB의 차이점
FAISS(Facebook AI Similarity Search) 같은 벡터 인덱스도 벡터 임베딩 검색을 개선하지만, DB의 기능을 가지고 있지는 않음
Vector DB는 여러가지 장점을 가짐
데이터 관리 기능: 데이터의 삽입, 삭제, 갱신이 쉬움
메타데이터 저장 및 필터링: 각 벡터에 대한 메타데이터 저장이 가능
확장성: 분산 및 병렬처리 기능을 제공
실시간 업데이트 지원
백업 및 컬렉션 기능(일부 인덱스만 골라서 백업)
에코시스템 연동: ETL(Spark), 분석도구(Tableau, Segment), 시각화(Grafana) 등과 연동. AI 도구와의 연동(LangChain, LlamaIndex, ChatGPT Plugins)
데이터 보안 및 접근 권한 관리
요약
NLP, 컴퓨터 비전 및 다른 AI 어플리케이션에서 벡터 임베딩이 폭발적으로 성장하면서 벡터 데이터베이스가 등장
프로덕션 시나리오에서 벡터 임베딩을 관리할 때 발생하는 문제점을 해결하기 위해 특수하게 만들어진게 벡터 데이터베이스
기존의 스칼라 기반 데이터 베이스 및 스탠드얼론 벡터 인덱스에 비해 상당한 이점을 제공
Colab 실습 코드
참고자료
supecialkim 님의 최신 블로그
더보기-

- Amazon S3 Tables 개발팀에게 직접 묻다. (미공개 자료 포함)
- 2024 AWS re:Invent 출장 중 Amazon S3 Tables 의 발표를 접하고, 시애틀에서 해당 서비스를 개발한 서비스팀이 현장에 있다는 얘기를 듣고 많은 분들이 궁금해 하실 내용들을 확인하고자 발표 세션과, 개발자를 찾아가 문의한 내용을 공개합니다. 아직 AWS Korea 블로그 및 기사를 제외한 한글 자료가 없기 때문에 기쁘게도 가장 빠르게 이를 한국어 자료로 전달드릴 수 있게 되었습니다. 붉은색으로 표기한 내용은 문서와 영상에 나오지 않는 서비스팀 그중에서도 개발에 참여한 인원을 직접 만나서 들은 정보이니 참고 부탁드립니다~! (해당 글은 작성자 노션블로그 에서도 볼 수 있습니다!) TL;DR 기술 동작 방식 : S3 Inteligent Tier...
-

- DataLake의 대중화, 개인용 DataLake의 시대 - DuckDB
- Duck DB DuckDB는 Google에서 BigQuery를 개발한 Jordan Tigani가 big data is dead 를 발표하면서 유명해진 오픈소스 인메모리 SQL OLAP 데이터 베이스 처리 시스템으로, 빈자를 위한 DataLake 과 같이 본 게시글의 제목처럼 "DataLake의 대중화, 개인용 DataLake의 시대"를 만들어 내기에 너무나 적합한 데이터 베이스 시스템이라 이렇게 소개합니다. DuckDB? DuckDB is an in-process SQL OLAP database management system What’s DuckDB C++로 작성된 오픈소스이다. DuckDB is implemented in C++ often produces mo...
-
- Meta LLM 패권 전쟁 격화시키다 : LlaMA2 상업적 이용가능 오픈소스로 공개
- LlaMA2 Llama-2 공식 사이트 : https://ai.meta.com/ TL; DR 3가지 크기의 모델 : 37B, 13B, 70B 3개 모델 학습에 A100-80GB 카드 한 장 기준 330만 시간 분량 학습 & 539톤 이산화탄소 배출 70B 모델은 현재기준 오픈소스 LLM 중 최고 성능 meta 논문기준 70B모델은 MMLU 벤치에서 GPT-3.5, PaLM과 근소한 차이만 보임 논문 : llama-2-open-foundation-and-fine-tuned-chat-models 월 7억명 MAU까지는 무료로 상업적 이용 가능 MS와 Meta가 파트너십을 맺어 azure에 배포 가능 : MS블로그 8시간 전 Meta에서 LLaMA 2 모델을 공개했습니...
-
- ChatGPT의 전두엽(장기기억 저장소)으로 각광받고 있는 Vector DB에 대해 알아보자
- 벡터 데이터베이스란? 벡터 데이터베이스는 방대한 양의 고차원 데이터를 벡터 형태로 최적화 하여 보관하고 쿼리하기 위해 특화된 DB 벡터는 서로 다른 특성이나 품질을 기반으로 개체를 설명하는 수학적 데이터 표현입니다. 각 벡터는 단어나 그림과 같은 단일 데이터 요소를 나타내며 여러 특성을 설명하는 값 모음으로 구성됩니다. 이러한 변수를 "기능" 또는 "치수"라고도 합니다. 예를 들어, 그림은 픽셀 값의 벡터로 표현될 수 있지만 전체 문장은 단어 임베딩의 벡터로 표현될 수 있습니다. 벡터 데이터베이스는 인덱싱 전략을 사용하여 특정 쿼리 벡터와 유사한 벡터를 쉽게 찾을 수 있습니다. 이는 기계 학습 과 같은 경우에 특히 유익합니다. 유사한 데이터 포인트를 발견하거나 제...
DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.