
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
검색을 넘어 추론으로: GraphRAG와 온톨로지 엔진의 결합

문서를 많이 검색해서 텍스트 생성 모델에 넣어주기만 하면 복잡한 규정이나 법률에 대한 정확한 답이 나온다는 생각이 일반적입니다. 하지만 실무 시스템에서 단순 RAG(Retrieval-Augmented Generation, 검색 증강 생성)를 운용해보면 텍스트 조각을 아무리 잘 찾아와도 그 조각들을 잇는 논리적 추론 단계에서 AI가 거짓을 사실처럼 만드는 환각(Hallucination) 현상을 자주 목격합니다.
문서 안에서 검색된 문단이 사실이라 할지라도, 문단 A와 문단 B를 결합해 "따라서 이 규정에 해당한다"라는 판정을 내리는 주체가 거대 언어 모델(LLM)이라면 논리적 엄밀성을 보장받기 어렵습니다. 모델은 문맥상 그럴듯한 문장을 이어 붙일 뿐, 규정 조항의 조건과 예외 관계를 기계적으로 계산하지 않기 때문입니다.
이러한 문제를 해결하기 위해 최근 기술 현장과 학계에서는 지식원 자체를 정형화된 관계망으로 구조화하고, 추론 영역을 전용 엔진에 넘기는 방식이 주목받고 있습니다. 공공SW 사업 법규정 적용을 위한 GraphRAG 설계 사례와 맨체스터 대학교 연구진이 발표한 OA-RAG(온톨로지 기반 에이전트 RAG)는 동일하게 문맥 검색의 한계를 정형 추론 구조로 극복하려는 시도를 보여줍니다.
관계를 연결하는 검색: 공공 법규정을 위한 GraphRAG
공공 행정이나 법률 분야의 문서들은 단순한 텍스트 묶음이 아닙니다. 법률, 시행령, 지침, 예규가 상위-하위 관계와 전제 조건, 예외 조항으로 촘촘히 얽혀 있습니다. 단순한 키워드나 벡터 유사도 검색으로는 "특정 조항의 예외 규정이 다른 지침에 명시된 경우"를 올바르게 찾아내기 어렵습니다.
법규정 AI 상담서비스 구축을 위한 지식그래프 및 GraphRAG 설계 기술 문서에서는 공공SW 사업 관련 법규정의 관계를 구조화하여 시스템에 적용한 사례를 다룹니다. 이 시스템은 단순 문서 검색을 넘어 Local Search와 DRIFT Search라는 두 가지 하이브리드 탐색 기법을 사용합니다.
Local Search는 특정 법 조항이나 개념에 직접 연결된 하위 엔티티와 관계를 정밀하게 파악할 때 유효합니다. 반면 DRIFT Search는 복잡하게 얽힌 법 규정 전체에 대해 전역적인 맥락을 짚어가며 관련 노드를 탐색하는 방식입니다.
[사용자 질의: 대가산정 기준 예외 조항]
       │
       ▼
┌──────────────┐      Local Search     ┌────────────────────────┐
│  GraphRAG    ├──────────────────────►│  특정 조항 노드 및     │
│  Query Engine│                       │  직접 연결 엔티티 추출  │
└──────┬───────┘                       └────────────────────────┘
       │              DRIFT Search     ┌────────────────────────┐
       └──────────────────────────────►│  상위 법률-하위 지침   │
                                       │  전역 탐색 경로 수집   │
                                       └────────────────────────┘
텍스트 조각을 단순 벡터화하여 저장하는 대신, 규정 간의 연결 고리를 그래프 노드(Node)와 엣지(Edge)로 정의하면 AI 모델이 답변을 작성할 때 참고해야 할 전체 관계망을 빠짐없이 제공할 수 있습니다.
이 방식은 조건부로 유효합니다. 규정과 법률처럼 세부 조건과 상하 관계가 명확한 도메인에서는 검색 정확도를 비약적으로 높여주지만, 초기 지식그래프를 구축하는 과정에서 인적·시간적 비용이 많이 들어갑니다. 법규정이 개정될 때마다 그래프의 노드와 엣지를 동기화하는 백엔드 파이프라인이 갖춰지지 않았다면 도입을 보류해야 합니다.
LLM에서 추론 엔진 분리하기: OA-RAG 구조
GraphRAG가 검색 데이터의 구조화에 집중한다면, 학계에서는 한 걸음 더 나아가 추론(Reasoning) 영역 자체를 LLM 외부로 떼어내는 구조를 제안합니다. 2026년 10월 arXiv에 공개된 「OA-RAG: Ontology-based Agentic RAG for Faithful LLM Reasoning」 연구 논문은 온톨로지(Ontology, 지식의 개념과 관계를 엄격히 정의한 체계)와 Reasoner(추론 엔진)를 에이전트의 도구로 사용하는 아키텍처를 제시합니다.
OA-RAG: 온톨로지 reasoner를 도구로 쓰는 Agentic RAG에 따르면, 기존 RAG는 검색기(Retriever)가 관련 문단을 가져오면 그 문단들을 잇는 논리 계산을 순전히 LLM에 의존했습니다. 이로 인해 검색된 문단에 없는 내용을 모델이 자체 지식으로 메워버리거나, 논리적 모순이 있는 답변을 생성하는 문제를 막기 힘들었습니다.
OA-RAG 아키텍처는 역할을 엄격히 분리합니다. LLM은 자연어로 들어온 질문을 온톨로지 질의 언어(예: SPARQL 또는 Description Logic Query)로 번역하고, 정형화된 추론 엔진인 Reasoner가 규정 데이터베이스를 탐색하여 논리적 참·거짓 및 결론을 계산합니다. LLM은 Reasoner가 반환한 정형화된 계산 결과를 다시 사용자가 읽기 편한 자연어로 다듬어 출력하는 인터페이스 역할만 맡습니다.
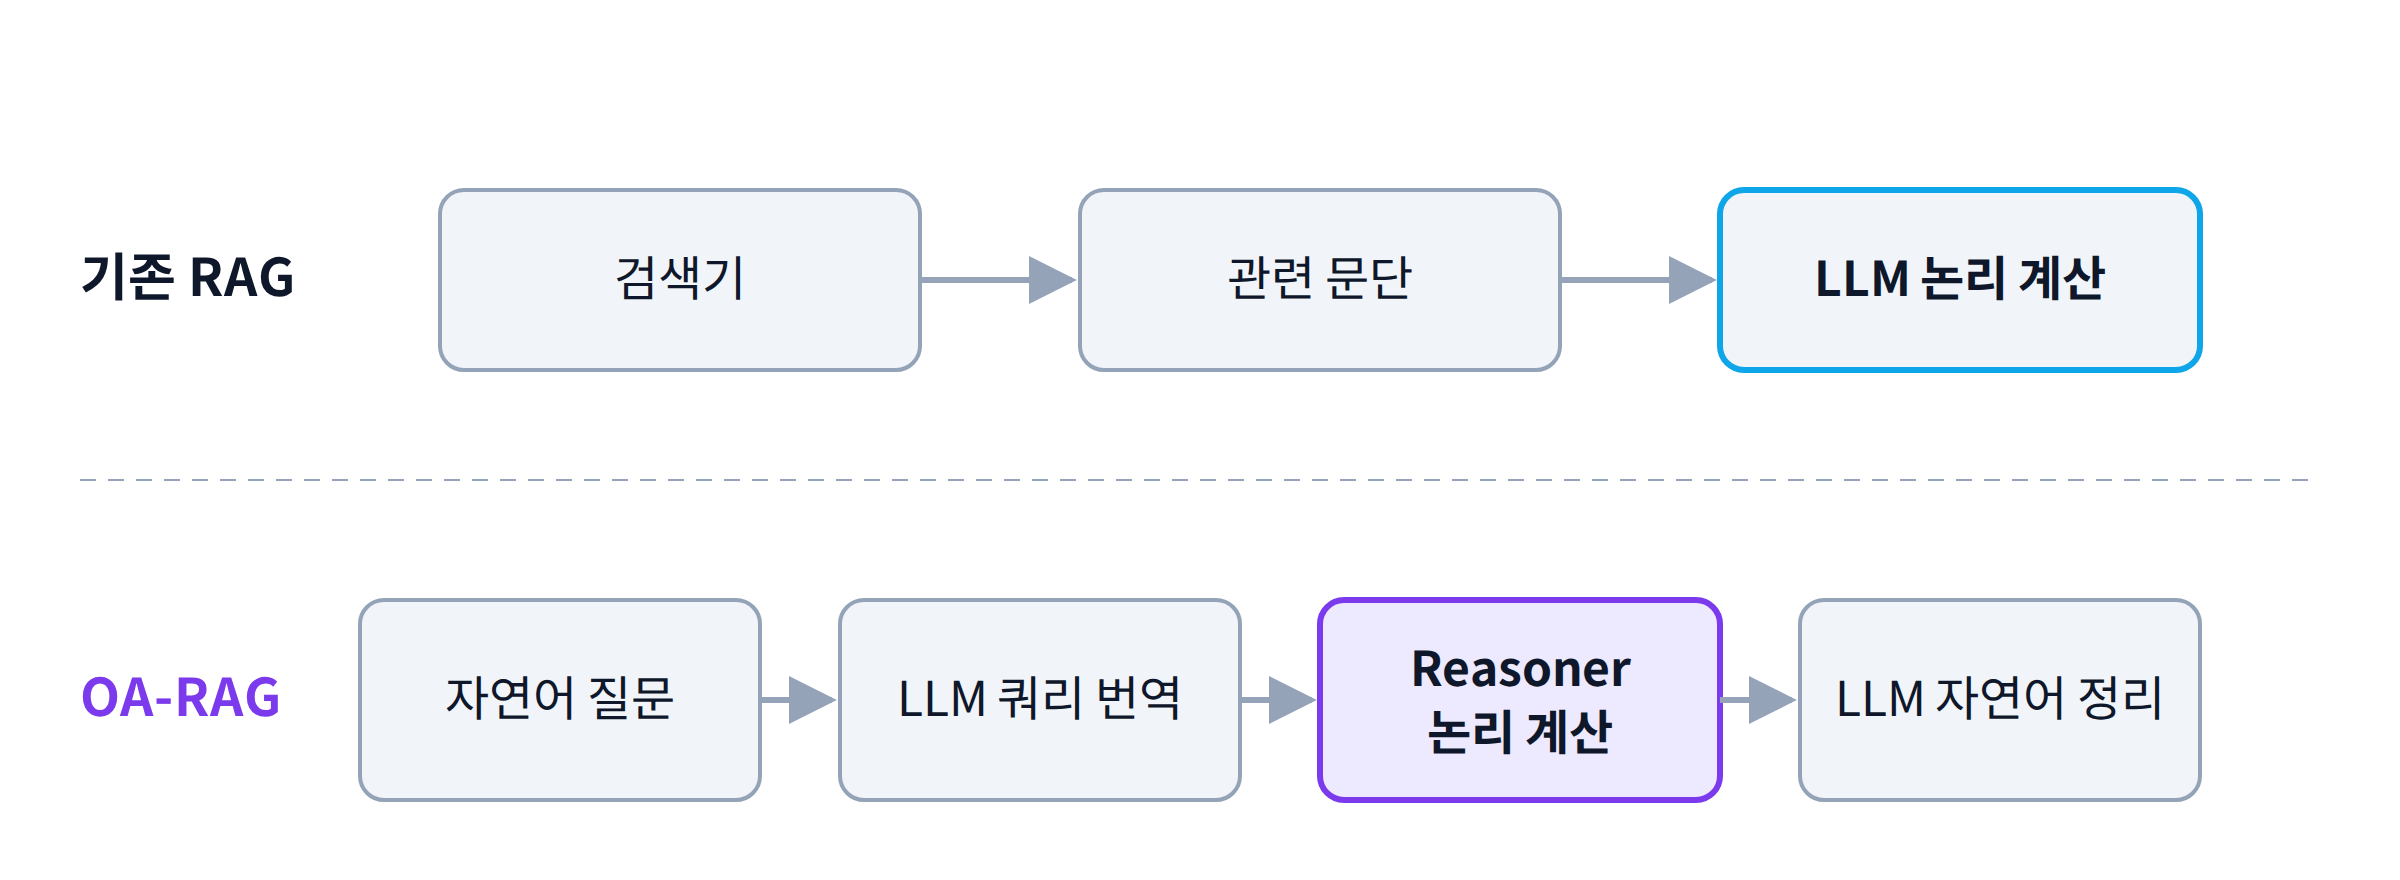
그림 1. 기존 RAG와 OA-RAG에서 논리 계산을 맡는 주체 비교
// OA-RAG의 추론 인터페이스 구조 예시
interface OntologyReasoner {
  // 정형화된 온톨로지 쿼리를 실행하여 엄격한 논리 결과를 반환합니다.
  executeQuery(query: string): Promise<QueryResult>;
}

interface QueryResult {
  isSatisfiable: boolean;
  inferredFacts: string[];
  proofTrace: string[]; // 추론 근거 경로
}

class AgenticRAGSystem {
  constructor(
    private readonly llmTranslator: LLMTranslator,
    private readonly reasoner: OntologyReasoner
  ) {}

  async answerQuestion(userPrompt: string): Promise<string> {
    // 1. LLM은 자연어를 정형 온톨로지 쿼리로 변환합니다.
    const formalQuery = await this.llmTranslator.toFormalQuery(userPrompt);

    // 2. 논리 계산은 외부 Reasoner 엔진이 담당합니다.
    const result = await this.reasoner.executeQuery(formalQuery);

    if (!result.isSatisfiable) {
      return "제시된 조건은 현재 규정과 충돌하여 적용할 수 없습니다.";
    }

    // 3. Reasoner가 계산한 명확한 증명 경로를 바탕으로 답변을 작성합니다.
    return await this.llmTranslator.toNaturalLanguage(result.inferredFacts, result.proofTrace);
  }
}
이 아키텍처를 사용하면 LLM이 임의로 논리를 비약하거나 없는 사실을 만들어내는 환각이 일어날 여지가 차단됩니다. 추론 과정이 Reasoner의 정형화된 비트 계산과 규칙 탐색으로 이뤄지므로, 답변의 출처와 논리적 근거 경로(proofTrace)를 100% 추적할 수 있습니다.
OA-RAG 접근법은 아직 지켜볼 단계입니다. 연구 논문 수준에서 개념 검증이 이루어진 상태이며, 다양한 산업군의 지식을 온톨로지 표준으로 변환하고 대규모 실시간 서비스에 적용하기 위한 추론 엔진 프레임워크의 성능 검증이 추가로 필요합니다.
실무 아키텍처의 변화와 지식 시스템 도입 판단
두 기술 사례가 가리키는 실무의 변화는 명확합니다. 생성형 AI 시스템을 프로덕션에 도입할 때, 시스템의 역할을 단순 "문서 검색 + 문장 요약"으로 설계해서는 정교한 업무를 대체할 수 없습니다.
표 1. 단순 RAG, GraphRAG, OA-RAG의 구조와 도입 부담 비교
- 단순 RAG — 지식 저장 형태: 텍스트 조각을 벡터 DB에 저장 / 논리 추론 주체: LLM / 도입 부담·단계: 문서를 잘라 벡터 DB에 넣으면 끝
- GraphRAG — 지식 저장 형태: 규정 간 관계를 노드·엣지로 정의 / 논리 추론 주체: LLM (관계망을 참고) / 도입 부담·단계: 초기 그래프 구축 비용, 개정 시 동기화 필요
- OA-RAG — 지식 저장 형태: 온톨로지 / 논리 추론 주체: 외부 Reasoner / 도입 부담·단계: 논문 수준 개념 검증, 지켜볼 단계
개발 실무 영역에서 이 방식을 적용하려면 백엔드 데이터 구조와 에이전트 루프의 연결 방식을 다듬어야 합니다. 텍스트를 나열하는 벡터 DB에만 의존하던 기존 백엔드에 지식그래프 DB(예: Neo4j) 또는 온톨로지 엔진을 나란히 배치해야 합니다.
실무 시스템을 구축할 때 적용 가능한 지식 그래프 구성 및 질의 파이프라인의 기본 형태는 아래 설정 예시와 같습니다.
# Agentic RAG 파이프라인 구성 예시 (graph_config.yaml)
knowledge_base:
  type: "hybrid"
  vector_store:
    provider: "qdrant"
    collection: "legal_documents"
  graph_store:
    provider: "neo4j"
    uri: "bolt://localhost:7687"
    schema_version: "2026.1"

search_strategy:
  local_search:
    depth: 2
    max_nodes: 50
  drift_search:
    enabled: true
    global_context_weight: 0.7

reasoning_engine:
  mode: "external_reasoner"
  strict_fact_checking: true
  fallback_on_uncertainty: false
이러한 정형 추론 아키텍처의 도입 여부를 결정할 때는 다음 기준을 파악해야 합니다.
- 도메인 규칙의 명확성: 규정, 법률, 금융 약관, 복잡한 내부 승인 절차처럼 규칙이 명시적인 분야라면 GraphRAG나 온톨로지 결합 방식이 매우 유효합니다.
- 데이터 동기화 비용: 시스템에 입력되는 지식이 자주 바뀌고 정형화하기 어려운 텍스트 위주라면 지식그래프 구축 비용이 RAG 구축 비용을 초과할 수 있습니다.
- 답변의 설명 가능성 요구 수준: "AI가 왜 이런 답변을 내놓았는가"에 대해 법적·제도적 증명이 필요한 서비스라면 추론 엔진 분리 아키텍처는 선택이 아닌 필수 조건입니다.
도입 전 확인할 것
온톨로지와 지식그래프 기반의 Agentic RAG 시스템을 도입하기 전에 팀 내부적으로 다음 한 가지 질문을 확인해 보길 권합니다.
"우리 도메인의 규정과 지식 간 관계를 정형화된 그래프 또는 온톨로지 데이터로 정의하고 유지보수할 담당자나 자동화 파이프라인이 준비되어 있는가?"
단순 문단 검색 기반 RAG는 문서를 텍스트 파서로 잘라 벡터 DB에 넣으면 끝납니다. 하지만 정형 추론 기반 시스템은 지식 간의 관계(Edge)와 개념(Ontology)을 기계가 이해할 수 있는 형태 유지 관리하는 작업이 핵심입니다. 이 백엔드 파이프라인이 준비되어 있지 않다면, 단순 RAG 성능을 개선하는 최적화 작업부터 차근차근 진행하는 것이 바람직합니다.
그 밖의 소식
- TV 앱 실행 시간 측정 자동화 개발기: 실물 TV 조작 및 화면 측정을 PC, IR 송신기, 웹캠과 Claude Code 조합으로 자동화하여 측정 대기 시간을 95% 줄인 사례입니다.
- 베지어 다시 짓기 (1) : 사람과 AI를 위한 디자인 시스템: 여러 버전이 뒤섞인 기존 디자인 시스템 라이브러리를 사람과 AI 에이전트가 모두 활용하기 좋도록 재정비하는 과정을 다룹니다.
- 소프트웨어가 구조적으로 무너지고 있다: 긴 의존성 사슬과 AI가 생성한 코드의 무분별한 누적이 만들어내는 비정합성(decoherence) 문제와 관리 통제력 약화를 경고합니다.
- Subscale - 여러 Tailscale 계정 주소별 분리 CLI 도구: 회사 및 개인용 계정을 수동으로 전환할 필요 없이 대상 IP/도메인에 따라 필요한 Tailscale 계정으로 자동 접속을 지정하는 CLI 도구입니다.
- BugMeNot 서비스 종료: 오랜 기간 가짜 계정 공유 서비스를 제공해 온 BugMeNot 웹사이트가 종료 공지와 암호화된 문자열을 남기고 서비스를 마감했습니다.
DEVOTEE 님의 최신 블로그
더보기-
- 검색을 넘어 추론으로: GraphRAG와 온톨로지 엔진의 결합
- 문서를 많이 검색해서 텍스트 생성 모델에 넣어주기만 하면 복잡한 규정이나 법률에 대한 정확한 답이 나온다는 생각이 일반적입니다. 하지만 실무 시스템에서 단순 RAG(Retrieval-Augmented Generation, 검색 증강 생성)를 운용해보면 텍스트 조각을 아무리 잘 찾아와도 그 조각들을 잇는 논리적 추론 단계에서 AI가 거짓을 사실처럼 만드는 환각(Hallucination) 현상을 자주 목격합니다. 문서 안에서 검색된 문단이 사실이라 할지라도, 문단 A와 문단 B를 결합해 "따라서 이 규정에 해당한다"라는 판정을 내리는 주체가 거대 언어 모델(LLM)이라면 논리적 엄밀성을 보장받기 어렵습니다. 모델은 문맥상 그럴듯한 문장을 이어 붙일 뿐, 규정 조항의 ...
-
- 23.9초를 2.7초로 줄인 서버 통폐합과 IP 파싱 불일치가 남긴 네트워크 경계의 조건
- 느린 네트워크 환경에서 웹 페이지의 첫 게시물이 화면에 나타나기까지 걸리던 23.9초가 서버 구조를 바꾼 뒤 2.7초로 줄었습니다. 반면 똑같은 런타임 환경에서 IPv4 주소 앞자리에 숫자 0 하나가 더 붙었다는 이유로, macOS 환경의 특정 Node.js 런타임은 87.0.0.1 인증서를 들고 온 127.0.0.1 로컬 서버를 정상 서버로 신뢰해 통신을 연결했습니다. X.com을 처음부터 다시 구축하기 - 서버 3개를 하나로 소식과 Node HTTPS 요청의 host에 0127.0.0.1을 넣었더니 6월 보안 패치 뒤 맥에서는 87.0.0.1용 인증서로 127.0.0.1 서버를 믿었다 분석은 서로 다른 레이어를 다루지만 하나의 기술적 사실을 공유합니다. 바로 ...
-
- Lovable 노출과 상시 녹음이 던진 데이터 권한 경계의 경고
- 15만 9,041개 프로젝트 중 7,403개 사이트에서 이메일 주소가 그대로 노출되었고, 노출 대상에는 8만 개 이상의 프로필과 20만 건 이상의 채팅 메시지, 여권 번호 1,000건 이상이 포함되어 있었습니다. 다른 한편에서는 스마트 안경을 착용한 사용자 한 사람의 선택으로 반경 안에 들어온 동료와 행인의 대화 및 전사 기록이 사용자의 의도와 무관하게 시스템으로 흡수되고 있습니다. 이 두 사건은 얼핏 소프트웨어 취약점과 하드웨어 프라이버시라는 서로 다른 영역의 문제처럼 보입니다. 하지만 그 밑바탕을 들여다보면 하나의 공통된 설계 결함에 닿아 있습니다. 시스템을 만드는 이들이 수집과 조회의 경계를 기본적으로 닫아두지 않고 편의성을 앞세워 열어두었을 때, 권한 없는...
-
- 초록색 불 뒤에 숨은 허수 테스트와 외부 의존성: AI 파이프라인의 검증 경계 세우기
- 지속적 통합(CI) 서버의 파이프라인이 모두 초록색 체크 표시를 띄우며 정상 종료되었습니다. 코드 리뷰어는 AI가 작성한 수백 줄의 풀 리퀘스트(PR)와 그에 딸린 단위 테스트가 모두 통과한 것을 확인하고 안도하며 배포 버튼을 누릅니다. 그러나 며칠 뒤 정산 로직에서 심각한 금액 누락 장애가 접수됩니다. 테스트 코드를 열어 확인해보니, 테스트는 버그가 있는 구현 함수를 그대로 실행한 뒤 반환된 잘못된 값을 기대값 변수에 복사해 넣고 검증을 끝낸 상태였습니다. 테스트는 통과했지만 시스템의 결함은 전혀 걸러내지 못했습니다. 이 장면은 현대 개발 팀이 AI 도구를 도입하면서 자주 마주하는 현실입니다. AI 테스트의 허수를 걸러내기에서 다룬 허수 테스트 문제와 AI가 작...
DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.