
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Computer Use Agent(CUA)를 직접 돌려보자! (Feat. AgentQ)

- DEVOTEE 요약
- Computer Use Agent(CUA)는 Multimodal LLM과 AI Agent 기술을 활용해 실제 컴퓨터, 브라우저, 모바일 UI를 조작하는 기술로, 기존 API 호출의 한계를 넘어 화면을 직접 제어해 더욱 복잡한 자동화를 가능하게 합니다. 특히, 스탠포드의 AgentQ와 같은 최신 연구는 MCTS와 DPO 알고리즘을 통해 LLM의 정책을 훈련, 개선하며 이러한 기술을 발전시키고 있습니다. 이에 따라 CUA는 JARVIS같은 스마트 비서 구현부터 다양한 산업 응용까지 미래의 혁신적인 자동화 도구로 활용될 가능성이 큽니다.
안녕하세요. DEVOCEAN AI Fellowship 7기에서 Computer Use Agent(CUA) 프로젝트를 진행 중인 장교철입니다.
저번에 Computer Use Agent라는 개념을 해당 블로그 포스트 에서 소개해 드렸었죠.
Computer Use Agent가 Multimodal LLM, Agent Ability를 사용해서 화면을 조종한다는 건 알겠는데,
이게 실제로 어떤 식으로 조종하고 훈련이 되는 건지 아직 감이 안 잡히실 거라고 생각합니다.
이번 포스트에서는 Computer Use Agent 분야에서 유명한 스타트업인 Multi-On과 스탠포드에서 공개한 AgentQ라는 Open Source GitHub repo를 직접 돌려보면서
Computer Use Agent의 작동 방식에 대해서 이해해 보는 시간을 가져 보도록 하겠습니다!
🖥️ Computer Use Agent란?
저번 포스트에서 소개해 드린 것처럼 Computer Use Agent는 MLLM과 AI Agent 기술을 기반으로 브라우저 환경, 모바일 혹은 웹 UI를 실제로 조작할 수 있는 Agent입니다.
먼저, MLLM을 통해 Screenshot, DOM 정보, 그리고 유저의 instruction과 같은 정보를 인풋으로 받아 현재 컴퓨터 화면에 대한 유저의 의도를 파악합니다.
그리고 Actionning, Planning, Memorizing, Tool Using 과 같은 AI Agent 기술을 사용하여 유저의 의도대로 컴퓨터 화면을 조작하여 컴퓨터 조작을 도와줍니다.
일반적으로 브라우저를 조작할 때는 Playwright 혹은 Selenium 같은 툴을 많이 사용합니다.
📝 AI Agent에 대한 자세한 설명은 아래 DEVOCEAN에 올라온 포스트들을 참고해주세요!
💡: OS와 같은 Computer 자체를 조작하는 Agent를 Computer Use Agent, 웹(Browser) 혹은 모바일을 조작하는 Agent를 각각 Browser Use 그리고 Mobile Use라고도 합니다.
⏱️ Computer Use Agent를 언제 사용할 수 있을까?
🤖 포스트 작성자의 자비스 만들기 프로젝트
Computer Use Agent를 언제 사용할 수 있을지를 얘기하려면 먼저 제가 CUA에 관심을 갖게 된 계기에 대해서 설명해 드리면 좋을 것 같은데요...(TMI 주의 요망)
학부 시절 AI를 처음 접하게 되고, AI 기술을 사용하면 사람들의 삶이 더 윤택해질 수 있을 거라는 생각으로 아이언맨의 자비스를 만들기 위하여 AI를 연구해야겠다고 다짐하였습니다.
그리고 대학원 진학 후 저는 아이언맨의 자비스 시스템을 만들기 위한 첫걸음으로 Siri, Alexa와 같은 voice assistant를 자동화 하자는 취지로 function calling을 연구하게 되었습니다.
Function Calling Benchmark를 주제로 ACL에 논문도 냈습니다!. 하지만, 외부 API call을 하는 것이 주목적인 Function Calling으로는 JARVIS처럼 모든 것을 자동화하는 것이 한계가 있다고 느꼈습니다.
Function Calling 및 MCP로는 이미 존재하는 API만 활용해서 자동화할 수 밖에 없었죠.
저는 이 한계를 느끼고 Function Calling의 부족한 공간을 메꿔주는 분야를 찾다가, Computer Use Agent라는 기술을 찾게 되었습니다.
API Calling으로 해결할 수 없는 Task 들은 AI가 실제로 컴퓨터나 모바일 화면을 조작하게 하여 해결하는 방법입니다.
대학원에서 홀로 연구에 몰두하며 막막함을 느끼던 중, 마치 누군가 이끌어주신 듯 DEVOCEAN AI Fellowship 7기에서 관련 프로젝트를 진행할 계획이라는 공기를 보게되었습니다.
급하게 뜻이 맞는 팀원들과 함께 지원하여 최종 선발되었습니다. 현재는 김동현 멘토님의 탁월한 지도 아래 프로젝트를 수행해나가고 있습니다.
너무 심한 TMI였는데요,
이렇듯 Computer Use Agent는 JARVIS와 같은 Voice Assistant에서 Function(API) Calling으로 해결할 수 없는 자동화 부분을 컴퓨터를 조종하여 해결해 줄 수 있는 기술입니다!
🪀 Computer Use 기업 및 활용 사례
이미 미국과 중국과 같은 나라에서는 2022년 쯤부터 많은 연구가 진행되었고, 서비스도 나오고 있습니다.
논문 관련해서는 지난 포스트에서 몇 편 소개해 드렸으니, 이번 포스트에서는 Computer Use를 서비스화한 기업을 소개해 드리겠습니다.
아마도 최근에 화젯거리였었던 서비스 중의 하나일 텐데요 중국의 Monica라는 회사에서 개발한 Manus[/ˈmæn.əs/]입니다. (Deepseek moment Part II 라고도 하더라고요)
Computer Use 기능을 AI Agent에 적용하여 유저의 명령을 수행할 때 Manus 서버에 설치된 컴퓨터를 직접 조작하여 문제를 해결해 줍니다.
사진처럼 핸드폰 여러 대가 동시에 혼자서 작동하고 있는 영상으로 화제가 되었었죠.
다음은 미국에 Computer Use 분야로 논문도 내고 서비스화하고 있는 The AGI Company라는 기업입니다.
이전 이름은 한 번쯤은 들어보셨을 MultiOn이라는 회사인데, 이번 포스트에서 설명하려는 [AgentQ](https://arxiv.org/abs/2408.07199라는 논문을 스탠포드 대학교와 publish 한 회사이기도 하죠.
REAL-Bench라는 Standardized test lab for Web Agent Evaluation을 제안하는 논문도 publish 했습니다. 같이 확인해 보셔도 좋을 것 같습니다.
대표적인 AI 기업 OpenAI와 Claude에서도 각각 Operator, 그리고 Computer Use라는 이름으로 서비스화하였습니다.
OpenAI는 Pro를 결제해야지만 사용해 볼 수 있는데, 저는 직접 사용해 본 결과 "서울대입구역에 한식 맛집을 찾아줘"와 같은 간단한 명령어도 버벅대고 실패하는 모습을 보였습니다.
Claude는 Computer Use라는 이름으로(아마 이때부터 Computer Use라는 이름을 사용하게 된 것 같습니다.)
Computer Use를 직접 돌려볼 수 있도록 Open Source로 깃헙에 공개했었습니다. 링크
위에 나열해 드린 기업 말고도 Computer Use라는 기능을 사용하여 서비스하고 있는 기업은 매우 많은데요,
이렇듯 단순히 Chatbot 형태의 LLM이 해결해 줄 수 있는 부분에 한계가 있다 보니 MLLM이 컴퓨터를 조작하는 방식으로 서비스가 발전해 가고 있는 것 같습니다.
나무위키에 올라온 내용이지만 Google에서도 Google Jarvis라는 프로젝트가 2024년 5월 Google I/O에서 잠깐 공개되었었다고 하네요.
👨💻 AgentQ - Advanced Reasoning and Learning for Autonomous AI Agents
지금까지 Computer Use Agent에 대해서 간단한 개념과 Use Case를 알아보았는데요,
개념과 응용 사례를 이해했으니 이제 Computer Use를 직접 경험해보면 좋을 것 같습니다!
위에서 언급 드린 AgentQ라는 논문에서 Computer Use를 구현한 코드를 깔끔하게 정리해서 오픈소스로 공개하였습니다.
해당 프로젝트를 사용해서 Computer Use를 경험해 보고 이해해 보면 좋을 것 같습니다.
그럼, 그 전에 먼저 AgentQ라는 논문에서는 어떤 내용을 다루는지 간단하게 설명해 드리도록 하겠습니다!
📰 논문 설명
Motivation
최근 LLM은 텍스트 생성 태스크에서는 강력한 성능을 보임에도 불구하고, 동적이고 상호작용적인 환경,
특히 웹 탐색과 같은 multi-step agentic 작업에서 효과적으로 작동하는 데 여전히 어려움을 겪고 있습니다.
LLM들은 텍스트와 같은 정적 데이터셋으로 학습되었기 때문에 실시간으로 변화하는 웹 환경의 경우 일반화 능력이 떨어집니다.
웹 환경과 같이 복잡한 작업에서는 효과적인 탐색 전략과 장기적인 계획 능력이 필수적이지만, 기존 LLM 에이전트는 특히 Long-Context Understanding 능력이 부족합니다.
AgentQ는 이러한 기존 LLM Agent가 yield하는 문제를 해결하기 위해 Monte Carlo Tree Search(MCTS), Self-Critique 메커니즘, 그리고 DPO 강화학습 방식을 결합하여 사용합니다.
Contribution
Agent Q 논문은 기존 LLM 에이전트가 동적 웹 환경에서 겪는 두 가지 주요 문제,
즉 정적 텍스트 데이터 학습으로 인한 동적 환경에서의 일반화 어려움과 Long-Context로 인한 탐색 및 학습의 한계를 해결하기 위해 AgentQ Framework를 제안합니다.
이 프레임워크는 강화학습의 여러 아이디어를 복합적으로 활용하여, 기초적인 강화학습 개념을 알고 계시면 이해가 더욱 수월합니다.
사실 저도 강화학습에 대한 지식은 좀 부족하기때문에 댓글로 피드백 주시면 감사하겠습니다.
Agent Q Framework의 작동 방식:
Agent Q framework는 Guided Monte Carlo Tree Search (MCTS), Self-Critique mechanism,
그리고 Offline Reinforcement Learning 기법인 Direct Preference Optimization (DPO)을 결합하여 LLM Policy를 훈련하는 방식입니다.
1. Search (Monte Carlo Tree Search, MCTS):
Agent는 현재 state(웹 화면)에서 시작하여, 현재 policy(LLM Policy: 논문에서는 LLaMA 70B를 사용합니다.)를 사용하여 다음 action에 대한 K개의 Action Candidates를 제안합니다.
제안된 Action Candidates에 대해 별도의 LLM Self-Critique model (논문에서는 이 모델도 LLaMA 70B를 사용합니다.)
이 각 행동의 perceived utility에 따라 순위를 매깁니다. 이 순위 정보는 각 행동의 Process-based Value Estimate hat{Q}를 계산하는 데 사용되며,
Step-level에서의 Process supervision 역할을 합니다.
이 hat{Q} 값은 나중에 DPO 학습을 위한 Combined Value (Q)를 구성하는 데 활용됩니다.
Agent는 Search Tree에서 UCB1 algorithm을 사용하여 다음으로 탐색할 state와 action 쌍을 선택합니다.
UCB1은 Exploitation (알려진 좋은 경로 선택)과 Exploration (덜 탐색된 경로 탐색)의 균형을 맞추는 데 사용되며,
이때 MCTS Backpropagation을 통해 업데이트된 Outcome-based Empirical Q-value tilde{Q}와 방문 횟수 (N)를 기반으로 UCB1 점수를 계산합니다.
선택된 action을 환경에서 실행한 후, Policy에 따라 Simulation 또는 Rollout을 진행하여 하나의 Trajectory를 완성합니다.
Trajectory가 완료되면 Task 성공 여부에 따라 최종 Outcome Reward (R) (Binary: 1 for success, 0 for failure)를 받습니다.
이 Reward (R)는 Trajectory를 따라 거슬러 올라가며 (Backpropagation), 경로 상에 있는 모든 State-Action pairs의 Outcome-based Empirical Q-value tilde{Q}와 방문 횟수 (N)를 업데이트합니다
(논문의 Eq. 8 참고). MCTS는 이 업데이트를 통해 어떤 경로가 Rollout 결과(Outcome)에 기반하여 더 유망한지 학습합니다.
2. Learning (Direct Preference Optimization, DPO)
MCTS 탐색 과정에서 수집된 다양한 Trajectory 데이터는 Replay Buffer에 저장됩니다 (Algorithm 1 참고).
이 Replay Buffer의 데이터를 바탕으로 Preference Pairs Dataset을 구축합니다. 각 state (node)에서 탐색되었던 여러 Action Candidates들을 비교하여 Preference pair를 만듭니다.
각 action의 가치는 단순히 MCTS를 통해 얻은 Empirical Q-value tilde{Q} 만 사용하는 것이 아니라,
AI Self-Critique model의 순위 기반 가치 hat{Q}와 MCTS의 tilde{Q}를 조합한 Combined Value (Q)를 사용합니다 (논문의 Eq. 10 참고).
두 action의 Combined value 차이가 일정 threshold 이상일 경우, 더 높은 가치를 가진 action을 Preferred action으로, 낮은 가치를 가진 action을 Rejected action으로 묶어 Preference pair를 구성합니다.
이렇게 구축된 Preference Pairs Dataset을 사용하여 현재 LLM Policy를 DPO algorithm으로 Fine-tune합니다.
DPO는 Preference pair의 Likelihood ratio를 최적화하여 Preferred action의 확률을 높이고 Rejected action의 확률을 낮추며,
학습 시작 전 Policy 또는 이전 Iteration의 Policy와의 KL Divergence를 제어하여 Policy drift를 방지합니다. DPO 학습은 DPO loss function을 최소화하는 방식으로 진행됩니다.
3. Iterative Improvement Cycle:
DPO 학습을 통해 개선된 Fine-tuned LLM Policy는 다음 Iteration에서 MCTS 탐색을 위한 Base policy로 사용됩니다.
이러한 Search와 Learning 과정의 Iteration을 총 N번 반복합니다.
최종적으로, N번의 Iteration이 모두 완료된 후 얻어진 LLM Policy가 실제 환경에서 Task를 수행하는 Inference 단계에 사용됩니다.
Conclusion
내용이 좀 복잡하지만, 간단히 설명하자면, MCTS 알고리즘을 사용해서 preference pair Dataset을 만들고,
그 데이터셋을 사용해서 DPO Finetuning을 통해 Computer Use Agent에서 사용되는 Policy 모델을 훈련하는 방식입니다.
이 AgentQ 프레임워크를 통해 모델의 성능을 향상 시켰습니다.
해당 논문은 ICLR 2025에 제출되었고 reject라는 결과를 받았습니다.
리뷰어들은 Ablation Study의 부족과 Novelty 문제를 제기해주었습니다.
☘️ AgentQ를 돌려보자!
이쪽 분야를 처음 접해보시면 프로그램을 돌리는데 설정하는 과정에서 시간이 많이 들어갈 수 있습니다.
제가 그랬거든요. 아래에 적어드린 것만 순서대로 따라하시면 문제 없이 AgentQ를 돌려보실 수 있습니다.
시작!
https://github.com/sentient-engineering/agent-q에 접속해줍니다.
해당 프로젝트에서는 poetry를 사용합니다. poetry 를 설치해줍니다.
poetry 설치 후 agent-q 폴더로 이동하시고,
poetry install을 통해 dependency를 모두 설치합니다.설치 후 poetry 환경을 활성화 해줍니다.
poetry env activatesource /home/kyochul/.cache/pypoetry/virtualenvs/agentq-JoLOBYua-py3.12/bin/activate
저는 맥을 사용하고 있어서 맥을 기준으로 설명드리자면, AgentQ는 PlayWright을 사용하고 Chrome 브라우저를 조작하기 때문에 Chrome이 설치되어 있어야 합니다.
터미널 실행 후 크롬을 디버깅 모드로 활성화합니다.
/Applications/Google\ Chrome.app/Contents/MacOS/Google\ Chrome \ --remote-debugging-port=9222 \ --user-data-dir="/tmp/chrome-debug"그럼 크롬 window가 켜졌을겁니다. 다른 터미널에서
curl http://localhost:9222/json/version크롬이 잘 켜졌는지 확인해줍니다.이제 AgentQ 프레임워크를 돌릴 MLLM을 설정해주어야 합니다.
agentq/core/agent/base.py에run이라는 함수에서 모델을 설정해줍니다. 저는gpt-4.1-nano를 사용했습니다.agent-q폴더로 돌아가서python -u -m agentq로 실행하면 아래 화면과 같이 성공적으로 AgentQ를 실행하실 수 있습니다!
🚀 마무리: Computer Use Agent의 미래?
이번 블로그 포스트에서는 AgentQ의 연구적인 기여와 AgentQ 실행 방법에 대하여 다뤘습니다.
AgentQ를 직접 돌려보시면서 이 Computer Use Agent라는 기술이 어떻게 응용될 수 있을지, 이 분야의 미래에 대해서는 어떻게 생각하시는지 여러분들의 생각이 궁금합니다!
댓글로 많이 알려주세요!
감사합니다.
7기_장교철 님의 최신 블로그
더보기-

- AAA팀: Autonomous Agent Enabling 기술 개발 - 연구과정(2)
- 안녕하세요! AAA의 장교철, 전현석, 김기태입니다. 저희는 실제 핸드폰에서 효율적으로 핸드폰을 조작하는 Mobile GUI Agent를 개발하고 있고, 이 포스트를 통해 현재 처음 연구 계획서를 공개한 시점에서 얼마나 주제가 발전되었고 얼마나 진행되었는지 공유하고자 합니다. 1. 처음 계획 한 주제 먼저 첫 연구계획 포스트에서 어떤 내용에 대해 말씀드렸는지 간단하게 요약드리겠습니다. 6월 14일에 처음 공개한 저희 포스트에서는 GUI Agent, Operator Agent라는 개념이 생소하게 느껴지실 분들을 위해 Autonomous Agent, GUI Agent, Federated Learning과 같은 개념을 소개드리고, Autonomous Agent Enab...
-

- Computer Use Agent(CUA)를 직접 돌려보자! (Feat. AgentQ)
- 안녕하세요. DEVOCEAN AI Fellowship 7기에서 Computer Use Agent(CUA) 프로젝트를 진행 중인 장교철입니다. 저번에 Computer Use Agent라는 개념을 해당 블로그 포스트 에서 소개해 드렸었죠. Computer Use Agent가 Multimodal LLM, Agent Ability를 사용해서 화면을 조종한다는 건 알겠는데, 이게 실제로 어떤 식으로 조종하고 훈련이 되는 건지 아직 감이 안 잡히실 거라고 생각합니다. 이번 포스트에서는 Computer Use Agent 분야에서 유명한 스타트업인 Multi-On과 스탠포드에서 공개한 AgentQ라는 Open Source GitHub repo를 직접 돌려보면서 Computer ...
-

- 멀티모달 LLM을 활용한 Computer Use Agent를 알아보자!
- 안녕하세요. DEVOCEAN AI Fellowship 7기에서 Computer Use Agent(CUA) 프로젝트를 진행 중인 장교철입니다. 이번 포스트에선 한국에서는 많이 알려지지 않은 CUA에 대한 배경 개념들과 최근 CUA 분야에는 어떤 연구들이 진행되고 있는지 설명드리려고 합니다. 1. Multi-modal LLM(MLLM) Computer Use Agent를 소개하기에 앞서, 그 기반이 되는 핵심 모델 중 하나인 MLLM(Multi-modal Large Language Model)의 개념을 간단히 설명드리겠습니다. 1.1 Concept MLLM(Multi-modal Large Language Model)은 텍스트 외에도 이미지, 비디오, 오디오 등 다양한...
DEVOTEE 추천 블로그
-

- 똑똑한 Agent를 만드는 방법: 워크플로우 개발
- Agent는 사용자를 대신하여 특정 목표를 위해 작업을 수행하는 자율적인 시스템입니다. Agent는 사용자의 요청을 이해하고, 환경과 상호 작용하며, 목표를 달성하기 위해 필요한 행동을 취합니다. LLM (Large Language Model)은 자연어를 이해하고 추론 능력을 가지고 있어 Agent를 구현하는 핵심 기술로 활용됩니다. GPT-3.5나 GPT-4와 같은 LLM을 사용하면 손쉽게 Agent를 구현해 볼 수 있습니다. Agent의 정확도는 사용자의 요청을 정확히 이해하고 처리하는 능력입니다. 이는 Agent 개발의 핵심 목표이며, 사용자 만족도를 높이는 데 중요한 역할을 합니다. 하지만 높은 정확도를 갖는 Agent를 만드는 것은 쉽지 않으며, 높은 정...
-

- TC = 프롬프트 : LLM 기반의 QA 테스트 자동화 톺아보기 (Cursor + PlayWright)
- 소프트웨어 서비스에 LLM이 도입되고 이제 AGI 시대로 접어든 이후 Tech서비스에는 AI의 활용이 점점 더 발전하고 있습니다. QA 테스트 자동화(Automation Test)에도 Chat기반 LLM Agent로 테스트 자동화를 빠르게 개발하고 도입할 수 있는 기술이 탄생했습니다. Cursor + PlayWright Chat기반 LLM Agent로 테스트 자동화를 진행하기 위해서는 Cursor IDE를 사용하고 있습니다. Cursor는 AI 코드 에디터이기 때문에 직접 테스트 프레임워크를 내장하고 있는 건 아니지만, 다양한 테스트 프레임워크와 잘 호환되도록 설계되어 있는데 여러가지 테스트 프레임워크를 사용해봤지만 특히 Playwright 테스트 프레임워크와는 ...
-
- AAA팀: Autonomous Agent Enabling 기술 개발 - 연구계획(1)
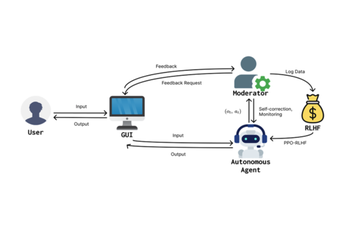
- 안녕하세요! AAA의 장교철, 전현석, 김기태입니다. 저희는 요즘 핫한 Autonomous Agent Enabling 기술 개발을 주제로 연구를 진행하게 되었습니다! 1. 연구 배경 1.1 Agentic AI 및 Autonomous Agent Agentic AI는 (M)LLM을 바탕으로 Perception → Plan → Action → Self-Reflection 루프를 자체적으로 실행해 사용자의 목표를 달성하는 Autonomous Agent를 지칭합니다. 이러한 에이전트는 “목표 지향적(task-oriented)이며, 환경을 인지, 추론하고 행동까지 진행한다”는 점에서 전통적 챗봇과 구분됩니다. 이에 산업계 역시 고객 상담, 문서 작성, 데이터 분석 등의 여러...
-
- 멀티모달 LLM을 활용한 Computer Use Agent를 알아보자!
- 안녕하세요. DEVOCEAN AI Fellowship 7기에서 Computer Use Agent(CUA) 프로젝트를 진행 중인 장교철입니다. 이번 포스트에선 한국에서는 많이 알려지지 않은 CUA에 대한 배경 개념들과 최근 CUA 분야에는 어떤 연구들이 진행되고 있는지 설명드리려고 합니다. 1. Multi-modal LLM(MLLM) Computer Use Agent를 소개하기에 앞서, 그 기반이 되는 핵심 모델 중 하나인 MLLM(Multi-modal Large Language Model)의 개념을 간단히 설명드리겠습니다. 1.1 Concept MLLM(Multi-modal Large Language Model)은 텍스트 외에도 이미지, 비디오, 오디오 등 다양한...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.