
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
R&D팀: 음악 기반 자동 안무 동영상 생성 모델 개발 - 연구계획(1)
- DEVOTEE 요약
- 이 연구는 음악과 인물 사진을 입력으로 춤추는 영상을 생성하는 자동 안무 모델 개발을 목표로 합니다. 이를 위해 음악 특징 추출, 인물 정체성 유지, 음악 기반 동작 생성, 동영상 생성 등 네 단계로 구성된 Music-to-Dance 프레임워크를 설계하며, 기존 모델의 한계를 개선하고자 각 단계에 최신 기술을 적용합니다. 최종적으로 자연스럽고 사실적인 춤 영상을 생성하고 평가 지표를 개선하기 위해 다양한 방법론을 활용할 계획입니다.
안녕하세요! 저희는 음악 기반 자동 안무 동영상 생성에 대해 연구해볼, R&D 팀입니다!
인물 사진 1장과 음악을 입력해서 음악에 맞는 춤을 추는 동영상을 생성하는 것이 최종 목표인데요,
그에 맞춰서 세부적인 요소를 다듬어볼 계획입니다!
1. 연구 배경
1.1 Music-to-Dance Framework
먼저, 저희가 궁극적으로 구축하고자 하는 모델 프레임워크에 대해 소개드리겠습니다.
사진과 음악을 입력으로 받아 댄스 영상을 생성하기 위해서는, 전체 프로세스를 여러 세부 단계로 나누고 각 단계에 적절한 모델을 적용하거나 새롭게 설계하는 것이 필요합니다.
전체 과정은 크게 네 단계로 구성됩니다.
Music Feature Extraction: 입력된 음악으로부터 주요 특징을 추출하는 단계입니다. 이때 추출된 feature는 이후 동영상 생성의 입력으로 활용되므로, 적절한 형태의 임베딩으로 가공되어야 합니다. 대표적인 방법으로는 기존 모델인 Jukebox[1]를 활용하거나, 대안적인 음악 분석 모델을 적용할 수 있습니다.
Identity Preservation: 입력된 인물 사진으로부터 인물의 고유한 정체성(Identity)을 추출하는 단계입니다. 여기에는 얼굴 정보뿐만 아니라 복장, 체형 등 신체 전반의 외형적 특징이 포함됩니다. 기존 연구 중 ConsistentID[2]는 이와 관련된 대표적인 모델입니다.
Music-to-Pose: 음악의 특성을 바탕으로 신체 Pose 시퀀스를 생성하는 단계입니다. 여기서 Pose는 신체 주요 관절을 기반으로 구성된 구조이며, 데이터셋 형식에 따라 디테일 수준이 달라질 수 있습니다. 최종적으로 자연스럽고 사실적인 동영상을 생성하기 위해서는 손가락 관절이나 이목구비 위치와 같은 세부 표현까지 포함하는 것이 중요합니다.
(Pose-conditioned) Video Generation: 앞서 생성된 Pose 시퀀스와 인물 Identity 정보를 바탕으로, 최종 결과물인 댄스 영상을 생성하는 단계입니다. 주요 참고 모델로는 CHAMP[3], StableAnimator[4] 등이 있으며, 이들은 포즈와 인물 정보를 영상으로 효과적으로 재구성하는 데 중점을 둡니다.
최종 생성 결과의 품질을 높이기 위해서는, 각 단계에서의 모델 성능 향상은 물론 단계 간 정보의 유기적인 연결이 매우 중요합니다.
이러한 통합적 접근의 사례로는 이번 CVPR Workshop에서 발표된 STM2PE-Diff[5] 등의 연구를 들 수 있습니다.
1.2 기존 방식의 한계
CHAMP[3] 등 기존의 모델들은 몇 가지 중요한 한계점을 지니고 있습니다.
이는 주로 사용된 데이터셋이나 포즈 표현 방식에서 비롯되며, 모델의 출력 품질을 향상시키기 위해서는 이러한 제약을 해결하는 것이 필수적입니다.
예를 들어, AIST[6] 데이터셋은 Music-to-Dance 생성 연구에서 널리 활용되어 왔으며, 사람이 춤추는 영상을 촬영하는 방식으로 구축되었습니다.
그러나 이 데이터셋은 인물이 화면 중앙에서 팔다리 위주로 움직이는 형태의 춤에 편향되어 있어, 다양한 스타일의 표현에는 한계가 있습니다.
또한, 포즈 정보 추출에 주로 활용된 SMPL[7] 모델은 손가락이나 얼굴의 세밀한 움직임을 반영하지 못한다는 단점이 있습니다.
이로 인해 생성된 춤 영상에서도 표정이나 손 동작의 변화가 거의 나타나지 않으며, 이는 춤의 완성도를 평가할 때 중요한 요소로 작용하는 디테일을 놓치는 결과를 초래합니다.
따라서 보다 사실적인 춤 영상 생성을 위해서는 이러한 세부 표현의 보완이 필수적입니다.
더불어, 동영상 생성 모델 전반에도 공통적인 한계가 존재합니다.
생성된 춤 영상에서는 종종 부자연스럽거나 물리적으로 불가능한 동작이 발생하며, 특히 영상 일부 구간에서는 신체 비율이나 구조가 일시적으로 왜곡되는 현상이 관찰됩니다.
이러한 문제들은 실제감을 해치며, 영상의 품질을 저하시킬 수 있습니다.
StableAnimator[4] 같은 최신 모델에서는 이러한 특징이 Pose 시퀀스의 보완을 통해 일부 개선되었지만, 여전히 생성된 영상 중간에 신체 부위의 누락이나 신체 구조 왜곡이 발생합니다.
저희는 그래서 여기로부터 한 단계 더 모델을 보완해보려고 합니다!
2. 연구 목표
저희는 Music-to-Dance 모델에 필요한 모듈 각각의 성능와, 전체적인 생성 결과물 평가를 개선해보고자 합니다.
Music Feature Extraction: 기존에는 주로 Jukebox 임베딩을 그대로 사용하는데, 해당 모델은 다소 옛날 모델이기도 하고, 너무 무거운 측면도 있습니다.
저희 팀이 주로 음악 관련 연구 경험이 있는 만큼, 더욱 적절한 feature extraction model을 적용할 계획입니다
Identity Preservation: 기존 Identity preservation 모델은 전반적인 얼굴의 분위기나 특징은 잘 가져오지만, 세부적인 신체적 특징을 가져오지 못하는 문제가 있습니다.
저희는 여기에 Sapiens[8] 같은 최신 Body-part segmentation 모델을 적용해보고자 합니다.
Music-to-Pose: 모델의 성능 개선을 위해 각 Pose를 GNN 구조를 거쳐 인코딩하거나, 이전 프레임과의 Temporal Displacement를 반영해볼 계획입니다.
StableAnimator[4]에서 개선한 것처럼, 포즈에 반영되는 요소도 추가할 것입니다!
(Pose-conditioned) Video Generation: StableAnimator 모델을 Backbone으로, 속도감 있는 움직임에서 블러처리되는 모션 블러 현상을 해결할 것입니다.
현재는 강화학습 기반의 프레임워크를 통해 개선할 계획입니다.
Evaluation 개선: 기존 생성 결과의 평가는 춤보다는 동영상 생성 평가 결과에 주력한 한계가 있습니다.
저희는 Laban Feature 같은 기존 Movement Analysis Feature를 사용하여 ‘잘 추는 춤’을 생성하도록 개선할 것입니다!
3. 연구 계획
세부 모듈이 많은 만큼, 앞으로 바쁘게 연구를 진행할 계획입니다!
멘토: SK AI R&D Center 박노갑· 전진
참여 멤버: 김이경 · 성민재 · 이도현
5월 OT에서 처음 모인 저희 팀의 화목한 모습입니다! 앞으로도 저희의 연구 기록 주목해주세요!!
참고문헌
[1] Dhariwal, Prafulla, et al. "Jukebox: A generative model for music." arXiv preprint arXiv:2005.00341 (2020).
[2] Huang, Jiehui, et al. "Consistentid: Portrait generation with multimodal fine-grained identity preserving." arXiv preprint arXiv:2404.16771 (2024).
[3] Zhu, Shenhao, et al. "Champ: Controllable and consistent human image animation with 3d parametric guidance." European Conference on Computer Vision. Cham: Springer Nature Switzerland, 2024.
[4] Tu, Shuyuan, et al. "Stableanimator: High-quality identity-preserving human image animation." Proceedings of the Computer Vision and Pattern Recognition Conference. 2025.
[5] Park, Nokap Tony. "STM²PE-Diff: Synthetically Trained Music-to-Pose Encoder Diffusion for Automated Choreography Generation." Proceedings of the Synthetic Data for Computer Vision Workshop @ CVPR. 2025.
[6] Tsuchida, Shuhei, et al. "AIST Dance Video Database: Multi-Genre, Multi-Dancer, and Multi-Camera Database for Dance Information Processing." ISMIR. Vol. 1. No. 5. 2019.
[7] Loper, Matthew, et al. "SMPL: A skinned multi-person linear model." Seminal Graphics Papers: Pushing the Boundaries, Volume 2. 2023. 851-866.
[8] Khirodkar, Rawal, et al. "Sapiens: Foundation for human vision models." European Conference on Computer Vision. Cham: Springer Nature Switzerland, 2024.
anthony200116 님의 최신 블로그
더보기
DEVOTEE 추천 블로그
-
- Virtual Try-On 기술 개발 - 연구계획(1)
- 안녕하세요! 만나서 반갑습니다:D SKT AI Fellowsihp 6기 Virtual Try-On 기술개발 연구를 맡은 팀 루이VTON✨입니다. 저희 팀은 서채준, 이민우, 조성민 으로 구성되어있으며 앞으로 Virtual Try-On 기술을 개발하고 상용화 할 수 있도록 열정을 불태울 것입니다. 저는 루이VTON의 앞으로의 활동기록을 DEVOCEAN inside에 올리게 된 이민우 라고 합니다.😉 그럼 이어서 저희 팀명에 대해서 소개해드리겠습니다😊 0. 팀명 소개 - "루이VTON" 명품 하면 떠오르는 네 글자..✨ 루이비똥 네 맞습니다. 팀 "루이VTON" 은 LOUIS VUITTON(명품 브랜드) + VTON(Virtual Try-ON) 을 결합하여 명품 ...
-
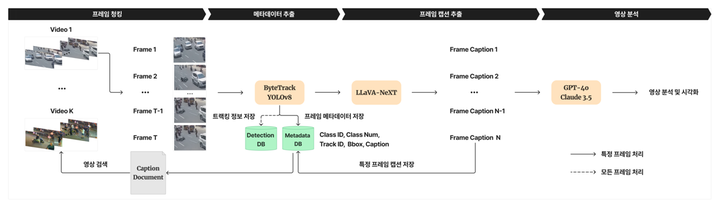
- 대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발 - 연구과정(2)
- 안녕하세요🤗 ~! SKT AI Fellowship 6기 '대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발' 연구를 수행중인 📺텔레토비전 팀📺 입니다 ~! 이번 글에서는 중간 발표까지 진행된 연구 내용과 멘토분들의 피드백을 반영한 향후 계획을 말씀드리고자 합니다. 1. 연구 목표 및 아이디어 💡 연구 배경 및 필요성 기존의 AI를 활용한 지능형 관제 시스템은 사전에 정의된 이벤트만을 탐지하고 분석할 수 있기 때문에 다양한 사용자의 요구를 충족하기 어려움이 있습니다. 관제 시스템 UI는 현재 대부분의 업체가 거의 동일한 형식을 사용하고 있으며, 이는 Open Set 검색 및 분석이 불가능한 한계점을 가지고 있는데요. 본 연구는 대규모 Mul...
-

- 대규모 Multimodal AI 모델을 이용한 영상 검색 시스템 개발 - 연구결과(3)
- 안녕하세요🤗 ~! SKT AI Fellowship 6기 '대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발' 연구를 수행한 📺텔레토비전 팀📺 입니다 ~! 이번 글에서는 지금까지 연구한 내용을 정리하여 말씀드리고자 합니다. 1. 연구 주제 및 목표 💡 연구 배경 및 필요성 기존의 AI를 활용한 지능형 관제 시스템은 사전에 정의된 이벤트만을 탐지하고 분석할 수 있기 때문에 다양한 사용자의 요구를 충족하기 어렵습니다. 또한, 관제 시스템 UI는 현재 대부분의 업체가 거의 동일한 형식을 사용하고 있으며, 이는 Open Set 검색 및 분석이 불가능한 한계점을 가집니다. 따라서, 본 연구는 대규모 Multimodal AI 기술을 이용한 영상 검색 ...
-
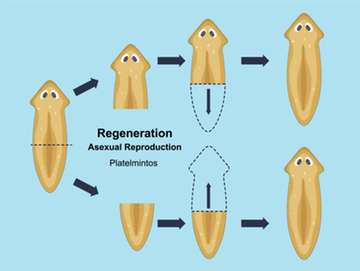
- Planarian팀: 비디오 콘텐츠 내 Planar Tracking 기술 연구 - 연구계획(1)
- 안녕하세요! SKT AI Fellowship 7기에서 "비디오 콘텐츠 내 Planar Tracking 기술 연구" 를 진행할 Planarian 팀입니다!! 앞으로 저희가 연구를 진행하기에 앞서 저희들의 연구 계획을 간략하게나마 소개해드리고자 합니다. 0.팀 소개-Planarian 저희의 팀 이름인 "Planarian" 은 신체를 128조각으로 잘라도 재생될 정도로 강한 생명력으로 유명한 무척추동물로, "Planar" Tracking연구를 "Planarian" 처럼 끈질긴 의지력으로 해낼 것이라는 저희 팀의 강력한 포부를 담고 있습니다! 저희 팀은 김현지, 최희진, 박용현 멘토님들과 김호재, 김용, 김수현 펠로우들로 구성되어 있습니다! 펠로우들은 전부 성균관대학교 ...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.