
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Fillm팀: 효율적인 (M)LLM 학습을 위한 Synthetic Data Filtering - 연구계획(1)

- DEVOTEE 요약
- DEVOCEAN AI Fellowship 7기 Fillm 팀은 멀티모달 데이터 효율성을 위한 Synthetic Data Filtering 연구를 진행 중입니다. 모바일 GUI 에이전트 학습에 중점을 두어 데이터셋 품질(Quality), 난이도(Difficulty), 다양성(Diversity)을 개선하고, 보상모델을 활용해 효율적 경로 생성과 학습 방법을 고도화하려 합니다. 이를 통해 인간 선호도에 부합하며 실행 가능한 GUI 에이전트를 목표로 하고 있습니다.
안녕하세요~ 저희는 DEVOCEAN AI Fellowship 7기,
효율적인 LLM 학습을 위한 Synthetic Data Filtering 과제를 맡게 된 Fillm 팀입니다!
Fillm 팀이란 '채우다'라는 뜻인 Fill 과 Multimodal의 앞글자인 M이 결합된 팀명입니다.
저희가 지원한 과제 설명에는 LLM 에 대한 Synthetic 데이터에 대한 내용이었는데,
저희 팀에서 MLLM에 대한 Synthetic 데이터에 대한 연구로 제안을 하였고 멘토님과의 상의 하에 멀티모달 데이터를 다루게 되었습니다.
그 과정에서 멀티모달의 M을 채웠다는 의미에서 Fillm 이라는 팀명을 짓게 되었습니다.
이번 포스트에서는 연구 과제와 계획을 간단히 소개드리려 합니다.
1. 연구 배경 및 필요성
딥러닝의 발전은 엄청난 양의 데이터로부터 가속화되었다고 해도 과언이 아닙니다.
현재 LLM들은 large corpus에서 다음 토큰을 예측하는 방식으로 학습하여 “그럴듯한 텍스트 생성”뿐 아니라 “추론능력”까지 발현되는 창발적 능력(emergent ability) [21] 을 보여주고 있습니다.
창발적 능력은 소규모 모델에서는 드러나지 않지만, 대규모 모델에서는 드러나는 능력으로, 소규모 모델의 성능 향상을 단순히 추정하는 것으로는 예측할 수 없습니다. - (Zoph et al., 2022) [21]
하지만 그럼에도 특정 복잡한 작업에 LLM을 완벽하게 적응시키기 위해서는 해당 작업에 대한 지시-답변 쌍이 필요합니다.
특히 텍스트 데이터의 경우 사람이 일일이 작성하는 과정이 필요해서 많은 비용이 듭니다.
이 같은 한계를 극복하기 위해 최근에는 AI 모델을 활용해 비교적 저렴하게 대량의 데이터를 생성할 수 있는 synthetic data를 이용하는 연구가 주목받고 있습니다.
그럼에도 불구하고, synthetic data의 신뢰성 문제와, 무분별한 데이터 생성이 모델 학습의 경제성과 효율성에 부정적 영향을 미칠 수 있다는 한계가 여전히 존재합니다.
이러한 문제를 해결하기 위해 최근 텍스트 synthetic data 정제에 대한 연구들이 활발히 진행되고 있습니다.
예를 들어, s1, LIMO [1,2] 와 같은 논문에서는 LLM이 생성한 데이터를 어떻게 정제할 수 있는지,
self-training 관련 연구 [3,4]에서도 self-generated synthetic data를 어떻게 효율적으로 활용할 것인지에 다루고 있습니다.
그림 1: 소규모 데이터로 기존 성능을 능가한 LIMO [2]
한편, 최근 AI 발전의 새로운 방향으로 AI 에이전트가 주목받고 있습니다. 초기에는 텍스트 기반 대화형 에이전트(Conversational agent)이 중심이었으나,
최근에는 다양한 형태의 데이터를 활용하는 멀티모달(Multi-modal)데이터를 사용하는 체화형 에이전트(Embodied agent)까지 다양한 형태로 발전하고 있습니다.
그래서 저희는 AI 에이전트, 특히 멀티모달 기능을 갖춘 에이전트 연구를 하고자 하였습니다.
AI 에이전트란 AI를 사용해 사용자를 대신하여 목표를 추구하고 태스크를 완료하는 소프트웨어 시스템으로, 추론, 계획, 기억이 가능하며 일정 수준의 자율성을 갖고 의사 결정, 학습, 조정을 처리합니다. - [5]
AI 에이전트의 종류는 여러가지가 있지만, 다음의 세 가지 기준들을 고려하여 GUI 에이전트를 연구 대상으로 선정하였습니다.
아카데믹 레벨에서 실험의 접근성이 좋은가?
SKT와의 협업 및 상용화에 높은 시너지를 기대할 수 있는가?
우리에게 흥미롭고 새로운 연구 주제인가?
이러한 기준을 바탕으로, 본 연구는 멀티모달 에이전트 중 가장 구조화된 데이터를 다루며 SKT의 다양한 어플리케이션에 적용가능한,
특히 Web 에이전트에 비해 연구가 상대적으로 덜 진행된 모바일 GUI 에이전트 학습을 위한 synthetic data curation에 초점을 맞추고자 합니다.
그에 따라, 저희 Fillm 팀은 두 가지 핵심 방향성을 갖고 모바일 GUI 에이전트 synthetic data를 curation하고자 합니다.
최소한의 데이터로 최대한의 성능을 달성할 수 있는 Quality - Difficulty - Diversity을 모두 고려한 고효율 GUI 학습 데이터셋 구축
위와 같은 데이터셋을 자동화된 파이프라인으로 생성할 수 있는 알고리즘 개발
Preliminary
전체 파이프라인을 이해하기 위해서는 우선 GUI Agent의 하나의 데이터를 의미하는 경로(Trajectory)에 대해 알아보겠습니다.
경로(Trajectory)
“경로”는 크게 4가지 요소로 구분 되어 있습니다. (그림2 참고)
그림 2: 경로 데이터 설명 (출처:[7])
High-level instruction: 사용자 관점에서 작성된 목표 지향적 지시사항으로 작업의 종류와 관련되는 정보를 포함
(예: “6월 13일 야구 경기 티켓 예매해줘”)
Low-level instruction: 에이전트 관점에서의 각 action 수행 전 제공되는 설명문.
(예: “야구 경기 티켓 예매 사이트를 찾아야 됩니다.”)
Action: Low-level instruction에 따른 에이전트의 행동 (예시: CLICK, TYPE, SCROLL)과 좌표 (x,y 좌표)
(예: “ action: SCROLL, coordinate: [698, 528] ”)
State:
Current state: 에이전트가 입력으로 받는 현재 화면 상태.
Next state: 에이전트의 action 수행 결과로 도달하는 다음 화면 상태.
기존 연구의 한계
경로 데이터셋의 정제와 관련하여 s1[ref]에서 영감을 받은 UI-R1이 있습니다.
해당 연구에서는 quality, difficulty, diversity에 대해서 정의하였고, 각각에 대해서 다음과 같은 한계를 갖습니다.
Quality
표면적 정제 방식에 그침: 단순히 기존 Cleaned Dataset인 ScreenSpot 데이터셋과 AndroidControl을 사용하였으며, 이 중에 잘못 정렬되어 있는 action이 속해있는 경로데이터만 삭제하였는데, 이것은 기존의 데이터에 과의존을 하는 방법론입니다. 특히 Os-Atlas에서는 실제로 ScreenSpot 데이터셋에서 주석 오류가 발견되었음을 지적하였습니다.
미세한 품질 결함 대응 부족: 단순히 명백히 잘못된 경로만 제거하는 것으로는 미세한 품질문제들을 해결할 수 없습니다.
Difficulty
모델 특화적 난이도 정의: UI-R1에서 단일 Qwen2.5-VL-3B 모델의 정답을 맞췄는지 여부만을 기준으로 난이도를 판단했습니다. 이는 해당 특정 모델의 약점에 편향된 난이도 정의를 만들어서, 다른 모델에게는 적절하지 않은 난이도를 제시할 수 있습니다.
단순한 성공/실패 기준, 정적 난이도 평가 방식: 모델의 출력이 ground truth와 일치하지 않으면 “어려움”으로 라벨링하는 이진 분류 방식은 난이도의 세분화된 스펙트럼을 반영하지 못합니다. 실제로는 약간의 실수가 있는 중간 난이도 태스크들이 존재할 수 있으나, 이러한 미묘한 차이를 포착하지 못합니다.
Diversity
형식적 요소에 국한된 다양성 정의: UI-R1에서는 Scroll, Back, Open App, Input Text 등의 액션 유형과 아이콘, 텍스트 등의 요소 유형만을 고려했지만, 시나리오의 다양성 부족을 가져올 수 있습니다.
이러한 한계를 극복하기 위해, 본 연구에서는 Quality, Difficulty, Diversity의 개념을 보다 정교하게 재정의하고,
이를 기반으로 한 고차원적인 데이터 정제 프로세스를 새롭게 설계하고자 합니다.
2. 전체 파이프라인
그림 3: 전체 파이프라인에 대한 개요도
위 그림은 저희 팀이 제시한 전체 파이프라인으로, 아래와 같이 크게 4단계로 나뉩니다. (그림 3 참고)
데이터 수집, 2) 데이터 정제, 3) 선호도 측정, 4) 데이터셋 기반 효율적인 학습
1) 데이터 수집
우선 데이터를 정제하기 위해서는 개방된 GUI synthetic data을 수집할 필요가 있습니다.
이를 위해서는 공개된 데이터셋의 종류와 수집 방식에 대한 이해가 선행되어야 합니다.
GUI 에이전트 synthetic data에 관한 연구는 OS-genesis [6], GUI-Odyssey [7] 등이 있으며,
이들은 특정 목적에 따라 인간이 직접 수집했거나 시뮬레이션 환경에서 데이터를 직접 생성 및 수집한 대표적인 예시입니다.
GUI 에이전트 학습을 위한 다양한 데이터셋을 체계적으로 구축하기 위해, 우리는 데이터 수집 과정을 다음의 세 가지 단계로 구성하고자 합니다.
(1) 기존의 실제 데이터를 기반으로 재구성한 GUI 에이전트 데이터셋
(2) LLM에 의해 생성된 high-level instruction
(3) synthetic high-level instruction 바탕으로 GUI 에이전트가 생성한 synthetic trajectory
그림 4: (1) 개방된 데이터를 재구성한 GUI 에이전트 데이터셋
그림 5: (2), (3) LLM으로 생성된 high-level instruction으로 GUI 에이전트가 수행한 Synthetic Trajectory 생성
2) 데이터 정제 (기준: Quality, Difficulty, Diversity)
GUI 에이전트와 관련된 모든 데이터셋을 수집했다고 가정해봅시다.
과연 이 데이터가 모두 사용될 필요가 있을까요?
모든 데이터를 그대로 사용하는 것은 모델 성능 저하나 학습 효율 저하로 이어질 수 있습니다.
이는 특히 이질적인 데이터셋들 간 품질 차이나 high-level instruction의 중복, 노이즈가 큰 경우 더욱 문제될 수 있습니다. 이러한 이유로 데이터셋 정제 과정이 필요합니다.
하지만 UI-R1은 다음과 같은 한계점이 있습니다.
Quality 측면에서 검수 기준이 형식적 오류나 논리적 일관성 위주로만 설정되어 있고, 완전히 자동화된 파이프라인이라고 보기 어렵습니다.
Difficulty 측면에서 단일 에이전트의 평가에 의존하여 다양한 에이전트에 대한 평가 실험이 뒷받침되지 못했습니다.
Diversity 측면에서 수학, 물리 등 특정 도메인에 국한되어 있고, GUI 에이전트 도메인은 고려하지 못했습니다.
따라서, 저희 팀은 UI-R1의 3가지 기준을 바탕으로 해당 기준을 재정의하여 데이터셋을 정제하고자 합니다.
2-1) 품질(Quality)
그림 6: Quality 정제 단계 파이프라인
Quality 단계에서는 4단계로 구분된 자동화된 파이프라인을 설계하여 진행하고자 합니다.
(1) 데이터 분할: 전체 데이터셋을 랜덤하게 여러 개로 분할합니다.
(2) 분할된 데이터에서 각각 모델 학습: 각 분할된 데이터셋을 사용하여 별도의 모델을 학습합니다. 이 과정은 각 모델이 각각의 고유한 데이터만을 학습하게 하여, 다른 데이터에 대한 편향을 최소화하는데 목적이 있습니다.
(3) 비학습 데이터셋에서 교차 추론: 각 모델은 자신이 학습하지 않은 분할 데이터셋에 대해 추론을 수행합니다. 이를 통해 모델이 보지 못한 데이터에 대한 일반화 능력을 평가할 수 있으며, 단순한 학습 샘플의 암기가 아닌 추론 능력을 확인할 수 있습니다.
(4) 원본 학습 데이터와 교차 추론된 데이터의 비교 및 분류: 원본 데이터와 교차 추론된 경로를 비교하여, 불일치가 발생하는 데이터를 식별합니다. 이러한 차이를 기반으로 보상모델 등 추가적인 기준을 적용해 더 우수한 경로 데이터를 선정하여 고품질 데이터셋을 구축합니다.
이러한 방법론은 ILR [9]에서 제시된 바 있으며, 모델이 경로 데이터의 품질을 스스로 반복적으로 개선할 수 있도록 할 수 있다는 장점이 있습니다.
저희 팀은 이를 한 단계 더 고도화하여, GUI 에이전트에 최적화된 방식으로 두 데이터 중 더 우수한 경로를 선택하는 기준과 절차를 정교하게 설계할 예정입니다.
2-2) 난이도(Difficulty)
Difficulty 단계에서는 Trajectory 데이터를 바탕으로 실패 비율(Fail-rate)을 계산하여 Difficulty를 측정하고자 합니다.
그림 7: Difficulty 기반 데이터 정제 파이프라인, [10]
본 연구에서는 UI-R1과 다르게, 다양한 에이전트를 활용하여 fail rate를 측정하고, 이를 바탕으로 어려운 문제와 그렇지 않은 문제를 구분합니다.
이후, Diffculty 측면에서 다양한 조합에 대해 분석 실험을 수행하여 어떤 조합이 모델의 성능 상승에 더 효과적인지 검증하고자 합니다.
2-3) 다양성(Diversity)
마지막 단계는 Diversity를 고려하는 단계입니다. Diversity는 실제 환경에서의 일반화 성능에 결정적인 영향을 미치는 핵심 요소 중에 하나입니다.
본 연구에서는 GUI 에이전트 데이터셋의 다양성을 도메인(Domain)과 경로(Trajectory) 측면에서 세분화하여 관리하고자 합니다.
도메인 (Domain)
본 연구에서는 다음 세 가지 기준을 중심으로 다양성을 재정의합니다.
태스크 종류: 일반 조작, 정보 관리, 쇼핑, SNS, 미디어 등
어플 종류: 인스타그램, 링크드인, 유튜브, X, 틱톡, 문서, 지도 등
기기 종류: 갤럭시, 픽셀, 태블릿 등
이와 더불어, 데이터셋 내 특정 도메인이 부족할 경우, LLM 또는 MLLM을 활용하여 새로운 도메인을 생성함으로써 다양성을 보완할 계획입니다.
그림 8: 에이전트의 태스크, 어플, 기기 종류 도메인-[7]
경로 (Trajectory)
경로의 다양성은 GUI 에이전트의 일반화 능력과 실제 환경 적응력에 매우 중요한 요소입니다.
예를 들어, GUI 환경에서 동일한 태스크를 수행할 때, 에이전트가 선택할 수 있는 경로는 단일하지 않고, 다양한 방식으로 목표에 도달할 수 있습니다.
이러한 다양성은 실제 환경에서의 강건성과 유연성을 높이며, 데이터셋의 품질과 신뢰성에도 직접적으로 기여합니다
따라서, 본 연구에서는 모든 경로를 임베딩이나 gradient 등 다양한 representation을 활용해 클러스터링함으로써 경로 간 중복을 방지하고, 의미적으로 다양한 경로만을 선별하여 데이터셋을 구성하고자 합니다.
이상으로 data curation 단계에서는 경로의 다양성을 체계적으로 확보하는 데 중점을 두었습니다.
이후에는, 이렇게 큐레이션된 데이터를 활용해 모델을 어떻게 더 효율적으로 학습시킬 수 있을지에 대한 전략을 논의하고자 합니다.
3) 보상함수 설계
정제된 데이터로 단순히 지도학습(Supervised Fine‑Tuning)을 적용하는 것도 가능하지만,
에이전트가 생성한 다양한 경로 데이터를 활용하여 모델을 한 단계 더 고도화하는 방안 역시 적극적으로 고려하고 있습니다.
최근에는 생성형 AI 모델을 학습하는 데 있어 RLHF(Reinforcement Learning from Human Feedback) 방식이 특히 효과적인 방법으로 각광받고 있습니다.
이 접근의 핵심은 인간의 피드백을 반영한 보상함수(reward function)를 설계해 선호도를 정량화하는 데 있습니다.
사람이 여러 후보 출력 중 선호 순위를 매기면, 이 데이터를 학습한 보상모델이 생성된 표현이 “얼마나 인간에게 타당한지”를 평가하고,
이를 바탕으로 정책(policy)을 강화 학습 단계에서 최적화합니다
예를 들어 TMap에서 경로를 검색할 때, 사용자는 단순히 목적지까지 가는 것뿐 아니라, 최단 경로, 교통 회피 경로, 개인 선호 기반 우회 경로 등 상황과 취향에 맞는 경로를 선택합니다.
이는 인간의 선호도가 성공 여부 이상의 여러 기준에 기반함을 보여줍니다.
이러한 선호도를 직접 수집·정밀 판정하기 위해선 전문가의 고차원적 인지 판단이 필요하며, 이에 따른 시간과 비용 부담이 큽니다.
그래서 대부분의 기존 연구들은 rule‑based reward, 즉 에이전트가 단순 목표를 달성했는지 정도만 평가하는 방식에 의존했습니다.
하지만 이 방식엔 아래와 같은 한계가 있습니다:
정해진 규칙을 준수했다고 해서 최적 경로라고 할 수 없음
룰을 충족하지 않더라도 유익한 경로가 있을 수 있음
이를 극복하기 위해 본 연구에서는 rule‑based 방식 대신, GPT‑4o 등 frontier LLM 또는 별도의 보상모델(reward model) 학습을 통해 경로 간 선호도를 정량화하려 합니다.
이를 통해 정답 도달 여부보다 유익한 경로에는 긍정적 피드백을, 그렇지 않은 경로에는 적절한 감점을 줄 수 있는 시스템을 구현하고자 합니다.
특히 GUI 에이전트가 생성해야 하는 바람직한 경로의 특성을 아래 두 축으로 정의하였습니다:
경로의 효율성 (Efficiency of Trajectory)
불필요한 클릭과 탐색 없이 최단 경로로 목표를 달성하는 것은 에이전트의 전략적 계획능력을 드러내는 핵심 요소입니다.
Low‑level instruction의 합리성 (Rationality of Low‑Level Instructions)
각 행동 지시는 사용자 입장에서 명확하고 직관적이어야 하며, 복잡하고 난해한 조작보다 단순·이해하기 쉬운 명령 순서를 따르는 것이 바람직합니다.
이는 에이전트의 설명 가능성과 안정적 실행에 직결됩니다.
이 두 기준을 바탕으로 경로 간 상대적 선호도(preference ranking)를 모델이 학습할 수 있게 구성함으로써, 인간의 선호에 부합하며 보다 정교한 경로 선택 능력을 갖춘 GUI 에이전트를 목표로 합니다.
사후 학습(post‑training) 단계에서는 최소한의 선호도 데이터셋을 기반으로, PPO[14], DPO[15], GRPO[16], ORPO[17], SimPO[18], KTO[19] 등 주요 RLHF 기법을 비교 적용할 계획입니다.
이를 통해 모델의 **경로 품질(Quality of Trajectory)**과 **사고 흐름(Reasoning Process)**이 인간 선호도와 더욱 정합적인 방향으로 고도화될 수 있기를 기대합니다.
4) 데이터셋 평가
기존 연구들은 높은 Visual Grounding 성능을 보이지만, 인간에 비해 high-level instruction에 대한 성공률(success rate)은 여전히 낮은 수준에 머물러 있습니다.
Visual Grounding이란 텍스트 정보가 내포하는 영역을 정확하게 찾아내는 태스크입니다.
이는 해당 태스크가 실제 응용 과정에서 신뢰성 높은 성능을 발휘하기 위해 아직 많은 개선이 필요함을 시사합니다.
특히, 현재 static한 평가 지표나 고정된 high-level instruction 기반 벤치마크는 실사용 환경에서의 적용성이나 일반화 능력을 충분히 반영하지 못하는 한계가 있습니다.
이러한 한계를 극복하기 위해서 high-level instruction의 다양성과 맥락 변화에 유연하게 반응할 수 있는 dynamic benchmark가 필요합니다.
Dynamic benchmark는 모델이 고정된 데이터셋이 아닌, 상황에 따라 instruction의 목적이나 조건이 변화하는 환경을 기반으로 모델을 평가함으로써,
얼마나 일관되게 사용자의 의도를 파악하고 정확한 visual grounding을 수행할 수 있는지 평가합니다.
그림 9: Visual Grounding 성능, [12]
그림 10: 에이전트와 인간의 Success Rate, [12]
3. 연구 계획
저희의 연구 계획은 다음과 같습니다.
4. 팀원 소개
무엇보다도, 팀원 모두 Data-Centric AI Agent 연구에 관한 강한 집념과, AI 모델이 현업에서 어떻게 사용되는지에 대한 호기심을 보유하고 있습니다.
AI 모델 연구와 제품에 어떻게 적용될지 깊게 고민하며, 5개월동안 열심히 달려보겠습니다 !!
Reference
[1] s1: Simple test-time scaling, arXiv 2025
[2] LIMO: Less is More for Reasoning, arXiv 2025
[3] BPO: Towards Balanced Preference Optimization between Knowledge Breadth and Depth in Alignment, NAACL 2025
[4] AdaSTaR: Adaptive Data Sampling for Training Self-Taught Reasoners, arXiv 2025
[5] Google Cloud, AI 에이전트란 무엇인가요? 정의, 예시, 유형, https://cloud.google.com/discover/what-are-ai-agents?hl=ko
[6] OS-genesis: Automating GUI Agent Trajectory Construction via Reverse Task Synthesis, ACL 2025
[7] GUI Odyssey: A Comprehensive Dataset for Cross-App GUI Navigation on Mobile Devices*,* arXiv 2024
[8] AndroidWorld: A Dynamic Benchmarking Environment for Autonomous Agents, ICLR 2025
[9] Iterative Label Refinement Matters More Than Preference Optimization Under Weak Supervision, ICLR 2025 Spotlight
[10] DART-Math: Difficulty-Aware Rejection Tuning for Mathematical Problem-Solving, NeurIPS 2024
[11] UI-R1: Enhancing Efficient Action Prediction of GUI Agents by Reinforcement Learning, arXiv 2025
[12] OS-Atlas: A Foundation Action Model for Generalist GUI Agents, ICLR 2025 Spotlight
[13] Scaling Relationship on Learning Mathematical Reasoning with Large Language Models, arXiv 2023 ****
[14] Training language models to follow instructions with human feedback, NeurIPS 2022
[15] Direct Preference Optimization: Your Language Model is Secretly a Reward model, NeurIPS 2023
[16] DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models, deepseek technical report 2024
[17] ORPO: Monolithic Preference Optimization without Reference Model, EMNLP 2024
[18] SimPO: Simple Preference Optimization with a Reference-Free Reward, NeurIPS 2024
[19] KTO: Model Alignment as Prospect Theoretic Optimization, ICML 2024
[20] On the Effects of Data Scale on UI Control Agents, NeurIPS 2024
[21] Emergent abilities of large language models, TMLR 2022
jslee42 님의 최신 블로그
더보기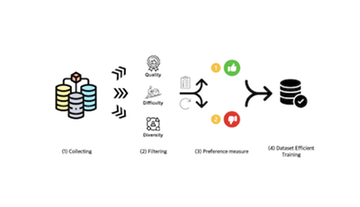
DEVOTEE 추천 블로그
-
- On Device상의 (인지/판단/실행) 모델 파이프라인 기술 개발 - 연구계획(1)
- 안녕하세요 🐰 저희는 On Device상의 (인지/판단/실행) 모델 파이프라인 기술 개발 과제를 수행 중인 SKT AI Fellowship 6기 O.DA (On Device AI) 팀 이선민, 장윤서, 권수영 입니다. 이번 포스트에서는 저희가 진행하고 있는 연구 과제 소개 및 연구 계획에 대해 말씀드리겠습니다. 1. 연구 배경 1-1. On-Device AI The proliferation of personalized experiences delivered via mobile applications has been a dominant theme of the last decade of personal computing. On Device AI는 디바이스 내 NPU...
-
- 대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발 - 연구과정(2)
- 안녕하세요🤗 ~! SKT AI Fellowship 6기 '대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발' 연구를 수행중인 📺텔레토비전 팀📺 입니다 ~! 이번 글에서는 중간 발표까지 진행된 연구 내용과 멘토분들의 피드백을 반영한 향후 계획을 말씀드리고자 합니다. 1. 연구 목표 및 아이디어 💡 연구 배경 및 필요성 기존의 AI를 활용한 지능형 관제 시스템은 사전에 정의된 이벤트만을 탐지하고 분석할 수 있기 때문에 다양한 사용자의 요구를 충족하기 어려움이 있습니다. 관제 시스템 UI는 현재 대부분의 업체가 거의 동일한 형식을 사용하고 있으며, 이는 Open Set 검색 및 분석이 불가능한 한계점을 가지고 있는데요. 본 연구는 대규모 Mul...
-
- 밤티팀: 추론 기반 한국어 AI 성능-안전성 최적화(Task-aware Deliberative Alignment) - 연구계획(1)
- 안녕하세요~!! 저희는 DEVOCEAN Ai fellowship 연구과제 02. 추론 기반 한국어 AI 성능-안전성 최적화: Task-aware Deliberative Alignment 프로젝트에 참여하게 된 팀 밤티 the striker 입니다. 1. 연구 과제 아이디어 1.1. 연구 배경 최근 범용 LLM은 다양한 언어, 분야, 응용 환경에서 강력한 성능을 보이며 폭넓게 활용되고 있습니다. 그러나 이와 동시에, **LLM의 안전성(safety)**에 대한 우려도 크게 증가하고 있습니다. 기존의 LLM의 safety alignment는 주로 간접 데이터를 활용한 Supervised Fine-Tuning(SFT) 또는 Reinforcement Learning fr...
-

- Fillm팀: 효율적인 (M)LLM 학습을 위한 Synthetic Data Filtering - 연구과정(2)
- 안녕하세요! 효율적인 Multimodal GUI-Agent 학습을 위한 synthetic data filtering을 수행하고 있는 Film팀의 김동희입니다. 오늘은 저희 연구의 시작을 알렸던 지난 연구계획(1) 포스팅에 이어서 연구과정(2)라는 제목으로 중간 발표까지의 여정과 결과에 대해서 말씀드리려 합니다. 지난 번 저희 연구 과제를 소개하는 글에서 text에서는 잘 filtering된 소수의 데이터가 다수의 데이터를 사용했을 때 보다 성능을 압도할 수 있음을 이전 연구에서 보였고 이를 multimodal로 확장, 특히 GUI-Agent를 학습하기 위한 데이터를 잘 정제해보자는 목표를 세웠습니다. 이 때 text data를 filtering 할 때 잘 작동되었...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.