
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
GADA팀: 효율적인 Generative AI for Discriminative AI 기술 개발 - 연구계획(1)

- DEVOTEE 요약
- Team "GADA"는 데이터 분포와 특성을 활용해 특정 태스크에 적합한 소형 AI 모델을 자동 생성하는 기술을 개발하고 있습니다. 이 연구는 제한된 자원 환경에서도 효율성과 성능을 극대화하여, 특히 tabular 데이터 처리에 적합한 맞춤형 모델 개발을 목표로 하며, Hypernetwork와 AutoML 기술 등을 활용합니다. 이를 통해 AI 개발 시간과 자원 소모를 줄이고, 다양한 산업에서 실질적으로 활용 가능한 경량 AI 솔루션을 제공하고자 합니다.
안녕하세요!
저희는 Team “GADA” 입니다!
저희 팀명은 주제인 "효율적인 Generative AI for Discriminative AI 기술 개발" 에서 따온 GADA이며, 성장하며 목표를 향해 나아가다는 뜻을 담고 있습니다.
저희 팀의 프로젝트를 간단히 소개드리면, 데이터의 분포와 특성을 기반으로 자동으로 Small 모델을 생성하는 기술을 연구하는 것입니다.
기존의 점진적 업데이트 방식에서 벗어나, 데이터 기반의 모델 생성 과정을 자동화함으로써 AI 개발의 효율성을 극대화하고,
제한된 자원 환경에서도 실용적인 성능을 발휘할 수 있는 경량 모델을 구축하는 것이 목표입니다!
먼저 저희 팀원들을 간략하게 소개 드리겠습니다.
👋팀원 소개
1. 연구 배경
1.1 연구의 필요성
현재 인공지능 분야는 GPT, BERT와 같은 대규모 언어 모델과 이미지 생성 모델의 급속한 발전으로 큰 주목을 받고 있습니다.
지만 이러한 발전은 막대한 계산 자원과 에너지 소비를 동반하고 있으며, 특히 GPU 자원에 대한 의존도가 극도로 높아져 AI 기술의 접근성과 지속가능성에 대한 우려가 제기되고 있습니다.
실제 비즈니스 환경에서 가장 많이 다루어지는 데이터 형태는 tabular 데이터입니다.
금융, 의료, 제조, 마케팅 등 대부분의 산업 분야에서 생성되는 데이터는 구조화된 테이블 형태로 존재하며, 이러한 데이터에 대한 효율적인 AI 솔루션의 필요성이 날로 증가하고 있습니다.
하지만 현재의 AI 개발 패러다임은 범용 대형 모델 중심으로 진행되어, tabular 데이터 처리에 특화된 효율적인 솔루션의 개발이 상대적으로 더디게 발전하고 있습니다.
바로 이런 문제를 해결하기 위해 저희 팀은 데이터 분포를 활용한 Small 모델 생성 기술을 연구하게 되었습니다. 이제 이 분야의 기술 동향부터 차근차근 살펴보겠습니다!
1.2 기술 동향
1.2.1 Hypernetwork
Hypernetwork는 다른 네트워크의 가중치를 동적으로 생성하는 네트워크로, 2017년 Ha et al.의 연구가 시작이라고 할 수 있습니다.
기존의 고정된 가중치를 사용하는 전통적인 신경망과 달리, 입력 조건이나 데이터 특성에 따라 타겟 네트워크의 파라미터를 적응적으로 생성할 수 있다는 점이 가장 큰 특징입니다.
이러한 특성 때문에 Hypernetwork는 메타 학습의 도구로도 활용되고 있으며, 특히 데이터 분포에 따라 최적화된 모델을 자동으로 생성하는 용도로 주목받고 있습니다.
최근에는 few-shot learning, continual learning, neural architecture search 등 다양한 분야에서 응용되고 있으며, 작은 데이터셋에 대한 빠른 적응 능력이 입증되고 있습니다.
그림1. HyperFast: Instant Classification for Tabular Data
1.2.2 데이터 분포 기반 모델 생성 연구
현재 AI 모델 개발에서는 범용 대형 모델을 다양한 태스크에 적용하는 것이 주류를 이루고 있지만, 이는 제한된 자원 환경에서 비효율적이라는 문제가 있습니다.
최근 연구들은 데이터의 통계적 특성과 분포를 분석하여 해당 데이터에 최적화된 모델 구조를 자동으로 설계하는 방향으로 발전하고 있습니다.
특히 tabular 데이터 분야에서는 데이터의 차원, 범주형/수치형 변수 비율, 클래스 불균형 정도 등의 분포 특성이 모델 성능에 큰 영향을 미치는 것으로 알려져 있어,
이를 활용한 맞춤형 모델 생성에 대한 관심이 높아지고 있습니다.
그림2. MotherNet: Fast Training and Inference via Hyper-Network Transformers
1.2.3 경량화 및 효율적 AI 모델 연구
기존의 모델 경량화 연구는 주로 대형 모델을 사후에 압축하는 방식(pruning, quantization, knowledge distillation)에 집중되어 있었습니다.
하지만 이런 접근법은 여전히 초기에 대규모 자원이 필요하다는 한계가 있습니다.
최근에는 처음부터 효율적인 소형 모델을 생성하는 연구가 주목 받고 있으며,
특히 Neural Architecture Search(NAS)와 AutoML 기술을 활용하여 주어진 제약 조건 하에서 최적의 경량 모델을 찾는 연구들이 활발히 진행되고 있습니다.
하지만 대부분 이미지나 자연어 처리에 집중되어 있으며 막대한 비용이 필요합니다.
그림3. Neural Architecture Search with Reinforcement Learning
이러한 기술 동향을 종합해보면, 기존의 접근법들은 이미 학습된 대형 모델이 필요하거나 막대한 비용이 필요하다는 근본적인 한계가 있습니다.
데이터 분포를 분석하여 최적화된 Small 모델을 자동으로 생성하는 저희의 연구 방향이 현재 기술 격차를 해결할 수 있는 중요한 접근법임을 알 수 있습니다.
처음부터 효율적인 소형 모델을 자동으로 생성하는 접근법, 즉 데이터의 특성을 분석해서 그에 맞는 최적의 모델을 직접 만들어내는 연구는 상대적으로 미흡한 상황입니다.
💡바로 이 지점이 저희 연구가 기여할 수 있는 핵심 영역이라고 생각합니다!
2. 연구 목표 및 계획
2.1 연구 목표
2.1.1 전체 목표
데이터 분포를 참조하여 최적의 모델 생성 기술을 통해 제한된 자원 환경에서도 실용적으로 활용 가능하며, AI 개발 과정의 시간과 자원 소모를 최소화하여 다양한 응용 분야에서 효율성과 성능을 동시에 향상시키는 것입니다.
2.1.2 세부 목표
데이터 분포 분석 기술 개발: Tabular 데이터의 통계적 특성과 분포를 자동으로 분석하여 최적의 모델 구조를 결정하는 기술 개발
제한된 자원 환경 최적화: 제한된 자원 환경에서도 높은 성능을 발휘할 수 있는 Small 모델을 자동으로 생성하는 기술 구현
모델 생성 과정 최적화: AI 개발 과정에서의 시간과 자원 소모를 최소화하면서도 성능을 향상시키는 자동화 시스템 구축
2.2 연구 계획
2.2.1 기반 기술 구축
데이터의 특성과 분포를 기반으로 최적의 소형 모델 아키텍처를 생성하는 hypernetwork 아키텍처 설계
Tabular 데이터의 고유한 특성(feature 간 상관관계, 결측값, 범주형/수치형 데이터 혼재 등)을 효과적으로 처리하는 생성 메커니즘 및 모듈 구현
2.2.2 핵심 기술 개발
사용자 입력 데이터를 분석하여 자동으로 최적 모델을 생성하는 end-to-end 시스템 개발
제한된 자원 환경에서도 높은 성능을 발휘하는 경량화된 discriminative 모델 생성
다양한 tabular 데이터셋에 대해 빠른 모델 생성과 즉시 활용 가능한 수준의 적응적 성능 확보
CPU 환경에서도 원활한 추론이 가능한 모델 크기와 연산 복잡도 최적화
2.2.3 실용화 및 벤치마킹
실제 비즈니스 환경 및 제한된 자원 환경에서의 효율성 측정
다양한 도메인의 실제 tabular 데이터셋을 활용한 성능 평가
기존 tree-based 모델 및 딥러닝 모델과의 성능 비교 분석
모델 크기, 추론 속도, 메모리 사용량 등 효율성 지표에 대한 정량적 평가
연구 결과 정리 및 논문 작성
2.3 기대 효과
2.3.1 기술적 기대 효과
데이터 특성에 맞는 맞춤형 AI 모델 자동 생성 기술 확보
자원 효율성 달성
개발 시간 단축을 통한 AI 적용 가속화
2.3.2 산업적 기대 효과
자원 희소한 분야에서 AI 기술 접근성 향상
다양한 산업 분야에서의 실용적 AI 솔루션 제공 및 디지털 격차 해소에 기여
저희 팀은 실제 비즈니스 환경에서 바로 활용할 수 있는 혁신적인 AI 기술을 개발하고자 합니다!
📅 3. 연구 일정 계획
📋 4. Ground Rule
항목 | 내용 |
|---|---|
협업 툴 | Notion, GitHub |
펠로우 미팅 | 온라인 주 2회 (수, 토) 오프라인 월 1회 |
멘토님 미팅 | 6~7월: 주 1회 월 2~3시 (SKT T타워) 8월~: 격주 월 2~3시 |
💪 열정과 협업으로 열심히 연구를 수행하여 좋은 성과를 내는 GADA 팀이 되겠습니다!
🙏 긴 글 읽어주셔서 감사합니다!
Reference
Ha, D., Dai, A., & Le, Q. V. (2017). HyperNetworks. In Proceedings of the 5th International Conference on Learning Representations (ICLR 2017). https://openreview.net/forum?id=rkpACe1lx
Pfisterer, L., Angerer, J., Heese, R., & Pfister, T. (2022). TabPFN: A Pretrained Transformer for Tabular Data. arXiv preprint arXiv:2207.01848. https://arxiv.org/abs/2207.01848
Pfisterer, L., Angerer, J., Heese, R., & Pfister, T. (2025). MotherNet: Fast Small Model Generation via Structural Priors. In Proceedings of the 6th International Conference on Learning Representations (ICLR 2025). https://openreview.net/forum?id=6H4jRWKFc3
Bonet, D., Mas Montserrat, D., Giró-i-Nieto, X., & Ioannidis, A. G. (2024). HyperFast: Instant Classification for Tabular Data. Proceedings of the AAAI Conference on Artificial Intelligence, 38(10), 11114-11123. https://doi.org/10.1609/aaai.v38i10.28988
Arik, S. Ö., & Pfister, T. (2021). TabNet: Attentive Interpretable Tabular Learning. Proceedings of the AAAI Conference on Artificial Intelligence, 35(8), 6679-6687. https://ojs.aaai.org/index.php/AAAI/article/view/16719
Huang, X., Khetan, A., Cvitkovic, M., & Karnin, Z. (2020). TabTransformer: Tabular Data Modeling Using Contextual Embeddings. arXiv preprint arXiv:2012.06678. https://arxiv.org/abs/2012.06678
M. Lin, Awesome AutoML Papers, GitHub, 2020. Available: https://github.com/hibayesian/awesome-automl-papers.
B. Zoph and Q. V. Le, Neural Architecture Search with Reinforcement Learning, in International Conference on Learning Representations (ICLR), 2017. https://arxiv.org/pdf/1611.01578
7기_조형서 님의 최신 블로그
더보기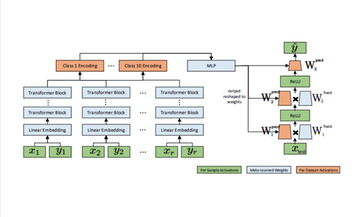
DEVOTEE 추천 블로그
-
- On Device상의 (인지/판단/실행) 모델 파이프라인 기술 개발 - 연구계획(1)
- 안녕하세요 🐰 저희는 On Device상의 (인지/판단/실행) 모델 파이프라인 기술 개발 과제를 수행 중인 SKT AI Fellowship 6기 O.DA (On Device AI) 팀 이선민, 장윤서, 권수영 입니다. 이번 포스트에서는 저희가 진행하고 있는 연구 과제 소개 및 연구 계획에 대해 말씀드리겠습니다. 1. 연구 배경 1-1. On-Device AI The proliferation of personalized experiences delivered via mobile applications has been a dominant theme of the last decade of personal computing. On Device AI는 디바이스 내 NPU...
-
- 대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발 - 연구과정(2)
- 안녕하세요🤗 ~! SKT AI Fellowship 6기 '대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발' 연구를 수행중인 📺텔레토비전 팀📺 입니다 ~! 이번 글에서는 중간 발표까지 진행된 연구 내용과 멘토분들의 피드백을 반영한 향후 계획을 말씀드리고자 합니다. 1. 연구 목표 및 아이디어 💡 연구 배경 및 필요성 기존의 AI를 활용한 지능형 관제 시스템은 사전에 정의된 이벤트만을 탐지하고 분석할 수 있기 때문에 다양한 사용자의 요구를 충족하기 어려움이 있습니다. 관제 시스템 UI는 현재 대부분의 업체가 거의 동일한 형식을 사용하고 있으며, 이는 Open Set 검색 및 분석이 불가능한 한계점을 가지고 있는데요. 본 연구는 대규모 Mul...
-
- AI Chatbot for Data Analytics Text2SQL - 연구결과(3)
- 안녕하세요! 저희는 'AI Chatbot for Data Analytics Text2SQL' 주제를 연구한 skql팀 입니다. 이번 포스트에서는 10월 31일 진행되었던 최종발표에서 발표한 저희 주제 및 내용을 공유드리겠습니다. 1. Background 연구배경 SQL은 데이터베이스에서 자료를 처리하는 용도로 사용되는 구조적 데이터 질의 언어이며, SQL을 통해 사용자들은 데이터베이스에서 쉽게 자료를 찾거나 저장할 수 있습니다. 데이터 분석을 통해 인사이트를 발견하는 것부터, 파이프라인 개발이나 프로그래밍에 활용하는 등 다양한 곳에 데이터가 사용되면서 SQL의 중요성이 증가하는 추세입니다. IDCube (ICT Infra의 data warehouse 및 분석 환경...
-

- GADA팀: 효율적인 Generative AI for Discriminative AI 기술 개발 - 연구과정(2)
- 안녕하세요! 저희는 Team “GADA” 입니다! 저희가 풀고자 하는 문제는 다소 오래되었지만 여전히 해결되지 않은 주제입니다. 바로 Tabular 데이터와 결측치(Missing Value) 문제입니다. 기존의 점진적 업데이트 방식에서 벗어나, 데이터 기반의 모델 생성 과정을 자동화함으로써 AI 개발의 효율성을 극대화하고, 제한된 자원 환경에서도 실용적인 성능을 발휘할 수 있는 경량 모델을 구축하는 것이 목표입니다! 이전에 작성했던 내용에 이어 진행된 내용들과 앞으로의 계획에 내용에 대해서 말씀드리도록 하겠습니다! 왜 Tabular 데이터인가? AI 연구에서 텍스트, 이미지, 음성 같은 데이터는 많은 관심과 성과를 얻어왔습니다. 반면, 정작 모든 산업에서 기본적으...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.