
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
쿠버네티스를 활용한 검색추천 시스템 구축과 미디어 에이전트 적용 사례

- DEVOTEE 요약
- 이번 블로그에서는 검색서비스팀이 쿠버네티스를 활용해 컨테이너 기반 검색추천 시스템을 어떻게 구축했고, 이를 에이닷 3.0 및 B tv 셋탑의 미디어 에이전트 서비스에 도입했는지 소개합니다. 쿠버네티스의 사용으로 반복적인 작업의 자동화, 빠른 서비스 배포, 중앙 집중화된 모니터링 등 개발 및 운영 효율성을 크게 향상할 수 있었습니다. 저희 팀은 안정적인 쿠버네티스 클러스터 구축, 컨테이너 기반 검색추천 시스템 배포, 애플리케이션 모니터링 시스템 구축 등의 목표를 통해 현실적인 문제 해결 및 서비스 최적화를 이루었습니다.
시작하며
안녕하세요. 저는 검색서비스팀의 유성규입니다. 저희 팀은 에이닷 내 다양한 서비스에 사용되는 검색 및 추천 기능 개발과 운영에 주력하고 있습니다.
이번 블로그에서는 저희가 어떻게 쿠버네티스를 이용해 컨테이너 기반 검색추천 시스템을 구축했는지,
그리고 이 시스템이 에이닷 3.0 및 B tv 셋탑에서 출시된 미디어 에이전트 서비스에 어떻게 도입되었는지를 소개하고자 합니다.
쿠버네티스를 사용하여 검색추천 시스템을 컨테이너화함으로써 여러 가지 중요한 이점을 얻을 수 있었습니다. 주요 이점은 다음과 같습니다.
개발 및 운영 효율성 향상: 반복적인 작업들을 자동화하며 개발과 운영 과정을 간편하고 효과적으로 관리할 수 있었습니다.
빠른 서비스 배포: 필요한 컴포넌트를 쉽게 배치하여 검색추천 서비스를 빠르게 제공했습니다.
중앙 집중화된 모니터링 도입: 모든 서비스 상태를 중앙에서 통합적으로 모니터링하고 관리할 수 있어 문제 해결과 운영 관리를 더욱 쉬웠습니다.
쿠버네티스를 통해 효율성 및 자동화를 실현하기 위해, 저희가 세운 주요 목표는 다음과 같습니다.
상용화 가능한 쿠버네티스 클러스터 구축: 안정적이고 확장 가능한 쿠버네티스 클러스터를 구축하여, 다양한 서비스가 원활하게 운영될 수 있도록 합니다.
검색추천 시스템을 컨테이너로 배포: 기존의 검색추천 시스템을 컨테이너 기반으로 전환하여, 서비스의 유연성과 확장성을 확보합니다.
컨테이너 기반의 애플리케이션 모니터링 시스템 구축: 컨테이너 환경에서 효율적인 모니터링 시스템을 구축하여, 서비스 운영 상태를 실시간으로 확인하고 관리할 수 있도록 합니다.
본 글에서는 목표를 달성하기 위한 진행한 작업들에 대해서 전체적으로 공유하고자 합니다.
쿠버네티스 클러스터 구축
쿠버네티스(Kubernetes)는 API 서버, 스케줄러, 컨트롤러 매니저 등으로 구성된 컨트롤 플레인과 각 노드에 설치되는 Kubelet 데몬을 포함하고 있습니다.
이 시스템은 컨테이너 런타임과 네트워킹 기반 위에서 작동하며, 대부분의 컴포넌트는 리눅스 커널 기능에 크게 의존합니다.
따라서 리눅스 커널 설정 및 파라미터 관리가 매우 중요합니다.
쿠버네티스 클러스터를 초기화하는 작업은 kubeadm 도구로 지원되지만, 컨테이너 런타임 구성, 네트워킹 설정, 리눅스 커널 파라미터 조정 등 다양한 세부 사항의 관리는 여전히 클러스터 관리자의 책임입니다.
이는 여러 공식 문서를 따르면서 진행할 수도 있지만, 이 방법은 복잡하고 시간이 많이 소요될 수 있습니다.
이를 해결하기 위해 오픈소스 도구인 Kubespray를 사용하였습니다.
Kubespray는 쿠버네티스 구성 요소의 설치뿐만 아니라 리눅스 커널 설정과 다양한 옵션들을 자동화하며,
오랜 시간 동안 개선되고 활발한 커뮤니티 지원 덕분에 상용화 가능한 수준의 쿠버네티스 클러스터를 쉽게 구축할 수 있습니다.
저희는 Kubespray 2.23 버전을 사용하여 쿠버네티스 클러스터를 설정하였습니다.
클러스터를 구성한 후에는, 클러스터 환경을 더욱 컨테이너 중심 방식으로 운영하기 위해 추가적인 오픈소스 도구들을 설치해야 합니다.
이들 중 인그레스(Ingress) 컨트롤러와 퍼시스턴트 볼륨(Persistent Volume) 프로비저닝은 필수적입니다.
또한, 효율적으로 리소스를 관리하기 위해 지속적인 통합/배포(CI/CD) 도구나 오퍼레이터 패턴을 활용하는 것을 고려해야 합니다.
쿠버네티스(Kubernetes)
쿠버네티스 클러스터를 설정하는 과정에서 가장 먼저 고려해야 할 중요한 요소 중 하나는 컨테이너 런타임(CRI: Container Runtime Interface)과 네트워킹 인터페이스(CNI: Container Network Interface)입니다.
각각의 역할에 대해 간략히 설명하겠습니다.
컨테이너 런타임 (CRI)
컨테이너 런타임은 쿠버네티스와 직접적으로 상호작용하며, 컨테이너를 생성하고 실행시키는 역할을 합니다.
이들은 이미지를 다운로드하거나 업데이트하고, 프로세스 시작 또는 중지, 메모리나 CPU 사용량 제한 등의 기본적인 컨테이너 관련 작업을 담당합니다.
저희는 두 가지 대안으로 cri-dockerd와 containerd를 검토한 결과, 다양한 워크로드에서 범용적으로 사용되고 유지보수가 용이한 containerd를 선택했습니다.
1. cri-dockerd
cri-dockerd는 도커(Docker) 데몬을 그대로 사용할 수 있도록 컨테이너 런타임 인터페이스(CRI)를 추상화 한 레이어를 제공합니다.이로써, 이미 도커를 사용하고 있는 시스템에서는 쉽게 쿠버네티스를 운영할 수 있습니다.
하지만, Kubernetes 1.24 버전부터
dockershim의 지원이 중단되었고, 비교적 최근에 공개된 런타임으로 도입하기 위해 검증이 필요한 부분들이 있습니다.일례로, cAdvisor의 최신 버전에서
dockerd연동 코드가 제거되면서 컨테이너 메트릭 데이터가 누락되는 현상을 발견한 적이 있습니다.
2. containerd
containerd는 쿠버네티스에서 널리 사용되는 컨테이너 런타임으로, 오픈소스 커뮤니티의 활발한 유지보수를 받고 있어 안정성과 확장성이 뛰어납니다.다양한 워크로드에서 범용적으로 활용 가능합니다.
하지만, 특정 컨테이너 어플리케이션이 도커 데몬에 의존하는 경우에는 호환되지 않을 수 있습니다.
더불어, 별도의 오픈소스 CLI 도구(
nerdctl)를 설치해서 사용해야 합니다.
컨테이너 네트워킹 (CNI)
쿠버네티스 환경에서 컨테이너 네트워크는 중요한 역할을 수행하며, 이 중 가장 주요한 두 가지 기능은 다음과 같습니다.
파드 IP 주소 관리 및 할당: 모든 파드가 고유하고 독립적인 IP 주소를 가져야 합니다.
이를 통해 각 파드 간에 통신이 가능해지고, 클러스터 내에서 파드의 위치와 상관없이 그에 접근할 수 있습니다.
네트워크 구성: 컨테이너 네트워킹은 파드 간(Pod-to-Pod), 파드와 서비스(Pod-to-Service) 간의 통신을 가능하게 합니다.
이것은 각 파드가 다른 파드나 클러스터 내에서 실행 중인 서비스에 쉽게 접근할 수 있도록 하는데 중요한 역할을 합니다.
일반적으로 사용되는 CNI 플러그인으로는 Flannel, Calico, Cilium 등이 있습니다.
모두 CNI를 준수하기 때문에 쿠버네티스와 호환 가능하지만, 세부 구현에 따라 각자의 장점이 있으므 클러스터의 특정 요구사항이나 시나리오에 따라 선택해야 합니다.
저희는 CNI 구현체로 Calico, Flannel 두 가지를 대안으로 검토하였습니다.
향후 점진적으로 서비스를 쿠버네티스로 전환할 계획으로 클러스터가 확장될 가능성이 있고, 더 풍부한 컨테이너 네트워킹 기능을 제공하면서도 범용적으로 사용 가능한 Calico를 선택했습니다.
1. calico
고성능, 높은 확장성, 그리고 보안이 중요한 대규모 또는 중규모 클러스터에 적합합니다. 특히 네트워크 정책 관리가 필요한 환경이나 BGP 라우팅이 요구되는 경우 매우 유리합니다.
성능과 보안을 중요시하는 클러스터에서는 Calico가 더 나은 선택이 될 수 있습니다.
네트워크 가상화 방식: IP-in-IP 방식으로 오버헤드가 적어 안정적이고 효율적인 네트워크 성능을 제공합니다. 다만, 클라우드 서비스 제공업체(CSP)에 따라 네트워킹 가상화 방식이 제한
될 수 있으므로, 해당 환경에 적합한 방식을 선택해야 합니다. 비교적 최신 버전에서 VXLAN 방식도 지원하기 시작했습니다.
CrossSubnet으로 구성하는 경우, 네트워크 서브넷 내의 통신에서 직접 통신으로 오버레이로 인한 오버헤드를 발생하지 않고 통신하도록 구성이 가능하며 이는 최적화 요소로 활용될 수 있습니다.
패킷 필터링: Calico는
iptables와ipvs를 모두 지원하며, eBPF 기반의 패킷 필터링도 가능합니다.도입 과정에서 몇몇 에러 상황을 겪었고 완벽히 해소되지 않아
ipvs방식으로 구축하여 사용하고 있습니다.
2. flannel
단순한 설치와 관리가 필요한 소규모 클러스터에 적합합니다.
네트워크 오버레이만 필요한 환경에서, 즉, 보안 정책이나 고급 네트워크 기능이 필요하지 않다면 Flannel이 적합할 수 있습니다.
네트워크 가상화 방식: VXLan 및 Host-GW 방식을 지원하지만, VXLan는 50바이트의 오버헤드가 발생하고,
Host-GW 방식은 모든 호스트가 동일 네트워크에 있어야하며 라우터의 라우팅 규칙을 직접 관리해야 하므로 복잡성이 증가합니다.
클러스터의 규모, 성능 요구 사항, 보안 수준에 따라 달라집니다.
고급 보안 정책, 클러스터 확장 및 성능 최적화가 중요한 환경에서는 Calico가 유리하다고 판단하였습니다.
소규모 클러스터를 여럿 운영하는 구성에서는 Flannel이 더 적합할 수도 있습니다.
정리해보면, 저희 쿠버네티스 클러스터 구성은 아래와 같습니다.
현재까지 여러 서비스가 컨테이너로 동작하는 환경으로 서비스 중이며 특이사항 없이 운영하고 있습니다.
구분 | 컴포넌트 | 설명 | 비고 |
|---|---|---|---|
Orchestration | Kubernetes (1.27) | 컨테이너 스케쥴링 및 관리 시스템 |
|
Runtime | Containerd + RunC | Docker에서 개발. 컨테이너 실행/관리. (이미지 관리, 컨테이너 격리 및 리소스 제어 등) |
|
Networking | Calico | Tigera에서 개발. 컨테이너 네트워킹 관리. (Pod IPAM, Pod-to-Pod 혹은 Pod-to-Service 네트워크 연결 지원 등) |
|
 출처: https://kubernetes.io
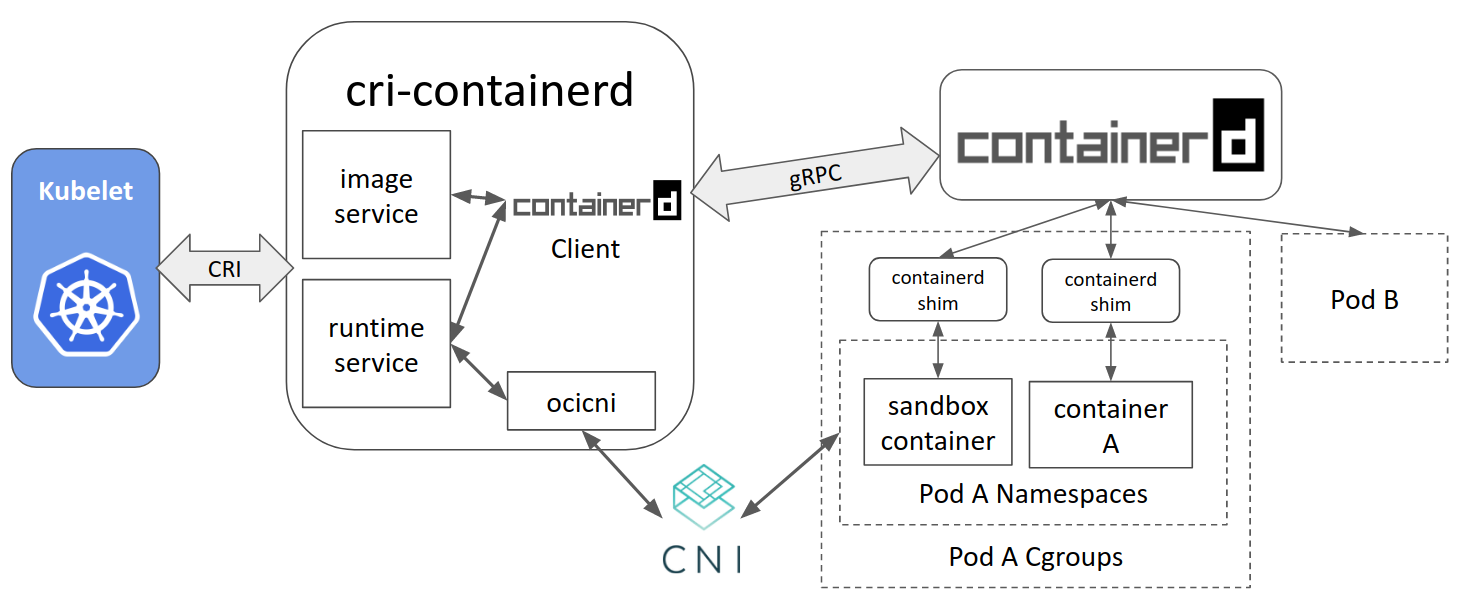 출처: https://github.com/containerd/containerd
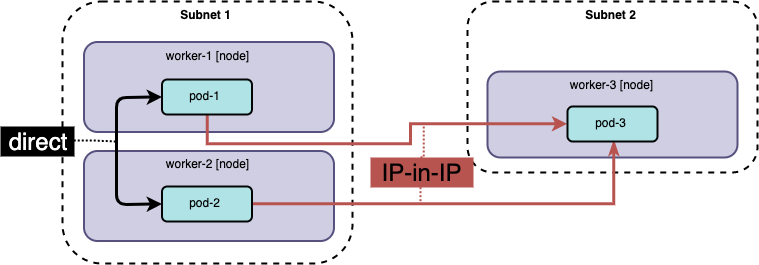 출처: https://coffeewhale.com
서드 파티 컴포넌트 (Third-party Components)
쿠버네티스를 컨테이너 네이티브 환경으로 활용하기 위해서는 오픈소스 서드 파티 컴포넌트 도입을 검토해야 합니다.
이러한 서드파티에는 인그레스 컨트롤러와 모니터링 스택 등 사싱상 필수적인 구성 요소들이 포함됩니다.
컨테이너 네이티브 생태계는 주로 CNCF (Cloud Native Computing Foundation)에서 관리되는 프로젝트들로 이루어져 있으며, 각각의 성숙도에 따라 구분되어 있습니다.
모든 오픈 소스 제품은 CNCFLandscape 웹사이트에서 자세히 살펴볼 수 있습니다.
오픈소스 시장에서는 다양한 제품이 공개되어 있으며, 각각 고유한 장점과 단점을 가지고 있습니다.
따라서 구현하고자 하는 워크로드의 특성에 따라 적절한 대안을 선택하는 것이 중요합니다.
저희의 주요 고려 사항은 안정성과 범용성이었습니다.
방대한 규모의 오픈소스 커뮤니티는 직간접적으로 지원을 받을 수 있으며, 다양한 실례를 통해 검증된 부분으로 안정적인 서비스가 가능하다고 판단했습니다.
다음은 저희가 고려했던 주요 서드파티 컴포넌트들에 대한 내용입니다.
구분 | 컴포넌트 | 설명 | 비고 |
|---|---|---|---|
Dynamic PV Provisioner | local-path-provisioner | 컨테이너에 호스트 볼륨을 동적으로 제공 | 컨테이너에 호스트 경로로 영구 볼륨을 제공 합니다. 노드에 종속성이 발생하지만 로컬 디스크를 사용하면 IO 성능을 최대한 활용할 수 있습니다. |
Ingress Controller | ingress-nginx | 클러스터 외부 요청을 내부로 전달 | Ingress 명세에 따라 nginx 설정을 관리하는 모듈 입니다. 따라서, 실질적인 프록싱은 nginx가 담당합니다. |
Monitoring | kube-prometheus-stack + thanos | 메트릭 기반 모니터링 제공 | Prometheus는 메트릭 모니터링에서 사실상의 표준입니다. 자체적으로 HA를 지원하지 않기 때문에 Thanos를 추가 구성을 해야하는 점이 단점입니다. 대안으로 victoriametrics, m3db도 주목받고 있습니다. 유료 제품인 datadog도 가능합니다. |
elastic-on-k8s + beats | 로그 기반 모니터링 제공 | 로그 모니터링에서 가장 일반적인 구성 입니다. 로그 수집기는 Logstash를 활용하는 경우도 있지만, 팀 내에서는 Beats 관련 노하우가 더 많았기에 선택했습니다. 대안으로 Grafana Loki도 고려 가능합니다. | |
Workflow | argo-workflows | 워크플로우 엔진 | 작업 흐름(DAG)을 스케쥴에 따라 실행하는 역할로 컨테이너 이미지 자동 빌드와 색인 자동화 용도로 구축하였습니다. 대안으로 airflow도 가능하지만 비교적 구성이 더 복잡하여 적용하지 않았습니다. 간단한 작업이라면 쿠버네티스 Job, CronJob 컨트롤러를 활용해도 무방 합니다. |
Deploy | argo-cd | 지속적인 배포 | GitOps 방식으로 지속적인 배포가 가능합니다. 대안으로 spinnaker 있지만 구성이 복잡하여 적용하지 않았습니다. |
Object Storage | minio | S3 저장소 | 색인이나 형태소 사전이나 모델 파일을 연동하기 위한 목적으로 구성했습니다. |
위 검토 내용을 토대로 구축한 저희 시스템의 논리적인 구조도는 다음과 같습니다.
검색추천 시스템 컨테이너화
검색추천 시스템은 색인기, 검색 엔진, 그리고 서비스 비즈니스를 구현하는 API 서버로 구성됩니다.
도메인에 따라 추가적인 컴포넌트가 필요할 수 있지만, 기본적으로 이 세 가지가 핵심적인 구성 요소입니다.
이번 글에서는 검색 엔진과 API 서버의 컨테이너화 작업을 중점적으로 다뤘습니다.
저희는 검색 엔진으로 Elasticsearch를 사용하며, SKT 내부 형태소 분석기를 활용하며 이를 위해 ES 플러그인을 개발하여 사용하고 있습니다.
API 서버는 Apache 웹 서버와 FastAPI 기반의 Uvicorn 서버를 혼용하여 운영하고 있습니다.
각 컴포넌트를 컨테이너화하기 위해 고려한 사항들을 아래에 정리했습니다.
Elasticsearch
배포 방식
Blue-Green 배포: 정적 색인을 통한 교체 전략을 활용합니다.
이 방식에서는 색인 문서 수가 많거나 증분 색인 이벤트가 빈번한 경우, 샤드 재배치 시 서비스 타임아웃이 발생할 위험이 있기 때문에,
샤드 할당 설정을 비활성화(
cluster.routing.allocation.enable: none) 했습니다.성능 저하를 방지하면서 클러스터 확장과 데이터 불균형 문제를 최소화할 수 있는 옵션을 추후 검토할 예정입니다.
전용(Dedicated) 노드 할당: Elasticsearch는 고성능 CPU와 대용량 메모리가 장착된 서버에 배치하는 것이 필요합니다.
또한, 다른 용도의 컨테이너가 리소스를 차지하지 않도록 제한을 두어야 합니다.
Anti-Affinity 설정: Elasticsearch 컨테이너가 동일한 노드에 스케줄링되지 않도록 설정하여, 노드 장애 시 서비스의 안정성을 확보할 수 있습니다.
컨테이너 리소스 할당
리소스 파편화 방지: 리소스를 정수배로 설정하는 것을 권장합니다.
예를 들어, CPU나 메모리를 정수배로 설정하면 자원의 파편화가 줄어들고 성능이 안정적으로 유지됩니다.
CPU 설정: CPU를 너무 낮게 설정하면 Throttling이 발생할 수 있습니다.
Throttling이 발생하면, 물리 노드는 여유가 있지만 프로세스가 할당된 CPU 자원을 충분히 받지 못하게 되어 지연이 발생할 수 있습니다.
Elasticsearch와 JVM은 병렬 처리를 활발히 수행하므로, 충분한 CPU 자원을 할당해야 과부하를 방지할 수 있습니다.
Memory 관리: 메모리가 부족할 경우 OOM Killer가 프로세스를 종료하므로, 메모리 사용량을 꾸준히 모니터링하고 필요시 증설하는 것이 중요합니다.
JVM 옵션
Cgroup 지원: Java 8 Update 191 이상부터 컨테이너 Cgroup 지원이 적용되므로, 해당 버전 이상에서 실행하는 것이 권장됩니다.
Heap 메모리 설정: 컨테이너의 메모리 리소스 최대 50%로 Heap 메모리 크기를 제한합니다.
Elasticsearch는 Lucene을 사용하여 Native Memory를 활용하므로, 추가적인 메모리 여유가 필요할 수 있습니다.
GC 옵션: 기본적으로 Elasticsearch의 내장 JVM 옵션으로 충분하지만, 필요한 경우 세부 옵션을 조정해야 합니다.
예를 들어,
XX:MaxGCPauseMillis는 GC 일시 중지 시간을 설정하며,Xms와Xmx는 동일한 값으로 설정해야 하고, 컨테이너 메모리 제한을 초과할 수 없습니다.G1GC 옵션:
XX:MaxGCPauseMillis는 GC 일시 중지 시간의 목표를 설정합니다 (기본값은 200ms).또한,
XX:+AlwaysPreTouch는 JVM 초기화 단계에서 메모리를 미리 할당하도록 합니다.
ES 설정
부트스트랩 설정:
bootstrap.memory_lock: true로 설정하여 Elasticsearch가 메모리를 잠글 수 있도록 합니다.불필요한 xpack 비활성화: 기본적으로 Elasticsearch는 다양한 xpack 기능을 제공하므로 필요하지 않은 기능들은 비활성화 합니다.
xpack.ccr.enabled,xpack.security.enabled,xpack.watcher.enabled,xpack.graph.enabled,xpack.ml.enabled등을 비활성화합니다.Shard Allocation Awareness: Elasticsearch가 동일 서버에 Primary/Replica 샤드가 배치되지 않도록 하기 위해
node.attr.kube_node_name: ${NODE_NAME}와cluster.routing.allocation.awareness.attributes: kube_node_name을 설정합니다. ${
API Server
배포 방식
Anti-Affinity를 통해 가급적 동일 노드에 스케쥴링 되지 않도록 설정 합니다.
전용(Dedicated) 노드 할당: 다른 용도의 컨테이너가 리소스를 선점하지 않도록 제한 했습니다.
무중단 배포를 위한 설정을 고려 합니다.
헬스체크 제어: 컨테이너 lifecykleHook의 preStop으로 헬스체크를 제외하고 의도적으로 추가적인 커넥션을 방지합니다.
lifecycleHooks:
  preStop:
    exec:
      command:
        - /bin/sh
        - -c
        - |
          mv hcheck/_hcheck.hdn hcheck/_hcheck.hdn.bak
          sleep 30
프로브 설정
readinessProbe를 사용하며 헬스체크를 호출하도록 하여 해당 파드가 트래픽을 받아도 되는지 결정 합니다.
Graceful shutdown
Ready 상태 변경을 위한 최소 대기 시간과 SIGTERM 전송 후 대기 시간을 설정 합니다.
minReadySeconds: 10
terminationGracePeriodSeconds: 60
웹 서버에서 지원하는 Graceful shutdown 처리를 고려 합니다.
컨테이너 이미지에 경량 init 프로세스 적용을 고려해야 합니다.
dumb-init은 자식 프로세스로 시그널 전파 및 시그널 변환하는 기능이 있습니다.
Apache: SIGTERM -> SIGWINCH 변환 처리 필요 (참고 링크)
Uvicorn: 별도 변환 처리 필요 없음.
컨테이너 리소스 할당
리소스의 파편화를 방지하기 위해 정수배로 설정을 권장합니다.
검색엔진 프론트로써 웹 서버는 주로 ES 검색 요청 위주로 IO Intensive한 특성이 있습니다.
CPU Limit을 설정하지 않았고 CPU Throttling 으로 인한 지연이 발생하지 않도록 하였습니다.
클러스터 모니터링
메트릭 기반 모니터링
Exporter로 수집한 메트릭을 Prometheus에서 수집하고, 특정 조건을 충족하는 경우 Alertmanager를 통해 알람 전송하는 구조 입니다.
Prometheus Stack으로 구성하였습니다.
프로메테우스는 자체 HA 구성이 불가능하므로 Thanos 를 통해 HA를 구성해야 합니다.
메트릭을 활용해서 어플리케이션의 자동화된 수평 확장(HPA)하는 것을 고려할 수 있습니다.
Exporter 도입 필요.
대중적인 어플리케이션(예: MariaDB 등)에 대응되는 오픈소스 Exporter 적용을 고려해야 합니다. Sidecar 패턴으로 실행하거나 별도 파드를 배치하는 방식도 가능합니다.
직접 개발한 어플리케이션은 Prometheus에서 제공하는 Exporter SDK를 활용해 구현해야 합니다.
대시보드 예시
알람 예시
로그 기반 모니터링
Log Shipper(beats 등)에서 컨테이너 로그를 수집해서 로깅 백엔드로 전달하는 구조 입니다.
컨테이너 로그를 중앙화하기 위한 Logging Backend (elasticsearch 등)을 고려해야 합니다. 저희는 Elasticsearch 클러스터를 구성하여 사용합니다.
서비스의 로그와 알람 포맷과 규칙에 대한 사전 협의가 필요합니다. 로그 알람 규칙을 설정하는데 표준화된 규격이 필요합니다.
알람 예시
미디어 에이전트 도입 사례
서비스 개요
미디어 에이전트는 LLM(대형 언어 모델)을 기반으로 한 미디어 특화 대화형 서비스로, 사용자에게 다음과 같은 기능을 제공합니다.
사용자 의도와 문맥에 맞는 콘텐츠 검색 및 추천: 사용자 요청에 따라 관련 콘텐츠를 빠르게 추천하고 검색할 수 있습니다.
다양한 미디어 콘텐츠 정보 제공: VOD, 실시간 편성표, OTT, 유튜브, 뉴스 정보 등 다양한 출처의 미디어 콘텐츠 정보를 통합하여 제공합니다.
혹시라도, 미디어 에이전트에 대해서 더 궁금하신 분은 [에이닷 미디어 에이전트] 대화형 콘텐츠 탐색은 어디까지 왔을까 블로그 내용을 참고해주세요.
컨테이너 이미지 준비
검색 엔진 컨테이너
기본 이미지 선택
Elasticsearch의 공식 Dockerfile을 참조하여 이미지의 기본 구조를 설정합니다.
RHEL(Red Hat Enterprise Linux) 기반으로 최적화된 이미지를 사용하여 보안 및 성능을 강화합니다.
한국어 처리 기능 통합
KLP(Korean Language Processor) Elasticsearch 플러그인을 설치하여 한국어 처리 기능을 추가합니다.
Elasticsearch와 KLP를 통합하여 커스텀 이미지를 생성, 한국어 텍스트를 보다 효율적으로 처리할 수 있습니다.
이미지 저장
생성된 이미지는 private registry에 저장하여 안전하게 관리하고, 필요한 서비스에서 사용할 수 있도록 합니다.
대화/검색 API 서버 컨테이너
FastAPI 기반 이미지 준비
FastAPI 애플리케이션을 구동할 수 있는 적합한 Python 버전을 선택하여 이미지를 준비합니다.
FastAPI와 Uvicorn이 사전 설치된 베이스 이미지를 활용하여 빠르게 구축합니다.
애플리케이션 통합
서비스에 필요한 애플리케이션 코드와 라이브러리를 설치합니다.
최종적으로 API 서버 이미지를 빌드하여, 실제 서비스 환경에 배포 가능한 형태로 준비합니다.
이미지 저장
생성된 이미지는 private registry에 저장하여 안전하게 관리하고, 배포 및 운영에 사용합니다.
배포
Helm 차트 활용
템플릿 기반 배포: Helm 차트를 사용하면 쿠버네티스 리소스를 템플릿화하여, 설정값만 변경함으로써 쉽게 배포할 수 있습니다.
이 방식은 빠르고 효율적인 배포를 가능하게 합니다.
유연성: Helm은 다양한 환경에 맞춘 커스터마이징이 용이합니다.
Helm 차트를 통해 환경에 따라 필요한 리소스 설정, 네트워크, 보안 등 세부적인 요소를 손쉽게 조정할 수 있습니다.
Helm 차트 설정 준비
검색 엔진
ES 클러스터 설정
클러스터 이름을 지정하여 클러스터의 고유성을 확보합니다.
최소 3개 이상의 노드를 설정하여 고가용성을 보장합니다.
JVM Heap 크기는 32GB 이하로 설정하여 성능 최적화와 메모리 관리를 효율적으로 합니다.
리소스 설정
컨테이너 메모리는 JVM Heap 크기의 2배로 설정하여 충분한 메모리 리소스를 확보하고, Elasticsearch 성능을 최적화합니다.
네트워크 설정
인그레스(Ingress) URL 경로를
/es/{clusterName}형태로 지정하여, 검색 엔진에 대한 요청을 구분하고 관리합니다.
모니터링 설정
클러스터의 상태와 성능 지표를 수집하기 위해 Prometheus Exporter를 설정하여, 실시간 모니터링과 알림을 통해 안정적인 운영을 지원합니다.
설정 예시
---
elasticsearch:
  clusterName: {ES 클러스터 이름; 일반적으로 서비스명 + 넘버링하여 사용}
  image: {컨테이너 이미지 주소}
  imageTag: {컨테이너 이미지 태그}
  imagePullPolicy: IfNotPresent
  replicas: 3
  esJavaOpts: "-Xmx16g -Xms16g"
  esJvmOptions:
    custom.options: |
      -XX:MaxGCPauseMillis=200
      -XX:+AlwaysPreTouch
      -XX:+DisableExplicitGC
  resources:
    requests:
      cpu: 8
      memory: 32Gi
    limits:
      cpu: 8
      memory: 32Gi

elasticsearchExporter:
  enabled: true

prometheus-elasticsearch-exporter:
  es:
    uri: http://{CLUSETER_NAME}-master:9200
  serviceMonitor:
    enabled: true
  prometheusRule:
    enabled: true
대화/검색 API 서버
FastAPI 컨테이너 설정
서비스 배포 시점에 적절한 컨테이너 이미지의 태그로 설정합니다.
컨테이너 실행 시, Uvicorn 서버를 설정할 수 있도록 실행 명령을 전달합니다.
예상되는 TPS(초당 처리량)와 리소스 사용량에 맞춰 Pod의 개수와 Worker process 수를 조정하여 성능 최적화를 합니다.
리소스 설정
CPU Throttling을 방지하기 위해 가능한 한 CPU 제한을 두지 않습니다. 이를 통해 성능 저하를 막고, 안정적인 서비스를 제공할 수 있습니다.
Pod 스케줄링
API 서버는 전용 노드에 할당하고, Anti-affinity 설정으로 가급적 여러 노드에 파드가 배치될 수 있도록 합니다.
네트워크 설정
환경 별로 인그레스(Ingress) 컨트롤러를 분리하여 적용합니다. 이를 통해 각 환경에서 독립적으로 트래픽을 처리할 수 있습니다.
각 서비스의 인그레스 URL 경로를 지정하여,
/front/{serviceName}형태로 요청을 처리합니다.
환경 변수 설정
서비스 환경에 맞는 환경 변수를 설정하고, 애플리케이션에서 해당 변수들을 참조하여 환경 별 설정을 적용합니다.
설정 예시
---
image:
  repository: {IMAGE 주소}
  tag: {IMAGE 태그}
  pullPolicy: IfNotPresent

args:
  - "uvicorn"
  - "main:app"
  - "--host"
  - "0.0.0.0"
  - "--port"
  - "80"
  - "--workers"
  - "30"
  - "--backlog"
  - "1024"

replicas: 4

resources:
  requests:
    cpu: 6
    memory: 8Gi
  limits:
    memory: 8Gi

tolerations:
  - key: "aisearch.sktelecom.com/front"
    operator: "Equal"
    value: "true"
    effect: "NoExecute"

ingress:
  enabled: true
  className: nginx
  annotations:
    nginx.ingress.kubernetes.io/rewrite-target: "/media_agent/$2"
  hosts:
    - host: ""
      paths:
        - path: "/front/media_agent(/|$)(.*)"
          pathType: ImplementationSpecific

envs:
  - name: TZ
    value: "Asia/Seoul"
  - name: API_PREFIX
    value: "/media_agent"
  - name: ES_CLUSTER
    value: "{ES_CLUSTER_NAME}"
  - name: ES_ADDRS
    value: "{ES_CLUSTER_NAME}-master.video.svc:9200"
컴포넌트 배포 실행
kubeconfig 파일 준비
쿠버네티스 클러스터 관리자로부터 미디어 에이전트 서비스가 배치된 네임스페이스에 배포하기 위한 사용자 인증서를 전달 받습니다.
Helm 차트 설치
먼저 Helm 레포지토리를 추가한 후, 필요한 차트를 설치합니다.
설치 시, 릴리즈 이름과 네임스페이스를 지정하여 Helm 설치 명령을 실행합니다.
Helm 차트 업그레이드
검색 엔진
Helm 차트 업그레이드 시, Pod가 순차적으로 재시작되는데 이 과정에서 타임아웃이 발생할 수 있습니다.
인덱스 라우팅 비활성화 설정에 따라 일시적으로
Yellow상태가 발생할 수 있습니다.이를 방지하기 위해, 안정성을 확보할 수 있도록 Standby 클러스터에서만 업그레이드를 실행합니다.
API 서버
서비스 환경별로 리소스, 네트워크, 환경 변수 설정 등을 템플릿화하여 배포 시 쉽게 커스터마이징할 수 있습니다.
Deployment의 기본 전략인RollingUpdate를 사용하여 서비스를 점진적으로 교체합니다.이를 통해 서비스 중단 없이 안정적으로 배포를 진행할 수 있습니다.
트러블슈팅 및 기타 작업
1. Keep-Alive로 인한 성능 문제
문제 발생 원인:
Uvicorn은 기본적으로 Keep-Alive 연결을 사용합니다.
요청이 많아지면서 Ingress-Nginx와 Uvicorn 사이의 Keep-Alive 연결 수가 급증하게 됩니다.
연결 수가 많아지면 새로운 연결을 맺는 데 시간이 오래 걸려 지연이 발생하는 문제가 생깁니다.
해결 방법:
Ingress에서 API 서버로 요청을 프록시할 때
Connection: close헤더를 추가하여 Keep-Alive를 비활성화시킵니다.이를 통해 연결 수를 제한하고 지연을 최소화할 수 있습니다.
ingress:
  annotations:
    nginx.ingress.kubernetes.io/connection-proxy-header: close
2. Hidden Index 문제
문제 발생 원인:
Elasticsearch의 ILM(인덱스 라이프 사이클 관리) 히스토리 인덱스 기능이 활성화되면
hidden인덱스가 생성됩니다.인덱스 라우팅이 비활성화되어 있을 때,
hidden인덱스를 할당하려고 하면 할당이 실패하여 Elasticsearch가red상태에 빠지는 문제가 발생할 수 있습니다.
해결 방법:
Elasticsearch 설정 파일에서
indices.lifecycle.history_index_enabled값을false로 설정하여 히스토리 인덱스 생성을 비활성화합니다.이를 통해
hidden인덱스 할당 실패를 방지할 수 있습니다.
indices.lifecycle.history_index_enabled: false
3. 배포 시 컨테이너 이미지 태그 관리 이슈
문제 발생 원인:
API 서버 코드 배포 시
kubectl patch를 사용하여 이미지 태그만 변경하고 Deployment를 배포하는 방식으로 진행되고 있었습니다.주기적으로 API 서버의 환경 변수를 수정해야 하며, 자동 배포를 위한 cronjob이 설정되어 있지만, 매번 수동 배포 후 새로운 이미지 태그를 수동으로 명시해야 했습니다.
해결 방법:
수동 배포 시 Helm 차트 업그레이드 기능만 사용하고, 자동 배포 시에는 필요한 환경 변수만 수정하도록 템플릿화된 Helm 차트와
reuse옵션을 활용하여 배포 과정을 자동화합니다.이를 통해 수동 배포와 자동 배포를 효율적으로 관리할 수 있습니다.
4. 형태소 분석기 동의어/엔티티 사전 업데이트
문제 발생 원인:
형태소 분석기 동의어/엔티티 사전 파일을 수정할 때마다 이미지 빌드, Helm 차트 배포, 그리고 서비스의 Elasticsearch 전환 작업 등을 수동으로 처리해야 했습니다.
이 과정이 반복적으로 이루어지면서 불필요한 시간 소모와 관리 부담이 생겼습니다.
해결 방법:
자동으로 동의어/엔티티 사전을 업데이트하기 위해, DB에서 사전 데이터를 읽어와 파일을 생성하는 Init Container를 추가하고, 사전 파일 경로를 마운트하는 방법을 도입했습니다.
이를 통해 매일 자동으로 업데이트된 사전 파일을 컨테이너에 반영할 수 있게 되었습니다.
extraInitContainers:
- image: $IMAGE_NAME:$IMAGE_TAG
  imagePullPolicy: IfNotPresent
  name: $NAME
  securityContext:
    runAsUser: 0
  volumeMounts:
  - mountPath: /usr/share/klp-resource
    name: shared-data
extraVolumeMounts:
- mountPath: /usr/share/klp-resource
  name: shared-data
  readOnly: true
extraVolumes:
- emptyDir: {}
  name: shared-data
검색엔진 컨테이너 실행 시, 마운트된 경로에서 사전을 빌드하는 스크립트를 실행하도록 설정하여 사전 파일이 항상 최신 상태로 반영되도록 했습니다.
맺음말
이번 글에서는 검색추천 시스템을 구축하기 위한 쿠버네티스 클러스터 설정 과정에 대해 다뤘습니다.
이 과정에서 쿠버네티스와 관련된 서드파티 도입의 필요성 및 이를 검토한 주요 요소들을 정리했습니다.
또한, 검색추천 시스템의 핵심 구성 요소인 검색 엔진과 API 서버를 컨테이너화하기 위해 고려한 사항들도 소개했습니다.
쿠버네티스와 컨테이너 네이티브 방식을 활용하여 애플리케이션의 자동화와 효율적인 운영 방법을 제시했습니다.
현재도 지속적인 개선과 발전을 진행 중이며, 향후에는 색인 자동화 작업을 쿠버네티스와 연계하여 더욱 자동화할 계획입니다.
또한, 사용 중인 리소스의 주기적인 최적화 체계를 마련하고, 특히 검색 엔진의 샤드 재배치를 자동화하여 쿠버네티스 환경에서 더욱 효율적인 운영 방안을 모색할 예정입니다.
더 나아가, 오퍼레이터 패턴을 활용하여 서비스 개발자가 운영 리소스를 최소화하고, 검색추천 서비스에 더욱 집중할 수 있는 환경을 만들고자 합니다.
이러한 개선 사항들이 에이닷의 다양한 에이전트뿐만 아니라 검색추천 서비스의 품질 향상에도 기여할 것으로 기대합니다.
긴 글 읽어주셔서 감사합니다.
작성자
유성규 (lukas.sky@sk.com)
강지우 (jiu@sk.com)
Lukas.SKY 님의 최신 블로그
더보기
DEVOTEE 추천 블로그
-

- AKS 상용 서비스 적용기 (3) - 서비스를 견고하게 해주는 k8s 추가 설정 (HPA, PV/PVC, Probe, preStop)
- 안녕하세요, dragonpipe입니다. 이 번에는 지난 게시글에 이어 AKS(Azure Kubernetes Service) 상용 서비스에 적용한 후기 세 번째 내용으로, 서비스 안정성에 도움이 되는 k8s 리소스의 manifest yaml 파일에 대해 소개드리려고 합니다. 1. HPA 설정 : AutoScaling을 위한 오브젝트 k8s의 큰 장점 중 하나가 오토스케일링 기능이라고 생각하는데요. HPA 리소스가 있으면 auto-scale 기능을 어렵지 않게 구현할 수 있습니다. HPA 리소스를 생성하기 위한 manifest 파일을 어떻게 작성하였는지 공유 드리고, 추가로 HPA가 잘 동작하는지 테스트 해 본 결과를 공유드리겠습니다. hpa.yaml 파일 작성 ki...
-

- 이제는 AI Agent 시대! RAG와 함께 Bedrock Agent를 활용해보자 - 2 (실습)
- 이전 아래 글에 이어지는 (실습) 편입니다. 이제는 Agent 시대! RAG와 함께 Bedrock Agent를 활용해보자 - 1 (이론) 서론 지난번에 살펴본 AI Agent에 대해 간단히 정리해보고, Amazon Bedrock Agent 서비스로 이를 구현해 보겠습니다. AI Agent 정의 AI Agent는 특정 목표를 달성하기 위해 자율적으로 행동하고 결정을 내리는 AI 시스템을 말합니다. 자율성: Agent는 사람의 직접적인 개입 없이 자체적인 판단으로 작업을 수행할 수 있습니다. 목표 지향성: 주어진 목표를 달성하기 위해 데이터를 수집하고 계획을 세우고 실행합니다. 환경 인식: 주변 환경을 인식하고 그에 따라 행동을 조절합니다. 학습 능력: 경험을 통해 ...
-

- AKS에 Qdrant 배포하기: 쉽게 시작하는 Qdrant와 RAG 개발 환경
- RAG와 Qdrant 최근 RAG 관련 업무를 진행하면서 벡터DB가 필요하게 되어 팀 내 논의를 거쳐 Qdrant를 선택하였습니다. 현재 개발 환경을 구축하여 이를 활용하고 있으며, 이에 대한 내용을 공유드리고자 합니다. 최근 벡터 검색과 유사도 기반 검색이 많은 관심을 받고 있습니다. Qdrant와 같은 벡터 데이터베이스는 검색 및 추천 시스템에서 그 성능을 입증하고 있으며, 특히 Retrieval-Augmented Generation(RAG)과 결합해 놀라운 성능을 발휘할 수 있습니다. 이번 글에서는 Azure Kubernetes Service(AKS)를 이용해 Qdrant를 손쉽고 빠르게 개발 환경에 배포하고, Ingress를 통해 도메인 기반으로 접근할 수...
-

- 비용도 줄여버리는! 클라우드 설계 최적화 어디까지 해봤어? - GitOps로 FinOps 적용하기
- 에이닷 서버팀의 목표와 다짐 바야흐로 때는 에이닷의 초기 개발 시점... 초기 서버 개발 인원으로 서비스를 안정적으로 설계 및 개발하여 당차게 출시 해 보려는 서버 개발자들이 있었으니~ 네 그렇습니다. 에이닷 서버팀의 첫 시작은 이렇게 작게 시작하였습니다. 하지만 늘 그렇듯 우리의 목표는 항상 크고 위대합니다. 고객에게 어떻게 더 발전된 서비스를 제공할 수 있을까요? 우리는 어떻게 한정된 자원으로 최대의 목표를 달성 할 수 있었을까요? 그래서 우리는 퍼블릭 클라우드를 사용하고, 클라우드 네이티브 아키텍처를 따르는 설계를 하기로 결정하였습니다. Cloud Native Architecture 기존의 IDC 내에서 개발하는 형식으로도 클라우드 환경에서 개발할 수 있습니...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.