
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
효율적인 GPU 메모리 사용을 위한 여러 기법
- DEVOTEE 요약
- GPU 사용에 있어서 메모리의 효율적인 관리를 위해 여러 가지 방법이 제시되었습니다. 그레이디언트 누적(gradient accumulation)과 그레이디언트 체크포인팅(gradient checkpointing)은 메모리 사용량을 줄이거나, 더 큰 배치 크기를 효과적으로 사용하는 방법입니다. PEFT(효율적인 학습 방법) 기술로서 LoRA와 QLoRA를 통해 많은 GPU 메모리를 활용하지 않고도 효율적인 미세조정을 할 수 있으며, ZeRO(Zero Redundancy Optimizer)는 데이터 병렬화의 비효율성을 감소시켜 메모리를 효과적으로 사용하는 방법입니다.
키워드: GPU(Graphic Processing Unit), OOM(Out of Memory) / 그레이디언트 누적(gradient accumulation), 그레이디언트 체크포인팅(gradient checkpointing) /
분산학습(distributed training), 데이터 병렬화(data parallelism), 모델 병렬화(model parallelism), 파이프라인 병렬화(pipeline parallelism), 텐서 병렬화(tensor parallelism)
ZeRO(Zero Redundancy Optimizer) / 효율적인 학습 방법(PEFT: Parameter Efficient Fine-Tuning), LoRA(Low-Rank Adaptation), QLoRA(양자화(Quantized)된 LLM의 효율적인 미세조정)
페이지 옵티마이저(paged optimizer)
아래 교육 영상의 도움을 많이 받았습니다. (SK그룹 mySUNI 이용자만 가능)
https://mysuni.sk.com/suni-main/lecture/card/CARD-19jy/cubes/CUBE-1890/video
OOM은 한정된 GPU 메모리에 데이터가 가득차 더 이상 새로운 데이터를 추가하지 못해 발생하는 에러로써, 딥러닝 모델 학습/추론을 위해 GPU 사용 시 가장 자주 만나는 에러
딥러닝 모델은 행렬 곱셈을 위한 파라미터의 집합으로 GPU에 딥러닝 모델 자체가 올라감
그렇다면 딥러닝 모델의 데이터 타입은?
최근에는 주로 16비트 fp16, bf16를 주로 사용
fp16과 bfloat16은 같은 16비트이나 range와 precicision이 다른데, bfloat16 가 훨씬 넓은 range를 커버(fp32와 동일하게 8비트의 지수(exponent)를 가짐)
다만 그 사이사이의 정확도는 fp16이 더 높음(가수(mantissa)의 비트가 fp16이 더 큼)
연산이 빨라야 하는 경우 Low precision을 사용
단일 GPU 효율적으로 활용하기
GPU 메모리 구성 데이터
모델 파라미터
그레이디언트(gradient)
옵티마이저 상태(optimizer state)
순전파 상태(forward activation)
딥러닝 학습 과정: 순전파 수행(역전파 수행을 대비하여 값 저장) → 역전파 수행(순전파 결과를 바탕으로 수행. 그레이디언트 생성) → 옵티마이저를 통해 모델 업데이트
그레이디언트 누적
딥러닝 모델을 학습시킬 때 각 배치마다 모델을 업데이트 하지 않고 여러 배치의 학습 데이터를 연산한 후 모델을 업데이트해 마치 더 큰 배치 크기를 사용하는 것 같은 효과를 내는 방법
아래 train_model 함수의 그레이디언트 누적 부분 중, 학습 인자(training_args)에서 그레이디언트 누적 횟수(gradient_accumulation_steps) 설정을 4로 두면,
(1)손실을 4로 나누어 역전파를 수행하고 (2)4번의 스텝마다 모델을 업데이트
def train_model(model, dataset, training_args):
    if training_args.gradient_checkpointing:
        model.gradient_checkpointing_enable()

    train_dataloader = DataLoader(dataset, batch_size=training_args.per_device_train_batch_size)
    optimizer = AdamW(model.parameters())
    model.train()
    gpu_utilization_printed = False
    for step, batch in enumerate(train_dataloader, start=1):
        batch = {k: v.to(model.device) for k, v in batch.items()}

        outputs = model(**batch)
        loss = outputs.loss
        loss = loss / training_args.gradient_accumulation_steps     --- (1)
        loss.backward()

        if step % training_args.gradient_accumulation_steps == 0:   --- (2)
            optimizer.step()                                        --- (2)
            gradients_memory = estimate_memory_of_gradients(model)
            optimizer_memory = estimate_memory_of_optimizer(optimizer)
            if not gpu_utilization_printed:
                print_gpu_utilization()
                gpu_utilization_printed = True
            optimizer.zero_grad()

    print(f"옵티마이저 상태의 메모리 사용량: {optimizer_memory / (1024 ** 3):.3f} GB")
    print(f"그레디언트 메모리 사용량: {gradients_memory / (1024 ** 3):.3f} GB")
그레이디언트 누적을 적용했을 때 메모리 사용량
cleanup()
print_gpu_utilization()

gpu_memory_experiment(batch_size=4, gradient_accumulation_steps=4)

torch.cuda.empty_cache()
아래와 같이 그레이디언트를 사용하지 않고 배치 사이즈를 변경하며 메모리 사용량 측정 시, 배치 사이즈 16 일 때 OOM이 발생
위의 그레이디언트를 사용하면 배치 크기 4로 메모리 사용량은 10.586GB로 성공적으로 실행되면서 동시에 배치 크기 16일때와 동일한 효과를 얻을 수 있음
cleanup()
print_gpu_utilization()

for batch_size in [4, 8, 16]:
    gpu_memory_experiment(batch_size)

    torch.cuda.empty_cache()
그레이디언트 체크포인팅
순전파의 계산 결과를 모두 계산하지 않고 일부만 저장해 학습 중 메모리의 사용량을 줄이는 학습 방법
딥러닝 모델에서는 모델 업데이트를 위한 그레이디언트를 계산하기 위해 순전파와 역전파를 수행하는데, 이때 역전파 계산을 위해 순전파의 결과 저장이 필요
가장 기본적인 방법은 모두 저장하는 것이나 GPU 메모리를 많이 차지하므로 아래와 같은 방법 고안
[순전파와 역전파 모두 저장하는 방법]
역전파를 진행하면서 메모리 절약을 위해 사용이 끝난 데이터는 삭제
[순전파의 마지막 계산 결과만 저장하는 방법]
역전파를 계산할 때 필요한 최소 데이터만 저장하고 나머지는 필요할 때 다시 계산
(1) 순전파 과정에서 중간 데이터를 삭제하며 진행하고 마지막 데이터만 남긴 상태로 손실을 계산 (2) 그 다음 역전파 계산을 위해 순전파 상태가 필요해지면 다시 순전파를 처음부터 계산
장점: 메모리 효율적 사용 가능
단점: 한 번의 역전파를 위해 순전파를 반복적으로 계산해야 함
[그레이디언트 체크포인팅]
위 두 가지 방법을 절충
순전파의 전체를 저장하거나 마지막만 저장하는게 아니라, 중간에 값들을 저장(체크포인트)하여 메모리 사용을 줄이고 필요한 경우 체크포인트부터 다시 계산해 순전파 계산량도 줄임
장점: 메모리 효율적 사용 가능
단점: 추가적인 순전파 계산이 필요하므로 학습시간 증가
세 번째 노드의 순전파 데이터를 체크포인트로 저장. 순전파가 완료 되었을 때 세 번째 노드, 마지막 노드의 값이 저장
if, 네 번째 노드의 값이 필요 -> 저장해 둔 세 번째 노드에서부터 순전파를 계산
분산 학습(distributed training): 2개 이상의 GPU를 이용한 모델 학습 방법 - Parallelism(병렬화)
오른쪽 그림이 마이크로소프트 에서 많이 사용하는 그림. 윗 층 layer가 하나의 모델
데이터 병렬화(data parallelism): 모델이 작아 하나의 GPU에 올릴 수 있는 경우 여러 GPU에 각각 모델을 올리고 학습 데이터를 병렬로 처리해 학습 속도를 높이는 방식
모델병렬화(model parallelism): 하나의 GPU에 올리기 어려운 큰 모델의 경우 사용. 모델을 여러 개의 GPU에 올리는 방식
파이프라인 병렬화(pipeline parallelism): 모델의 레이어(층)를 여러 장치로 나누어 처리하는 방식. 모델을 순차적으로 나누어, 각 장치가 특정 레이어를 처리하도록 함
텐서 병렬화(tensor parallelism): 모델 레이어 내에서 파라미터를 쪼개어 계산. 레이어 내부 계산을 여러 장치에 나누어 병렬로 처리하는 방식.
레이어를 나누는 대신, 레이어 내 연산을 세분화. 이 경우 행렬을 분리해도 동일한 결과를 얻을 수 있도록 행렬 곱셈을 적용
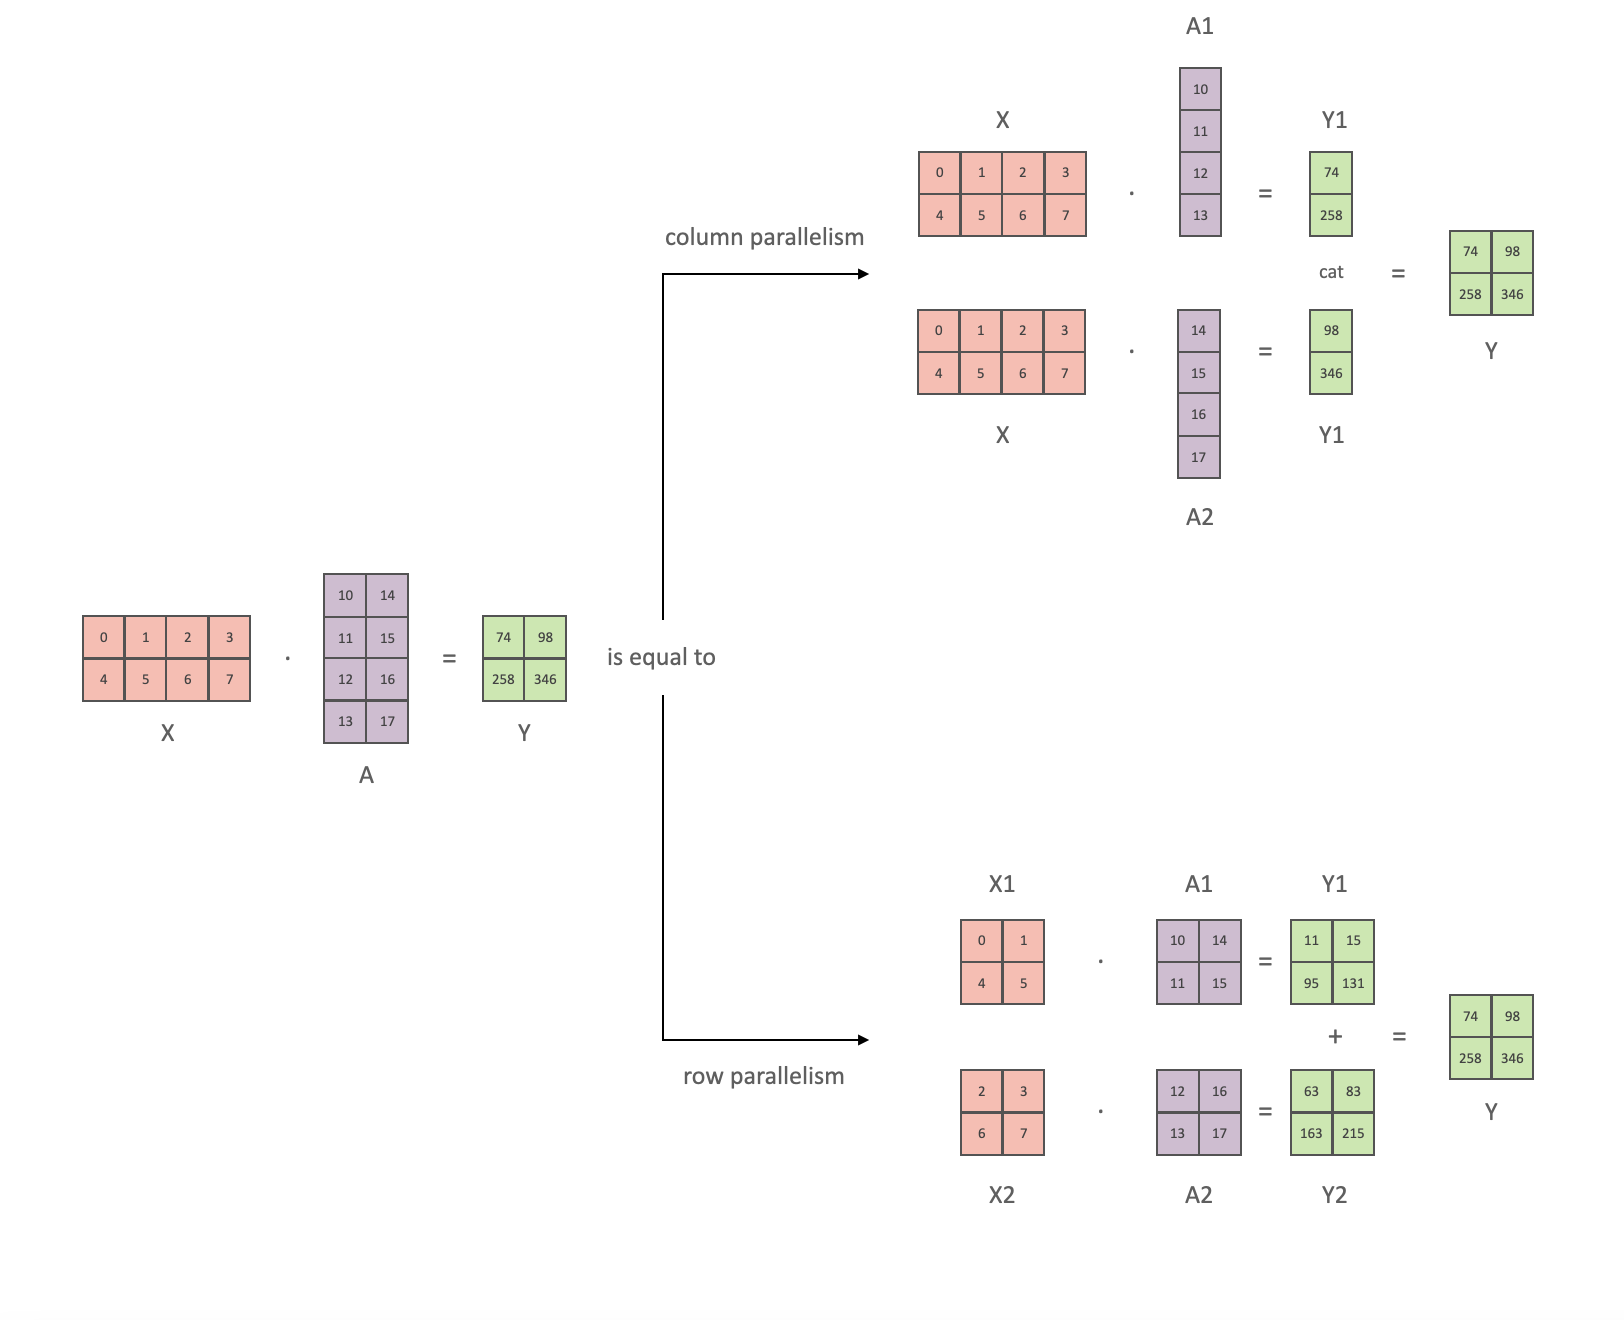
비교
특성 | 파이프라인 병렬화 | 텐서 병렬화 |
|---|---|---|
분할 대상 | 레이어 단위로 분할 | 레이어 내부 계산 단위로 분할 |
장치 간 통신 | 레이어 간 결과 전달 | 연산 결과 병합 |
적용 상황 | 레이어 수가 많은 경우 | 레이어 연산이 매우 큰 경우 |
구현 복잡도 | 상대적으로 간단 | 더 복잡 |
ZeRO(Zero Redundancy Optimizer: 조단위의 파라미터 모델 학습을 위한 메모리 효율화) - 데이터 병렬화에서 중복 저장 줄이기
데이터 병렬화는 여러 데이터를 빠르게 한 번에 처리 하므로 데이터 측면에서는 좋으나 여러 장비에 똑같은 모델을 올려 놓았기 때문에 비효율적
모델 병렬화는 연산이 끝난 다음 다음 장비로 연산 결과를 넘겨주므로 아이들타임 발생. 두 방식 모두 메모리 비효율이 있으나 ZeRO는 이런 문제를 해결
기존(베이스라인)에는 각 GPU마다 모델 파라미터(p), 그레이디언트(g), 옵티마이저(os)를 저장하는 비효율이 있는데,
ZeRO는 각 GPU가 모델을 부분적으로 가지고 필요한 순간에만 모델 파라미터를 복사해 연산을 수행하는 방식으로 메모리를 효율적으로 사용
효율적인 학습 방법(PEFT): LoRA
LLM과 같은 기반 모델의 크기가 커지면서 하나의 GPU를 사용해 모든 파라미터를 학습하는 전체 미세 조정(full fine-tuning)을 수행하기가 어려워짐
대부분의 개인과 조직은 여러 GPU를 사용한 모델 학습이 어려우므로 일부 파라미터만 학습하는 PEFT(Parameter Efficient Fine-Tuning) 연구가 활발히 이루어지고 있음
그 중 오픈소스 LLM 학습에서 가장 주목받고 많이 활용되는 학습 방법은 모델에 일부 파라미터를 추가하고 그 부분만 학습하는 LoRA(Low-Rank Adaptation) 학습 방식
좌측 파란색의 dxd는 전체 차원에 대해 학습을 한 경우이고, 우측 주황색의 LoRA 방법론을 사용하면 r차원의 적은 파라미터로 d차원의 동일한 학습 효과를 꾀할 수 있다.
W0가 pretrained Weights, Wx가 LoRA 방법론을 이용한 데이터 변화량
학습 파라미터 변화에 따른 성능 변화. 타 방법론 대비 LoRA는 r(파라미터 수)을 바꿈에 따라 적든 크든 꾸준한 성능을 보임
[모델을 불러오면서 LoRA 적용하기]
from transformers import AutoModelForCausalLM, AutoTokenizer
from peft import LoraConfig, get_peft_model

def load_model_and_tokenizer(model_id, peft=None):
    tokenizer = AutoTokenizer.from_pretrained(model_id)

    if peft is None:
        model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype="auto", device_map={"":0})

    elif peft == 'lora':
        model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype="auto", device_map={"":0})
        lora_config = LoraConfig(                         --- (1)
                    r=8,
                    lora_alpha=32,
                    target_modules=["query_key_value"],
                    lora_dropout=0.05,
                    bias="none",
                    task_type="CAUSAL_LM"
                )

        model = get_peft_model(model, lora_config)        --- (2)
        model.print_trainable_parameters()                --- (3)

    print_gpu_utilization()
    return model, tokenizer
(1) load_model_and_tokenizer 함수에 peft 인자를 'lora'로 설정. peft 라이브러리에서 LoraConfig 클래스를 사용하여 LoRA를 적용 설정
(2) 다음으로 불러온 모델에 lora_config를 적용해 파라미터를 재구성하는 get_peft_model 함수 호출
(3) 모델 재구성 후 학습 파라미터의 수와 비중을 확인하는 print_trainable_parameters() 메서드 호출
cleanup()
print_gpu_utilization()

gpu_memory_experiment(batch_size=16, peft='lora')

torch.cuda.empty_cache()
LoRA를 적용하면서 학습 가능한 파라미터가 전체 파라미터 대비 0.117%.
모델을 불러 왔을 때 메모리 사용량은 이전과 거의 동일하나, 옵티마이저 상태의 메모리 사용량과 그레이디언트 메모리 사용량이 현저히 줄어듦
이는 전체 파라미터를 학습하는 것이 아닌 전체의 0.117%만 학습하기 때문
효율적인 학습 방법(PEFT): QLoRA(Efficient Finetuning of Quantized LLMs - 양자화된 LLM의 효율적인 미세 조정)
양자화란 기존 데이터를 더 적은 메모리를 사용하는 데이터 형식으로 변환하는 방법
LoRA: 16비트
QLoRA: 4비트. 오른쪽에 CPU 메모리가 함께 표시되어 있는데 QLoRA는 학습 도중 OOM 발생하지 않고 안정적으로 진행될 수 있도록 페이지 옵티마이저(paged optimizer) 기능을 활용
페이지 옵티마이저: 엔비디아의 통합 메모리를 통해 GPU가 CPU 메모리(RAM)를 공유하는 것을 의미. 통합 메모리는 컴퓨터의 가상 메모리 시스템과 유사한 개념을 GPU 메모리 관리에 적용한 기술
CPU는 GPU가 메모리를 공유해 더 많은 GPU 메모리가 있는 것처럼 동작. GPU가 처리해야 할 데이터가 많을 때 일부 데이터를 CPU 메모리에 보관했다가 해당 데이터가 필요해지면 CPU 메모리에서 GPU 메모리로 옮겨 처리
from transformers import AutoModelForCausalLM, AutoTokenizer, BitsAndBytesConfig
from peft import LoraConfig, get_peft_model, prepare_model_for_kbit_training

def load_model_and_tokenizer(model_id, peft=None):
    tokenizer = AutoTokenizer.from_pretrained(model_id)

    if peft is None:
        model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype="auto", device_map={"":0})

    elif peft == 'lora':
        model = AutoModelForCausalLM.from_pretrained(model_id, torch_dtype="auto", device_map={"":0})
        lora_config = LoraConfig(
                    r=8,
                    lora_alpha=32,
                    target_modules=["query_key_value"],
                    lora_dropout=0.05,
                    bias="none",
                    task_type="CAUSAL_LM"
                )

        model = get_peft_model(model, lora_config)
        model.print_trainable_parameters()
    elif peft == 'qlora':
        lora_config = LoraConfig(
                    r=8,
                    lora_alpha=32,
                    target_modules=["query_key_value"],
                    lora_dropout=0.05,
                    bias="none",
                    task_type="CAUSAL_LM"
                )
        bnb_config = BitsAndBytesConfig(    --- (1)
                  load_in_4bit=True,
                  bnb_4bit_use_double_quant=True,
                  bnb_4bit_quant_type="nf4",
                  bnb_4bit_compute_dtype=torch.float16
              )
        model = AutoModelForCausalLM.from_pretrained(model_id, quantization_config=bnb_config, device_map={"":0})  --- (2)
        model.gradient_checkpointing_enable()                                                                      --- (2)
        model = prepare_model_for_kbit_training(model)                                                             --- (2)
        model = get_peft_model(model, lora_config)   --- (3)
        model.print_trainable_parameters()           --- (3)

    print_gpu_utilization()
    return model, tokenizer
(1) BistAndBytesConfig 클래스를 사용하여 양자화 설정 정의
(2) 양자화 설정인 bnb_config를 사용해 모델을 불러오고 학습시키기 위한 준비 과정으로 prepare_modle_for_kbit_training 함수 호출
(3) LoRA 설정을 적용하기 위해 get_peft_model 함수를 호출, 학습 가능한 파라미터 수를 확인하기 위해 print_trainable_parameters() 메서드를 사용
cleanup()
print_gpu_utilization()

gpu_memory_experiment(batch_size=16, peft='qlora')

torch.cuda.empty_cache()
총 GPU 메모리 사용량이 2.651GB로 감소 (LoRA: 4.732GB)
kyungmi.kim 님의 최신 블로그
더보기-

- 효율적인 GPU 메모리 사용을 위한 여러 기법
- 키워드: GPU(Graphic Processing Unit), OOM(Out of Memory) / 그레이디언트 누적(gradient accumulation), 그레이디언트 체크포인팅(gradient checkpointing) / 분산학습(distributed training), 데이터 병렬화(data parallelism), 모델 병렬화(model parallelism), 파이프라인 병렬화(pipeline parallelism), 텐서 병렬화(tensor parallelism) ZeRO(Zero Redundancy Optimizer) / 효율적인 학습 방법(PEFT: Parameter Efficient Fine-Tuning), LoRA(Low-Rank Adapt...
-

- 모델 정렬을 위한 효과적인 학습 전략
- 말 잘 듣는 모델 만들기 Keyword: 사전 학습, 지도 미세 조정(supervised fine-tuning), 지시 데이터셋(instruction dataset) 강화 학습, RLHF(Reinforcement Learning from Human Feedback), PPO(Proximal Preference Optimization) 기각샘플링(rejective sampling), 직접 선호 최적화(Direct Preference Optimization, DPO) 사전 학습 LLM은 인터넷 상의 다양한 텍스트 데이터를 수집한 대용량의 텍스트로 사전 학습 수행 사전 학습 동안에는 LLM이 특정한 형태로 응답하거나 사용자의 요청에 따라 응답 하기를 기대하기는 어렵고,...
DEVOTEE 추천 블로그
-

- Hugging Face API로 배우는 GPU 친화적 모델 학습
- 모델 학습 과정 딥러닝을 GPU에서 수행하는 과정은 크게 1. 환경 설정, 2. 모델 준비, 3. 학습 실행, 그리고 4. 결과 활용의 단계로 나눌 수 있습니다. 환경 설정 단계에서는 NVIDIA GPU가 장착된 컴퓨터에 CUDA와 cuDNN을 설치하여 GPU 사용 환경을 구축합니다. 이는 GPU를 딥러닝에 활용할 수 있게 해주는 기반 작업입니다. 다음으로, TensorFlow나 PyTorch 같은 딥러닝 프레임워크를 설치합니다. 이 프레임워크들은 GPU를 효율적으로 사용할 수 있는 도구를 제공합니다. 모델 준비 단계에서는 사용할 딥러닝 모델을 설계하고, GPU 메모리에 맞게 데이터 처리 방식을 조정합니다. 학습 실행 단계에서는 모델과 데이터를 GPU 메모리로 이...
-

- vLLM로 효율적인 모델 서빙하기
- sLLM 서빙하기 동일한 연산을 수행하면서 성능 하락이 없으면서도 추론 능력을 향상시키는 방안을 통해 모델 서빙을 수행합니다. 배치 전략과 트랜스포머 연산, 추론 전략으로 나눠서 살펴봅니다. 배치전략 (batching) LLM 서빙에서 배치 전략은 모델의 처리량과 지연 시간을 최적화하는 데 중요한 역할을 합니다. 정적배치: 일반 배치로 고정된 크기의 배치가 채워질 때마다 처리하는 방식입니다. 입력 데이터를 배치할 때 한번에 N개 입력을 받아 모두 추론이 끝날때까지 기다리는 방식입니다. 지연 시간이 크게 증가할 수 있어 실시간 서비스에는 적합하지 않습니다. 동적배치: 동적 배치는 일정 시간 동안 들어온 요청들을 모아서 한 번에 처리하는 방식입니다. GPU 자원을 효...
-

- 실험으로 알아보는 LLM 파인튜닝 최적화 가이드 Part 1.
- 들어가며 오랜만에 새로운 포스팅을 시작합니다. 2025년 새해 복 많이 받으세요! 이번 글에서는 파인튜닝 최적화를 주제로, 학습에 관련된 파라메터 설정과 최적화 요소에 대한 내용을 다루려고 합니다. 사실 학습 파라미터 설정에 관한 문서는 많지만, 설정값에 따라 어떤 결과가 나오는지 구체적으로 다룬 사례는 드문 편입니다. 그래서 현업에서는 여러 번의 실험과 시행 착오를 거쳐 최적의 값을 찾아내는 경우가 많죠. LLM 파인튜닝처럼 비용이 많이 드는 작업에서는 이러한 시행착오의 비용이 큰 부담으로 작용할 수 밖에 없습니다. 이번 포스팅에서는 다양한 설정이 결과에 미치는 영향을 직접 실험을 통해 살펴보며, 이를 통해 파인튜닝 최적화에 대한 이해를 좀 더 해보고자 합니다....
-

- CUDA OOM 해결 사례 공유 - PyTorch all_gather_object 의 비밀
- CUDA OOM (Out of Memory)란? CUDA OOM 오류는 NVIDIA GPU에서 제공하는 메모리(RAM)가 부족할 때 발생하는 오류입니다. 주로 딥러닝 모델 학습이나 대용량 데이터 처리 중 다음과 같은 상황에서 발생합니다: 너무 큰 배치 사이즈(batch size) 설정 너무 복잡한 모델 아키텍처 사용 모델 파라미터나 입력 데이터가 GPU 메모리를 초과 메모리 누수(memory leak) 또는 해제하지 않은 텐서 🔍 해결 방법 배치 사이즈 줄이기 with torch.no_grad()로 불필요한 그래디언트 계산 방지 del, gc.collect(), torch.cuda.empty_cache()로 수동 메모리 해제 Mixed Precision Trai...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.