
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Meta XR Device 활용 러닝 Agent 서비스 개발 - 연구 결과(3)
- DEVOTEE 요약
- Metaphor 팀은 Meta XR Device를 사용하여 러닝 에이전트 서비스를 개발하고 있습니다. 연구의 핵심은 Edge AI를 활용하여 기존 2D 텍스트 및 이미지 기반 학습의 한계를 극복하고, 3D Reconstruct와 LLM 에이전트를 통해 학습자의 이해도를 높이는 것입니다. 또한, Meta-All-In-One-SDK를 사용하여 사용자가 음성 명령으로 3D 모델을 생성하고 상호작용할 수 있도록 하여 초개인화된 학습 경험을 제공합니다.
안녕하세요!
저희는 'Meta XR Device 활용 러닝 Agent 서비스 개발'을 진행하고 있는 Metaphor 팀입니다.
이번 기록에서는 지금까지 연구한 내용을 최종적으로 정리하여 말씀드리도록 하겠습니다.
Edge AI란?
Edge AI는 클라우드나 중앙 서버가 아닌, 데이터가 생성되는 '엣지(edge)' 즉, 실제 기기나 장치에서 직접 인공지능을 구동하는 기술을 말합니다.
예를 들어, 스마트폰에서 얼굴을 인식하거나 스마트 스피커가 음성을 인식할 때, 데이터를 서버로 전송하지 않고 기기 자체에서 처리하는 것이 Edge AI입니다.
이러한 Edge AI를 활용해서 일상생활의 공부 환경에 어떻게 적용할 수 있을까가 저희 연구의 핵심 주제였습니다.
기존 학습의 문제점
기존의 학습 플랫폼에는 두 가지 주요 문제가 존재합니다.
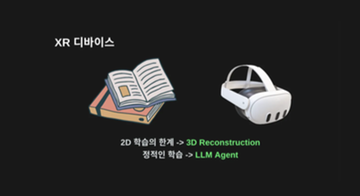
첫번째로, 2D 학습의 한계입니다. 전통적인 교육 자료는 주로 2차원적인 텍스트, 이미지, 그리고 동영상으로 구성되어 있습니다.
이러한 2D 자료는 정보 전달에는 효과적일 수 있으나, 복잡한 개념이나 구조를 심층적으로 이해하는 데에는 한계가 있습니다.
예를 들어, 건축학에서 복잡한 건물의 구조를 이해하려면 3D 모델이 필요한데, 2D 도면만으로는 공간적인 이해가 제한됩니다.
이러한 2D 학습의 한계는 학습자의 이해도를 낮추고, 실질적인 응용 능력을 저해할 수 있습니다.
둘째로, 정적인 학습의 한계입니다. 기존의 학습 방식은 주로 교사가 지식을 전달하고 학생이 이를 수동적으로 받아들이는 형태로 이루어집니다.
이처럼 일방향적인 학습은 학습자의 참여도와 흥미를 감소시킬 수 있으며, 개인의 학습 속도나 스타일을 고려하지 못합니다.
실시간 피드백이나 상호작용이 부족하여 학습자가 자신의 이해 수준을 즉각적으로 파악하고 보완하는 데 어려움을 겪습니다.
솔루션
위에서 언급한 기존 학습의 문제점을 극복하기 위하여 본 프로젝트에서 XR 디바이스를 활용하여 다음과 같은 솔루션을 제시하였습니다.
먼저, 2D 학습 자료의 한계를 극복하기 위해 3D Reconstruction 기술을 도입하였습니다.
해당 기술로 2차원 이미지나 자료를 3차원 오브젝트로 변환할 수 있습니다. 이를 통해 학습자는 입체적인 정보를 보다 직관적으로 이해할 수 있게 됩니다.
예를 들어, 세포나 분자 구조를 3D로 시각화하여 복잡한 생물학적 과정을 쉽게 이해할 수 있습니다.
다음으로 정적인 학습의 한계를 극복하기 위해 대규모 언어 모델(LLM) 에이전트가 학습자를 지속적으로 보조하는 방법을 도입하였습니다.
LLM 에이전트는 인공지능 기반의 가상 조교로서, 학습자의 질문에 실시간으로 답변하고, 추가적인 설명이나 예시를 제공하며, 학습 진행 상황을 분석하여 맞춤형 피드백을 줍니다.
이를 통해 학습자는 초개인화된 학습 경험을 누릴 수 있습니다.
개발 목표
중간 발표 이후 저희는 다음과 같은 개발 목표를 설정하였습니다.
중간발표 내용 개선: 기존 LLM의 답변이 신뢰할 수 있을만한 답변이 되도록 방법론 적용
제시한 솔루션을 위한 새로운 UseCase: 2D to 3D 모델 생성 과정 자동화
사용자가 Meta Quest에서 글씨를 타이핑할 필요 없이, 목소리만으로 명령하는 기능
Unity의 C# 환경에서 AI가 돌아가도록 우선 서버로 모든 UseCase를 구현, 후에는 온디바이스 AI로 전환
개발 내용
시스템 아키텍처
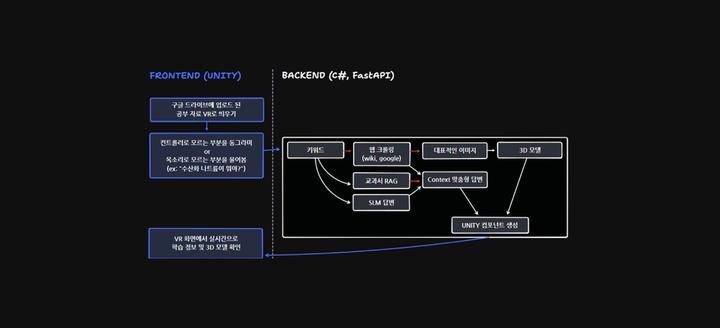
본 시스템 구조는 온디바이스에서 수행되는 부분과 서버(Server)에서 수행되는 부분으로 나뉩니다.
SST와 LLM Agent와 같이 빠른 Interaction이 중요한 기능들을 온디바이스AI 환경으로 구현하고, 3D Reconstruction과 같이 고성능의 모델로 정교한 출력을 내는 것이 중요한 기능을 서버에서 구현하였습니다.
UseCase 정의
저희가 제시한 솔루션에 어울리는 UseCase는 크게 두가지였습니다: Create3D, Describe
1. Create3D: 이미지로부터 3D 모델을 생성
”티라노사우루스의 뼈 구조가 궁금해!”와 같은 질문이 유저한테서 들어오면:
유저가 현재 보고 있던 PDF 페이지를 AWS S3에 업로드합니다.
그 다음 FastAPI에게 질문의 의도(Create3D), 유저의 질문, 공룡 이름, 업로드된 페이지 이름을 JSON 형식으로 HTTP POST로 전달합니다.
FastAPI에서는 JSON 형식을 전달받고 AWS S3에서 페이지 이미지를 전달받은 다음, 해당 이미지를 기반으로 Meshy 모델을 통해 3D 오브젝트를 생성합니다.
생성된 오브젝트를 리턴하면 3D 모델을 Unity에서 HTTP GET로 전달받아 앱에 띄워주게 됩니다.
2. Describe: sLLM, 위키 크롤링, RAG의 답변을 활용하여 유저의 질문에 대한 답변 생성
“티라노사우루스는 갈비뼈가 총 몇 개야?”와 같은 질문이 유저한테서 들어오면:
Image → 3D 오브젝트 생성 in FastAPI
어떤 이미지가 오더라도 그에 맞는 3D 모델을 생성하는 것이 핵심 목적이었습니다.
그러나 3D 오브젝트를 생성하는 과정에서 저희는 일부 이미지들이 저희가 기대한 것과 다르게 처리되는 현상을 발견하였습니다.
첫 번째 문제는 Artifact의 형성이었습니다.
원본 사진에 원하지 않는 요소나 노이즈가 포함되어 있는 경우(예: 교재 내의 화살표) 3D 생성 과정에 같이 포함된다는 점이었습니다.
이 문제를 해결하기 위해 다음과 같은 솔루션을 사용하였습니다:
U2-Net 활용
다중 스케일 특징 추출로 객체의 세밀한 윤곽선까지 포착하여 정교한 분할 수행
불필요한 배경이나 노이즈 제거
RGBA 포맷으로 투명 배경 생성
3D 재구성이나 포스트 프로세싱에서 불필요한 오브젝트와의 혼선 감소
대상 객체를 명확하게 분리하는 데 유리
두번째 문제는 Aliasing의 발생이었습니다. 오브젝트 특징이 심각하게 왜곡되는 현상(예: 트리케라톱스의 뿔이 2개 혹은 4개로 보여지는 경우)이 발생하였습니다.
나이퀴스트 이론에 따르면, 샘플링 주파수가 원본의 주파수보다 상대적으로 낮으면 오류가 발생하게 됩니다.
따라서 저희는 다음과 같은 솔루션을 사용하였습니다:
cv2.INTER_AREA 알고리즘으로 픽셀 영역 기반 다운샘플링하여 앨리어싱 방지
8비트 깊이의 정확한 투명도 정보 보존
경계 부분의 부드러운 전환에 대한 정보
이미지를 배경에 자연스럽게 겹치게 하여 앨리어싱 문제 완화
텍스처 매핑에서 mipmapping 또는 anisotropic filtering을 사용해 텍스처 앨리어싱 방지
LLM Agent
멀티소스 데이터통합 프레임워크
sLLM의 답변, 위키에서 크롤링한 내용, 교과서 기반의 RAG 이렇게 세가지 방법으로 생성한 답변을 하나의 답변으로 Integration하는 부분은 중간발표와 거의 유사합니다.
다만 중간발표에서 사용한 코드의 문제점은, 위키 페이지를 잘 발견하지 못한다는 점, 설사 발견을 하더라도 위키 내용의 첫 문단만 가져오기 때문에 질문에 대한 특화된 답변 생성이 불가능하다는 점이었습니다.
위키 페이지의 링크는 주로 https://en.wikipedia.org/wiki/{공룡이름} 의 형식입니다.
따라서 유저의 질문이 들어오면 그 질문의 핵심이 되는 공룡 이름만을 추출하는 LLM을 크롤링 이전 단계에 추가하였습니다.
또한 위키의 첫 문단이 아니라 전체 내용을 가져오되, 이를 전부 다 사용하면 토큰의 문제가 있어서(한 페이지 당 30,000 토큰) 사용자의 질문을 답변할 수 있는 세 문장만을 추출하여
답변을 생성하도록 코드를 수정하는 방안으로 토큰의 문제를 해결하였습니다(1000 토큰 이내로 감소).
온디바이스 기능 고도화
Unity 전체적인 환경 개발 & 서버와의 소통
Meta-All-In-One-SDK란?
Meta에서 제공해주는 Meta Quest용 개발 에셋으로, 마치 라이브러리 같은 개념입니다.
유저의 컨트롤러나 손 모양을 감지하는 UseCase, 유저가 Unity의 오브젝트를 잡거나 누르는 등 Interaction을 지원하는 UseCase,
유저의 음성을 듣고 처리하는 UseCase 등 Meta Quest에서 생길 만한 다양한 시나리오에 대한 에셋을 제공해줍니다.
이번 프로젝트의 핵심이 되는 Voice SDK도 이에 포함되어 있습니다.
유저 Interaction UseCase 개발
사진의 왼쪽 부분은 Unity에서 작동하는 PDF Reader입니다. 본래 Unity는 자체적으로 PDF 파일을 열 수 있는 방법이 없습니다.
따라서 유저가 업로드한 PDF를 다운받으면 이를 이미지들로 파싱하여 Assets/Images 디렉토리에 저장하도록 한 뒤, Quad 오브젝트에서 이미지를 렌더링하도록 개발하였습니다.
왼쪽/오른쪽 화살표를 누르면 이전/다음 페이지에 해당하는 이미지를 재렌더링하게 됩니다.
중간 부분은 유저의 질문(예: “티라노사우루스는 왜 팔이 짧아?”)을 입력받는 부분입니다.
오른쪽 부분은 유저의 질문에 대한 답변을 띄우는 Canvas 오브젝트입니다. Title, Subtitle, 질문에 대한 답변, 사진, 그리고 참고한 출처를 표시하게 됩니다.
Shader에 대한 고민
Unity 배경을 장식하기 위해 Museum Asset을 사용하고자 했지만, Shader 호환성의 문제가 발생하였습니다.
Unity에는 HDRP, URP, Built-in의 shader가 존재하며, 그중 HDRP는 가장 무거운 shader로 RTX 등의 다양한 기능들을 지원하는 반면, Built-in은 가장 퀄리티가 낮지만 가벼운 shader입니다.
처음에는 HDRP로 개발을 하다가, Meta Quest는 안드로이드 빌드를 기반으로 작동하기 때문에 가장 가벼운 Built-in Shader 변경하였습니다.
Unity에서 shader의 종류를 바꾸려면 아얘 새로운 프로젝트를 생성해야 하기 때문에 시행착오가 꽤나 있었던 편입니다.
만약 이 프로젝트를 다시 진행하라고 하면 Shader에 대한 고민부터 시작했을 것 같습니다.
VoiceSDK & Wit.ai - 사용자의 음성만을 이용한 워크플로우
VoiceSDK란?
Meta-All-In-One-SDK에 포함된 에셋 중 하나로, Meta Quest에서 음성 명령이 들어오면 자체적인 프로세스를 통해 음성 명령의 의도를 파악하고 그에 알맞는 UseCase를 실행하도록 도와주는 도구
예를 들어, 사용자가 타이핑을 하고 버튼을 누르는 대신 “스테고사우루스의 모형을 보여줘!”라는 말 한마디만 하면 백엔드에서 3D 생성 과정이 자동으로 수행됩니다.
Wit.ai란?
문장이 들어오면 문장의 의도(Intent), 문장에 있는 요소(object) 등을 감지하는 AI입니다.
적은 수의 문장들 만으로도 효과적으로 파인튜닝할 수 있다는 장점이 있었습니다(Create3D, Describe, OUT OF SCOPE 각각 200여개의 문장만을 사용하였고 97% 이상의 Accuracy를 달성하였습니다.)
파인튜닝을 할 때의 핵심 스킬은 Speech to Text 과정에서 생길 만한 왜곡을 반영하는 것이었습니다.
예를 들어 “티라노사우루스의 뼈 구조를 보고 싶어”라는 문장이 있으면 “티라노 사우스의 뼈 구조 보고 싶” 혹은 “칠하노사우루스 벼 구조를 복오 싶어” 등 다양한 문장들로 Data Augmentation을 하였습니다.
완전한 Edge AI로의 확장
본 프로젝트에서 유일하게 서버에서 작동하는 기능은 “3D Reconstruction” 기술입니다.
현재는 온디바이스에서 작동하는 3D 모델들의 한계가 명확합니다.
그러나 현재 학계에서 온디바이스 NeRF 기술이 활발히 연구되고 있는 만큼, 본 팀이 구현한 수준의 3D 모델을 온디바이스 상에서 생성할 수 있을 것이라 기대됩니다.
본 프로젝트에서 개발한 프레임워크 위에, 온디바이스 모델의 고도화를 연구한다면 유저에게 완전한 학습경험을 제공할 수 있습니다.
최종시연
https://drive.google.com/file/d/19cWmnbXzqJgmvqUxPPN13cD9jnzoz1iw/view?usp=sharing
최종시연을 보여드리며 최종 연구결과 보고 마무리하도록 하겠습니다. 감사합니다.
dohyun11111m 님의 최신 블로그
더보기-
- Meta XR Device 활용 러닝 Agent 서비스 개발 - 연구 결과(3)
- 안녕하세요! 저희는 'Meta XR Device 활용 러닝 Agent 서비스 개발'을 진행하고 있는 Metaphor 팀입니다. 이번 기록에서는 지금까지 연구한 내용을 최종적으로 정리하여 말씀드리도록 하겠습니다. Edge AI란? Edge AI는 클라우드나 중앙 서버가 아닌, 데이터가 생성되는 '엣지(edge)' 즉, 실제 기기나 장치에서 직접 인공지능을 구동하는 기술을 말합니다. 예를 들어, 스마트폰에서 얼굴을 인식하거나 스마트 스피커가 음성을 인식할 때, 데이터를 서버로 전송하지 않고 기기 자체에서 처리하는 것이 Edge AI입니다. 이러한 Edge AI를 활용해서 일상생활의 공부 환경에 어떻게 적용할 수 있을까가 저희 연구의 핵심 주제였습니다. 기존 학습의 문...
-
- Meta XR Device 활용 러닝 Agent 서비스 개발 - 연구과정(2)
- 안녕하세요! 저희는 'Meta XR Device 활용 러닝 Agent 서비스 개발'을 진행하고 있는 Metaphor 팀입니다. 이번 기록에서는 저희가 지난 6월부터 현재까지 어떤 연구를 진행하였고, 남은 기간 동안 어떠한 연구를 계획하고 있는지에 대해 공유해 드리겠습니다. 1. 과제 개요 저희의 과제의 핵심은 학생이 공부를 하는 와중에 모르는 부분에 대한 시각적 자료를 즉각적으로 보고 들을 수 있는 XR 러닝 Agent를 개발하는 것입니다. 저희는 본래 AR을 통해 해당 문제를 해결하고자 하였습니다. 직접 메타퀘스트를 통해 교과서를 실시간으로 보고 모르는 부분을 가리키면 그에 대한 교과서/위키 등을 기반하여 설명을 보여주고, 그에 적합한 그림과 3D 모델을 보여주...
-
- AR 기반 생성AI 학습 어시스턴트 - 연구계획(1)
- 안녕하세요, SKT AI Fellowship 6기 ‘AI 디바이스 기반 특화 서비스 발굴 및 개발’ 과제를 수행 중인 팀 Metaphor 입니다. 팀 이름으로는 메타버스를 통해 공부하다가 모르는 내용을 비유와 시각적인 자료로 해결해준다는 의미로, Metaverse + Metaphor의 단어를 합성했습니다 :) 연구 배경 우리는 이미 LLM의 시대에 살고 있습니다. 이제는 GPT를 사용하지 않는 학생들을 찾아보기 힘들 정도입니다. 실제로 여러 RAG와 Fine Tune된 모델들을 통해 LLM은 세부적인 분야에서 활약하고 있습니다. 저희 팀은 이런 LLM을 증강현실 기기에 탑재하여 보다 직관적인 학습 어시스턴트를 개발하고자 합니다. 기술 개요 1) RAG 기본 개념 ...
DEVOTEE 추천 블로그
-
- Language-Image Multi-modal AI 기술 연구 - 연구 결과(3)
- 안녕하세요! 저희는 SKT AI FellowShip 4기에서 Language-Image Multi-Modal AI 기술 연구를 맡았던 Team KEANU입니다! 지난 6개월동안 연구했던 결과물을 여러분들께 공유해 드리고 싶어서 이렇게 최종 결과물을 보여드리려 합니다. 저희가 올렸던 데보션 글들을 읽어주셨던 분들은 아시겠지만, 많은 노력이 들어간 결과물 이네요. 😁 만약, 실제로 A.에 저희 기술이 들어간다면 사회적으로 엄청난 파급효과를 일으킬 수 있을까요? 자, 그럼 최종 발표 ppt를 보면서 최종 결과물을 같이 보러 가시죠! 저희 ppt 표지입니다! 오른쪽에는 귀여운 에이닷 로고와 캐릭터들이 함께 하고 있습니다. 왜냐면 저희는 Target이 A.이기 때문이죠!...
-
- AR 기반 생성AI 학습 어시스턴트 - 연구계획(1)
- 안녕하세요, SKT AI Fellowship 6기 ‘AI 디바이스 기반 특화 서비스 발굴 및 개발’ 과제를 수행 중인 팀 Metaphor 입니다. 팀 이름으로는 메타버스를 통해 공부하다가 모르는 내용을 비유와 시각적인 자료로 해결해준다는 의미로, Metaverse + Metaphor의 단어를 합성했습니다 :) 연구 배경 우리는 이미 LLM의 시대에 살고 있습니다. 이제는 GPT를 사용하지 않는 학생들을 찾아보기 힘들 정도입니다. 실제로 여러 RAG와 Fine Tune된 모델들을 통해 LLM은 세부적인 분야에서 활약하고 있습니다. 저희 팀은 이런 LLM을 증강현실 기기에 탑재하여 보다 직관적인 학습 어시스턴트를 개발하고자 합니다. 기술 개요 1) RAG 기본 개념 ...
-
- On Device상의 (인지/판단/실행) 모델 파이프라인 기술 개발 - 연구과정(2)
- 안녕하세요 🐰 저희는 On Device상의 (인지/판단/실행) 모델 파이프라인 기술 개발 과제를 수행 중인 SKT AI Fellowship 6기 O.DA (On Device AI) 팀 이선민, 장윤서 입니다. 이번 포스트에서는 저희가 중간 발표까지 3개월동안 진행한 연구 내용에 대해 말씀드리겠습니다. 1. 연구 과제 및 목표 (1) 연구 과제 저희는 사용자로부터 받은 다양한 입력을 직접 인지, 판단, 실행할 수 있는 모델 파이프라인을 연구하고 있습니다. 인지, 판단 파이프라인은 사용자로부터 다양한 입력(ex. text, audio, image 등)을 받으면 On-Device 내에서 사용자의 입력을 처리하고 sLLM을 이용해 사용자의 의도를 파악합니다. 예를 들어...
-
- Meta XR Device 활용 러닝 Agent 서비스 개발 - 연구과정(2)
- 안녕하세요! 저희는 'Meta XR Device 활용 러닝 Agent 서비스 개발'을 진행하고 있는 Metaphor 팀입니다. 이번 기록에서는 저희가 지난 6월부터 현재까지 어떤 연구를 진행하였고, 남은 기간 동안 어떠한 연구를 계획하고 있는지에 대해 공유해 드리겠습니다. 1. 과제 개요 저희의 과제의 핵심은 학생이 공부를 하는 와중에 모르는 부분에 대한 시각적 자료를 즉각적으로 보고 들을 수 있는 XR 러닝 Agent를 개발하는 것입니다. 저희는 본래 AR을 통해 해당 문제를 해결하고자 하였습니다. 직접 메타퀘스트를 통해 교과서를 실시간으로 보고 모르는 부분을 가리키면 그에 대한 교과서/위키 등을 기반하여 설명을 보여주고, 그에 적합한 그림과 3D 모델을 보여주...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.