
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구결과(3)
- DEVOTEE 요약
- SKT AI Fellowship 6기에서 고스체인 팀은 데이터 인텔리전스를 실현하기 위한 AI 데이터분석가 도입 프로젝트를 수행했습니다. 머신러닝 모델의 성능을 향상시키기 위해 피처 발굴을 중심으로 한 AI 기반 데이터 인텔리전스 시스템을 개발하였으나, 현재는 특허 출원 및 논문 심사 중이어서 기술적 세부내용은 공개할 수 없는 상황입니다. 이번 프로젝트를 통해 팀원들은 AI와의 협업 가능성을 높이는 성과를 얻었으며, 이를 바탕으로 향후 더욱 넓은 영역에서 AI 활용을 기대하고 있습니다.
안녕하세요 😃
SKT AI Fellowship 6기 “AI 데이터분석가 도입을 통한 데이터 인텔리전스 실현” 과제를 수행한 고스체인 팀입니다.
지난 10월 31일 최종 발표를 마지막으로, 약 6개월간의 펠로우쉽 과제 수행을 마무리하였습니다.
펠로우 자격으로 데브오션에 글을 쓰는 마지막 시간이 되었습니다.
이번 글에선 저희 팀이 수행한 과제가 무엇인지, 어떠한 새로운 AI 기술을 만들었는지를 말씀드리고 그 결과와 기술 활용 사례를 공유드리려 합니다.
다만, 현재 글을 처음 게시하는 시점에서는 특허 출원과 논문 심사가 진행 중인 상황이라,
당장 현 시점에서 기술적 개발 부분, 성능 결과 관련한 내용들을 담아내지 못하게 된 점을 미리 양해의 말씀을 드리고자 합니다.
특허 출원, 논문 심사가 마무리가 되는 대로 생략된 부분을 채우도록 하겠습니다.
과제 배경
DL이 아닌 ML류의 모델들도 여전히 중요하게 쓰이고 있습니다.
이는 DL에 비해 ML이 가지는 더 나은 장점들에 기인합니다. (빠른 학습 속도, 가벼운 리소스, 모델의 높은 해석 가능성)
이런 장점들은 데이터 기반의 의사결정을 내리는 데 큰 역할을 하게 됩니다.
따라서 높은 성능의 머신러닝 모델을 구축하는 것은 대단히 중요하게 되고, 이를 위해선 모델 측면, 데이터 측면 각각에서 많은 작업들을 하게 됩니다.
그런데, 실제 현업에서는 모델의 학습 절차뿐만이 아닌, 아래 사진1)과 같이 MLOps 차원 등 학습 이외의 전사적인 시스템도 고려해야 해 현실적으로 모델링 학습 자체에만 신경을 쓰기엔 어려운 상황입니다.
(ML)파트 뿐만이 아니라 (Ops)도 고려하지 않을 수 없음을 모식도를 통해서 알 수 있습니다.
문제 정의 및 해결 과정, 결과
✔️ 문제 정의
이러한 상황에서, 어떻게 머신러닝 모델의 성능을 높일 수 있을지 고민하게 됩니다.
머신러닝 모델의 좋은 성능을 달성하기 위해선 데이터의 질을 높이는 방안이 있습니다.
그 중 중요한 축을 이루는 부분이 피처 발굴입니다.
매우 간단한 예시로, 아래와 같이 Price, Sales, Category 변수가 데이터에 존재한다고 생각해 봅시다.
모델링 혹은 데이터 분석에 중요한 도움이 되는 정보라 판단되는 관계를 생각하고, 이를 토대로 새로운 변수를 만듭니다.
가령 아래의 노란색 음영처럼 가격과 판매량의 비율, 각 변수의 정규화된 값 등을 생각할 수 있습니다.
만약 이들을 추가해 머신러닝 모델을 적합하였는데 모델의 성능이 향상되면 좋은 피처를 발굴한 것이라 할 수 있습니다.
피처를 새롭게 발굴하는 것은, 데이터 사이언티스트의 전문 지식, 다년간에 축적된 노하우 등이 포함된 종합적인 사고 과정을 요구합니다.
이런 사고 과정을 도맡아 피처 발굴 역할을 수행하는 LLM을 만들어, AI 기반의 데이터 인텔리전스를 실현하자는 것이 저희 팀의 최종 과제 목표가 되었습니다.
부가적으로, DB에서 데이터를 추출하는 간단한 sql쿼리를 반환하는 수준의 LLM도 간단하게 만들어 데이터 업무 효율화를 기여하고자 하였습니다.
✔️ 해결 과정 및 결과, 활용 방안
위의 문제들은 여러 데이터 분석과 관련한 문헌, 자료들을 토대로 LLM, 최신 AI 기술들을 활용하여 저희가 정의한 문제를 해결할 수 있었습니다.
이전 중간 연구 진행 상황을 기준으로 간략하게 정리해 보면,
사내 보안 문제, 리소스 자원 문제를 염려하여, 로컬에서도 충분히 사용할 수준의 소형 sLLM 모델을 이용해 거대 언어 모델에 준하는 능력을 가질 수 있도록 하였습니다.
또한, 새로운 피처를 발굴하도록 모델 학습과 더불어 더 나은 LLM을 만들 수 있도록 여러 조치들을 취하였습니다.
서두에 말씀드린 대로, 당장 이 부분에 대해서는 추후 특허와 논문 절차가 마무리가 되는 대로 이 부분에 대해 자세히 수정해서 적을 계획입니다. 😭
마무리, 참여 소감
펠로우쉽 모집 공고부터 최종 발표까지, 약 6개월간의 시간을 통해 과제를 마무리하였습니다.
아쉬움도 남지만, 그만큼 저희 펠로우들은 이번 프로젝트의 경험을 소중하게 간직하고, 각자의 다음 목표를 향해 더 성장하고자 합니다.
지금까지 과제를 위해 힘써주신 저희 고스체인 팀 멘토님들께도 다시 한번 감사의 말씀을 전하고 싶습니다.
끝으로 저희 팀 펠로우들의 개인적인 소감으로 마무리를 하겠습니다. 대단히 감사합니다.
처음 과제를 시작하게 될 때는 너무 어렵게 느껴지고, 과연 원하는 대로 LLM을 만들 수 있을까라는 근심과 걱정이 없었다고 하면 거짓말입니다.
하지만 저희 고스체인 팀 팀원들, 그리고 멘토님들이 큰 힘이 되어 주어서 잘 과제를 마무리할 수 있었습니다.
저에겐 6개월이 질적으로 더 성장한 사람이 될 수 있었던 소중한 시간이었습니다.
6개월이라는 긴 시간 동안 힘든 순간도 많았지만, 그만큼 즐겁게 배우고 다양한 실험을 할 수 있었습니다.
SKT AI Fellowship 덕분에 소중한 기회를 가질 수 있었고, 이를 통해 한층 더 성장할 수 있었음을 느낍니다.
많은 지원과 배움의 기회를 제공해 주신 SKT AI Fellowship 관계자분들께 진심으로 감사드리며, 앞으로도 이곳에서 배운 것들을 바탕으로 더욱 발전해 나가고자 합니다.
요즘 많은 기업들이 AI를 통해 업무를 자동화하거나, 고객들에게 AI서비스를 제공하기 위해 투자를 확대하고 있습니다.
특히 ChatGPT등을 통해 개인의 업무나 일상에서 AI와의 협업이 자연스러워지고 있는데요,
앞으로는 AI와의 협업이 특정 기업이나 분야에 국한되지 않고 더 넓은 영역으로 확대될 것으로 기대합니다.
SKT AI Fellowship은 이렇게 AI가 더 넓은 영역에서 적용되고, 인간과의 협업 가능성을 높이는데 기여할 수 있는 프로젝트였다고 생각합니다.
이런 소중한 기회를 주신 분들께 감사드립니다.
또한 지난 6개월간 매주 미팅하며 성장할 수 있게 도와주시고, 좋은 인연을 쌓았던 멘토님들께도 정말 유의미하고 즐거운 시간이었다고 말씀드리고 싶습니다.
저는 앞으로도 AI, 특히 LLM분야에서 더 많은 가능성을 탐색하면서 AI 성장 과정을 함께할 수 있도록 노력하고 있겠습니다. 감사합니다.
참고문헌
Google Cloud, 2024, MLOps: Continuous delivery and automation pipelines in machine learning
kon7672 님의 최신 블로그
더보기-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구결과(3)
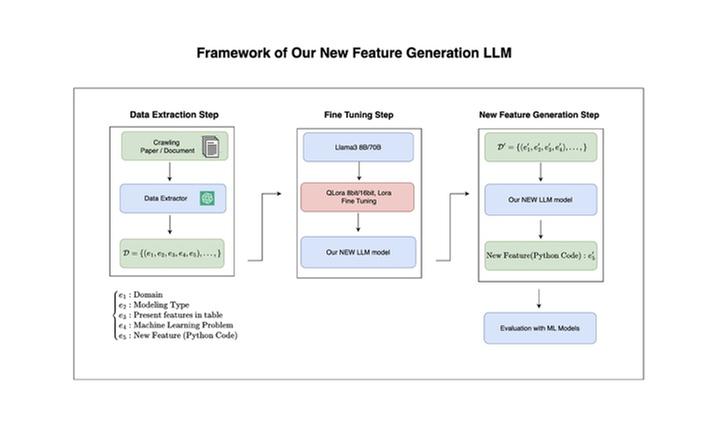
- 안녕하세요 😃 SKT AI Fellowship 6기 “AI 데이터분석가 도입을 통한 데이터 인텔리전스 실현” 과제를 수행한 고스체인 팀입니다. 지난 10월 31일 최종 발표를 마지막으로, 약 6개월간의 펠로우쉽 과제 수행을 마무리하였습니다. 펠로우 자격으로 데브오션에 글을 쓰는 마지막 시간이 되었습니다. 이번 글에선 저희 팀이 수행한 과제가 무엇인지, 어떠한 새로운 AI 기술을 만들었는지를 말씀드리고 그 결과와 기술 활용 사례를 공유드리려 합니다. 다만, 현재 글을 처음 게시하는 시점에서는 특허 출원과 논문 심사가 진행 중인 상황이라, 당장 현 시점에서 기술적 개발 부분, 성능 결과 관련한 내용들을 담아내지 못하게 된 점을 미리 양해의 말씀을 드리고자 합니다. ...
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구과정(2)
- 안녕하세요 😃 AI Fellowship 6기의 “AI 데이터분석가 도입을 통한 데이터 인텔리젼스 실현” 과제를 수행하고 있는 고스체인 팀입니다. 과제를 시작한 지 엊그제 같은데, 벌써 지난 주에 과제 진행에 대한 중간 발표까지 이루어졌습니다. 발표를 기점으로, 지금까지 진행한 내용들을 정리하고 피드백을 기반으로 향후 과제를 발전시킬 수 있는 기회를 가질 수 있었습니다. 이번 글에서는 저희가 중간 발표에서 진행했던 내용에 대해 소개드리고, 그에 대한 피드백과 향후 계획을 얘기하려 합니다. 1. 중간 발표 과제 소개 지난 글에서 소개하였듯, 저희 과제의 목표는 LLM을 이용해 데이터 분석을 자동화하는 기술을 만드는 것입니다. 데이터 분석 프로세스에서 LLM을 통해 ...
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구계획(1)
- 안녕하세요! 이렇게 DEVOCEAN을 통해 인사드릴 수 있게 되어 너무나 영광입니다. 저희는 SKT AI Fellowship 6기에서 AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 과제를 맡게 된 고스체인 팀 고정현, 박경윤, 이동훈입니다. 앞으로 5개월 간 펠로우십의 여정을 Devocean에 기록하게 되었습니다. 잘 부탁드립니다 (야호) 😊 1. Prologue LLM과 같은 생성형 AI와 블록체인에 기반한 web 3.0 패러다임이 퍼지고 있는 시기입니다. 이렇게 빠르게 변화하는 상황 속에서 데이터 분석 역시 근본적인 변화가 일어날 것으로 예상되고, 이에 발빠르게 대응할 필요가 커지고 있습니다. 더불어 생성형 AI를 데이터 분석과 결합하게 되...
DEVOTEE 추천 블로그
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구계획(1)
- 안녕하세요! 이렇게 DEVOCEAN을 통해 인사드릴 수 있게 되어 너무나 영광입니다. 저희는 SKT AI Fellowship 6기에서 AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 과제를 맡게 된 고스체인 팀 고정현, 박경윤, 이동훈입니다. 앞으로 5개월 간 펠로우십의 여정을 Devocean에 기록하게 되었습니다. 잘 부탁드립니다 (야호) 😊 1. Prologue LLM과 같은 생성형 AI와 블록체인에 기반한 web 3.0 패러다임이 퍼지고 있는 시기입니다. 이렇게 빠르게 변화하는 상황 속에서 데이터 분석 역시 근본적인 변화가 일어날 것으로 예상되고, 이에 발빠르게 대응할 필요가 커지고 있습니다. 더불어 생성형 AI를 데이터 분석과 결합하게 되...
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구과정(2)
- 안녕하세요 😃 AI Fellowship 6기의 “AI 데이터분석가 도입을 통한 데이터 인텔리젼스 실현” 과제를 수행하고 있는 고스체인 팀입니다. 과제를 시작한 지 엊그제 같은데, 벌써 지난 주에 과제 진행에 대한 중간 발표까지 이루어졌습니다. 발표를 기점으로, 지금까지 진행한 내용들을 정리하고 피드백을 기반으로 향후 과제를 발전시킬 수 있는 기회를 가질 수 있었습니다. 이번 글에서는 저희가 중간 발표에서 진행했던 내용에 대해 소개드리고, 그에 대한 피드백과 향후 계획을 얘기하려 합니다. 1. 중간 발표 과제 소개 지난 글에서 소개하였듯, 저희 과제의 목표는 LLM을 이용해 데이터 분석을 자동화하는 기술을 만드는 것입니다. 데이터 분석 프로세스에서 LLM을 통해 ...
-
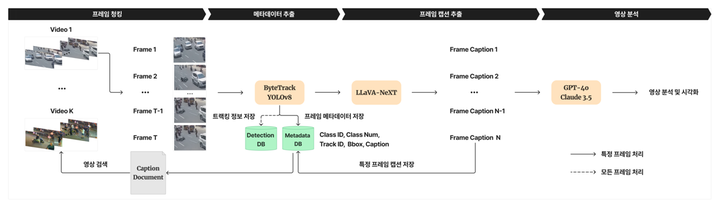
- 대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발 - 연구과정(2)
- 안녕하세요🤗 ~! SKT AI Fellowship 6기 '대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발' 연구를 수행중인 📺텔레토비전 팀📺 입니다 ~! 이번 글에서는 중간 발표까지 진행된 연구 내용과 멘토분들의 피드백을 반영한 향후 계획을 말씀드리고자 합니다. 1. 연구 목표 및 아이디어 💡 연구 배경 및 필요성 기존의 AI를 활용한 지능형 관제 시스템은 사전에 정의된 이벤트만을 탐지하고 분석할 수 있기 때문에 다양한 사용자의 요구를 충족하기 어려움이 있습니다. 관제 시스템 UI는 현재 대부분의 업체가 거의 동일한 형식을 사용하고 있으며, 이는 Open Set 검색 및 분석이 불가능한 한계점을 가지고 있는데요. 본 연구는 대규모 Mul...
-
- IA팀: LLM 기반 데이터 리니지 활용 Impact Analysis 대화형 에이전트 기술 개발 - 연구계획 (1)
- 안녕하세요! 👋 저희는 SKT AI Fellowship 7기에서 "LLM 기반 데이터 리니지 활용 Impact Analysis 대화형 에이전트 기술 개발" 과제를 수행하고 있는 IA 팀입니다! IA는 Impact Analysis의 머릿글자를 따서 지은 이름이에요. 이름처럼 인사이트풀한 문제를 분석하고 풀어내서 영향력 있는 팀이 되겠다는 포부를 담고 있습니다! 다음으로 본격적인 연구 과제를 소개하고 저희 팀이 그 과제를 어떻게 풀어나가려고 하는지에 대해서 자세히 적어보겠습니다. 1. 연구 과제 소개 🔎 연구 배경 및 필요성 현대의 데이터 플랫폼에서는 테이블 컬럼 하나만 바꿔도 대시보드가 깨지고, 모델이 실패하고, 그 책임은 누군가에게 돌아갑니다. 실제로 테이블 ...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.