
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Virtual Try-On 기술 개발 - 연구결과(3)

- DEVOTEE 요약
- 루이VTON 팀은 복잡한 패턴의 의류를 자연스럽게 시착할 수 있는 Virtual Try-On 기술을 개발하기 위해 IDM-VTON 모델을 활용했습니다. 연구 과정에서 GarmentNet과 TryonNet을 보완하기 위해 Edge Filtering과 Tunnel Extraction 기법을 도입하여 의류의 디테일을 보존하는 데 주력했습니다. 최종적으로, 사용자 설문 평가를 통해 이 기술은 SK텔레콤의 에이닷 서비스에 상용화되었으며, 많은 사용자들이 이에 대한 긍정적인 의견을 보였습니다.
안녕하세요!!
SKT AI Fellowship 6기에서 Virtual Try-On 기술 개발 연구과제를 수행하고있는 루이VTON팀의 서채준입니다.
오늘은 저희의 지난 연구계획(1), 연구과정(2)에 이어 연구결과(3)라는 제목으로 최종 발표까지의 여정과 주요 결과에 대해서 말씀드리려 합니다.
메인 목표: 세부 디테일을 잘 살려낼 수 있는 Virtual Try-On 기술 개발 및 상용화
이전에 포스팅 했던 연구계획, 연구과정에서 저희 팀의 메인 목표는 다음과 같이 정하고 시작했었습니다.
"의류의 세부적인 디테일들을 살려 가상 시착할 수 있도록 하자"
Logo 보존
의류의 어려운 패턴 보존
자연스러운 가상 시착
목차
Introduction
Objectives & Related Work
Methodology
Experiments
Results
Contributions
Appendix
1. Introduction
**Virtual Try-ON(VTON)**이란 사용자와 의류 이미지를 통해 해당 옷을 입은 사용자 이미지를 생성해주는 기술입니다.
이때 입력 사용자 이미지인 차은우 배우가 입고 있는 민무늬 옷과 같이 패턴이 단조로운 경우 현존하는 VTON 모델들로도 충분히 커버가 가능합니다.
그래서 저희 과제에서는 입력 의류 이미지와 같이 비교적 패턴이 복잡한 옷들을 중점적으로 다루었습니다.
다음은 저희가 6월부터 10월까지 진행한 것들을 정리한 내용입니다.
6월
VTON 연구 동향 파악 및 레퍼런스 수집
메인 모델 선정 및 문제 정의
7월
골프 웨어 학습 데이터베이스 구축
문제 해결 방법 도출
8월
아이디어 한계 구조화 및 재정립
새로운 방법론 제시
9월
최종 아이디어 설계 및 실험
서비스 상용화 준비
10월
새로운 방법론 성능 평가 (설문 조사)
에이닷 미디어 서비스 사용 및 데모 출시
2. Objectives & Related Work
일반적으로 VTON에서 자연스러운 결과란 전반적인 옷의 형태 뿐만 아니라 주름이나 디테일 등이 잘 복원된 이미지를 의미합니다.
하지만 위 그림처럼 현재까지 개발된 기술들의 결과들은 옷의 로고 및 텍스처 무늬가 제대로 보존되지 않은 경우가 존재하며, 옷의 색감이나 패턴이 뭉개지는 경우가 발생합니다.
또한, 옷의 형태가 잘 보존되지 않은 경우 역시 존재합니다.
지금까지 대부분의 VTON 모델들은 옷의 디테일을 보존하는 데에 집중하기보다 인물의 포즈에 맞게 옷을 왜곡하여 시착을 수행하는 것을 목표로 하였습니다.
결과적으로 인물의 체형이나 포즈, 각도에 맞게 옷을 자연스럽게 왜곡하여 생성하는 능력은 발전하였으나, 옷의 지역적인 특징들은 잘 보존되지 않음을 확인할 수 있습니다.
2-1. 루이VTON팀이 선정한 모델
IDM-VTON Architecture
해당 모델은 저희가 이번 과제에서 선정한 모델입니다.
앞서 보여드렸던 기존의 VTON 기술들과 달리 의류에 대한 캡션을 통해 GarmentNet과 TryonNet의 디테일 보존 능력을 향상시켰다는 특징이 존재합니다.
또한 IP-Adapter(Image Prompt Adapter)를 추가하여 의류 이미지의 전반적인 특징을 잘 보존하도록 하였습니다.
이와 같이 기존 VTON 기술들에 비해 의류의 디테일이 향상된 모습을 보였다는 점에서 IDM-VTON 모델을 선정하였습니다.
GarmentNet
IDM-VTON 모댈의 GarmentNet의 경우 의류 이미지를 인코딩하여 메인 모델인 TryonNet에 전달하는 역할을 수행합니다.
또한 의류의 high-level semantic 정보에 집중하여 학습한다는 특징이 존재합니다.
저희 팀은 GarmentNet의 high-level 의류 정보의 학습 능력을 향상시키고자 Edge Filtering 방법론은 제안하였습니다.
자세한 내용은 3절에서 설명드리도록 하겠습니다.
TryonNet
TryonNet의 경우 신체 포즈를 반영하여 의류와 신체의 변형을 조정하는 역할을 가집니다.
해당 브랜치의 경우 저수준 특징 정보에 집중하여 학습한다는 특징이 존재합니다.
저희 팀은 TryonNet의 저수준 특징 정보의 집중을 보다 더 향상시키고자 Tunnel Extraction 기법을 추가하여 학습하였습니다.
이에 대한 내용 역시 3절에서 자세하게 말씀드리도록 하겠습니다.
IP-Adapter
IP-Adapter는 Image-Prompt Adapter의 약자로 옷의 이미지와 프롬프트에 대한 정보를 TryonNet에 전달합니다.
옷의 전체적인 형태 정보를 프롬프트로 구조화하여 전달함으로써 옷의 종류 및 소매 길이와 같은 전체적인 특징을 보존하는 데에 도움을 줍니다.
2-2. IDM-VTON(base) 실험 결과
IDM-VTON 모델의 결과 입니다.
의류의 전반적인 형태는 보존되고 있으나, 무늬들이 뭉개지며 세부적인 디테일들이 잘 보존되지 않는 것을 볼 수 있습니다.
또한, 존재하지 않아야 하는 부분에 잘못 생성되기도 합니다.
이러한 한계점들을 개선하기 위해, 의류 디테일 보존 능력을 향상시키고자 IDM-VTON 모델의 GarmentNet과 TryonNet을 보완하기 위한 새로운 아이디어가 필요했습니다.
3. Methodology
3-1. Edge Filtering
그 중 첫번째로 말씀드릴 것은 GarmentNet을 보완하기 위한 Edge Filtering 입니다.
IDM-VTON 모델 결과들의 경우, 로고 및 무늬들의 위치, 모양들을 보존하는 데에 전반적으로 성능이 떨어지는 것을 확인할 수 있었습니다.
의류의 전반적인 디테일 즉, 고수준의 정보를 추출하기 위해 Sobel Filter를 사용하여 의류 이미지의 엣지 정보를 추출하였습니다.
그 후, GarmentNet의 입력에 concat하여 의류의 인코딩 능력을 강화하도록 하였습니다.
3-2. Tunnel Extraction
두번째는 Tunnel Extraction 기법을 사용하여 TryonNet이 의류의 디테일을 더 잘 학습할 수 있도록 하였습니다.
DWPose를 이용해 신체의 Keypoints 좌표값들을 추출하고 해당 좌표들을 이용해서 적절한 Minimum Boundary Box를 형성하여 Zoom하는 방식입니다.
이를 통해, TryonNet이 학습할 때 사용자의 옷 영역을 표현하기 위한 픽셀 개수를 증가시켜 기존보다 저수준의 디테일한 특징들을 보존할 수 있도록 학습할 수 있었습니다.
다만, 기존 Tunnel Extraction 기법에서는 얼굴을 포함한 상반신 전체를 포커스 영역으로 설정했지만,
추론 시 얼굴이 왜곡되던 문제 때문에, 저희는 얼굴을 제외한 영역만 확대하여, 의류의 세부 디테일을 강조하도록 하였습니다.
이렇게 함으로써 제한된 해상도에서도 옷과 신체의 질감과 디테일을 보다 더 확보된 상태에서 학습할 수 있었습니다.
4. Experiments
Dataset: VITON-HD
GPUs: NVIDIA A100 80GB x 4
DeepSpeed ZeRO-3 + CPU offload
AdamW Optimizer
Learning rate: 1e-6
100 epoch (각각 대략 5일 소요)
Guidance scale: 2.5
5. Results
중점적으로 비교할 모델 버전은 크게 3가지입니다.
IDM-VTON (base)
IDM-VTON (w/ Filtering)
IDM-VTON (w/ Filtering & Tunnel)
결과를 보시다시피 Filtering만을 사용하였을 때 부족하였던 의류의 무늬와 같은 특징 보존도가 크게 향상되는 것을 확인할 수 있습니다.
6. Contributions
저희 팀의 최종 목표는 연구기간 동안 개발한 기술을 활용하여 SK텔레콤의 에이닷 서비스로 상용화하는 것입니다.
그 전에, 저희 과제의 목표를 상용화에 두었기 때문에 정량적 평가보다는 실제 유저들의 정성적 평가가 더 중요하다고 판단하였습니다.
이를 위해 약 40명의 사람들에게 구글폼을 이용하여 설문조사를 진행하였습니다.
우선 모델의 입력 이미지인 사용자 이미지와 의류 이미지를 보여주었습니다.
해당 이미지들을 각각 비교하였을 때 얼마나 자연스러운지 1~10점을 평가하도록 진행하였습니다.
그 후, 간략한 소감 및 피드백을 수집하였으며, 실제로 해당 기술을 적용한 서비스를 에이닷 내에 상용화 하였을 때 얼마나 자주 사용할 것인지에 대해 조사를 추가로 진행하였습니다.
설문조사 결과
마지막으로, 저희가 개발한 VTON 기술을 직접 이용해볼 수 있는 Demo 사이트까지 보여준 뒤 사용자들에게 피드백을 수집하였습니다.
대부분 Filtering과 Tunnel Extraction 기법이 모두 적용된 (C)의 결과가 가장 자연스럽다는 의견이 많았으며, 실제로 상용화가 되었을 때, 참고용으로 사용해보고 싶다는 의견이 65%%로 가장 많았습니다.
상용화
촤근에는 실제로 저희 기술이 에이닷에 상용화가 되었습니다.
에이닷 어플을 설치하신 후, 미디어 에이전트 -> 스포츠 -> 골프 -> AI룩북을 확인하실 수 있습니다.
10월 넷째주에 나온 따끈따끈한 신상이니 한번씩 봐주시면 감사하겠습니다!
사용자들은 실제로 선수들이 옷을 입었을 때의 모습을 보고 옷을 구입하기 위해 하단의 옷의 정보를 확인할 수 있습니다.
지금까지 SKT Fellowship 6기 Virtual Try-On 기술 개발 연구 과제를 수행했던 루이VTON이었습니다.
(황문경 멘토님, 정지연 멘토님을 비롯한 모든 관계자분들께) 감사드립니다.
7. Appendix
Benchmarking resullts (VITON-HD testset)
ghskfen06 님의 최신 블로그
더보기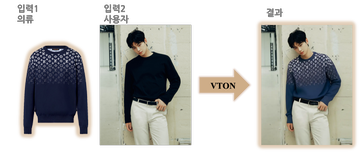
DEVOTEE 추천 블로그
-

- 서비스 로봇용 신규 Vision AI 응용 기술 개발 - 연구 결과(3)
- 안녕하세요 SKT AI Fellowship 3기 1번 과제 서비스 로봇용 신규 Vision AI 응용 기술 개발을 연구하고 있는 신서유기입니다. 어느덧 연구를 시작한지 5개월이 지났고, 연구 내용들에 대해 전달해드리려고 합니다. 연구계획(1) 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163228 연구계획(2) 블로그 참조 : https://devocean.sk.com/search/techBoardDetail.do?ID=163336 먼저 저희는 저희가 개발한 로봇 AI 비전 애플리케이션 과제에 제목과 맞게, 로봇에 탑재되는 PC에 딥러닝 기반의 여러 기능등을 탑재하여 Coex에서 열린 SKT 부스...
-
- Virtual Try-On 기술 개발 - 연구계획(1)
- 안녕하세요! 만나서 반갑습니다:D SKT AI Fellowsihp 6기 Virtual Try-On 기술개발 연구를 맡은 팀 루이VTON✨입니다. 저희 팀은 서채준, 이민우, 조성민 으로 구성되어있으며 앞으로 Virtual Try-On 기술을 개발하고 상용화 할 수 있도록 열정을 불태울 것입니다. 저는 루이VTON의 앞으로의 활동기록을 DEVOCEAN inside에 올리게 된 이민우 라고 합니다.😉 그럼 이어서 저희 팀명에 대해서 소개해드리겠습니다😊 0. 팀명 소개 - "루이VTON" 명품 하면 떠오르는 네 글자..✨ 루이비똥 네 맞습니다. 팀 "루이VTON" 은 LOUIS VUITTON(명품 브랜드) + VTON(Virtual Try-ON) 을 결합하여 명품 ...
-
- Virtual Try-On 기술 개발 - 연구과정(2)
- 안녕하세요!! SKT AI Fellowship 6기에서 Virtual Try-On 기술 개발연구과제를 수행하고있는 루이VTON팀의 이민우입니다. 오늘은 저희 연구의 시작을 알렸던 지난 연구계획(1) 포스팅에 이어서 연구과정(2)라는 제목으로 중간 발표까지의 여정과 결과에 대해서 말씀드리려 합니다. 저희의 변하지 않는 목표는 다음과 같습니다. 메인 목표: 명품 Virtual Try-On 기술 상용화 이전 연구계획(1) 포스팅에서는 메인 목표인 Virtual Try-On 기술 상용화를 이루기 위한 세부 목표는 다음과 같이 정하고 시작하였습니다. 지난 포스팅 세부 목표 Logo 보존 자연스러운 Pose based model 구축 Fine-tuning 다양한 backbo...
-
- 스마트폰 센서 활용 PDR 모델 연구 - 연구 결과(3)
- 안녕하세요! SKT AI Fellowship 6기 슼폰지 팀입니다. 저희는 스마트폰 센서를 활용한 보행자 위치 추정(PDR: Pedestrian Dead Reckoning) AI 모델 개발을 주제로 약 5개월간 연구를 진행했습니다. 이전 포스팅에서 (1)연구 소개 (2)연구과정을 공유했는데요, 마지막 포스팅인 만큼 이번에는 저희 연구를 간략하게 다시 소개드리고, 최종 수행 과정과 결과를 공유하겠습니다. 연구 소개 현대 사회에서 위치 기반 애플리케이션은 우리의 일상생활에 깊숙히 자리 잡고 있습니다. 길찾기 앱부터 자전거 공유 서비스, 운동 기록 앱, 그리고 위치 기반 게임까지 GPS를 활용한 실시간 위치 추적 기술은 다양한 분야에서 사용되고 있습니다. 이러한 기술은...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.