
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
B-7 Multimodal 정신 건강 인식 프로젝트 - 연구과정(2)
- DEVOTEE 요약
- SKT AI Fellowship 6기 B-7 emo카세 팀은 멀티모달 데이터 기반 우울증 예측 모델을 연구 중입니다. 팀은 음성 및 텍스트 데이터를 활용해 감정 예측, 우울증 진단, 심리 상담 챗봇을 개발하며, 현재 감정 모델 성능 개선과 함께 최종 목표를 위한 연구를 계속할 계획입니다. 앞으로 감정 강도를 반영한 모델 개발과 데이터 부족 상황에서의 우울증 진단 모델의 고도화에 집중할 예정입니다.
안녕하세요! SKT AI Fellowship 6기에서 Multimodal 정신 건강 인식 프로젝트 과제를 수행하고 있는 B-7 emo카세 팀입니다.
저희 팀은 우울 증상 및 우울증 예측을 위한 Pretraining-Finetuning Framework을 목표로 연구를 진행하고 있습니다.
이번 포스트에서는 현재까지 진행한 연구 진행 결과에 대한 중간 발표 내용과 멘토분들의 피드백을 반영한 앞으로의 향후 계획에 대해 이야기해보고자 합니다.
목차
예상 데모 시나리오
Main Objectives
Cross-Modal
Emotion Label
Depression Detection
향후 계획
1. 예상 데모 시나리오
저희는 멀티모달 건강 인식 프로젝트로 대화 상황을 가정하여 3가지 task를 수행하는 것을 목표로 두고 있으며,
이 때 대화 속에 내제된 두 가지 모달인 **‘음성’**과 ‘텍스트’ 데이터를 활용하고자 합니다.
멀티모달 데이터에 기반한 감정 상태 예측 모델을 개발
학습된 감정 예측 모델에 기반한 우울 진단 모델을 개발
우울 진단 결과를 반영한 심리 상담 챗봇을 개발하려고 합니다.
구체적인 데모 시나리오로는, 사용자의 speech를 인풋으로 받아 STT (speech to text)를 통해 text를 추출합니다.
그 후, speech에 내제된 audio와 text 두 가지 모달의 데이터를 기반으로 감정 예측 및 우울진단 태스크를 수행합니다.
이 때, 우울 진단 태스크는 더욱 정밀한 진단과 설명 가능성을 제공하기 위해
2 step:
1. 우울증 증상 예측
2.우울 진단으로 이루어집니다.
그리고, 심리 상담 챗봇을 구현할 때, 우울 진단 모델에서 앞서 도출한 우울 증상을 반영하여 더욱 정밀한 답변을 생성할 수 있도록 하는 것을 최종 목표로 두고 있습니다.
2. Main Objectives
저희 팀은 최종 데모 시나리오를 달성하기 위해, 큰 프레임워크 내에서 총 3가지 포인트를 중점적으로 고려해봤습니다.
우선, multi-modal 데이터를 잘 반영하기 위해 음성과 텍스트 사이에 존재하는 modality gap을 해소하고
서로 다른 modality를 효과적으로 통합할 수 있는 cross-modal model을 개발하고자 합니다.
둘째로는, 감정 Label에 대한 인지심리학적 접근을 통한 emotion label의 재해석을 시도하였습니다.
이는, 인간의 감정은 이산적이지 않고 복합적인 요소가 작용한다는 점을 기반으로 감정 사이에 존재하는 내제된 특성을 반영하여 감정 인식 모델 학습을 진행하고자 하는 방식입니다.
마지막으로, 우울에 있어 인간의 감정 상태가 많은 영향을 준다는 점을 기반으로
저희의 emotion model을 pretrain model 삼아, 우울 진단 task에 finetuning 하는 방식을 고려하였습니다.
2.1 Cross-Modal
우선 modality gap을 해소하기 위한 cross-modal 모델의 관점에서, 기존 연구들에 대한 소개를 먼저 하겠습니다.
기존 연구들은 두 모달리티를 각각의 인코더로 처리한 이후, cross-modality encoder에서 서로 다른 modal의 정보를 통합하여 output을 출력하도록 합니다.
기존 연구들은 대칭적인 cross-attention 구조를 활용하는데, Query 음성 에 대해 텍스트의 정보를 key value로,
반대로 Query 텍스트에 대해서는 음성 정보를 key value로 활용하며 서로 다른 모달리티의 정보를 반영합니다.
이런 대칭적인 cross-attention 구조는 두가지 모달을 동일선상에서 바라봅니다.
하지만, 텍스트에는 감정예측/우울 진단에 있어 중요한 context를 파악할 수 있으며
음성 데이터에서는 텍스트에서는 드러나지 않는 감정 상태가 나타난다는 점에서 단순히 이 둘을 동일선상에서 바라보는 것이 아닌
각 모달이 내제하는 “정보의 차이”를 고려한 cross-attention 구조를 설계하는 것이 필요하다고 보았습니다.
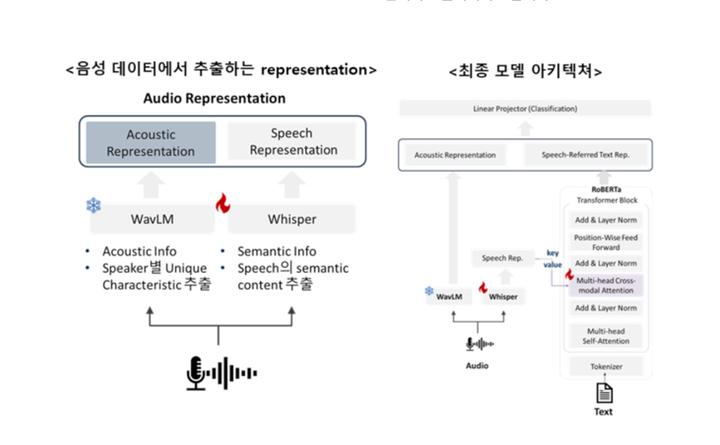
이를 위해 저희는 audio를 reference로 활용한 text representation을 추출한 후 이에 기반한 prediction을 도출하고자 했습니다.
우선 각각의 모달 audio와 text에 대해서 feature representation을 추출하기 위해
large dataset으로 학습된 pretrained model Whisper의 Encoder와 RoBERTa를 활용하여 audio와 text의 representation을 일차적으로 추출합니다.
그리고, 감정 인식과 우울 진단 task에서는 context정보를 잘 파악하는 것이 중요하기 때문에 text 정보를 main stream으로 두고,
text에서는 포착되지 않고 audio에서는 포착되는 감정 상태에 따른 발화 표현을 reference 삼아 활용하였습니다.
이러한 **‘Audio-referred text representation’**은 효율적인 맥락 정보에 대한 이해와 음성에 담긴 감정 상태를 적절히 반영할 수 있다는 점에서 착안하였습니다.
예를 들어, 어떤 소식에 대한 답변으로 “정말? 그게 사실이야?” 라는 대목이 text는 동일하지만 audio에서는 화난, 슬픈, 그리고 기쁜 상태에 따라 음성 톤이 다를 것이기 때문에
이를 text context 파악에 추가 정보로 넣어주는 것입니다.
이를 구현하기 위해서, text modal 내부의 self attention layer를 Cross-modal Attention Layer로 대체하고 text 정보를 query로 audio 정보를 key,value로 활용하여 attention을 수행하였습니다.
이는 기존의 대칭적인 방식과 비교하여 attention을 한번만 수행한다는 점에서 효율적이기도 합니다.
이에 추가적으로, 더욱 generalizable한 모델을 구축하기 위해 speaker 정보를 모델의 추가 인풋으로 활용합니다.
모든 화자가 개별적인 특성을 지니며, 발화 방식이 다르기 때문에 이를 모델의 인풋에 활용하는 것이 일반화 관점에서 강점을 보일 수 있기 때문입니다.
기존 연구들은 speaker 정보로 speaker id embedding을 활용하지만, 이는 train set에 등장한 speaker에 대한 정보만 반영할 수 있기에 일반화 관점에서 한계가 존재합니다.
따라서, 저희는 WavLM이라는 음성 처리 모델을 통해 추출한 acoustic representation을 speaker 정보로 활용하였습니다.
Acoustic Feature를 추출하고자 활용하는 Whisper는 semantic 정보를 추출하는 데 특화됐다면 wavlm은 speaker별 unique한 특징을 추출하는데 유용한 모델로,
사람마다 지니는 다른 발화 특징을 통해 speaker와 관련된 feature 정보를 반영할 수 있습니다.
이에 기반한 최종 모델 아키텍쳐 구조는, 'Audio-referred text representation’에 acoustic representation이 concat되어 linear projector에 들어가게 됩니다.
각 modality별 encoder로 활용되는 whisper와 roberta는 모델 파라미터 사이즈별로 다양한 모델이 존재합니다.
저희는 각 모델의 output feature dimension size를 기준으로 두 가지 후보를 선정하였습니다.
다만 이 때, 모델 전체를 finetuning하는 것은 메모리 측면과 학습 시간 측면에서의 비효율적인 문제가 존재하기 때문에,
모델 전체가 아닌 일부 가중치만 미세조정하는 Parameter-Efficient Finetuning (PEFT) 기법을 적용하였습니다.
총 4가지 PEFT 기법을 적용하였으며, 상세 내용은 아래 그림과 같습니다. PEFT 기법별로 아키텍쳐 내부에 각각 적용됩니다.
저희가 개발한 모델의 성능을 확인하고자 두 가지 감정 인식 벤치마크 데이터셋인 IEMOCAP과 MELD를 활용하였습니다.
각 단일 모델에 대한 iemocap (6-class)에서의 감정 인식 결과를 평가하기 위해, 각 모델별로 뽑은 feature 뒤에 2개의 classification layer를 추가하여 비교하였습니다.
오디오에서는 Dense layer에만 LoRA를 것이, 텍스트에서는 LoRA를 RoBERTa-Large 모델의 Key, Query, Value Weight Matrix에만 적용했을 떄가 가장 높은 성능을 보였습니다.
두 모달 모두에서 parameter 수는 pre-train 모델 대비 극히 일부만 활용하면서 미세조정을 하지 않는
FROZEN된 방식에 비해 약 10% 가량의 큰 성능향상 폭을 보이며 PEFT 기법의 유효성을 확인할 수 있었습니다.
다음으로, 멀티 모달 성능을 평가하기 위해 1) 두 모달을 단순 concatenation한 것과 2) cross attention에 기반한 모델을 비교한 결과는 아래와 같습니다.
두 모달을 concat 했을 때가 단일 모달에 비해 성능 향상을 보이며, 이는 멀티 모달리티를 반영 하는 것이 단일 모달만 활용하는 것보다 성능 향상에 도움이 되는 것을 확인할 수 있습니다.
그러나, 저희의 제안 부분인 cross attention 실험 성능에서는, 현재로써는 단일모달 성능에 미치지 못하는 상황으로 최종 결과 도출 전까지 개선해야 하는 부분에 해당합니다.
이 부분에 대해서는 cross attention을 수행하기 이전에 추가적인 attention이나 convolution 연산이 수행되지 않고,
raw feature를 바로 받아 cross attn으르 수행하게 됨에 따라 feature 추출이 정확하게 되지 않았다는 점으로 보아 이 부분을 개선해보고자 합니다.
2.2.감정 분류의 인지심리학적 접근
다음으로, 감정 분류에 있어 인지심리학적 접근을 시도한 내용입니다.
아래 사진은 인지심리학자 Robert Plutchik이 제안한 감정 모델로, 감정별로 지니는 의미적 유사도에 따라 각 감정이 wheel (바퀴)에 표현이 됩니다.
해당 모델의 특징으로는 유사한 감정은 덜 유사한 감정보다 가깝게 정의되고, 반대의 감정은 반대 방향에 위치합니다.
예를 들어, Joy와 Trust는 인접하게 위치한 반면 Joy와 Sad는 반대 위치에 위치하게 됩니다.
이에 따르면, 인지심리학적 관점에서 우리 인간의 감정은 이산적이지 않고, continuous한 복합적인 요소가 존재함을 알 수 있습니다.
다만, 인공지능 모델에서의 감정 분류 Task는 이를 단순한 classification task로 바라보고 Cross Entropy Loss에 기반합니다.
그러나 일반적인Cross Entropy Loss는 감정 예측의 오류에 대해 반대 감정에 대한 error와 유사한 감정에 대한 error를 동일시하게 측정합니다.
이는 결국 각 감정 class를 이산적으로 바라보게 되며, 실제 인간의 감정 체계와는 상이한 부분이 존재하게 되어, 저희는 인간의 감정에 내재된 특성을 반영한 학습 기법을 적용해보았습니다.
이를 구현하기 위해 저희는 Emotion Label을 Plutchik wheel에 매핑 반지름이 1인 원에 대해 각 label별로 (0,0), (1,0) 등의 좌표를 지정하고
각 감정 좌표 사이의 거리로 Emotion Recognition Loss을 설정해서 반대감정에 대한 Loss가 유사한 감정에 대한 loss보다 크게 하면서 인간 감정 체계를 반영할 수 있도록 하였습니다.
모델 학습 시에는 저희가 제안한 Emotion Recognition Loss를 일반적인 Cross Entropy Loss에 더해주어 학습을 진행하였습니다.
실험 결과로 저희가 Cross modal model은 안정화 작업중에 있어 사전 연구 중 하나인 CORECT에 대해 일반적인 Cross Entropy Loss만 있는 것과
저희가 제안한 Plutchik 기반의 Emotion Recognition Loss를 더한 것을 비교하였습니다.
해당 결과로, 단순 Cross Entropy Loss만 사용하는 것보다 Emotion Label을 활용하는 것이 더 우수한 성능을 보이며 인간 감정 체계를 모델에 반영하는 것이 학습에 도움이 되는 것을 확인할 수 있었습니다.
Cross-Modal Model에서의 안정적인 성능 확보 이후에 Emotion Label을 추가하여 다양한 파라미터 상황에서의 실험 성능을 비교하여 최종 모델을 선정하고자 합니다.
2.3.우울증 진단 모델
마지막으로는 저희의 최종 task와 관련된 우울 진단 모델로, 감정 예측 모델을 Pretrain 모델로 활용하여 이를 우울증 진단 task에 finetuning하여 활용하고자 합니다.
이 때 우울진단의 지표로 활용되는 9가지 지표에 대한 예측을 수행하고 그 뒤에, 우울진단을 진행합니다.
모델 학습 이후에는 Text에 SHAP을 활용해서 인풋 단어별 예측에 많은 영향을 준 단어를 보여주고 우울 증상별로 우울 진단에 미치는 영향력을 측정하여 진단에 대한 근거를 제시하고자 합니다.
해당 부분에 대한 이야기는 최종 결과와 함께 보여드리도록 하겠습니다.
3. 향후 계획
중간 발표를 진행하면서 멘토님들의 피드백 덕분에 앞으로 진행할 방향에 대한 계획을 수립해보았습니다.
우선, 현재까지 개발한 감정 모델에 대한 성능 개선과 함께 최종 task인 우울증 진단과 챗봇 개발에 중점을 두고 진행해보고자 합니다.
감정 모델에서 받은 피드백으로, 감정의 강도를 활용하는 방법에 대한 인사이트를 얻을 수 있었습니다.
저희가 활용하는 감정 데이터셋에는 감정 강도에 대한 label이 없어,
이를 활용하지 못하는 것에 대한 아쉬움과 대안 방안에 대해 고민을 하는 중이었는데 좋은 아이디어를 주셔서 정말 감사했습니다.
이를 반영한 감정 모델 개발에 대해 고민해보고자 합니다.
우울 진단과 관련해서는, 기존 병원에서 활용하는 우울증 진단은 단순한 자가진단 테스트에 기반하는데,
이에 비교하여 저희 모델이 더욱 정교하고 신뢰할 만한 결과를 도출할 수 있어야 할 것 같습니다.
다만, 우울증 진단은 데이터셋 자체가 많이 부족한 상황으로, 데이터가 적은 상황에서도 유의미한 모델 개발에 힘써야 할 것으로 보입니다.
현재까지 약 2달 가량의 기간동안은 성능 개선에 집중이 많이 되어 있었는데,
최종 발표까지 시간이 얼마 남지 않은만큼 남은 기간동안은 전체적인 시스템을 먼저 구축하고, 남은 시간을 활용해서 성능 고도화를 진행해보기로 하였습니다!
멀티모달 데이터를 활용한 정신질환 진단이 사회적으로도 큰 가치를 가지는 부분인만큼, 앞으로도 마지막까지 좋은 결과를 달성할 수 있도록 더 노력해보겠습니다!
많은 피드백 주신 멘토님들께 진심으로 감사의 말씀을 전하며 포스팅을 마칩니다:)
emilyseong 님의 최신 블로그
더보기-
- B-7 Multimodal 정신 건강 인식 프로젝트 - 연구과정(2)
- 안녕하세요! SKT AI Fellowship 6기에서 Multimodal 정신 건강 인식 프로젝트 과제를 수행하고 있는 B-7 emo카세 팀입니다. 저희 팀은 우울 증상 및 우울증 예측을 위한 Pretraining-Finetuning Framework을 목표로 연구를 진행하고 있습니다. 이번 포스트에서는 현재까지 진행한 연구 진행 결과에 대한 중간 발표 내용과 멘토분들의 피드백을 반영한 앞으로의 향후 계획에 대해 이야기해보고자 합니다. 목차 예상 데모 시나리오 Main Objectives Cross-Modal Emotion Label Depression Detection 향후 계획 1. 예상 데모 시나리오 저희는 멀티모달 건강 인식 프로젝트로 대화 상황을 가정하여...
-
- Multimodal 정신 건강 인식 프로젝트 - 연구계획(1)
- 안녕하세요! SKT AI Fellowship 6기에서 Multimodal 정신 건강 인식 프로젝트 과제를 수행하게 된 B-7 emo카세 팀입니다. 저희 팀은 우울 증상 및 우울증 예측을 위한 Pretraining-Finetuning Framework을 목표로 연구를 진행하고 있습니다. 첫 포스트에서는 Fellowship 기간동안 수행하게 될 연구의 계획과 최종 예상 결과물을 소개해 드리도록 하겠습니다. 〈목차〉 정신 건강 인식이란? 연구 배경 연구 최종 목표 연구 내용 제안 모델 데이터셋 예상 결과물 Project Plan & Team Introduction 1. 정신 건강 인식이란? 저희 팀은 현대사회에서 중요한 문제로 자리 잡고 있는 정신 건강, Mental ...
DEVOTEE 추천 블로그
-
- 멀티 턴 대화 토픽 추출 - 연구과정(2)
- 안녕하세요! 저희는 SKT AI Fellowship 5기 07번 과제를 맡게 된 ‘자연어쩔티비내리는호남선’ 팀 입니다 😁 이번 포스트에서는 8월 24일 진행되었던 중간발표 세션에서 발표했던 저희 팀의 연구 주제와 진행 상황에 대해 설명드리겠습니다! 1. 연구 배경 및 목적 문서에서 주제를 추출하는 과제는 중요하지만 주제의 변화를 추적하는 시도는 이제껏 시도된 적이 없었습니다. 예를 들어, 하나의 세션에서 LLM기반 인공지능과 대화할 때 첫 대화에 대한 주제만 반영되는 한계가 존재하고, 신문기사에서는 문단에 따라 논지가 바뀌는 경우가 생기며, 온라인 게시판은 한 게시판에 여러 주제의 게시글이 올라오는 경우가 대부분입니다. 이에, 저희는 LLM기반 인공지능 대화 주...
-
- AI 활용 5G 음성 통화 서비스 검증 자동화 - 연구계획(1)
- 안녕하세요! SKT Fellowship 6기에서 'AI 활용 5G 음성 통화 서비스 검증 자동화’ 과제를 진행하게 된 팀 sk삭임 입니다. 저희의 팀명은 통화 서비스의 검증 자동화를 통한, 사람과 사람을 잇는 통화 음성의 속삭임을 의미하기도 하고, SKT 프로젝트에 참여하면서 만들어 나갈 수많은 사람들과의 사귐도 이루겠다는 팀의 목표를 담고 있습니다. 이 포스트에서는 저희의 전반적인 연구계획과 태스크의 진행 방향을 소개해 드리겠습니다. 과제 추진 배경 통화 중 음질이 저하되거나, 연결이 끊겼던 경험이 있으신가요? 해당 문제들이 발생했을때 사용자들의 불만족이 증가하고, 사용자들은 소통의 오류를 경험했다고 합니다. 또한 HD Voice는 LTE망을 사용하는데, 이때 ...
-
- Multimodal 정신 건강 인식 프로젝트 - 연구계획(1)
- 안녕하세요! SKT AI Fellowship 6기에서 Multimodal 정신 건강 인식 프로젝트 과제를 수행하게 된 B-7 emo카세 팀입니다. 저희 팀은 우울 증상 및 우울증 예측을 위한 Pretraining-Finetuning Framework을 목표로 연구를 진행하고 있습니다. 첫 포스트에서는 Fellowship 기간동안 수행하게 될 연구의 계획과 최종 예상 결과물을 소개해 드리도록 하겠습니다. 〈목차〉 정신 건강 인식이란? 연구 배경 연구 최종 목표 연구 내용 제안 모델 데이터셋 예상 결과물 Project Plan & Team Introduction 1. 정신 건강 인식이란? 저희 팀은 현대사회에서 중요한 문제로 자리 잡고 있는 정신 건강, Mental ...
-
- 대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발 - 연구과정(2)
- 안녕하세요🤗 ~! SKT AI Fellowship 6기 '대규모 Multimodal AI모델을 이용한 영상 검색 시스템 개발' 연구를 수행중인 📺텔레토비전 팀📺 입니다 ~! 이번 글에서는 중간 발표까지 진행된 연구 내용과 멘토분들의 피드백을 반영한 향후 계획을 말씀드리고자 합니다. 1. 연구 목표 및 아이디어 💡 연구 배경 및 필요성 기존의 AI를 활용한 지능형 관제 시스템은 사전에 정의된 이벤트만을 탐지하고 분석할 수 있기 때문에 다양한 사용자의 요구를 충족하기 어려움이 있습니다. 관제 시스템 UI는 현재 대부분의 업체가 거의 동일한 형식을 사용하고 있으며, 이는 Open Set 검색 및 분석이 불가능한 한계점을 가지고 있는데요. 본 연구는 대규모 Mul...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.