
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구과정(2)
- DEVOTEE 요약
- 안녕하세요! 저는 AI Fellowship 6기의 고스체인 팀입니다. 중간 발표에서 저희는 LLM을 이용해 데이터 분석을 자동화하는 기술을 소개하고, Text2SQL 모델과 Feature Generation LLM 모델을 통해 성능을 높이는 방법을 제시했습니다. 향후 계획은 모델 평가와 아키텍처 설계 개선을 통해 실무적 활용과 독창성을 높이는 것입니다.
안녕하세요 😃
AI Fellowship 6기의 “AI 데이터분석가 도입을 통한 데이터 인텔리젼스 실현” 과제를 수행하고 있는 고스체인 팀입니다.
과제를 시작한 지 엊그제 같은데, 벌써 지난 주에 과제 진행에 대한 중간 발표까지 이루어졌습니다.
발표를 기점으로, 지금까지 진행한 내용들을 정리하고 피드백을 기반으로 향후 과제를 발전시킬 수 있는 기회를 가질 수 있었습니다.
이번 글에서는 저희가 중간 발표에서 진행했던 내용에 대해 소개드리고, 그에 대한 피드백과 향후 계획을 얘기하려 합니다.
1. 중간 발표
과제 소개
지난 글에서 소개하였듯, 저희 과제의 목표는 LLM을 이용해 데이터 분석을 자동화하는 기술을 만드는 것입니다.
데이터 분석 프로세스에서 LLM을 통해 자동화를 할 수 있는 부분을 두 가지 짚어볼 수 있습니다.
첫째, 데이터 분석가가 요청하는 자연어 질의에 부합하는 SQL query문을 생성하는 Text2SQL 모델
둘째, 머신러닝 모델링을 하는 경우 모델의 성능을 높이기 위해 새로운 feature를 생성해주는 LLM 모델
데이터 분석가는 사용되는 사전 지식과, 개개인의 노하우를 바탕으로 추론을 통해 새로운 feature를 생성합니다.
LLM이라면 이런 능력을 모사할 포텐셜이 충분히 있다고 판단하여, 데이터 분석, 머신러닝 등 모델링과 관련있는 논문을 통해 LLM을 학습시켜 새로운 feature를 생성하도록 하였습니다.
text2sql
분석가가 요구하는 자연어 질의를 입력으로 주어지면, 이에 해당하는 sql query를 생성하도록 하기 위해 spider와 와 ai hub의 dataset을 이용하였습니다.
질의 데이터 중 난이도가 높은 6000여개의 데이터셋을 마련하였으며, 한국어로 된 자연어 질의는 gpt api를 통해 모두 영어로 번역하였습니다.
또한 기존 공개된 학습용 데이터셋은 LLM이 테이블 스키마를 선택하는 능력을 기르기에는 구조적으로 아쉬운 점이 있어,
입력 프롬프트에 주어지는 테이블 스키마를 다소 복잡한 형태가 되도록 학습 데이터를 증강하였습니다.
스파이더 데이터셋에는 테스트용 데이터셋도 별도 마련되어 있어 우선 100개의 질의에 대해 대답을 요청한 결과 대략 62%정도의 정답률을 확인할 수 있었습니다.
학습 데이터가 아직 수만개를 추가로 확보는 한 상태라 이들도 전처리 등 학습 데이터를 구축하기로 계획을 해 두고,
저희 팀은 일단은 바로 Feature Generation LLM을 만드는 것에 우선적으로 집중하였습니다.
<학습 데이터>
<모델 output>
Feature engineering LLM (FeG-LLM)
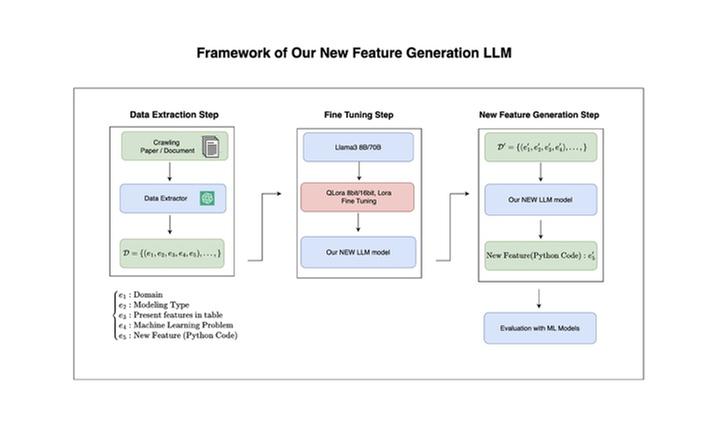
피쳐 생성을 자동화하는 전체 프로세스를 3단계로 구분하였습니다.
첫번째 단계는 Data Extraction, 즉 데이터 분석, 모델링과 관련된 논문을 크롤링하고 학습을 위한 데이터를 추출하는 단계입니다.
두 번째 단계는 Lora기반의 Fine Tuning을 진행한 단계이며, 마지막 단계는 파인튜닝된 모델을 통해 새로운 피쳐를 생성하는 단계입니다.
Data Extraction
전체 프레임워크는 아래와 같습니다.
모델 평가 계획
저희의 모델 평가를 위해 사용할 ML모델과 데이터셋을 선정하였는데요,
Feature generation의 자동화를 시도했던 선행 논문들에서 실험으로 사용한 ML 모델로 tree기반의 XGBoost, Catboost, RandomForest을 선정하였습니다.
또한 선행 모델에서 평가했던 데이터셋 중 6개와 kaggle 데이터셋을 사용하여 평가를 진행했습니다.
Kaggle에서는 다양한 도메인과 베이스 모델이 학습하지 않았을 법한 데이터셋, binary classification에 적합한 데이터셋을 기준으로 선정하였습니다.
여러 시도들과 현 모델
바로 한 번에 원하는 대로 모델이 완성되면 좋겠지만....
저희도 이 피쳐를 생성하는 LLM을 만들기 위해 많은 시도가 있었는데요,
특히 중간 발표 전까지는 어떻게 해야 데이터 분석가의 노하우를 잘 반영하는 데이터를 논문으로부터 추출할 것인가에 논의를 활발히 하였습니다.
최초 시도에서는 논문에서 새로 생성한 new feature와 이를 생성한 배경인 context를 추출하여 4bit로 양자화시킨 pre-trained model의 학습 데이터로 사용했습니다.
그러나 학습된 모델의 답변의 질이 알아보기 어려울 만큼 좋지 않았습니다.
따라서 논문에서 파생변수를 만들 때의 정보를 5가지로 세분화하고, qLoRA의 경우 8bit로진행하였습니다.
만들어진 feature의 성능 평가 단계를 자동화하기 위해, gpt api를 호출하여 모델의 결과를 주고, python code로 변환하도록 하였습니다.
이렇게 최종으로 만들어진 python code를 이용하여 기존 데이터셋에 new feature를 추가하고 성능을 확인하였습니다.
ml모델에 적합시킨 결과, new feature를 적용하지 않았을 때보다 성능이 개선됨을 확인하였습니다. 하지만 이 모델에는 아쉬운 점이 있습니다.
첫째, gpt를 이용하면 회사 내부의 데이터를 사용하기 어렵다는 점
둘째, GPT의 개입으로 인해 향상된 성능이 학습시킨 모델의 영향인지 gpt의 영향인지 판단하기 어려운 부분이 존재한다는 점
이를 해결하는 가장 최선의 방법은, 저희의 LLM 모델이 python code를 최종 답변으로 출력하는 모델을 만들고자 하였습니다.
이에 대한 아키텍처는 다음과 같습니다.
학습 시 prompt 구조를 좀 더 구체화시키고, python code를 output으로 내뱉도록 학습을 진행했습니다.
이렇게 학습된 모델이 바로 적용 가능한 형태의 python code를 답변으로 제시함을 확인할 수 있습니다.
코드를 생성하게 구조를 바꾸어, 파생 변수 열 추가, 모델 적합 및 AUC 확인까지 모든 과정을 한번에 자동화하는 것을 가능하게 하였습니다.
Gpt api를 사용하지 않아도, 새로운 파생 변수를 추가할 시 성능 향상을 보여주는 것을 확인할 수 있었습니다.
(본 모델이 완성된 시점이 중간 발표 자료 마감 시점이었어서, 시간 관계상 일부 데이터셋에 대해서만 우선 평가를 진행하였습니다.)
피드백 및 향후 계획
저희의 연구 내용에 대해 멘토님들과 여러 동료분들께서 다양한 피드백을 주셔서 너무 감사하였습니다.
피드백을 토대로 향후 계획을 크게 모델 평가, 아키텍처 설계 두 가지 부분으로 세워볼 수 있었습니다.
모델 평가
AUC 지표가 조금 더 유의하면서도 안정적으로 변할 수 있도록 해 보려 합니다.
아울러 평가용 tabular 데이터셋 중 LLM 학습에 사용된 논문에서 이미 다루었다면, 파생 변수를 쉽게 제안할 수 있을 테니 모델이 알고 있지 않은,
최신 데이터에 대해서도 검증을 해 보면 좋겠다는 피드백을 토대로,
논문에서 사용한 데이터를 날짜별로 정렬하여 가장 최신 데이터셋보다 더 늦게 나온 데이터셋으로도 모델을 평가할 계획입니다.
이외에도 파이썬 코드 작동 비율, 생성된 새로운 피쳐의 내용적 풍부성 등 세부적인 평가 지표도 추가적으로 수립해 모델 평가에 반영할 계획입니다.
아키텍처 설계
현 시점까지는 "논문에서 전문가의 노하우를 잘 추출하는 방법"에 집중을 하였으니,
이제부터는 "모델이 논리적으로 답변하고 이에 피드백을 주는 방법”에 집중을 할 계획입니다.
이 부분을 해결하기 위해 DPO를 통한 피드백 부여, CoT 기반의 답변을 유도하는 방안을 구체화하고 있습니다.
이를 해결함으로써 저희 과제의 중요한 부분인 AUC 지표에 유의한 도움을 줄 수 있습니다.
여기에서 회사의 실무적 도움, 독창성 증대를 기대할 수 있습니다.
현재 모델 적용을 위한 구체화와 코드 구현을 진행하고 있으며, 질이 높은 추가 데이터를 augmentaion을 하는 것도 계획 중입니다.
이렇게 하여 중간 발표까지의 과제 상황 공유, 그리고 향후 계획까지 정리하였습니다.
남은 펠로우쉽 기간도 열심히 달려서 성공적으로 과제를 수행하겠습니다.🔥
감사합니다
kon7672 님의 최신 블로그
더보기-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구결과(3)
- 안녕하세요 😃 SKT AI Fellowship 6기 “AI 데이터분석가 도입을 통한 데이터 인텔리전스 실현” 과제를 수행한 고스체인 팀입니다. 지난 10월 31일 최종 발표를 마지막으로, 약 6개월간의 펠로우쉽 과제 수행을 마무리하였습니다. 펠로우 자격으로 데브오션에 글을 쓰는 마지막 시간이 되었습니다. 이번 글에선 저희 팀이 수행한 과제가 무엇인지, 어떠한 새로운 AI 기술을 만들었는지를 말씀드리고 그 결과와 기술 활용 사례를 공유드리려 합니다. 다만, 현재 글을 처음 게시하는 시점에서는 특허 출원과 논문 심사가 진행 중인 상황이라, 당장 현 시점에서 기술적 개발 부분, 성능 결과 관련한 내용들을 담아내지 못하게 된 점을 미리 양해의 말씀을 드리고자 합니다. ...
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구과정(2)
- 안녕하세요 😃 AI Fellowship 6기의 “AI 데이터분석가 도입을 통한 데이터 인텔리젼스 실현” 과제를 수행하고 있는 고스체인 팀입니다. 과제를 시작한 지 엊그제 같은데, 벌써 지난 주에 과제 진행에 대한 중간 발표까지 이루어졌습니다. 발표를 기점으로, 지금까지 진행한 내용들을 정리하고 피드백을 기반으로 향후 과제를 발전시킬 수 있는 기회를 가질 수 있었습니다. 이번 글에서는 저희가 중간 발표에서 진행했던 내용에 대해 소개드리고, 그에 대한 피드백과 향후 계획을 얘기하려 합니다. 1. 중간 발표 과제 소개 지난 글에서 소개하였듯, 저희 과제의 목표는 LLM을 이용해 데이터 분석을 자동화하는 기술을 만드는 것입니다. 데이터 분석 프로세스에서 LLM을 통해 ...
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구계획(1)
- 안녕하세요! 이렇게 DEVOCEAN을 통해 인사드릴 수 있게 되어 너무나 영광입니다. 저희는 SKT AI Fellowship 6기에서 AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 과제를 맡게 된 고스체인 팀 고정현, 박경윤, 이동훈입니다. 앞으로 5개월 간 펠로우십의 여정을 Devocean에 기록하게 되었습니다. 잘 부탁드립니다 (야호) 😊 1. Prologue LLM과 같은 생성형 AI와 블록체인에 기반한 web 3.0 패러다임이 퍼지고 있는 시기입니다. 이렇게 빠르게 변화하는 상황 속에서 데이터 분석 역시 근본적인 변화가 일어날 것으로 예상되고, 이에 발빠르게 대응할 필요가 커지고 있습니다. 더불어 생성형 AI를 데이터 분석과 결합하게 되...
DEVOTEE 추천 블로그
-
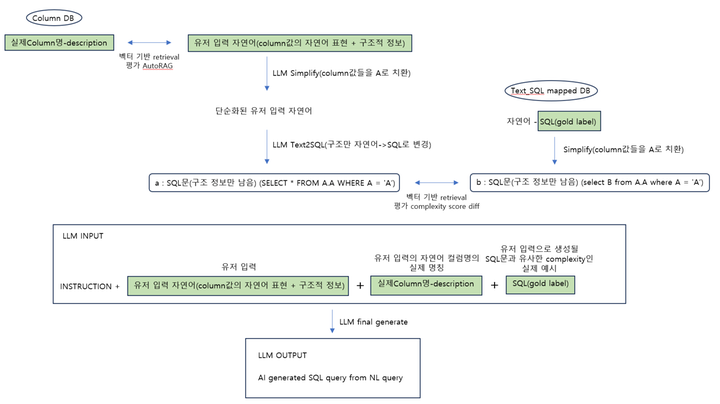
- RAG 및 LLM 파인튜닝을 통한 Text2SQL 모델 성능 개선 - 연구계획(1)
- 안녕하세요! 저희는 SKT AI Fellowship 6기 a-02번 과제를 맡은 skql(슼큐엘) 팀입니다! 이번 포스트를 통해 저희 팀의 연구 주제와 진행 방법에 관해 설명드리겠습니다! 1. 연구 과제 소개 1.1. 연구 목표/내용/배경 데이터분석에 관심이 많으신 분이라면 SQL을 한 번 쯤은 들어보셨을텐데요. SQL은 데이터베이스에서 자료를 처리하는 용도로 사용되는 구조적 데이터 질의 언어이고, SQL을 통해 사용자들은 데이터베이스에서 쉽게 자료를 찾거나 저장할 수 있습니다. 데이터 분석을 통해 인사이트를 발견하는 것부터, 파이프라인 개발이나 프로그래밍에 활용하는 등 다양한 곳에 데이터가 사용되면서 SQL의 중요성이 증가하고 있습니다. 이에 저희는 IDCube...
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구계획(1)
- 안녕하세요! 이렇게 DEVOCEAN을 통해 인사드릴 수 있게 되어 너무나 영광입니다. 저희는 SKT AI Fellowship 6기에서 AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 과제를 맡게 된 고스체인 팀 고정현, 박경윤, 이동훈입니다. 앞으로 5개월 간 펠로우십의 여정을 Devocean에 기록하게 되었습니다. 잘 부탁드립니다 (야호) 😊 1. Prologue LLM과 같은 생성형 AI와 블록체인에 기반한 web 3.0 패러다임이 퍼지고 있는 시기입니다. 이렇게 빠르게 변화하는 상황 속에서 데이터 분석 역시 근본적인 변화가 일어날 것으로 예상되고, 이에 발빠르게 대응할 필요가 커지고 있습니다. 더불어 생성형 AI를 데이터 분석과 결합하게 되...
-
- VPP를 위한 Object Insertion 기술 연구 - 연구과정(2)
- 안녕하세요! 저희는 SKT AI Fellowship 6기 C12 과제 VPP를 위한 Object Insertion 기술 연구를 진행하고 있는 인서트(INserT) 팀입니다. 이번 기록에서는 저희가 지난 6월부터 현재까지 어떤 연구를 진행하였고, 남은 기간 동안 어떠한 연구를 계획하고 있는지에 대해 공유해 드리겠습니다. 1. 연구 과제 소개 VPP (Virtual Product Placement) Virtual Product Placement (가상 상품 배치) 의 줄임말인 VPP는 제품, 간판 또는 비디오 형태의 디지털 콘텐츠에 특정 브랜드의 제품을 동적으로 삽입하는 기술입니다. PPL (Product PLacement)은 많이 들어보셨을 텐데요, PPL은 촬영 ...
-
- IA팀: LLM 기반 데이터 리니지 활용 Impact Analysis 대화형 에이전트 기술 개발 - 연구계획 (1)
- 안녕하세요! 👋 저희는 SKT AI Fellowship 7기에서 "LLM 기반 데이터 리니지 활용 Impact Analysis 대화형 에이전트 기술 개발" 과제를 수행하고 있는 IA 팀입니다! IA는 Impact Analysis의 머릿글자를 따서 지은 이름이에요. 이름처럼 인사이트풀한 문제를 분석하고 풀어내서 영향력 있는 팀이 되겠다는 포부를 담고 있습니다! 다음으로 본격적인 연구 과제를 소개하고 저희 팀이 그 과제를 어떻게 풀어나가려고 하는지에 대해서 자세히 적어보겠습니다. 1. 연구 과제 소개 🔎 연구 배경 및 필요성 현대의 데이터 플랫폼에서는 테이블 컬럼 하나만 바꿔도 대시보드가 깨지고, 모델이 실패하고, 그 책임은 누군가에게 돌아갑니다. 실제로 테이블 ...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.