
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
C언어로 구현한 AVX 함수를 PYTHON에서 호출하여 연산 속도 개선하기
- DEVOTEE 요약
- numpy나 tensorflow 같은 라이브러리를 직접 구현할 때 필요한 AVX/SIMD 명령어 사용법과 Python에서 C언어 함수를 호출하는 방법을 설명합니다. AVX는 256비트 SIMD 명령어셋으로, 많은 데이터를 동시에 처리해 연산 속도를 크게 개선할 수 있습니다. ctypes를 이용해 Python에서 C언어로 구현한 AVX 함수를 호출하면 성능을 더욱 향상시킬 수 있습니다.
안녕하세요. SKHYNIX DRAM EUV노광PHOTO기술팀 장우석 TL입니다.
이 글에서는 여러분이 numpy나 tensorflow 같은 라이브러리를 스스로 구현해야 할 때 필요한 기술을 이야기하려고 합니다. 구체적으로는 이런 기술들 입니다.
AVX? SIMD란?
C언어로 작성한 함수를 PYTHON에서 호출하는 법
C언어로 구현한 AVX 함수를 PYTHON에서 호출하여 연산 속도 개선하는 예제
참고로, C 컴파일러는 MINGW64를 사용할 것입니다. (https://www.mingw-w64.org/downloads/)
1. AVX? SIMD란?
(이미지 출처 : https://en.wikipedia.org/wiki/Advanced_Vector_Extensions)
AVX(고급 벡터 확장, Advanced Vector eXtensions) 는 인텔과 AMD에 의해 공개된 256비트 SIMD 명령어셋 입니다. (정확히 말하면 AVX2 까지 256비트를 사용합니다.)
그리고, SIMD는 Single instruction, multiple data의 약자로, 하나의 명령어로 여러 데이터를 동시에 다루는 것을 의미합니다.
256비트, 라는 숫자를 잘 기억해주세요. avx2를 이용한 더하기는 이런 식으로 작동합니다.
256비트 레지스터1 에 32비트 int나 float를 8개 채워넣고
256비트 레지스터2 에 32비트 int나 float를 8개 채워넣은 뒤
레지스터 1의 8개 숫자와 레지스터 2의 숫자 8개를 동시에(!!!!) 더해서
256비트 레지스터3 에 32비트 int나 float를 8개 채워넣습니다.
이를 c언어로 구현하면 다음과 같습니다.
/* t.c */
/* gcc t.c -mavx2 -o t.exe */

#include <immintrin.h>
#include <stdio.h>
#include <stdlib.h>


void add8IntArraysAVX(int* a, int* b, int* result) {
    __m256i avx_a = _mm256_loadu_si256((__m256i*)a);
    __m256i avx_b = _mm256_loadu_si256((__m256i*)b);
    __m256i avx_result = _mm256_add_epi32(avx_a, avx_b);
    _mm256_storeu_si256((__m256i*)result, avx_result);
}

void show(int* arr,  int arrc){
    printf("[");
    for (int i = 0; i < arrc ; i++){
        printf("%d",*(arr+i));
        if (i < arrc-1) {printf(", ");}
    }
    printf("]");
}


int main(){
    int arr1[8] = {5,6,7,8,9,10,11,12};
    int arr2[8] = {9,10,1,2,3,4,5,6};
    int rst[8];

    add8IntArraysAVX(arr1, arr2, rst);
    show(rst, 8); /* [14, 16, 8, 10, 12, 14, 16, 18] */

    return EXIT_SUCCESS;
}
그러면 곱하기는 어떻게 구현될까요?
32비트 정수 곱하기 32비트 정수의 결과값을 담으려면 64비트가 필요합니다.
때문에, _mm256_mul_epi32은 _mm256_add_epi32 랑 조금 다르게 작동하는데요.
256비트 레지스터1 에 32비트 int나 float를 8개 채워넣고
256비트 레지스터2 에 32비트 int나 float를 8개 채워넣고
홀수 번째 숫자만(!!!!!!!!!) 추려서 곱해서
256비트 레지스터3에 64비트 int나 float를 4개 채워넣습니다.
이를 구현한 코드는 다음과 같습니다.
/* t.c */
/* gcc t.c -mavx2 -o t.exe */

#include <immintrin.h>
#include <stdio.h>
#include <stdlib.h>


void mul8IntArraysAVX(int* a, int* b, long long* result) {
    __m256i avx_a = _mm256_loadu_si256((__m256i*)a);
    __m256i avx_b = _mm256_loadu_si256((__m256i*)b);
    __m256i avx_result = _mm256_mul_epi32(avx_a, avx_b);
    _mm256_storeu_si256((__m256i*)result, avx_result);
}

void show(long long* arr,  int arrc){
    printf("[");
    for (int i = 0; i < arrc ; i++){
        printf("%lld",*(arr+i));
        if (i < arrc-1) {printf(", ");}
    }
    printf("]");
}


int main(){
    int arr1[8] = {5,6,7,8,9,10,11,12};
    int arr2[8] = {9,10,1,2,3,4,5,6};
    long long rst[4];

    mul8IntArraysAVX(arr1, arr2, rst);
    show(rst, 4); /* [45, 7, 27, 55] */

    return EXIT_SUCCESS;
}
아주 쉽습니다.
(avx2 api docs : https://www.intel.com/content/www/us/en/docs/intrinsics-guide/index.html)
2. PYTHON에서 C 함수 호출하기
python에서 c 언어 함수를 호출하려면 두 가지 방법이 있습니다.
cython을 쓴다. (https://cython.org/)
ctypes를 쓴다. (https://docs.python.org/3/library/ctypes.html)
양쪽 다 장단점이 있는데,
cython은 python을 살짝 변형한 문법으로 c 언어를 다룰 수 있게 해주는 대신, 컴파일 과정도 복잡하고, 종종 종속성 이슈가 발생하게 됩니다.
경험상? 제가 cython을 쓸 때는, numpy와 몇몇 c 라이브러리를 섞어 써야 할 때가 대부분인데, numpy에서 어떤 중요한 변경점이 발생한 걸 모르고,
numpy 버전을 올렸다가, 함수가 다 망가진 적이 있었어요. 금방 해결하긴 했는데, 섬뜩했죠. 믿음과 신뢰의 numpy 였는데...
ctypes는 c언어 dll 파일을 그냥 가져다가 쓸 수 있게 해주는 라이브러리입니다.
파이선에 내장된 라이브러리라 종속성 문제도 없고 깔끔한 대신, 그냥 c 언어를 잘 알아야 합니다.
c언어 자체를 싫어하시는 분은 cython이 더 나을 수도 있어요.
이 글에서는 ctypes를 사용하겠습니다.
/* arr.c */
/* gcc arr.c -fPIC -shared -o arr.dll */

#include <stdio.h>
#include <stddef.h>
#include <stdlib.h>


void mul(size_t* arr, size_t num, size_t arrc){
    for (size_t i = 0; i < arrc ; i++){
        *(arr + i) *= num;
    }
}

void show(size_t* arr,  size_t arrc){
    printf("[");
    for (size_t i = 0; i < arrc ; i++){
        printf("%zu",*(arr+i));
        if (i < arrc-1) {printf(", ");}
    }
    printf("]");
}
먼저 arr.c를 위처럼 작성한 뒤, gcc로 컴파일 해주세요. 컴파일 커맨드는 코드 맨 위에 있습니다.
# run.py

import ctypes
from pathlib import Path

arr = (ctypes.c_size_t * 10)(*[1,2,3,4,5,6,7,8,9,10])


PATH_ADD_DLL = Path(Path(__file__).parent, "arr.dll").__str__()
cf = ctypes.CDLL(PATH_ADD_DLL)
cf.mul(arr,5,10)
cf.show(arr,10)  #[5, 10, 15, 20, 25, 30, 35, 40, 45, 50]
그 다음, 컴파일의 결과로 나온 arr.dll과 같은 폴더에 run.py를 위처럼 작성하고 실행하면
arr.c에 정의 했던 mul 함수와 show 함수가 잘 실행되는 걸 보실 수 있습니다.
조금 array 선언 방식이 낯서실 수는 있는데, 결국 size_t 의 크기 * 10개 만큼 빈공간을 만들어놓고, list에 들어 있는 숫자들을 채운 것이에요.
엄청 쉽습니다.
3. C언어로 구현한 AVX 함수를 PYTHON에서 호출하여 연산 속도 개선하는 예제
/* arr.c */
/* gcc arr.c -mavx2 -fPIC -shared -o arr.dll */

#include <immintrin.h>


void add8IntArraysAVX(int* a, int* b, int* result) {
    __m256i avx_a = _mm256_loadu_si256((__m256i*)a);
    __m256i avx_b = _mm256_loadu_si256((__m256i*)b);
    __m256i avx_result = _mm256_add_epi32(avx_a, avx_b);
    _mm256_storeu_si256((__m256i*)result, avx_result);
}

void mul8IntArraysAVX(int* a, int* b, long long* result) {
    __m256i avx_a = _mm256_loadu_si256((__m256i*)a);
    __m256i avx_b = _mm256_loadu_si256((__m256i*)b);
    __m256i avx_result = _mm256_mul_epi32(avx_a, avx_b);
    _mm256_storeu_si256((__m256i*)result, avx_result);
}
먼저 avx 더하기 곱하기 함수를 arr.c에 정의하고 arr.dll로 컴파일 해줍니다.
#add.py

import ctypes
from pathlib import Path

arr = (ctypes.c_int * 8)(*[1,2,3,4,5,6,7,8])
arr2 = (ctypes.c_int * 8)(*[10,7,6,5,6,3,2,1])
rst = (ctypes.c_int * 8)()

PATH_ADD_DLL = Path(Path(__file__).parent, "arr.dll").__str__()
cf = ctypes.CDLL(PATH_ADD_DLL)
cf.add8IntArraysAVX(arr,arr2,rst)

print([i for i in rst]) #[11, 9, 9, 9, 11, 9, 9, 9]
컴파일해서 나온 add.dll과 같은 폴더에 add.py를 놓고 실행하면 잘 실행되는 것을 볼 수 있습니다.
#mul.py

import ctypes
from pathlib import Path

arr = (ctypes.c_int * 8)(*[1,2,3,4,5,6,7,8])
arr2 = (ctypes.c_int * 8)(*[10,7,6,5,6,3,2,1])
rst = (ctypes.c_longlong * 4)()

PATH_ADD_DLL = Path(Path(__file__).parent, "arr.dll").__str__()
cf = ctypes.CDLL(PATH_ADD_DLL)
cf.mul8IntArraysAVX(arr,arr2,rst) #[10, 18, 30, 14]

print([i for i in rst])
mul도 잘 작동하네요.
그러면 이 avx 함수들은 얼마나 빠른 걸까요?
#add_t.py

import time
import ctypes
from pathlib import Path

def meas_time(func):
    def tmp(*args, **kwargs):
        start = time.time()
        rtn = func(*args, **kwargs)
        end = time.time()
        print(f'{end-start}')
        return rtn
    return tmp

@meas_time
def test_py(arr1, arr2):
    for i in range(1000000):
        [a1 + a2 for a1, a2 in zip(arr1, arr2)]

@meas_time
def test_c(arr1, arr2):
    arr1 = (ctypes.c_int * 8)(*arr1)
    arr2 = (ctypes.c_int * 8)(*arr2)
    rst = (ctypes.c_int * 8)()

    PATH_ADD_DLL = Path(Path(__file__).parent, "arr.dll").__str__()
    cf = ctypes.CDLL(PATH_ADD_DLL)

    for i in range(1000000):
        cf.add8IntArraysAVX(arr1,arr2,rst)

if __name__ == "__main__":
    arr1 = list(range(8))
    arr2 = list(range(8))

    test_py(arr1, arr2)  #0.36424970626831055  sec
    test_c(arr1, arr2)   #0.171189546585083  sec
더하기 함수는 테스트 해보면 얼추 2배 정도 빠릅니다.
근데 사실, 자세히 보면 아시겠지만, python 자료형 <> c 자료형 변환하는 시간이 엄청 길죠.
이것을 극복할 만큼, c언어의 성능을 뽑아낼 수 있는가, 가 핵심입니다.
#mul_t.py

import time
import ctypes
from pathlib import Path

def meas_time(func):
    def tmp(*args, **kwargs):
        start = time.time()
        rtn = func(*args, **kwargs)
        end = time.time()
        print(f'{end-start}')
        return rtn
    return tmp

@meas_time
def test_py(arr1, arr2):
    def filter_odd(arr):
        rst = []
        for i in range(len(arr)):
            if i % 2 == 0:
                rst.append(arr[i])
        return rst

    arr1 = filter_odd(arr1)
    arr2 = filter_odd(arr2)
    for i in range(1000000):
        [a1 * a2 for a1, a2 in zip(arr1, arr2)]

@meas_time
def test_c(arr1, arr2):
    arr1 = (ctypes.c_int * 8)(*arr1)
    arr2 = (ctypes.c_int * 8)(*arr2)
    rst = (ctypes.c_longlong * 4)()

    PATH_ADD_DLL = Path(Path(__file__).parent, "arr.dll").__str__()
    cf = ctypes.CDLL(PATH_ADD_DLL)

    for i in range(1000000):
        cf.mul8IntArraysAVX(arr1,arr2,rst)

if __name__ == "__main__":
    arr1 = list(range(8))
    arr2 = list(range(8))

    test_py(arr1, arr2)  #0.27773237228393555  sec
    test_c(arr1, arr2)   #0.18175268173217773  sec
곱하기는 얼마나 빠른가요?
약 30프로 정도 더 빠르게 계산을 해주네요. GIL 선생이 슬퍼하시겠어요.
굉장히 좋습니다.
(https://numpy.org/doc/stable/reference/simd/index.html)
이상입니다. 참 쉽죠? numpy 공식 docs보면 SIMD, 참 저렇게 무섭게 적혀 있는데. 별 거 아닙니다.
이제 여러분들도 수학만 조금 공부하면, numpy 같은 라이브러리 만드실 수 있습니다.
다들 화이팅입니다.
jangwooseok2 님의 최신 블로그
더보기-

- C언어로 구현한 AVX 함수를 PYTHON에서 호출하여 연산 속도 개선하기
- 안녕하세요. SKHYNIX DRAM EUV노광PHOTO기술팀 장우석 TL입니다. 이 글에서는 여러분이 numpy나 tensorflow 같은 라이브러리를 스스로 구현해야 할 때 필요한 기술을 이야기하려고 합니다. 구체적으로는 이런 기술들 입니다. AVX? SIMD란? C언어로 작성한 함수를 PYTHON에서 호출하는 법 C언어로 구현한 AVX 함수를 PYTHON에서 호출하여 연산 속도 개선하는 예제 참고로, C 컴파일러는 MINGW64를 사용할 것입니다. (https://www.mingw-w64.org/downloads/) 1. AVX? SIMD란? (이미지 출처 : https://en.wikipedia.org/wiki/Advanced_Vector_Extensions...
-
- FastAPI에서 자동 생성되는 Swagger 문서의 cdn.jsdelivr.net 의존성 없애기
- 안녕하세요~ SKHYNIX DRAM EUV 노광PHOTO기술팀 장우석 TL입니다. 다들 알고 계시겠지만, 얼마 전에 큰 일이 있었어요. 인증서 문제로 인한 cdn.jsdelivr.net 접속 불능 사태 | GeekNews (hada.io) 지난 목요일(5/3)에 cdn.jsdelivr.net이 접속불능에 빠졌습니다. 저게 어떤 사이트냐면, bootstrap, jquery 등등을 저희가 link tag로 편하게 이용하고자 할 때, 무심코 접속하게 되는 사이트입니다. 제가 js, css 번들을 다운 받을 필요 없이, 단지 저 link tag를 html에 삽입하는 것만으로 위 라이브러리들을 사용할 수 있어서 편하게 사용들을 했었는데요. 저거 넣어서 만들었던 서비스들이 ...
-
- [C/PYTHON] Socket 기초 1 - 간단한 http 서버 만들기
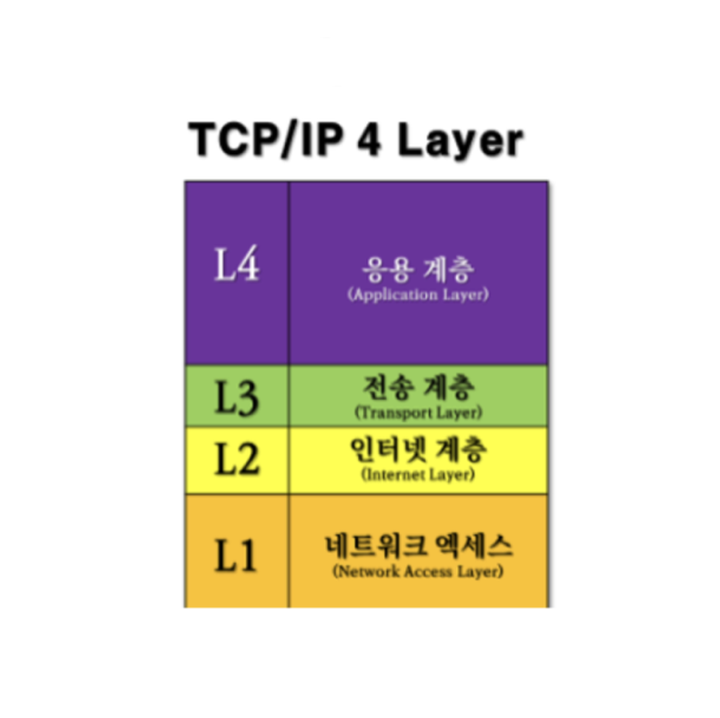
- 안녕하세요. SKHYNIX DRAM노광PHOTO기술팀 장우석 TL입니다. socket은 운영체제에 내장된, 전화를 거는 기능입니다. 조금 더 고급지게 말하면, socket은 응용 계층(L4)에서 그 아래 계층(L3~L1)에 접근하기 위한 인터페이스입니다. HTTP 서버를 구성할 때 사용하는 DJANGO, SPRING 등의 라이브러리들도 socket을 통해 네트워크에 접근합니다. 이 글에서는 socket을 이용하여 http 서버를 만드는 코드를 c언어와 python으로 보여드리고 코드를 설명 드리겠습니다. 1. simple http server for linux //server.c //simple http server for linux //gcc server.c -...
-
- [python/c] CYTHON 입문자를 위한 Q&A
- 안녕하세요. SKHYNIX DRAM노광포토기술팀 장우석 TL입니다. CYTHON은 C로 작성한 코드를 PYTHON에서 활용할 수 있도록 하는 라이브러리, 스크립트 입니다. 최근 3.0버전이 릴리즈 되었습니다. (https://appmaster.io/ko/news/c-paweoro-pythoneul-ganghwahaneun-cython-3-gonggae) 이 업데이트 방향에 대해, 다들 어떻게 생각하시는지 궁금해요. 퓨어 파이선 모드, NUMPY와의 연계를 더 강화했고, 앞으로도 그렇게 한다고 하는데요. 개인적으로는 NUMPY로도 속도가 모자라서 CYTHON을 쓰는데, NUMPY와의 연계를 강화하기 보단, 그 외 C LIBRARY들과의 연계를 더 강화해줬으면 하는 ...
DEVOTEE 추천 블로그


DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.