
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Long context LLM : 1부 Position Embedding
- DEVOTEE 요약
- LLM(대규모 언어 모델)에는 토큰 한도 제한이 있으며, 일부 Open Source LLM들은 이 제한이 상대적으로 작습니다. 이 제한을 극복하기 위해 Position Embedding에 대한 이해가 필요합니다. Position Embedding의 종류에는 절대적 위치를 사용하는 Absolute Position Embedding과 상대적 위치를 사용하는 Relative Position Embedding, 그리고 이를 일반화한 Rotary Position Embedding이 있습니다.
개요
Open Source LLM이든 Closed Source LLM이든 Context window의 token limit들이 존재합니다.
예전에 비하면 1M이상 허용되는 LLM들도 등장하기는 했습니다만 여전히 finetunning을 부담없이 마음대로 할 수 있는 Open Source LLM의 경우에는 그에 비하면 상당히 작습니다.
물론 pretrain을 위한 노하우와 LLM을 학습할 만한 데이터를 가지고 있다면 긴 context까지 수용가능하도록 LLM을 pretrain하는 방법도 있기는 합니다.
그러나 이미 pretrain되있는 훌륭한 Open Source LLM을 pretrain 거의 없이 활용할 수 있는 방법이 없을까요?
당연히 있습니다. 그 부분에 대해서 말씀드리기 전에 Position Embedding에 대한 이해가 필요합니다.
본 post에서는 Position Embedding에 대한 전반적인 설명을 하도록 하고 다음 post에서 본격적으로 Context Window Token Limit을 늘릴 수 있는 방법에 대해 말씀드리도록 하겠습니다.
Position Embedding
Position Embedding에 대한 개략적인 이해
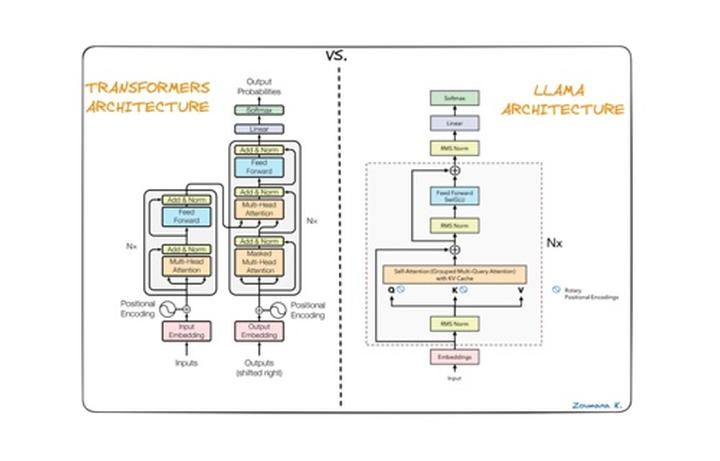
Transformer의 구조를 보면 아래의 그림과 같습니다. 아래 그림은 정말 많이 보셨을꺼 같은데요.
Position Embedding이 있는 부분이 그림상의 Positional Encoding입니다.
Position Embedding에 대한 이해를 위해 Input부터 Position Encoding까지 어떤 식으로 들어가는지 차근차근 말씀을 드리도록 하겠습니다.
먼저 Input으로 "퇴근하자"라는 문구가 들어갔다고 가정을 해보겠습니다.
그러면 사전에 정의된 vocabulary로부터 "퇴근하자"의 token에 대한 index를 return해주는 것이 Transformer그림상의 Inputs의 역할이라고 보시면 되겠습니다.
그렇게 Input Embedding으로 "퇴근하자"에 대한 token index가 들어오면 각 index에 mapping되어있는 embedding vector를 return해주는 것이 Input Embedding이 하는 역할입니다.
그 다음 step으로 Positional Encoding정보와 Input Embedding이 합쳐져서 self attention layer의 input으로 들어가게 됩니다.
여기서 Positional Encoding정보는 간단하게 얘기해서 "퇴근하자"에서 "퇴"라는 token이 몇번째 위치하는지를 나타내는 값(scalar 또는 vector)입니다.
사실 Positional Encoding을 무엇으로 정의를 할지 Positional Encoding과 Input Embedding vector를 어떤 식으로 합칠지에 따라 다양한 Position Embedding방법이 있습니다.
아래 그림상에서는 Position Encoding vector와 Input Embedding vector를 단순 vector sum으로 하였네요.
Position Embedding의 필요성
그렇다면 Position Embedding이 대체 왜 필요할까요?
Transformer가 나오기전에 한창 hot했던 RNN이나 LSTM같은 sequence model의 경우는 Position Embedding이라는 것이 필요가 없었습니다.
그 이유는 아래 그림처럼 Input들이 순차적으로 들어가기 때문에 필요가 없었습니다.
그러나 Transformer의 경우에는 Input들이 순차적으로 들어가지 않습니다.
위의 그림처럼 한꺼번에 "퇴근하자"라는 문장이 들어가기 때문에 Position Embedding의 정보가 없으면 "하자퇴근"이라는 말과 동일하게 인식을 하게 됩니다.
따라서 token의 구성은 같지만 다름을 모델에게 인지시키기 위해 각각의 token들에 대한 위치정보로 Position Embedding이 필요로 하게 된 것입니다.
Notation
글이 중반부 이상 넘어가고 있는데 갑자기 Notation을 말씀을 드려야 할 꺼 같습니다.
아무래도 Position Embedding의 종류에 대해 말씀드리기 위해서는 불가피하게 Notation을 도입을 해야 좀 더 소통하기 편한 관계로 관련해서 말씀드리도록 하겠습니다.
Position Embedding의 종류에 대해서 얘기를 할 때 self attention의 query, key, value function들도 같이 얘기를 해야해서 부득이하게 관련된 notation도 도입하게 되었습니다^^;
Position Embedding의 종류
자 그럼 본격적으로 Position Embedding의 종류에 대해 말씀드리도록 하겠습니다.
Position Embedding의 종류로는 크게 Absolute Position Embedding과 Relative Position Embedding, Rotary 2개로 나뉩니다.
그리고 요즘은 Relative Position Embedding중에서 Rotary Position Embedding이 많이 쓰이고
이는 Context Window의 token limit을 늘리는데 중요한 역할을 하기 때문에 따로 다시 말씀드리도록 하겠습니다.
Absolute Position Embedding
Absolute Position Embedding은 말 그대로 절대적 위치를 사용하여 Position Embedding을 정의합니다.
절대적 위치를 이용해서 어떻게 정의를 하느냐는 모델마다 다릅니다.
Transformer 논문에서는 다음과 같이 Position Embedding vector를 정의하게 됩니다.
아무래도 position embedding vector를 sin, cos이라는 주기함수로 정의했다보니 이론적으로는 position을 무한대로 키워도 값들은 무슨 값이든 나오게 됩니다.
Bert계열이나 GPT2 모델의 경우에는 Position Embedding vector는 Maximum Sequence length를 고정해놓고 해당개수 만큼의 trainable vector set으로 정의하여 모델 pretrain시 같이 학습하도록 합니다.
여기에서는 Maximum Sequence length를 정의했다보니 position이 Maximum Sequence length가 넘는 값이면 정의되지 않은 값이라 모델에서 수용할 수가 없게 됩니다.
지금까지는 position embedding vector를 어떻게 정의를 하느냐였고 정의된 position embedding vector와 input embedding vector를 합치는 방법으로는
Absolution Position Embedding에서는 단순히 vector sum으로 정의를 하게 됩니다.
그래서 query, key, value function은 다음과 같이 정의를 할 수 있게 됩니다.
Relative Position Embedding
Relative Position Embedding은 position embedding vector를 정의할 때 상대적인 위치로 position embedding vector를 정의하겠다는 concept입니다.
언뜻 생각을 해보면 상대적인 위치를 어떻게 쓰겠다는 건지 이해가 되지 않을 수 있습니다.
transformer구조를 생각해보면 input embedding vector와 position 정보가 합쳐져서 self attention의 input으로 들어갑니다.
그리고 self attention score에서의 attention weight에 상대적인 위치라는 개념이 나올 수가 있습니다.
조금 더 직관의 영역에서 얘기를 해보면 m번째 self attention score는 n개의 value function의 weighted sum으로 정의가 되는데
여기서 weight인 attention weight은 m번째 token과 서로 다른 위치의 token이 얼마나 영향을 미치는가로 해석을 할 수 있습니다.
생각을 해보면 m번째 token과 가까운 token들이 영향을 강하게 미칠 것이고 멀리 떨어져 있으면 떨어져 있을수록 약하게 영향을 미친다는 것을 우리가 평소에 쓰는 문장에서부터 알고 있습니다.
이러한 부분은 attention weight에 상대적인 위치정보만 들어가더라도 우리가 생각하고 있는 것을 충분히 반영될 수가 있습니다.
그렇다면 어떻게 attention weight에 상대적인 위치를 넣을 수 있을까요?
attention weight에서 중요하게 연산하는 부분이 m번째 query function과 n번째 key function의 inner product연산입니다.
해당 연산을 Absolute Position Embedding일 때 해당 연산을 해보면 다음과 같습니다.
위 식에서 빨간색 block부분이 위치와 관련된 부분이고 해당 부분을 어떻게 상대적인 위치로 녹여서 적의를 하느냐는 모델마다 다릅니다.
대표적으로 T5모델의 경우는 위의 빨간색 block부분을 하나의 bias term으로써 상대적인 position 정보를 넣게 됩니다.
value function에는 어차피 attention weight쪽에 상대적인 위치정보가 들어갔기 때문에 별도로 위치정보를 추가로 더 넣어서 정의하진 않습니다.
Rotary Position Embedding
Rotary Position Embedding은 Relative Position Embedding을 조금 더 일반화시킨 것에서부터 생각을 하게 됩니다.
앞서 Relative Position Embedding에 대해서 얘기를 할 때 query function과 key function을 input의 linear transformation이라고 가정하였습니다.
하지만 Rotary Position Embedding은 다음 식을 만족하는 query function, key function 그리고 function g를 찾는 것에서부터 시작합니다.
그러나 그냥 위의 식을 만족하는 함수를 찾는 것은 막연합니다. 그래서 2차원 case로 좁혀서 생각을 해봅시다.
추가로 position 정보가 없을때는 다음과 같이 input embedding vector의 어떤 함수라고 가정을 합니다.
2차원 case이기 때문에 우리는 복소수 평면으로 생각해서 query function과 key function을 다음과 같은 radical, angular component의 function으로 쓸 수 있습니다.
그러면 query, key function과 g function의 관계와 initial condition을 만족하도록 query function과 key function을 구하면 아래와 같습니다.
(자세한 식 유도는 Rotary Position Embedding paper에 잘 나와있습니다.)
여기서 initial condition을 input embedding vector의 linear transformation이라고 두고, gamma를 0이라고 두면 결국 query function과 key function은 다음과 같이 정의할 수 있습니다.
위 식에서부터 알다시피 position은 exponential term에만 관련이 있고 이를 matrix representation하면 다음과 같이 쓸 수 있습니다.
이는 transformer논문에서 position embedding vector와 마찬가지로 position이 정의된 max token limit이상으로 주어지더라도 모델자체내에서 수용은 가능한 구조라는 것을 볼 수 있습니다.
그래서 아래 그림의 빨간색 block처럼 max token limit이상 generate시키면 이상한 token이라도 generate를 하게 됩니다.
이제까지는 2차원에서 query function과 key function에 대한 이야기를 했었고 동일하게 general한 짝수 차원으로 확장해서 식을 써보면 다음과 같이 정의할 수 있습니다.
여기서의 theta는 hyperparameter이고 모델마다 다르기는 하지만 많은 모델에서 theta를 다음과 같이 정의되고 있습니다.
여담으로 RoPE paper에서 위와 같이 theta를 정의했을 때 attention weight의 upper bound를 계산할 수 있는데 그때 token이 멀리 떨어질수록 서로의 영향도가 떨어진다는 long term decay property를 증명을 하였습니다.
이런 식의 Rotary Position Embedding방법은 현재 거의 모든 open source LLM에 사용되고 있고 transformer구조와는 다르게 position embedding layer를 매 transformer layer시작할 때마다 넣어주는 구조를 취하고 있습니다.
지금까지 Position Embedding에 대해 말씀드렸는데요. 아마 많은 분들이 아시고 계신 사항이라고 생각이 됩니다.
다음 post에서 말씀드릴 pretrain된 LLM에서 max token limit 이상에도 pretrain시킨 능력을 유지시키는 방법에 대해서 말씀드릴 때 Position Embedding을 변형시키기 때문에
이번 post는 Intro라고 생각하시고 가볍게 읽어주셨으면 좋겠습니다. 감사합니다:)
jshwang0311 님의 최신 블로그
더보기-

- Long context LLM : 2부 RoPE Extension Method
- 개요 1부에서는 Position Embedding에 대한 전반적인 내용에 대해서 한번 훑어보았습니다. (참고 : https://devocean.sk.com/blog/techBoardDetail.do?ID=166264) 1부 마지막 쯔음에 요즘 open source LLM들은 대부분 Rotary Position Embedding(RoPE)을 사용하고 있다고 말씀드렸습니다. 이번 포스트에서는 RoPE layer쪽을 살짝 바꿔줌으로써 원래 수용가능한 context size보다 훨씬 더 많은 양이 수용가능한 방식에 대해 말씀드리도록 하겠습니다. Position Interpolation Position Interpolation에 대해 말씀드리기 전에 일단 2d case에서...
-

- ICML 2024를 다녀와서..
- 이번에 ICML(International Conference on Machine Learning) 2024에 outlier detection이라는 주제로 논문이 채택되어 포스터 발표를 위해 출장을 다녀왔습니다. 원래는 Long Context LLM 2부에 대해 포스팅을 하려고 했지만 출장 다녀온김에 적시성있게 제가 발표했던 내용과 짧게짧게 제가 파악한 LLM에 대한 전반적인 내용에 대해서 공유드리고자 합니다. ICML 포스터 발표 개요 및 동기 제가 발표한 논문은 smart factory관련 프로젝트를 할 때 시작을 하게 되었습니다. 당시 프로젝트는 센서를 통해 컨베이어벨트 또는 모터들의 이상탐지를 하는 프로젝트였으며, 이상상황에 대한 데이터는 labeling이 ...
-
- Long context LLM : 1부 Position Embedding
- 개요 Open Source LLM이든 Closed Source LLM이든 Context window의 token limit들이 존재합니다. 예전에 비하면 1M이상 허용되는 LLM들도 등장하기는 했습니다만 여전히 finetunning을 부담없이 마음대로 할 수 있는 Open Source LLM의 경우에는 그에 비하면 상당히 작습니다. 물론 pretrain을 위한 노하우와 LLM을 학습할 만한 데이터를 가지고 있다면 긴 context까지 수용가능하도록 LLM을 pretrain하는 방법도 있기는 합니다. 그러나 이미 pretrain되있는 훌륭한 Open Source LLM을 pretrain 거의 없이 활용할 수 있는 방법이 없을까요? 당연히 있습니다. 그 부분에 대해서...
DEVOTEE 추천 블로그

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.