
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Data Projects에서 I/O Optimization

- DEVOTEE 요약
- 일반적인 데이터 ML 프로젝트에서는 알고리즘 최적화 외에도 I/O 작업 최적화를 통해 성능을 개선할 수 있습니다. CSV는 비효율적인 데이터 저장 형식이며, Feather와 Parquet 형식이 더 적은 메모리를 사용하고 더 빠른 읽기/쓰기 성능을 보여줍니다. CSV 문제를 인식하고 데이터를 저장할 상황에 맞는 최적의 형식을 선택하는 것이 중요합니다.
일반적인 데이터 ML 프로젝트에서 최적화 노력(실행 시간과 메모리)은 보통 알고리즘 측면에 집중됩니다.
하지만 I/O 관련 작업을 최적화함으로써도 상당한 개선을 경험할 수 있습니다.
데이터 저장에 가장 일반적인 옵션은 CSV이지만, 이는 시간과 저장 효율이 매우 낮습니다.
개선하는 방법에 대해 알아보겠습니다.
CSV 외에도 DataFrame을 저장할 수 있는 다양한 다른 옵션이 있습니다.
따라서 데이터 파이프라인을 최적화하기 위해 다음 매개변수에 대한 성능을 비교하는 것이 유용할 수 있습니다:
디스크에서 차지하는 공간
읽기 및 쓰기 실행 시간
이 실험을 위해, 다음과 같은 가상의 데이터를 생성했습니다:
100만 행
20개의 열
사례 1: 숫자 열만 포함된 경우.
사례 2: 숫자 열 10개와 문자열 열 10개가 포함된 경우.
테스트는 단일 노드에서 했습니다.
다음 시각 자료는 각 형식에 저장된 경우 DataFrame(사례 1 및 사례 2)의 메모리 사용량을 나타냅니다:
위에서 언급한 바와 같이:
두 경우 모두 CSV는 DataFrame을 저장하기에 가장 최적의 형식이 아닙니다.
숫자 데이터의 경우, Parquet는 CSV보다 2배 이상 적은 공간을 차지합니다.
숫자 데이터의 경우, Feather도 유망합니다.
혼합 열의 경우, JSON을 제외한 모든 형식이 거의 동일한 공간을 차지합니다.
다음으로, 아래 자료는 DataFrame을 해당 형식으로 저장하는 데 걸리는 실행 시간을 나타냅니다:
위에서 언급한 바와 같이:
숫자 열만 있을 경우, DataFrame을 pickle로 저장하는 것이 CSV보다 훨씬 빠릅니다. 하지만 혼합 열이 있는 경우 실행 시간이 크게 증가합니다.
Feather는 두 경우 모두 가장 적은 실행 시간을 가지므로 명확한 승자입니다. 또한, 앞서 언급한 저장 결과에서도 Feather 형식이 가장 유망한 형식 중 하나였습니다.
여기서 Parquet 형식도 유망합니다.
마지막으로, 아래 시각 자료는 해당 형식으로 저장된 DataFrame을 메모리에서 로드하는 데 걸리는 실행 시간을 나타냅니다:
위에서 언급한 바와 같이:
숫자 열이 있는 경우 Pickle, Feather, Parquet의 읽기 시간이 가장 짧습니다.
하지만 혼합 열이 있는 경우 Parquet의 읽기 시간이 크게 증가합니다.
Feather는 두 경우 모두 실행 시간이 짧아 가장 유망한 형식으로 보입니다.
CSV는 최적의 선택이 아닙니다.
Excel에서 열거나 지속적으로 데이터를 추가해야 할 때만 사용하세요.
CSV는 데이터 유형 정보를 보존하지 못합니다.
Pickle은 데이터 유형을 보존하지만, 혼합 열의 경우 실행 시간이 나빠집니다.
또한, Python 전용입니다.
Feather와 Parquet 비교:
Feather는 약간 더 많은 메모리를 사용하지만, 실행 시간이 빠릅니다.
Parquet는 숫자 데이터에 적합하고, 저장 공간 활용이 우수합니다.
CSV의 문제를 인식하고, 상황에 맞는 최적의 형식을 선택하는 것이 성능 개선에 도움이 될 것 같습니다.
홍반장 님의 최신 블로그
더보기-

- Data Projects에서 I/O Optimization
- 일반적인 데이터 ML 프로젝트에서 최적화 노력(실행 시간과 메모리)은 보통 알고리즘 측면에 집중됩니다. 하지만 I/O 관련 작업을 최적화함으로써도 상당한 개선을 경험할 수 있습니다. 데이터 저장에 가장 일반적인 옵션은 CSV이지만, 이는 시간과 저장 효율이 매우 낮습니다. 개선하는 방법에 대해 알아보겠습니다. CSV 외에도 DataFrame을 저장할 수 있는 다양한 다른 옵션이 있습니다. 따라서 데이터 파이프라인을 최적화하기 위해 다음 매개변수에 대한 성능을 비교하는 것이 유용할 수 있습니다: 디스크에서 차지하는 공간 읽기 및 쓰기 실행 시간 이 실험을 위해, 다음과 같은 가상의 데이터를 생성했습니다: 100만 행 20개의 열 사례 1: 숫자 열만 포함된 경우. ...
-
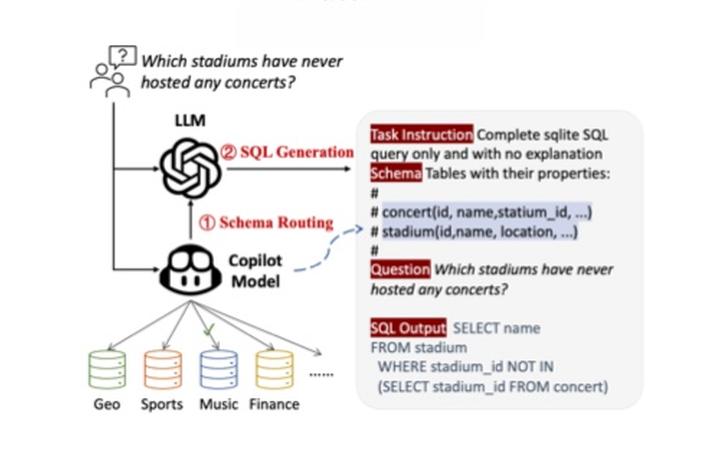
- DBCopilot: Scaling Natural Language Querying to Massive Databases 논문 리뷰
- 최근 사내 Data Warehouse 를 기반으로 Text2SQL 챗봇을 구현하고 있습니다. SNS 눈팅 중에 지인분이 공유해주신 논문내용이 지금 고민하고 있는 주제와 동일하여 읽어보고 리뷰를 해보고자 합니다. 논문에서는 Text2SQL 용어와 NL2SQL 이라는 용어를 혼용하여 있으며, 구현에 활용된 LLM 은 gpt-3.5-turbo-16k-0613 입니다. 논문의 내용을 개인적인 견해를 섞어서 아래와 같이 의역해보았습니다. 논문 : https://arxiv.org/pdf/2312.03463v2 DBCopilot: Scaling Natural Language Querying to Massive Databases ABSTRACT DB Copilot 프레임워크는 ...
-
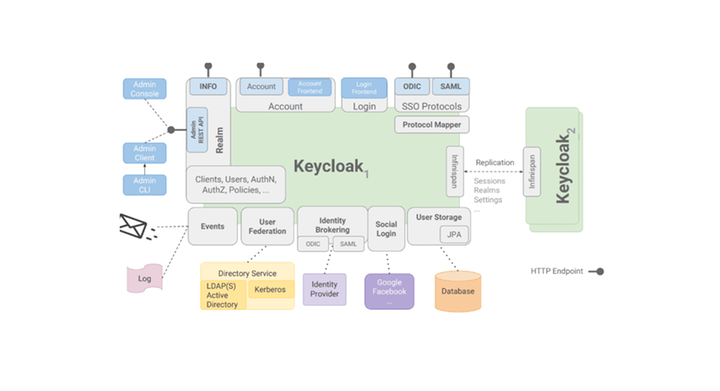
- AWS 에서 Keycloak 기반 서비스 인증 체계 구축 하기 (1편) - 키클록(Keycloak) 이란?
- Keycloak은 Open Source 기반의 IAM(Identity and Access Management) 소프트웨어로 사용자에 대한 인증(Authentication)과 인가(Authorization) 관리기능을 국제 인증/인가 표준 프로토콜(OIDC, SAML, OAuth 2.0 등) 기반으로 제공합니다. Keycloak 아키텍처 Keycloak 은 인증 및 인가 표준 프로토콜을 지원할 수 있고, 유연한 아키텍처를 가지고 있습니다. 주요 특징 Redhat/Jboss에서 공개한 Open Source Software 국제 인증/인가 표준 프로토콜 기반 SSO(Signle-Sign-On) 지원 (OpenID Connect, SAML, OAuth 등) 인증/인가 처...
-

- MacOS 에서 Minikube 로 Kubernetes 입문하기
- 맥에서 minikube 를 기반으로 쿠버네티스 실습환경을 구축하는 방법에 대해 살펴보겠습니다. Minikube 란 무엇인가? Minikube 는 Mini + kube 의 합성어로 쿠버네티스 클러스터 구축을 매우 간단하게 할 수 있도록 만들어주기 위해서 시작된 프로젝트 입니다. 보통 클러스터를 구성해야하는 플랫폼들은 개발자가 개인 PC 에 실습환경을 구성하는 것이 매우 번거로울 수 있는데, 쿠버네티스 또한 마찬가지로 클러스터를 구성하기 위한 여러가지 방법이 있지만 minikube 를 활용하면 매우 간편히 개인 PC 에 쿠버네티스 환경을 구성할 수 있습니다. 설치 minikube 를 설치하기 위해서는 2개의CPU, 2GB 의 메모리, 20GB 의 디스크 공간 등을 요...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.