
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
비디오 기반 광고 컨텐츠 및 Layout Generation - 연구계획(1)
- DEVOTEE 요약
- 안녕하세요! 저희는 SKT AI Fellowship 6기의 T1 VAKER 팀으로, AI를 이용해 비디오 광고 컨텐츠와 레이아웃을 자동으로 생성하는 연구를 진행 중입니다. 주 연구는 Dynamic Layout Generation과 Background Video Generation으로 나뉘며, 광고 영상의 역동적인 레이아웃과 현실감 있는 배경 영상을 만드는 것이 목표입니다. 앞으로도 연구 진행 상황을 공유할 예정이니 많은 관심 부탁드립니다.
안녕하세요~~~ SKT AI Fellowship 6기에서, Media GenAI 팀과 함께 비디오 기반 광고 컨텐츠 및 Layout Generation을 풀어나갈 T1 VAKER 팀입니다🚀🚀🚀!!
저는 이번 포스트를 맡은 김지환입니다!
저희 팀의 이름은 skT와 함께 최고🥇가 될, Video mAKER 라는 뜻을 담고 있어요 😚
먼저 저희의 간략한 소개를 드릴게요!
저희 팀은 모두 같은 과 동기들로 뭉쳐 최고의 팀워크를 자랑할 예정이랍니다 😉
1. 연구 과제 소개
비디오 기반 광고 컨텐츠 및 Layout Generation. 대체 뭘 하려는 걸까요?
우리의 궁극적인 목표🚀는 다음과 같습니다.
🚀 : “광고하고자 하는 상품과 내용이 있을 때, AI로 광고 영상을 만들자”
생각해보면 광고 시장은 우리 삶에서 평생 사라지지 않을텐데, 광고 촬영에는 천문학적인 비용💰(모델, 감독, 촬영 장비, 편집 등…🤯)이 들게 됩니다. AI로 광고 제작을 자동화 한다? 매우 자연스럽고 간단한 생각이지만, 기업에서는 AI 광고 솔루션을 개발하는 것이 경쟁력 측면에서 매우 중요한 문제일 수 있습니다.
특히 최근 몇 년간 Diffusion model을 중심으로 이미지와 비디오 생성 성능이 크게 향상됐다보니, 요즘 AI로 만든 광고 포스터나 영상이 눈에 띄기 시작하더라구요. 다행인건, 아직 성능이 좋아보이지는 않아요 😂
우리의 광고 제작 파이프라인은 크게 두 가지 단계로 나뉩니다.
첫째, LLM 기반 광고 개요(콘티) 생성
둘째, Diffusion 기반 영상 레이아웃 및 배경 영상 생성
이 중에서 저희 팀이 맡은 건 두 번째 단계입니다! Diffusion model을 활용해 영상의 레이아웃과 배경 영상을 생성하는 거죠. 그럼 두 번째 단계를 또 두 가지로 나눌 수 있겠죠?
1️⃣ Dynamic Layout Generation
2️⃣ Background Video Generation
각각에 대해 좀 더 자세히 알아보죠!
1.1. Dynamic Layout Generation
레이아웃 생성(Layout Generation)이란, 화면 안의 다양한 요소(제목, 텍스트, 이미지, 비디오, 도형 등)들을 어디에, 어떤 크기로 배치할 것인지를 결정하는 것을 말합니다. 보통 웹이나 앱, 포스터, 문서 디자인에서 많이 사용되죠.
Image source: Lin et al., LayoutPrompter: Awaken the Design Ability of Large Language Models, NeurIPS, 2023.
하지만 저희는 광고 "영상"에 사용할 레이아웃을 만들어야 해요. 각 요소들이 적절한 곳에 위치되는 것 뿐 아니라, 시청자들의 눈길을 사로잡을 수 있게 역동적인 움직임을 만들어야 하죠. 사전 연구는 고사하고 데이터도 전혀 없기 때문에, 굉~~~장히 험난한 여정이 예상됩니다..🧐
저희는 이 문제를 “Dynamic Layout Generation”이라고 정의했습니다. 저희가 누구보다 먼저 정의하고, 풀어보려는 문제인 만큼, 달에 처음 깃발을 꽂는 심정으로 출발해보겠습니다! 🚀
1.2. Background Video Generation
비디오 생성(Video Generation)은 요즘 매우 유명하죠! OpenAI의 SORA부터, Google DeepMind의 veo, 이번 주에 공개된 KWAI의 KLING, Luma의 Dream Machine까지.. 원래 비디오 생성을 연구하고 있는 저로서는 최신 연구를 팔로업 하기도 힘들만큼 빠른 속도로 발전하고 있는데요 🔥
광고 배경 영상을 생성해야 한다면, 가장 중요한 것은 영상의 1) reality와 2) length라고 생각해요. 생성된 영상이 AI로 만든 티가 심하게 나거나 너무 짧게 끊긴다면, 보는 사람들로 하여금 거부감을 불러일으킬 수 있으니까요.
2. 연구 계획
다음은 연구의 (아주) 대략적인 계획이에요. 현재로서 저희는 Dynamic Layout Generation에 더 큰 비중을 두고 있어요. 아무래도 우리가 처음으로 정의한 문제이다보니, 훨씬 많은 시간이 필요할거에요. 레이아웃 생성이 잘 마무리되면, Background Video Generation으로 넘어갈 생각이에요.
2.1. Dynamic Layout Generation
우리는 레이아웃에 역동성(dynamic)을 불어넣어야 해요. 정적인(static) 데이터에 time-series 특성을 부여하는 거죠. 이는 마치 이미지(static) 생성에서 비디오(dynamic) 생성으로 넘어오는 것과 동일하다고 볼 수 있어요. 이미지를 시간 순서로 나열한게 비디오기 때문이죠!
그럼 이미지와 비디오 생성의 차이점을 알아볼까요? 이미지 생성 기술이 비디오 생성으로 발전될 때, 이미지에 “시간 축”을 추가하는 방법을 사용했어요. 딥러닝에서 이미지는 높이, 너비, 채널 축을 가지고 있는 3차원 텐서로 표현돼요. 그렇다면 비디오는? 이미지의 시간적 나열이니까, 시간, 높이, 너비, 채널 축을 가지고 있는 4차원 텐서로 표현할 수 있죠. 그것 말고는 완전히 동일해요. 딥러닝 모델 입장에서 이미지 생성과 비디오 생성은, 생성할 텐서의 차원 수의 차이 뿐이기 때문에, 학습과 데이터 수집이 조금 (많이) 어렵다는 것 빼고는 동일해요 😝
저희는 이 흐름에서 영감을 받아, dynamic layout을 “시간 축이 추가된” layout으로 생각하기로 했어요. 조금 더 자세히 말하자면, static layout generation 모델을 학습하고, 이 모델에 temporal layer를 추가하여 학습할 생각이에요. 자세한건 다음 포스트에서 다룰게요!
2.2. Background Video Generation
위에서 광고 배경 영상의 핵심은 1) reality와 2) length라고 했습니다. 하지만 먼저 reality는 현실적으로 해결이 어려울 수 있어요. (reality가 높은 비디오 foundation 모델을 만드려면 연구비가 10000배는 필요할거에요..🤯) 하지만 우리는 오픈소스를 활용할 수 있어요! 이 정도 발전 속도라면 두 달 정도만 기다려도 훨씬 좋은 오픈소스 모델이 나올거에요. 또 다른 문제는 length입니다. 현재 가용 가능한 비디오 모델들은 대부분 1~3초 짜리 짧은 클립을 만들 뿐이에요. 영상의 길이가 길어질수록 필요한 GPU VRAM이 기하급수적으로 증가하기 때문이죠.
기습 홍보를 하자면, 제 최근 연구인 FIFO-Diffusion을 활용하면 추가적인 학습 없이도 무한히 긴 비디오를 만들수 있어서 이 문제를 해결 할 수 있어요 😙😉 저희는 이 FIFO-Diffusion과 오픈 소스 비디오 생성 모델을 활용해서 광고 배경 비디오를 생성할 계획입니다.
A video generated by FIFO-Diffusion with a prompt "An astronaut floating in space, high quality, 4K resolution."
3. 마치며
이번 포스트에서는 저희 연구 과제에 대한 소개와, 대략적인 연구계획에 대해서 다뤄봤습니다!
저희의 생각과 고민이 잘 전달됐으면 좋겠네요 😆
다음 포스트에서는 진행된 연구의 결과에 대해 다뤄볼게요! 긴 글 읽어주셔서 감사합니다 🥰
연하연상 님의 최신 블로그
더보기-
- 비디오 기반 광고 컨텐츠 및 Layout Generation - 연구과정(2)
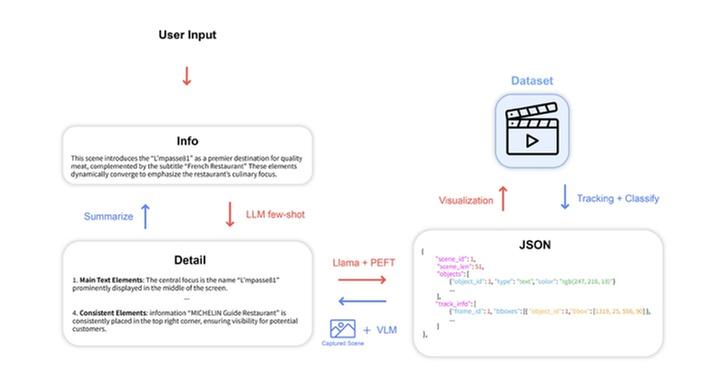
- 안녕하세요, SKT AI Fellowship 6기로 'C11: AI 기반 광고 컨텐츠 생성 및 Layout Generation' 을 주제로 연구 중인 t1vaker 팀 신연상 입니다. 어느덧 세 달이 지나 중간 발표도 무사히 끝이 났네요. 본 글에서는 저희 팀이 지금까지 어떤 과제를 어떻게 해결해 나가고 있는지, 그리고 받은 피드백을 바탕으로 앞으로 남은 Fellowship 기간 동안 어떤 계획을 세우고 있는지에 대해 정리해보았습니다. (DEVOCEAN 파일 용량 제한 및 비디오 업로드 불가로, 많은 자료가 사진으로 대체되었습니다.) 1. 과제 개요 혹시 이런 TV 광고를 보신 적 있으신가요? 저는 택시 뒷자리에서 본 기억이 있네요! 현재 SK 브로드밴드에서는 '...
-
- 비디오 기반 광고 컨텐츠 및 Layout Generation - 연구계획(1)
- 안녕하세요~~~ SKT AI Fellowship 6기에서, Media GenAI 팀과 함께 비디오 기반 광고 컨텐츠 및 Layout Generation을 풀어나갈 T1 VAKER 팀입니다🚀🚀🚀!! 저는 이번 포스트를 맡은 김지환입니다! 저희 팀의 이름은 skT와 함께 최고🥇가 될, Video mAKER 라는 뜻을 담고 있어요 😚 먼저 저희의 간략한 소개를 드릴게요! 저희 팀은 모두 같은 과 동기들로 뭉쳐 최고의 팀워크를 자랑할 예정이랍니다 😉 1. 연구 과제 소개 비디오 기반 광고 컨텐츠 및 Layout Generation. 대체 뭘 하려는 걸까요? 우리의 궁극적인 목표🚀는 다음과 같습니다. 🚀 : “광고하고자 하는 상품과 내용이 있을 때, AI로 ...
DEVOTEE 추천 블로그
-
- VPP를 위한 Object Insertion 기술 연구 - 연구계획(1)
- 안녕하세요! 저희는 SKT AI Fellowship 6기 10번 과제 VPP를 위한 Object Insertion 기술 연구 를 진행할 '인서트(INserT)' 팀입니다. 저희 인서트 팀은 문승기, 이정은, 이창엽으로 구성되어 있고, 저는 앞으로 5개월 간 데보션에 연구 과정을 기록할 이창엽입니다! 반갑습니다! 🫡 본론에 들어가기에 앞서, 저희 팀의 이름이 왜 인서트인지 궁금하지 않으신가요? 연구 주제가 Object Insertion이기도 하고, 저희 팀원 모두 MBTI가 INTx로 구성되어 있기 때문에 팀명을 인서트(INserT)로 정하였습니다! 😃 그럼 지금부터 연구 과제를 소개하고, 저희가 제안한 연구 방향은 어떤 것인지 말씀드리겠습니다! 1. 연구 과제...
-
- 이미지 기반 광고 컨텐츠 Layout Generation - 연구계획(1)
- 안녕하세요! SKT AI Fellowship 6기로 활동하게 된 엔팁과 아이들😺 팀입니다. 저희 팀은 C-10번 과제인 〈이미지 기반 광고 컨텐츠 Layout Generation〉 연구를 진행하고 있습니다. 이번 글에서는 저희 과제에 대한 설명과 더불어, 앞으로의 연구 계획에 대해 설명드리고자 합니다. 1. 주제 소개 저희는 Layout Generation을 중심으로, 이미지 기반 광고 컨텐츠 생성의 전반적인 부분을 다루고 있습니다. 자세한 설명에 앞서, 먼저 저희가 일차적으로 목표하고 있는 결과물을 보여드리겠습니다. 위의 이미지는 실제로 T딜에서 MMS 마케팅 서비스에 활용한 광고 이미지인데요. 이 이미지는 디자이너가 직접 적절한 위치에 상품 이미지를 배치하고...
-
- VPP를 위한 Object Insertion 기술 연구 - 연구과정(2)
- 안녕하세요! 저희는 SKT AI Fellowship 6기 C12 과제 VPP를 위한 Object Insertion 기술 연구를 진행하고 있는 인서트(INserT) 팀입니다. 이번 기록에서는 저희가 지난 6월부터 현재까지 어떤 연구를 진행하였고, 남은 기간 동안 어떠한 연구를 계획하고 있는지에 대해 공유해 드리겠습니다. 1. 연구 과제 소개 VPP (Virtual Product Placement) Virtual Product Placement (가상 상품 배치) 의 줄임말인 VPP는 제품, 간판 또는 비디오 형태의 디지털 콘텐츠에 특정 브랜드의 제품을 동적으로 삽입하는 기술입니다. PPL (Product PLacement)은 많이 들어보셨을 텐데요, PPL은 촬영 ...
-
- 비디오 기반 광고 컨텐츠 및 Layout Generation - 연구과정(2)
- 안녕하세요, SKT AI Fellowship 6기로 'C11: AI 기반 광고 컨텐츠 생성 및 Layout Generation' 을 주제로 연구 중인 t1vaker 팀 신연상 입니다. 어느덧 세 달이 지나 중간 발표도 무사히 끝이 났네요. 본 글에서는 저희 팀이 지금까지 어떤 과제를 어떻게 해결해 나가고 있는지, 그리고 받은 피드백을 바탕으로 앞으로 남은 Fellowship 기간 동안 어떤 계획을 세우고 있는지에 대해 정리해보았습니다. (DEVOCEAN 파일 용량 제한 및 비디오 업로드 불가로, 많은 자료가 사진으로 대체되었습니다.) 1. 과제 개요 혹시 이런 TV 광고를 보신 적 있으신가요? 저는 택시 뒷자리에서 본 기억이 있네요! 현재 SK 브로드밴드에서는 '...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.