
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구계획(1)
- DEVOTEE 요약
- 안녕하세요! 저희는 SKT AI Fellowship 6기에서 AI와 블록체인을 결합한 데이터 분석 자동화 과제를 수행하게 된 고스체인 팀입니다. 5개월 동안 온체인 데이터를 분석하고 생성형 AI를 통해 자동화된 데이터 인텔리전스를 실현하는 것이 목표입니다. 이를 위해 LLM, Text2SQL, Feature Store 등의 기술을 활용하고, 블록체인 기술과 AI를 접목하여 새로운 비즈니스 가치를 창출하겠습니다.
안녕하세요!
이렇게 DEVOCEAN을 통해 인사드릴 수 있게 되어 너무나 영광입니다. 저희는 SKT AI Fellowship 6기에서
AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현
과제를 맡게 된 고스체인 팀 고정현, 박경윤, 이동훈입니다.
앞으로 5개월 간 펠로우십의 여정을 Devocean에 기록하게 되었습니다. 잘 부탁드립니다 (야호) 😊
1. Prologue
LLM과 같은 생성형 AI와 블록체인에 기반한 web 3.0 패러다임이 퍼지고 있는 시기입니다.
이렇게 빠르게 변화하는 상황 속에서 데이터 분석 역시 근본적인 변화가 일어날 것으로 예상되고, 이에 발빠르게 대응할 필요가 커지고 있습니다.
더불어 생성형 AI를 데이터 분석과 결합하게 되면 참신한 분석 방법을 제시하는 등 그 임팩트가 상당할 것입니다.
따라서 저희 고스체인 팀은 온체인 데이터에 특화된 데이터 분석 인텔리젼스를 실현하는 것을 목표로 펠로우쉽 과제를 진행합니다.
그렇다면, 여기서 온체인 데이터는 무엇이고 또 분석 인텔리젼스를 실현하겠다는 것은 어떤 의미일까요? 결론부터 말씀드리면,
온체인 데이터 : 블록체인 상에 올라가고 생성되는 모든 데이터
분석 인텔리젼스 실현 : 데이터 분석에 생성형 AI를 도입해 분석가 및 마케터의 분석 프로세스를 자동화하고, 새로운 분석 방법(Feature store 구축 등)을 제안하는 LLM을 구축
바로 이해되는 분도 계시고, 설명이 조금 더 궁금한 분들도 계실 것 같습니다. 따라서, 이번 글은 다음과 같은 순서로 구성하였습니다.
우선 관련 도메인에 대해 간략히 소개 후, 본 과제를 수행함으로써 얻는 가치와 기대 효과를 말씀드리려 합니다.
이후 본 과제를 수행하는데 사용 예정인 기술을 검토하고, 과제 수행 계획을 말씀드리도록 하겠습니다.
2. Preliminaries
Web 3.0
온체인 데이터를 담고 있는 블록체인은 web3.0과 뗼레야 뗄 수 없는 관계입니다. 그런 의미로 대부분 잘 아실 테지만, web의 발전 흐름을 다시 한번 짚어보려 합니다.
과거에 처음 인터넷을 사용할 때를 Web 1.0 시대로 볼 수 있습니다. 이때는 정보를 직접 기록할 수 있는 소수들이 인터넷에 정보를 저장/배포하게 되면,
몇몇 사용자들이 해당 정보에 접근하고 읽을 수만 있던 상태입니다.
후에 21세기가 들어 SNS가 발전하고, 사용자 들 간 상호작용을 할 수 있도록 웹 페이지의 구조가 바뀐 것이 Web2.0입니다.
1.0시대에 비해 사용자들이 웹 페이지에 정보도 기록하거나 올릴 수 있고, 사용자들 간 교류도 가능하게 됩니다.
그러나, 이때 역시 중심 관리하는 축(관리자)이 존재하여 소유하고 있는 웹을 관리할 권한을 갖고 있는 구조입니다.
현재 Web3.0에 이르러서는, 이러한 중앙집권화마저 무너트리는 탈중앙화(Decentralization)을 핵심으로 웹의 구조가 재편성되고 있습니다.
이는 사용자들이 단순히 정보 제작에 참여하는 것을 넘어서서, 각 사용자가 정보의 주체가 되는 것입니다. 즉 모든 참여자들이 동등한 권한을 가짐으로써
중앙집권적인 요소에 기대어 운영되는 시스템을 지양하고, 공동을 주장하는 것이지요.
(페이스북이 이름을 Meta로 바꾼 것도, 이러한 시대의 흐름에 발빠르게 대응하기 위한 생각을 담아내고 있다는 이야기도 있습니다.)
온체인 데이터
즉, 이러한 Web3.0의 사상을 잘 담아내고 있는 것이 블록체인입니다.
블록체인에 기반한 암호화폐들은 공동의 참여자들이 새롭게 발생한 거래 정보가 담긴 블록(Block)을 검증하는 작업 증명(PoW)를 하게 됩니다.
이는 복잡한 수학 문제를 풀어 해시 값을 찾아내는 과정인데, 만일 성공한다면 그 대가로 비트코인과 같은 암호화폐를 받게 되는 것입니다.
다시 말해, 구성원으로 참여하는 모든 노드(컴퓨터)가 동등한 권한을 갖고 블록체인에서 발생하는 모든 거래 내역에 빠짐없이 접근 및 검토할 수 있습니다.
이렇게 체인들 간에 다량의 데이터들이 발생하게 되고, 블록체인에 올라가 있는 모든 데이터를 ‘온체인 데이터’ 라고 일컫는 것입니다.
3. Goal of Fellowship – Data Intelligence
생성형 AI와 온체인 데이터의 결합
이렇게 블록체인에서 발생하는 온체인 데이터는 작업 참여자들의 행동 패턴, 흐름을 알 수 있는 중요한 정보 원천이 됩니다. 따라서 이 데이터를 분석하는 것은 매우 흥미롭고 중요한 일이 됩니다.
더군다나, 이더리움과 같은 2세대 이후 가상화폐는 스마트 계약(Smart Contract)를 통해 가상화폐를 단순히 화폐의 대용 수단이 아닌, 조건이 수반된 자동 거래를 구현하는 시스템까지 구축하게 되었습니다.
즉, 이러한 비정형 데이터들까지 온체인 데이터에 대량으로 쌓이고 있는 상황이므로, LLM과 같은 생성형 AI를 데이터 분석에 활용할 필요성이 점차 커지고 있습니다.
온체인 데이터는 Google Bigquery, Web3, Blockchair, Cryptoquant 등 여러 기관에서 수집할 수 있으며, 이더리움과 관련한 온체인 데이터 역시 제공하고 있습니다.
아래 화면은 실시간으로 올라오고 있는 이더리움의 거래 데이터를 모니터링할 수 있는 웹페이지(Etherscan)의 모습입니다. 이러한 데이터를 지속적으로 입수해
심도 깊은 분석을 자동화한다면 체인 내부의 변화와 흐름을 이해하고 미리 예측함으로써 새로운 비즈니스 밸류를 발빠르게 선점할 수 있게 됩니다.
과제 목표
따라서 저희 팀은 우선 이더리움 화폐를 대상의 온체인 데이터를 기반으로 분석 Intelligence를 실현할 것입니다. 일을 효과적으로 해결하기 위해 아래의 두 가지 문제로 쪼개었습니다.
온체인 데이터를 활용하여 부가가치를 생산하고자 하는 기업 내 여러 종사자들이 손쉽게 데이터에 접근할 수 있도록 Text2SQL LLM 구축
온체인 데이터 분석 주제 중 중요한 몇 개에 특화된 데이터 분석가들의 노하우와 블록체인 고유의 기술을 고려한 파생 변수 생성하는 Feature Store LLM 구축
두 Task 모두 기본적으로는 Llama2와 같은 공개된 pre-trained 모델을 저희의 태스크에 맞게 RAG와 QLoRA(Quantized Low rank adaptation) 방법 기반의 PEFT를 적절히 활용하게 됩니다.
Quantized된 기법을 도입하여 본래의 파인 튜닝 목적을 달성하면서도 경량화를 함께 추진해 보려 합니다.
사실 두 문제는 크게 하나의 문제이기도 한데, 과제를 효율적으로 해결하기 위해 두 부분으로 나누었다고 판단하면 되겠습니다.
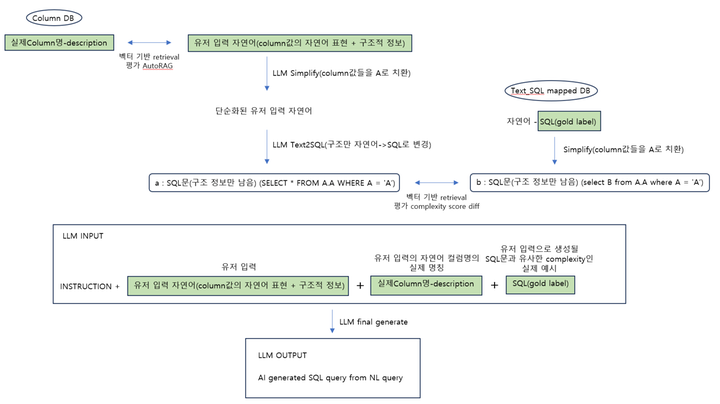
[Text2SQL을 위한 RAG]
Text2SQL의 경우 범용적인 데이터에 대한 선행 연구들이 어느 정도 진행되어 있으니 간략하게만 소개하겠습니다.
저희는 학교에 있는 GPU 계산 서버를 이용해 사전에 배포된 T2SQL용 파인 튜닝 모델들을 검토하였습니다. 프롬프트를 통해 어느 정도의 DB 스키마를 소화할 수 있는지를 사전 테스트를 진행한 결과,
대략적으로 5~10개의 테이블, 각 테이블당 10개 내외의 열들의 경우엔 Fine tuning을 잘 시킬 경우 비슷한 DB 도메인에 대해 적절한 SQL쿼리를 만드는 것을 확인하였습니다.
수천 개의 테이블과 테이블 당 수백~수천 개의 열이 있는 DB 구조에서 분석가가 원하는 데이터를 뽑아줄 때는 모든 스키마를 다 알려줄 필요는 없으므로,
RAG로 DB구조를 프롬프트에 가져오는 과정에서 아래의 검색 알고리즘 기반을 이용해 DB스키마를 축소해서 가져오게 하는 것이 저희 팀의 아이디어입니다.
Table 정보를 뽑을 경우에는 Semantic search를, columns을 불러올 땐 Lexical Search 혹은 둘을 결합한 hybrid search 계열로 벡터 DB에 임베딩된 요소를 가져올 것입니다.
이렇게 되면 LLM이 감당할 수 있는 양의 DB 스키마만 선택적으로 뽑아 프롬프트에 넣어줄 수 있으므로, 대량의 테이블에서도 성공적으로 쿼리를 만들 수 있을 것이라 판단해 구현 준비 중에 있습니다.
사진에선 테이블과 열 개수를 각각 5~10개로 제한하였으나, 향후 이 사이즈를 확대할 계획입니다.
[Feature Store for On-chain Data]
데이터 분석 인텔리전스 실현의 핵심은 분석을 자동화해 온체인 데이터 분석에 필요한 파생 변수를 생성해 내는 것입니다.
이를 위해 블록체인 기술의 중요한 점을 파악하고 있어야 하고, PEFT를 이용해 여러 문헌에서 제시한 파생 변수와 맥락을 학습하게 해야 합니다. 따라서 두 가지 요소를 짚어보겠습니다.
(1) 스마트 컨트랙트와 ERC-20
온체인 데이터를 LLM으로 적극 활용할 수 있게 하는 블록체인의 기술적 요소 중 하나로 스마트 컨트랙트를 꼽을 수 있습니다.
Preliminary 섹션에서 말했듯이 이더리움은 단순 가상 화폐를 나아가 자동으로 계약을 이행할 수 있게 설계가 되어 있습니다.
그러다 보니 스마트 컨트랙트를 분석하는 것도 온체인 데이터의 흐름을 감지하는 매우 중요한 요소 중 하나가 됩니다.
스마트 컨트랙트는 프로그래밍 언어 규약이 있는데, 이를 잘 문서화하여 정리한 것이 ERC-20입니다. ERC-20에서는 기본적으론 아래와 같은 형태로 계약 실행 문을 작성하라고 안내합니다.
아래는 ERC-20 규약하에서 프로그래밍을 하는 일부 부분을 발췌한 것입니다.
/**
 * @title ERC20Basic
 * @dev Simpler version of ERC20 interface
 * @dev see https://github.com/ethereum/EIPs/issues/179
 */
contract ERC20Basic {
  uint256 public totalSupply;
  function balanceOf(address who) public constant returns (uint256);
  function transfer(address to, uint256 value) public returns (bool);
  event Transfer(address indexed from, address indexed to, uint256 value);
}

/**
 * @title ERC20 interface
 * @dev see https://github.com/ethereum/EIPs/issues/20
 */
contract ERC20 is ERC20Basic {
  function allowance(address owner, address spender) public constant returns (uint256);
  function transferFrom(address from, address to, uint256 value) public returns (bool);
  function approve(address spender, uint256 value) public returns (bool);
  event Approval(address indexed owner, address indexed spender, uint256 value);
}
이런 프로그래밍 언어 기반으로 계약을 걸고 실행할 수 있게 되는데, 이 부분에 여러 취약점이 발생하고 있어 최근 Smart contract의 취약점을 미리 발견해 탐지하는 LLM 활용 연구들이 여럿 진행되고 있습니다.
따라서 Verified된 smart contract 데이터를 이용해 BERT 등의 Encoder 기반 LLM을 통해 학습을 시켜 이상 흐름을 조기에 감지하는 모델을 이용해
이상 계약 탐지 비율 등의 파생 변수를 제안할 수 있을 것입니다. 참고로 해당 데이터는 Geth-Json RPC, Etherscan 등을 통해 구축해 볼 수 있습니다.
(2) QLoRA
(Q)LoRA는 PEFT(Parameter Efficient Fine Tuning)의 방식 중 하나입니다. 여기서는 이론적인 설명을 주로 하였습니다.
LoRA는 어떻게 하면 파인 튜닝을 적절히 잘 할 수 있을까에 대한 해결 방안으로 2018년 Microsoft에서 나온 논문에서 제시된 방안입니다.
먼저, 기본적인 파인 튜닝을 할 때 목적이 되는 식은 다음과 같습니다.
입력이 되는 데이터 X와 이전 시점까지 주어진 y값들을 이용하여, 그 이후의 y값을 가장 잘 예측하는 파라미터를 MLE(Maximum Likelihood Estimation)를 통해 계산하려는 것이 위 식의 목적입니다.
딥러닝 모델에서는 이러한 파라미터를 경사 하강법(Gradient Descent)을 통해서 찾아나가게 될 텐데,
LLM 모델의 파라미터수가 지속적으로 증가함에 따라 포워드와 백워드 계산을 처리함에도 많은 자원이 필요하게 되었습니다.
LoRA의 저자들은 파라미터를 매우 많이 가지는 모델들이 실제로는 더 낮은 내재적 차원에 존재한다는 논문들에 영감을 받아,
더 작은 수의 파라미터만 업데이트해도 충분할 것이라는 생각을 했습니다. 이를 반영한 식은 다음과 같습니다.
위의 식에서 Θ에 해당하는 파라미터 수는 이전 식에서 Φ에 해당하는 파라미터 수보다 작습니다.
그리고 이미 훈련된 가중치가 Φ_0에 해당하고, 추가로 업데이트 된 가중치인 ΔΦ를 Θ에 저장합니다. 이렇게 하면 더 적은 자원을 가지고 효율적인 파인 튜닝이 가능하게 됩니다.
한편, QLoRA에서는 LoRA에 양자화된 모델을 결합시키는 방법을 소개하고 있습니다.
기존에 학습된 모델의 가중치들을 4비트로 양자화하여, 매우 경량화한 모델에 LoRA를 적용하고 있습니다. 이렇게 경량화한 QLoRA 모델은 65B 모델도 48GB의 단일 GPU에서 학습시킬 수 있습니다.
4비트로 양자화한다면 표현 가능한 가중치의 종류가 매우 줄어들텐데, 이러한 모델이 기존 모델의 정확도를 어떻게 확보하는지에 대해 궁금증이 있을 것입니다.
QLoRA에서는 깊고 큰 모델은 파라미터의 중복성으로 인해 양자화 하더라도 모델 전체의 성능을 유지할 수 있다는 사실과,
양자화 하기 전 가중치의 분포를 반영하도록 양자화하는 등의 기법을 통해 이를 해결하였습니다.
또한, 양자화한 모델을 파인 튜닝하여 가중치를 업데이트한다면, 오차로 인해 성능이 크게 무너질 수 있습니다.
양자화하지 않은 LoRA와 결합한다면, 이런 우려 없이 양자화로 인해 손실된 정보를 보상하도록 학습되어 경량화된 파인 튜닝이라는 목적을 달성할 수 있습니다.
이렇게 QLoRA를 통한 PEFT를 Text2SQL과 파생 변수 생성을 위한 LLM 제작에 사용할 예정입니다. Text2SQL은 자연어 질의와 그에 대응하는 SQL쿼리 문 데이터 셋을 사용할 것이며
독해 데이터 셋은 다음과 같이 두 가지 방안으로 구축하여 LLM에서 주로 문제되는 할루시네이션을 방지하면서도 창의적인 파생 변수를 제안할 수 있도록 설계하였습니다.
실제로 만들 수 있는 예시는 다음과 같습니다. 아래의 경우는 논문 "Oracle Counterpoint: Relationships between On-chain and Off-chain Market Data"을 이용해 구축한 데이터셋 예시입니다.
4. Blueprint
PEFT의 적용 방안에 대한 설명을 마치며, 이렇게 앞으로 5개월간 대략적인 연구 계획과 과제에 대한 소개를 마무리하였습니다.
향후 일정을 간략히 말씀드리면, 매주 멘토님과의 오프라인 미팅을 가지며
6월에는 온체인 데이터와 AI기술 지식 향상을 목표로 fellow간 스터디를 진행하며 LLM 모델 학습에 필요한 데이터 생성을 완료할 예정입니다.
7월부터 본격적으로 기술을 개발하여 전체 파이프라인을 구현하도록 하고, 8월부터 성능을 관찰하며 evaluation 및 개선을 집중적으로 수행할 계획입니다.
블록체인과 AI는 앞으로 미래를 주도할 주요 기술입니다. 두 기술 분야를 접목해 탄생하는 새로운 기술은 무궁무진하게 많을 것입니다!
이 두 분야의 최고 전문 지식과 경험을 지니신 멘토님들과의 본 과제를 수행할 수 있게 된 것은 정말 큰 행운입니다 😁
협력을 통해 저희 팀 모두가 이 분야의 선구자가 되고자 하는 목표, 새로운 비즈니스 가치를 창출한다는 목표를 마음 속에 품고
자부심 한가득으로 본 fellowship 과제를 성공적으로 마무리하겠습니다.
고스체인 팀 화이팅!!
5. References
Yang, Zhimeng; Klages-Mundt, Ariah; Gudgeon, Lewis. "Oracle Counterpoint: Relationships between On-chain and Off-chain Market Data."
Edward Hu, Yelong Shen, Yuanzhi Li, Shean Wang, Phillip Wallis, Lu Wang, Zeyuan Allen-Zhu, Weizhu Chen, "LORA: Low-Rank Adaptation of Large Language Models".
Tim Dettmers, Artidoro Pagnoni, Ari Holtzman, Luke Zettlemoyer, "QLORA: Efficient Finetuning of Quantized LLMs".
커넥팅랩, 블록체인 트렌드 2022- 2023
smart contract code, https://etherscan.io/token/0x0f71b8de197a1c84d31de0f1fa7926c365f052b3#code#L5
Lora tuning code, https://github.com/microsoft/LoRA
web3.0 삽화 https://dev.to/pragativerma18/evolution-of-web-42eh
kon7672 님의 최신 블로그
더보기-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구결과(3)
- 안녕하세요 😃 SKT AI Fellowship 6기 “AI 데이터분석가 도입을 통한 데이터 인텔리전스 실현” 과제를 수행한 고스체인 팀입니다. 지난 10월 31일 최종 발표를 마지막으로, 약 6개월간의 펠로우쉽 과제 수행을 마무리하였습니다. 펠로우 자격으로 데브오션에 글을 쓰는 마지막 시간이 되었습니다. 이번 글에선 저희 팀이 수행한 과제가 무엇인지, 어떠한 새로운 AI 기술을 만들었는지를 말씀드리고 그 결과와 기술 활용 사례를 공유드리려 합니다. 다만, 현재 글을 처음 게시하는 시점에서는 특허 출원과 논문 심사가 진행 중인 상황이라, 당장 현 시점에서 기술적 개발 부분, 성능 결과 관련한 내용들을 담아내지 못하게 된 점을 미리 양해의 말씀을 드리고자 합니다. ...
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구과정(2)
- 안녕하세요 😃 AI Fellowship 6기의 “AI 데이터분석가 도입을 통한 데이터 인텔리젼스 실현” 과제를 수행하고 있는 고스체인 팀입니다. 과제를 시작한 지 엊그제 같은데, 벌써 지난 주에 과제 진행에 대한 중간 발표까지 이루어졌습니다. 발표를 기점으로, 지금까지 진행한 내용들을 정리하고 피드백을 기반으로 향후 과제를 발전시킬 수 있는 기회를 가질 수 있었습니다. 이번 글에서는 저희가 중간 발표에서 진행했던 내용에 대해 소개드리고, 그에 대한 피드백과 향후 계획을 얘기하려 합니다. 1. 중간 발표 과제 소개 지난 글에서 소개하였듯, 저희 과제의 목표는 LLM을 이용해 데이터 분석을 자동화하는 기술을 만드는 것입니다. 데이터 분석 프로세스에서 LLM을 통해 ...
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구계획(1)
- 안녕하세요! 이렇게 DEVOCEAN을 통해 인사드릴 수 있게 되어 너무나 영광입니다. 저희는 SKT AI Fellowship 6기에서 AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 과제를 맡게 된 고스체인 팀 고정현, 박경윤, 이동훈입니다. 앞으로 5개월 간 펠로우십의 여정을 Devocean에 기록하게 되었습니다. 잘 부탁드립니다 (야호) 😊 1. Prologue LLM과 같은 생성형 AI와 블록체인에 기반한 web 3.0 패러다임이 퍼지고 있는 시기입니다. 이렇게 빠르게 변화하는 상황 속에서 데이터 분석 역시 근본적인 변화가 일어날 것으로 예상되고, 이에 발빠르게 대응할 필요가 커지고 있습니다. 더불어 생성형 AI를 데이터 분석과 결합하게 되...
DEVOTEE 추천 블로그
-
- RAG 및 LLM 파인튜닝을 통한 Text2SQL 모델 성능 개선 - 연구계획(1)
- 안녕하세요! 저희는 SKT AI Fellowship 6기 a-02번 과제를 맡은 skql(슼큐엘) 팀입니다! 이번 포스트를 통해 저희 팀의 연구 주제와 진행 방법에 관해 설명드리겠습니다! 1. 연구 과제 소개 1.1. 연구 목표/내용/배경 데이터분석에 관심이 많으신 분이라면 SQL을 한 번 쯤은 들어보셨을텐데요. SQL은 데이터베이스에서 자료를 처리하는 용도로 사용되는 구조적 데이터 질의 언어이고, SQL을 통해 사용자들은 데이터베이스에서 쉽게 자료를 찾거나 저장할 수 있습니다. 데이터 분석을 통해 인사이트를 발견하는 것부터, 파이프라인 개발이나 프로그래밍에 활용하는 등 다양한 곳에 데이터가 사용되면서 SQL의 중요성이 증가하고 있습니다. 이에 저희는 IDCube...
-
- VPP를 위한 Object Insertion 기술 연구 - 연구과정(2)
- 안녕하세요! 저희는 SKT AI Fellowship 6기 C12 과제 VPP를 위한 Object Insertion 기술 연구를 진행하고 있는 인서트(INserT) 팀입니다. 이번 기록에서는 저희가 지난 6월부터 현재까지 어떤 연구를 진행하였고, 남은 기간 동안 어떠한 연구를 계획하고 있는지에 대해 공유해 드리겠습니다. 1. 연구 과제 소개 VPP (Virtual Product Placement) Virtual Product Placement (가상 상품 배치) 의 줄임말인 VPP는 제품, 간판 또는 비디오 형태의 디지털 콘텐츠에 특정 브랜드의 제품을 동적으로 삽입하는 기술입니다. PPL (Product PLacement)은 많이 들어보셨을 텐데요, PPL은 촬영 ...
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구과정(2)
- 안녕하세요 😃 AI Fellowship 6기의 “AI 데이터분석가 도입을 통한 데이터 인텔리젼스 실현” 과제를 수행하고 있는 고스체인 팀입니다. 과제를 시작한 지 엊그제 같은데, 벌써 지난 주에 과제 진행에 대한 중간 발표까지 이루어졌습니다. 발표를 기점으로, 지금까지 진행한 내용들을 정리하고 피드백을 기반으로 향후 과제를 발전시킬 수 있는 기회를 가질 수 있었습니다. 이번 글에서는 저희가 중간 발표에서 진행했던 내용에 대해 소개드리고, 그에 대한 피드백과 향후 계획을 얘기하려 합니다. 1. 중간 발표 과제 소개 지난 글에서 소개하였듯, 저희 과제의 목표는 LLM을 이용해 데이터 분석을 자동화하는 기술을 만드는 것입니다. 데이터 분석 프로세스에서 LLM을 통해 ...
-
- AI 데이터 분석가 도입을 통한 자동화된 데이터 인텔리전스 구현 - 연구결과(3)
- 안녕하세요 😃 SKT AI Fellowship 6기 “AI 데이터분석가 도입을 통한 데이터 인텔리전스 실현” 과제를 수행한 고스체인 팀입니다. 지난 10월 31일 최종 발표를 마지막으로, 약 6개월간의 펠로우쉽 과제 수행을 마무리하였습니다. 펠로우 자격으로 데브오션에 글을 쓰는 마지막 시간이 되었습니다. 이번 글에선 저희 팀이 수행한 과제가 무엇인지, 어떠한 새로운 AI 기술을 만들었는지를 말씀드리고 그 결과와 기술 활용 사례를 공유드리려 합니다. 다만, 현재 글을 처음 게시하는 시점에서는 특허 출원과 논문 심사가 진행 중인 상황이라, 당장 현 시점에서 기술적 개발 부분, 성능 결과 관련한 내용들을 담아내지 못하게 된 점을 미리 양해의 말씀을 드리고자 합니다. ...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.