
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
LLM Performance Evaluation - 연구계획(1)
- DEVOTEE 요약
- ttf 팀은 SKT AI Fellowship 6기에서 LLM 성능 평가 과제를 맡고 있으며, 기존의 평가 방법인 Question-Answering Evaluation을 뛰어넘는 LLM 기반 평가 구조를 제시하려 합니다. 이를 위해 도메인 및 기능별 전문가 모델을 활용하며, 최종 답변을 선정하는 과정에서 Ensemble Refinement와 Peer Discussion 기법을 도입합니다. 최종 목표는 평가의 정확성과 효율성을 높여 LLM의 성능을 종합적으로 평가하는 것입니다.
안녕하세요! 저희는 SKT AI Fellowship 6기에서 LLM Performance Evaluation 과제를 맡게 된 ttf 팀입니다! ☺️
ttf? 글을 쓸 때 꼭 필요한 폰트 확장자처럼 Fellowship에서 꼭 필요한 팀이 되겠다는 의미입니다! 🌱
이번 포스트에서는 연구 과제 소개 및 계획을 소개드립니다.
1. 개요
대규모 언어 모델(LLM, Large Language Model)은 현대 인공지능 기술의 정점에 있는 혁신적인 도구죠! 최근 몇 년간 AI 연구에서 LLM은 그 중요성과 영향력이 크게 증가하면서 많은 주목을 받고 있습니다.
ChatGPT, Claude, Gemini, BLOOM, LLaMA 등과 같은 LLM들은 시간이 지날 수록 성능이 높아질 뿐만 아니라 적용 분야에 따라 그 개수도 점점 증가하고 있는데요! 😃
이렇게 많고 많은 LLM들 중에 어떤 모델이 성능이 어떤 부분에서 좋다고 할 수 있을까요? 답변의 정확도, 유창성, 일관성, 다양성, 창의성, 추론 속도, 윤리성, 적응성 등의 여러 기능을 어떻게 종합적으로 판단해 LLM의 최종 Performance를 평가할 수 있을까요?
기존에 쓰고 있던 벤치마크 쓰면 되는거 아닌가? 🤔
기존의 벤치마크는 모델의 성능이 향상되고 있는 현재에는 평가의 효과가 떨어집니다. 또한 공개 벤치마크의 경우에는 모델을 평가하는 유효기간이 점점 줄어들고 있습니다. 저희 팀은 이런 현 벤치마크의 문제점을 인식하고 기존의 Question-Answering Evaluation의 벤치마크를 벗어나 능동적으로 모델을 평가할 수 있는 LLM-based Evaluation 구조를 제시하고자 합니다!
Question-Answering Evaluation이랑 LLM-based Evaluation은 뭐가 다른 거지? 🤔
기존 벤치마크인 Question-Answering Evaluation을 전부 답을 적어도 전부 틀릴 수 있는 수동적인 객관식 시험이라고 한다면, 저희가 제시할 LLM-based Evaluation은 Mixture of Experts 기법을 이용한 Representative LLM Evaluator 전교 1등 의 Answer를 정답이라고 가정하고 LLM의 답변을 평가하는 능동적인 서술형 시험이라고 할 수 있습니다!
2. 전체 파이프라인
위 그림은 저희 팀이 제시한 전체 파이프라인입니다.
Mixture of LLM Experts의 Answer를 만들기 위해서 저희는 두 종류의 Expert를 선정합니다. 바로 Domain-specific Expert(이하 Domain Expert)와 Functional-specific Expert(이하 Functional Expert)입니다.
Domain Expert는 특정 도메인에 대한 질문의 배경지식을 제공해줄 수 있는 Expert입니다. 질문이 입력값으로 들어오면 질문과 가장 연관성이 높다고 생각되는 Domain Expert를 routing하는 방식으로 질문에 가장 잘 맞는 Domain Expert 하나를 선정합니다. 선정된 Domain Expert를 Top-1 Domain Expert라고 부릅니다. Domain으로는 의료, 교육, 법률, 금융 등 specific dataset으로 따로 학습이 필요한 분야들을 선정할 예정입니다.
Functional Expert는 선정된 Domain Expert가 실수할 수 있는 기능적인 부분에 대한 지식을 제공해줄 수 있는 Expert입니다. 주어진 질문에 대해 Domain Expert의 답변을 확인하고 Domain과 질문 모두를 고려해 응답에서 중요한 기능 평가 k개를 선정해 Domain Expert와 Peer Discussion을 수행할 수 있도록 합니다.
응답에서 중요한 기능 평가? 그게 뭐지? 🤔
LLM이 생성하는 텍스트들은 사실에 기반하여 정확한 정보를 제공할 의무가 있습니다. 사용자에게 안전하고 유익한 정보를 제공하기 위해 LLM의 기능 향상은 꼭 필요한 요소라고 할 수 있습니다.
[이미지 출처: https://www.hankookilbo.com/News/Read/A2023022215200000727]
예를 들어, ChatGPT의 초기 모델은 '조선왕조실록에 기록 된 세종대왕의 맥북프로 던짐 사건에 대해 알려줘' 라고 했을 때 말도 안되는 일을 실제로 있었던 일처럼 묘사하는 기괴한 답변을 내기도 했는데요. 이는 LLM의 Hallucination이 가득한 답변으로, 저희는 각 Domain마다 유의해서 평가해야 하는 기능들이 있다고 판단했습니다.
유의해서 평가해야 하는 기능들로는 윤리성(Ethics), 신뢰성(Trustworthiness), 환각(Hallucination) 등이 있습니다. 이러한 기능들은 각각 Ethics Expert, Trustworthiness Expert, Hallucination Expert로 학습되어 Functional Experts가 됩니다. 그리고 Functional Expert들은 Domain Expert와의 Peer Discussion을 통해 주어진 질문에 대한 최적의 답변을 도출합니다.
3. 보충 설명
이번 절은 전체 파이프라인에 대한 보충 설명을 담았습니다! 어떤 Foundation model을 이용할 것인지, 학습을 마친 Expert가 어떤 과정을 통해 최고의 답변을 도출하는지 더욱 자세히 설명 드리겠습니다.
3.1. Mistral 7B
[이미지 출처: https://medium.com/aimonks/is-mistral-7b-really-the-best-model-a-first-look-9dd39e11df74]
Expert로 사용하는 Foundation model은 Mistral 7B입니다. 사실 더 큰 모델을 Fine-tuning 하는 것이 효과적이지만, 현재 저희에게 주어진 사용 가능한 Resource들을 고려해서 7B 모델로 선정했습니다.
Mistral 7B는 이름대로 70억 개의 매개변수를 가지고 있습니다. 최신 트랜스포머(Transformer) 아키텍처를 기반으로 하는데, 입력 텍스트를 처리하고 출력 텍스트를 생성하는 데 매우 효율적입니다.
Mistral 7B는 Grouped Query Attention 기법을 활용하여 inference 속도를 높이며, Sliding Window Attention 기법을 활용하여 inference 비용을 줄이는 특징을 가지고 있습니다.
저희는 Ollama를 이용해 pre-trained Mistral 7B 모델을 불러와 각 Domain dataset이나 Functional Dataset에 대해서 Fine-tuning함으로써 더 구체적인 능력을 갖추게 할 예정입니다.
3.2. Chain of Thought
Chain of Thought(이하 CoT)는 모델이 문제의 응답을 생성하는 과정에서 생각을 말로 표현하도록 하거나 단계별 추론 과정을 따르도록 유도하는 방법론입니다. 보통 복잡한 이해를 요구하는 task에 주로 활용하는데요.
[이미지 출처: 논문 "Chain-of-Thought Prompting Elicits Reasoning in Large Language Models"]
위의 이미지를 보시면 이해가 쉬워집니다.
왼쪽의 Standard Prompting은 단순한 계산 문제인 Input Question에 대한 답변을 간단하게 답변만 내놓고 있는 반면, 오른쪽의 CoT Prompting은 모델의 추론 과정을 답변에 그대로 서술하도록 유도합니다. 모델의 답변을 보시면 처음 사과의 개수를 언급하고, 점심에 먹은 사과의 개수와 추가로 구입한 사과의 개수를 언급해가며 답변을 도출하는 걸 보실 수 있습니다.
저희 팀은 오른쪽의 Prompting처럼 Expert들이 CoT, 말 그대로 생각의 추론 과정을 답변에 그대로 도출하도록 만들어 3.3.절에서 설명할 Ensemble Refinement에 활용합니다.
CoT의 품질이 곧 응답의 품질과 연관되므로 Evaluation 과정에서는 CoT 내용의 장단점을 주로 평가합니다. 또한 CoT를 통해 생각의 흐름이 부자연스러운지를 동시에 평가하는 데에도 사용하기 때문에 Domain Expert의 성능을 끌어올리는 역할도 있습니다.
3.3. Ensemble Refinement
[이미지 출처: 논문 "Towards expert-level medical question answering with large language models"]
Ensemble Refinement는 Med-PaLM에서 사용한 기법으로 Self-consistency의 일반화된 응답을 생성하는 기법입니다.
일반적인 Ensemble Refinement의 진행 단계는 다음과 같습니다.
하나의 Language Model에 여러 번 반복해서 동일한 질문을 줌
Language Model이 생성한 응답과 CoT의 장단점을 고려하여 새로운 응답을 생성
2번 과정을 반복하며 최종 응답을 선정
저희 팀은 위 진행 단계의 3번을 조금 변형해서 최종적으로 하나의 응답을 선정하는 게 아닌, Top-k개의 응답을 선합니다. 그리고 이 다음 절에 이어질 Peer Discussion을 통해 Top-k개의 응답 중 Top-1, 즉 Mixture of Experts의 정답이라고 할 수 있는 응답을 생성합니다.
3.4. Peer Discussion
[이미지 출처: 논문 "PRD: Peer Rank and Discussion Improve Large Language Model based Evaluations"]
Ensemble Refinement를 통해 선정한 k개의 답변들을 놓고 Expert끼리(Domain Expert & Functional Experts) Peer Discussion을 수행합니다. 가장 좋은 응답을 정답으로 선정하는 과정입니다.
Peer Discussion이라는 말 그대로 여러 모델이 서로 다른 출력을 평가하고 피드백을 제공합니다. 여기서는 Expert끼리의 토론을 통해 각 답변을 수정하고 보완할 수 있으며, 이 과정에서 최종 선정될 답변의 퀄리티를 높입니다.
k개의 답변들 중에 Domain Expert가 평가하는 Domain Knowledge, Functional Expert가 평가하는 Functional Knowledge가 적절히, 고루 잡힌 단 하나의 답변만이 선정됩니다.
3.5. 답변 선정 기법이 2가지인 이유는? 🤔
3.3절과 3.4절은 둘 다 방식은 다르나 동일한 목적을 가진 답변 선정 기법입니다. 그런데 왜 둘 다 필요할까요?
대부분의 스포츠에서 예선과 본선을 나누어 경기를 진행하듯이 Ensemble Refinement로 N개의 응답 중에서 k개를 선정하는 예선을 진행하고, Peer Discussion으로 나머지 k개의 응답 중에서 최종 1개의 응답을 선정하는 본선을 진행한다고 생각해주시면 좋을 것 같습니다.
그럼, 왜 굳이 예선과 본선을 나누는 거지?
스포츠 경기에서 예선과 본선을 나누는 이유 중 하나는 경기의 수준을 유지하고 대회의 시간과 자원을 효율적으로 관리하기 위함입니다. 이는 어쩌면 저희 방법론의 이유와 비슷할지도 모르겠습니다. 바로 복잡성과 그에 따른 연산 효율성 때문입니다.
N개의 응답 중에 1개를 최종 선택하는 연산을 Peer Discussion 기법으로 생성한다고 가정해보겠습니다. N = 64라면, Expert들은 64개의 응답에 대한 각각의 Initial Review를 생성해야 합니다. 더욱이 거기서 끝나지 않고, 위 그림에 있는 것처럼 Discussion도 진행하게 되면 그에 따른 연산량과 대기 시간이 기하급수적으로 증가하게 됩니다. 하지만, 장점이 아예 없는 것은 아닙니다. Peer Discussion은 모델 간의 상호 토론과 수정 과정을 포함하지만 더 높은 정확성과 품질을 보증할 수 있다는 장점이 있습니다.
이번에는 반대로 N개의 응답 중에 1개를 최종 선택하는 연산을 Ensemble Refinement 기법으로 생성한다고 가정해보겠습니다. Peer Discussion에 비해 빠른 연산량으로 대기 시간을 거의 소모하지 않고 최종 답변을 내놓을 것입니다. 하지만 아시다시피 명백한 단점이 있죠. 비교적 단순한 알고리즘은 Peer Discussion보다 못한 정확성과 품질을 도출하게 됩니다.
저희는 두 가지 장점을 모두 수용하기 위해 N개의 답변 중에 k개를 선정할 때는 빠른 연산이 가능한 Ensemble Refinement를, k개의 답변 중에 최종 1개의 답변을 선정하기 위해서는 다소 느리나 정확한 Peer Discussion을 채용했습니다.
4. LLM 답변 비교
이제 거의 다 왔습니다! 😉 이전 단계들을 지나오며 우리가 획득한 세 가지를 소개해드리겠습니다. 🙌
입력값으로 주어진 질문
질문에 대한 Experts의 최종 답변 하나
평가해야할 LLM이 도출한 질문에 대한 답변 하나
LLM의 성능을 평가하기 위해서는 3번 답변이 질문에 대한 Experts의 최종 답변인 2번 답변에 얼마나 가까운지 평가한 점수를 내야합니다. 이 점수를 바탕으로 우리는 LLM끼리의 우열을 가릴 수 있습니다.
이 평가를 위한 여러 가지 방안 중에서 꼭 적용해볼, LLM을 이용한 Evaluation 방법론 2가지를 소개해드리겠습니다. 실제 실험에서는 이들 이외에도 여러 가지를 대입해 볼 생각입니다.
4.1. LM Evaluation Harness(Eleuther AI)
EleutherAI의 LM_Evaluation Harness는 다양한 작업에 대해 LLM을 평가할 수 있도록 설계된 프레임워크입니다. 동일한 입력과 작업에 대해서 다양한 언어 모델을 테스트할 수 있는 일관된 환경을 제공하고 다양한 프레임워크와 작동하도록 설계되어 있어서 사용하기에 편합니다. 꼭 사용해볼 평가 방법론 중 하나입니다.
이는 Hugging face에서 Open LLM Leaderboard 백엔드로도 활용 중인 방법입니다.
4.2. Evalverse
Evalverse는 Upstage AI에서 개발한 LLM 평가를 위한 통합된 라이브러리입니다. Slack을 통해 코딩 없이 평가 요청을 할 수 있는 기능을 제공하고, Report! 라는 명령어를 통해 완료된 평가의 종합적인 보고서를 받을 수도 있습니다. 사용자의 편의를 위한 서비스 기능들이 많아보여서 꽤 기대하고 있는 평가 방법 중 하나입니다.
5. 과제 수행 계획
다음은 저희 팀의 과제 수행 계획표입니다. 중간 리뷰 전까지 Top-1 Domain Expert와 Top-k Functional Experts의 Fine-tuning을 마치고, Ensemble Refinement와 Peer Discussion 코드 구현을 진행할 생각입니다.
중간 리뷰 이후로는 Mixture of Experts를 이용한 LLM Performance Evaluation 과제의 충분한 실험을 진행할 수 있을 것으로 예상하고 있습니다.
최종 발표 이후로는 위 연구를 논문으로 집필하여 Top-tier Conference에 제출하는 것을 목표로 하고 있습니다.
Bonus. 팀원 소개 👥
저희는 인하대학교 학부 동기이자 같은 동아리 소속 6년 지기 친구들로, 대학원까지 같은 전공으로 오게 되었습니다. 이번 SKT AI Fellowship을 통해 의미 있고 유익한 활동을 함께 해보고자 합니다.🏃🏻♂️
이상으로 ttf 팀의 연구 계획이었습니다! 긴 글 읽어주셔서 감사합니다! 🫶
멘토님들과 찍은 SKT타워 항공샷으로 마무리~🌝
Seongsoo_H 님의 최신 블로그
더보기-
- LLM Performance Evaluation - 연구결과(3)
- 안녕하세요! SKT AI Fellowship 6기에서 LLM Performance Evaluation 과제를 맡은 ttf 팀입니다! 이번 포스트에서는 최종 발표까지의 연구 결과가 어떻게 도출되었는지 공유해드리겠습니다! 1. 개요 최근 LLM 연구가 활발해지면서 기존 벤치마크들은 그 유효성이 줄어들고, 데이터셋의 단순성 때문에 모델의 다양한 능력을 평가하는 데 한계가 있습니다. 이에 저희 ttf 팀은 기존의 Question-Answering Evaluation의 벤치마크를 벗어나 능동적으로 모델을 평가할 수 있는 LLM-based Evaluation, 생성형 평가 모델을 제시하고자 합니다! 기존의 Question-Answering Evaluation과 LLM-bas...
-
- LLM Performance Evaluation - 연구과정(2)
- 안녕하세요! SKT AI Fellowship 6기에서 LLM Performance Evaluation 과제를 맡은 ttf 팀입니다! 😃 이번 포스트에서는 중간 발표를 마친 상태에서 어디까지 과제가 진행되었는지 짧게 공유 드리겠습니다! 1. 개요 이전과 같이 저희 팀은 평가의 효과가 떨어지는 기존의 벤치마크의 문제점을 인식하고, 기존의 Question-Answering Evaluation의 벤치마크를 벗어나 능동적으로 모델을 평가할 수 있는 LLM-based Evaluation 구조를 제시하고자 합니다! 기존의 Question-Answering Evaluation과 LLM-based Evaluation의 차이점은 뭘까? 🤔 위와 같은 의문점을 간단한 예시를 가지...
-
- LLM Performance Evaluation - 연구계획(1)
- 안녕하세요! 저희는 SKT AI Fellowship 6기에서 LLM Performance Evaluation 과제를 맡게 된 ttf 팀입니다! ☺️ ttf? 글을 쓸 때 꼭 필요한 폰트 확장자처럼 Fellowship에서 꼭 필요한 팀이 되겠다는 의미입니다! 🌱 이번 포스트에서는 연구 과제 소개 및 계획을 소개드립니다. 1. 개요 대규모 언어 모델(LLM, Large Language Model)은 현대 인공지능 기술의 정점에 있는 혁신적인 도구죠! 최근 몇 년간 AI 연구에서 LLM은 그 중요성과 영향력이 크게 증가하면서 많은 주목을 받고 있습니다. ChatGPT, Claude, Gemini, BLOOM, LLaMA 등과 같은 LLM들은 시간이 지날 수록 성능이 ...
DEVOTEE 추천 블로그
-
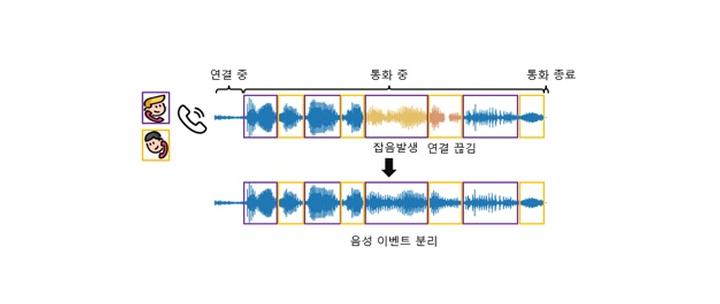
- AI 활용 5G 음성 통화 서비스 검증 자동화 - 연구계획(1)
- 안녕하세요! SKT Fellowship 6기에서 'AI 활용 5G 음성 통화 서비스 검증 자동화’ 과제를 진행하게 된 팀 sk삭임 입니다. 저희의 팀명은 통화 서비스의 검증 자동화를 통한, 사람과 사람을 잇는 통화 음성의 속삭임을 의미하기도 하고, SKT 프로젝트에 참여하면서 만들어 나갈 수많은 사람들과의 사귐도 이루겠다는 팀의 목표를 담고 있습니다. 이 포스트에서는 저희의 전반적인 연구계획과 태스크의 진행 방향을 소개해 드리겠습니다. 과제 추진 배경 통화 중 음질이 저하되거나, 연결이 끊겼던 경험이 있으신가요? 해당 문제들이 발생했을때 사용자들의 불만족이 증가하고, 사용자들은 소통의 오류를 경험했다고 합니다. 또한 HD Voice는 LTE망을 사용하는데, 이때 ...
-
- LLM Performance Evaluation - 연구과정(2)
- 안녕하세요! SKT AI Fellowship 6기에서 LLM Performance Evaluation 과제를 맡은 ttf 팀입니다! 😃 이번 포스트에서는 중간 발표를 마친 상태에서 어디까지 과제가 진행되었는지 짧게 공유 드리겠습니다! 1. 개요 이전과 같이 저희 팀은 평가의 효과가 떨어지는 기존의 벤치마크의 문제점을 인식하고, 기존의 Question-Answering Evaluation의 벤치마크를 벗어나 능동적으로 모델을 평가할 수 있는 LLM-based Evaluation 구조를 제시하고자 합니다! 기존의 Question-Answering Evaluation과 LLM-based Evaluation의 차이점은 뭘까? 🤔 위와 같은 의문점을 간단한 예시를 가지...
-
- LLM Performance Evaluation - 연구결과(3)
- 안녕하세요! SKT AI Fellowship 6기에서 LLM Performance Evaluation 과제를 맡은 ttf 팀입니다! 이번 포스트에서는 최종 발표까지의 연구 결과가 어떻게 도출되었는지 공유해드리겠습니다! 1. 개요 최근 LLM 연구가 활발해지면서 기존 벤치마크들은 그 유효성이 줄어들고, 데이터셋의 단순성 때문에 모델의 다양한 능력을 평가하는 데 한계가 있습니다. 이에 저희 ttf 팀은 기존의 Question-Answering Evaluation의 벤치마크를 벗어나 능동적으로 모델을 평가할 수 있는 LLM-based Evaluation, 생성형 평가 모델을 제시하고자 합니다! 기존의 Question-Answering Evaluation과 LLM-bas...
-
- TelBench : Telco 서비스향 LLM 성능측정을 위한 벤치마크 개발 및 평가
- 통신 분야에 특화된 Telco LLM의 데이터 설계, 구축, 그리고 평가 과정에 대해 공유합니다. 우선, LLM이 통신 분야의 용어와 지식, 비즈니스 맥락을 이해할 수 있도록 설계한 학습 데이터인 TelTask와 TelInstruct를 소개할 예정입니다. 이어서, 이 데이터로 학습된 Telco LLM의 검증을 위해 진행한 벤치마킹 과정과 결과에 대해 설명하고, 데이터 전문가인 언어학자와 엔지니어의 협업 시너지, 고객 센터 상담사를 통한 인간의 전문적인 평가, 그리고 통신 특화 LLM-as-a-judge 개발 경험 등 기술적인 시도를 해 나가는 과정도 함께 다룰 것입니다. 통신 산업 내에서 대규모 언어 모델의 가능성을 확인하고, 보다 정확하고 유용한 솔루션을 제공하...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.