
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
RAG 및 LLM 파인튜닝을 통한 Text2SQL 모델 성능 개선 - 연구계획(1)

- DEVOTEE 요약
- 저희 팀 SKT AI Fellowship의 프로젝트는 자연어를 SQL로 변환하는 한글 LLM/RAG 챗봇 개발입니다. 이를 통해 SQL에 익숙하지 않은 분석가들이 쉽게 데이터베이스와 상호작용할 수 있도록 돕고자 합니다. 데이터 보안을 유지하면서도 자연어로부터 SQL 쿼리를 자동으로 생성할 수 있는 시스템을 구현하고 있습니다.
안녕하세요! 저희는 SKT AI Fellowship 6기 a-02번 과제를 맡은 skql(슼큐엘) 팀입니다!
이번 포스트를 통해 저희 팀의 연구 주제와 진행 방법에 관해 설명드리겠습니다!
1. 연구 과제 소개
1.1. 연구 목표/내용/배경
데이터분석에 관심이 많으신 분이라면 SQL을 한 번 쯤은 들어보셨을텐데요.
SQL은 데이터베이스에서 자료를 처리하는 용도로 사용되는 구조적 데이터 질의 언어이고, SQL을 통해 사용자들은 데이터베이스에서 쉽게 자료를 찾거나 저장할 수 있습니다.
데이터 분석을 통해 인사이트를 발견하는 것부터, 파이프라인 개발이나 프로그래밍에 활용하는 등 다양한 곳에 데이터가 사용되면서 SQL의 중요성이 증가하고 있습니다.
이에 저희는 IDCube (ICT Infra의 data warehouse 및 분석환경 서비스)를 사용하는 유저들 중 SQL에 익숙치 않은 분석가들을 위해, 자연어(NL)로부터 SQL문을 생성하는 한글 LLM/RAG chatbot을 개발하고자 합니다.
기존에 SQL문을 작성하기 위해서는 유저가 원하는 정보(자연어)에 1:1 대응되는 column을 docs에서 찾아, 찾은 컬럼명을 이용해 sql문을 구성하고, 구성한 sql문을 AWS Athena로 실행하여 결과를 받게 됩니다.
하지만 컬럼명이 직관적이지 않을 경우 docs에서 description을 통해 필요한 컬럼을 찾아야 해서 시간이 많이 소요됩니다. 또한 sql문 작성이 능숙하지 않은 분석가는 쿼리문 구성에 있어 어려움을 느낍니다. 데이터 보안 문제로 인해 컬럼 정보를 chatGPT, claude 와 같은 웹 서비스에 직접 전달하는 것 또한 불가능하므로 어려움을 해결하기가 쉽지 않습니다. sql문에 익숙한 분석가에게도 실무 데이터에서 join의 범위 제한이 없다는 점 및 상/하위호환 관계인 테이블들이 존재한다는 점으로 인해 쿼리문 작성에 과도하게 많은 시간을 투자하게 됩니다.
이를 해결하기 위해, 기본적으로 데이터 보안 문제를 해결하는 동시에 LLM으로 NL→SQL 생성의 자동화가 필요합니다. 유저가 chatGPT, claude와 같은 웹 서비스에 컬럼 정보를 전달하는 것이 아닌, claude-opus-skt/gpt-4o-skt와 같은 데이터 보안 계약이 완료된 api, 또는 오픈 소스 sLLM을 파인튜닝한 모델에 프롬프트 엔지니어링 및 RAG DB를 활용해야 합니다.
1.2. challenge
1.2.1. 유사한 형태의 history 쿼리를 찾아오는 것의 정확성
Text2SQL 모델에서는 유저의 question(Q_u)을 입력으로 받아 이에 상응하는 SQL 쿼리(S_u)를 output으로 제공하고, context로 question에서 요구하는 값과 매핑된 schema와 출력 예시가 필요합니다.
이미 보유한 데이터(NL 입력(Q_d) - SQL 출력(S_d) 중 유저의 question과 유사한 데이터가 있다면 정확도가 크게 오를 수 있지만, 그 형태의 유사도를 측정하고 적절한 예시문을 제공하는 것은 매우 어렵습니다.
이 문제점을 해결하기 위해 , 잘 정제된 데이터 (0순위) 생성에 큰 노력을 기울여야 하며, 실제 자연어 입력문(Q_u)과 데이터의 자연어 입력문(Q_d)의 유사도를 잘 검사하는 형태로 단순화를 해야 합니다.
1.2.2. 난이도 구분의 어려움
기존 연구의 난이도 분류는 특정 구문 키워드(join, 서브쿼리)에 편향된 기준으로 이루어집니다.
DINSQL - https://arxiv.org/pdf/2304.11015
The moduleclassifies each query into one of the three classes: easy, non-nested complex and nested complex.The easy class includes single-table queries that can be answered without join or nesting. Thenon-nested class includes queries that require join but no sub-queries, and the queries in the nestedclass can contain joins, sub-queries and set operations. The class labels are important for our querygeneration module, which uses different prompts for each query class.
자체 모델 확보를 위해 오픈소스 모델의 lora 파인튜닝을 하게 된다면, 1.2.1. 에서 설명한 과정을 거쳐 데이터를 확보하고 이를 기반으로 파인튜닝을 해야합니다. 하지만 아주 긴 입력 context에 대한 학습의 어려움 등으로 인해 파인튜닝 과정에서 매우 많은 컴퓨팅 자원 및 시행착오가 예상됩니다. 단, glm-4-9b의 등장처럼, 기본 추론 능력이 뛰어난 모델이 공개된다면 파인튜닝을 시도할 가치가 있습니다.
컴퓨팅 자원 효율화 및 LLM 모델의 한계를 극복하기 위해 LLM 모델을 쿼리 난이도 별로 나눠 난이도 별 fine-tuning을 수행하고 이를 통합하여 전체 모델을 구성하는 방향을 생각해볼 수 있습니다.
1.2.3 유저 니즈 파악 및 멀티 턴 대화 흐름 설계 필요
유저 니즈 파악 - 단순히 특정 테이블의 내용을 조회하려는 입력도 많이 존재합니다.
유저가 테이블의 컬럼 정보를 입력하지 않는 경우 → 자연어로부터 관련 테이블을 모두 가져와야 합니다.
그 다음 니즈를 세부적으로 챗봇이 질문하도록 하는 프롬프트 구성이 필요합니다.
대부분의 니즈를 충족시키는 멀티 턴 대화 흐름을 잘 기획해야 합니다.
예를 들면,
유저 입력으로 ~에 관한 정보를 알고 싶다 가 들어오면 관련 테이블을 가져와서 요약, 원하는 task를 챗봇이 유저에게 물음.
유저의 대답을 기반으로, 관련 테이블을 한번 더 찾아서 가져오고 요약, 원하는 task가 ~~가 맞냐고 물음, 아니라면 원하는 task를 챗봇이 유저에게 재질문합니다.
유저의 대답에 따라 작업을 수행합니다. → sql문 생성
해당 형태를 따르면, 단순한 테이블 조회 task부터 sql문 생성까지 다양한 니즈를 충족시키는 흐름을 구현할 수 있습니다. 즉 유저의 첫 입력 복잡도에 따라 서비스를 계속 이용하게 할 수도 있고 바로 답을 줄 수도 있게 해야 합니다. 이렇게 진행하기 위해 쉬운 task부터 답하면서, 유저에게 다음 세부 task를 묻는 형식으로 진행돼야 합니다. 따라 멀티 턴 상황에 맞는 프롬프트를 만들어야 합니다.
1.2.4 유저 입력의 모호성
위 사진처럼 쿼리문 작성에 필요한 정보가 누락되거나 유저가 입력을 아주 대충 작성한 경우, 멀티턴 대화를 통해 추가 정보를 수집하여 sql문 생성을 위한 자연어로 바꿔야 합니다.
2. 연구 수행 계획
2.1. 관련 선행 연구
2.1.1. DIN-SQL
참고논문: https://arxiv.org/pdf/2304.11015
DIN-SQL은 LLM의 답변에서 스스로 출력의 원인을 설명하도록 프롬프트를 주는 방식으로, 결과에 대한 explainabilty를 높혔습니다. 입력이 구체적 자연어라는 전제 하에, 스키마 링크와 난이도를 순차적으로 추론, 이후 자연어와 스키마 링크와 난이도를 입력으로 SQL문을 생성, 이때 출력 과정 중 intermediate representation을 표현하도록 했습니다. 이렇게 생성된 최종 출력물에 대해 자가 수정하는 단계에서 다시 입력으로 기존 정보들을 받아서 버그를 수정하고 최종적으로 사용하는 방식의 파이프라인 입니다.
Schema linking prompt
입력 : 구체적 자연어
출력 : 구체적 이유를 설명하면서(step by step) 입력 자연어에 해당하는 스키마 링크(필요 컬럼, 외래 키)정보 선정
Classification & decomposition prompt
입력 : 구체적 자연어
출력 : 구체적 이유를 설명하면서(step by step) 입력의 난이도를 3개로 분류 (EASY : JOIN필요없음 nested필요없음, MID : JOIN필요 nested필요없음, HARD : nested필요)
SQL Generation
입력 : 난이도, 구체적 자연어, 스키마 링크
출력 : EASY는 바로 출력, EASY가 아닌 경우 구체적 이유를 설명하면서(step by step) Intermediate_representation을 표현하고, 최종 SQL문 출력
Intermediate_representation : style : NatSQL [Gan et al., 2021]
Various intermediate representations have been introduced in the literature.
In particular, SemQL [Guo et al., 2019] removes operators JOIN ON, FROM, and GROUP BY, which have no clear counterparts in natural language queries, and merges the HAVING and WHERE clauses. NatSQL [Gan et al., 2021] builds upon SemQL and removes the set operators. Expressions in natural language queries may not clearly map to a unique SQL clause or they may map to multiple clauses, so removing operators makes the transition from natural language to SQL easier. As our intermediate representation, we use NatSQL, which is shown to have a state-of-the-art performance when combined with other models [Li et al., 2023a].
Self-correction prompts
입력 : 스키마 링크, SQL문(잠재적 오류 가능성)
출력 : 오류 수정된(오류 없는 경우 그대로인) 최종 SQL문
2.2 연구방향
2.2.1. 데이터 정제
유저들이 실제 입력해서 성공한 sql문을 자연어 문장으로 바꿔야 합니다. 이 작업에서 예시로 실제 입력되는 sql생성용 자연어 문장 로그를 context example로 사용해야 합니다.(가장 중요, 컬럼-자연어 매핑 작업이자, 입력 자연어 문장의 난이도(길이,구문키워드 빈도, 구조)를 sql문의 난이도(길이,구문키워드 빈도, 구조)와 매핑하는 작업.)
1.에서 생성한 sql-자연어 데이터를 난이도별 분류해야 합니다.(데이터 클러스터링)
2.에서 분류된 데이터를 각각 난이도별 sllm의 lora파인튜닝에 활용해야 합니다.(Instruction fine tune), 혹은 sllm파인튜닝 없이 llm api에 대한 프롬프트 엔지니어링 + RAG로 모든 것을 해결하려고 한다면, 난이도별 instruction template의 구성에 분류된 데이터를 활용해야 합니다. 난이도가 높은 sql생성을 할 때는 CoT를 멀티 턴 상황에 최적화하여 구성해서, 유저의 추가 정보를 유도해야 할 수도 있습니다.
2.2.2. 난이도 별 LLM 데이터 구성
난이도 별 LLM 모델을 구성하고 fine-tuning을 진행하기 위해 각 난이도 별 데이터(NL 입력(Q_d) - SQL 출력(S_d)와 LLM의 성능 평가 지표가 필요합니다.
먼저 데이터셋을 난이도 별로 나누기 위해 구문 빈도 및 구문별 가중치(llm CoT기반으로 제작)기반의 난이도 점수별 데이터셋 분류가 필요합니다. 기존 논문들에서 제시하는 임의의 분류법(easy, nested complex, …)을 넘어서, llm이 형성하기 어려워 하는 구문을 기준으로 체계화된 점수표를 통해 학습 시킬 데이터 분포를 결정하는 연구의 고도화가 필요합니다. 이를 통해 난이도 별 전문가 모델들이 각자 풀어야 하는 구문에 대해 잘 풀지 못했던 문제를 잘 풀게 하는 방향으로 학습시킬 수 있습니다.
1. SQL 쿼리문의 구문 별 SQL 키워드 출현 빈도 카운팅
실제 코드 실행 결과
# 실행 성공한 내부 SQL 쿼리문에서 구문 수를 count
keyword_counts
{'WITH': 1, 'AS': 9, 'SELECT': 7, 'CONCAT': 2, 'FROM': 7, 'WHERE': 5, 'LIKE': 2, 'TO_DATE': 4, 'INTERVAL': 1, 'JOIN': 1, 'ON': 1, 'IN': 2})
{'SELECT': 1, 'FROM': 1, 'WHERE': 1, 'LIKE': 1, 'LIMIT': 1})
{'SELECT': 1, 'CASE': 1, 'WHEN': 4, 'THEN': 4, 'AS': 9, 'FROM': 1, 'WHERE': 1, 'IN': 1, 'LIMIT': 1})
{'SELECT': 18, 'CAST': 8, 'AS': 28, 'IF': 11, 'CASE': 1, 'WHEN': 4, 'THEN': 4, 'ROUND': 6, 'FROM': 18, 'ROW_NUMBER': 1, 'OVER': 1, 'CONCAT': 3, 'JOIN': 11, 'WHERE': 13, 'ON': 11, 'IN': 1, 'SUBSTR': 3, 'SUM': 2})
{'SELECT': 1, 'FROM': 1, 'LIMIT': 1})
{'SELECT': 3, 'CONCAT': 1, 'AS': 13, 'FROM': 3, 'WHERE': 2, 'CAST': 2, 'LIKE': 1, 'JOIN': 1, 'ON': 1, 'LIMIT': 1})
{'SELECT': 1, 'FROM': 1, 'WHERE': 1, 'LIMIT': 1})
{'SELECT': 6, 'AS': 1, 'SUM': 24, 'ROUND': 2, 'FROM': 6, 'SUBSTR': 8, 'WHERE': 6, 'JOIN': 2, 'COUNT': 2, 'ON': 2, 'UNION': 1, 'ALL': 1, 'LIMIT': 1})
{'SELECT': 1, 'AS': 25, 'SUM': 15, 'CAST': 15, 'ROUND': 6, 'FROM': 1, 'WHERE': 1, 'IN': 1, 'LIMIT': 1})
{'SELECT': 18, 'CAST': 8, 'AS': 28, 'IF': 11, 'CASE': 1, 'WHEN': 4, 'THEN': 4, 'ROUND': 6, 'FROM': 18, 'ROW_NUMBER': 1, 'OVER': 1, 'CONCAT': 3, 'JOIN': 11, 'WHERE': 13, 'ON': 11, 'IN': 1, 'SUBSTR': 3, 'SUM': 2})
{'SELECT': 1, 'FROM': 1, 'WHERE': 1})
{'SELECT': 1, 'AVG': 3, 'AS': 1, 'FROM': 1, 'WHERE': 1, 'HAVING': 1, 'LIMIT': 1})
{'SELECT': 1, 'CAST': 1, 'AS': 1, 'FROM': 1, 'LIMIT': 1})
{'SELECT': 1, 'FROM': 1, 'WHERE': 1, 'LIMIT': 1})
{'SELECT': 1, 'FROM': 1, 'LIMIT': 1})
{'SELECT': 1, 'FROM': 1, 'WHERE': 1})
{'SELECT': 1, 'FROM': 1, 'WHERE': 1})
{'SELECT': 6, 'AVG': 21, 'FROM': 6, 'WHERE': 4, 'JOIN': 2, 'AS': 8, 'LIKE': 6, 'ON': 2, 'LIMIT': 1})
{'SELECT': 1, 'FROM': 1, 'WHERE': 1, 'IN': 1})
2. SQL 키워드 별 가중치 계산
CoT prompt를 통해 gpt4o로 논리적 근거를 추가하여 각 키워드 별 초기 가중치를 계산합니다.
CoT prompt(gpt4o에 넣는 입력 전체), output
###instruction
너는 자연어를 입력받아 sql문을 생성하는 챗봇이야. Step by Step으로 생각하고 행동해.
1.입력으로 sql키워드 리스트를 받아.
2.자연어를 sql문으로 만들 때 사용하는 각
키워드의 난이도를 0~1사이 실수(소수점 둘째 자리까지 넓은 분포로 표현) 점수를 매겨.
3.각 키워드 오른쪽에 주석의 형태로 난이도 책정의 이유를 논리적으로 설명해.

###input
sql_commands = [
"SELECT",
"FROM",
"WHERE",
"JOIN",
"WITH",
"AS",
"ORDER BY",
"LIMIT",
"CASE",
"WHEN",
"THEN",
"LEFT JOIN",
"ON",
"INTERVAL",
"TO_DATE",
"ROUND",
"IF",
"SUM",
"ROW_NUMBER",
"PARTITION BY",
"OVER",
"CONCAT",
"CAST",
"GROUP BY",
"SUBSTR",
"DISTINCT",
"RIGHT JOIN",
"FULL OUTER JOIN",
"CROSS JOIN",
"UNION",
"UNION ALL",
"MIN",
"MAX",
"AVG",
"COUNT",
"HAVING",
"EXISTS",
"NOT EXISTS",
"ANY",
"ALL",
"IN",
"NOT IN",
"BETWEEN",
"LIKE",
"RANK",
"DENSE_RANK",
# AWS Athena specific commands
"UNLOAD",
"USING",
"EXTERNAL",
"LOCATION",
"STORED AS",
"SERDE",
"WITH SERDEPROPERTIES",
"WITH PARAMETERS",
"TBLPROPERTIES",
"MSCK REPAIR TABLE",
"ADD PARTITION",
"DROP PARTITION",
"SHOW PARTITIONS",
"SHOW CREATE TABLE",
"SHOW TBLPROPERTIES",
"DESCRIBE",
"SHOW DATABASES",
"SHOW TABLES",
"SHOW COLUMNS",
"SHOW FUNCTIONS",
"ANALYZE",
"VACUUM",
"COPY INTO",
"ALTER TABLE",
"ALTER DATABASE",
"ALTER VIEW",
"REFRESH TABLE",
"REFRESH DATABASE",
"MERGE INTO"
]

###output_format
sql_command_weights = {
"SELECT": 0.12, # ~~~
"FROM": ?, # ~~~
"WHERE": ?, # ~~~
"JOIN": 0.65, # ~~~
# CoT prompt를 통해, gpt4o로 구문 별 난이도 가중치를 초기화하고 논리적 근거를 주석 형태로 출
sql_command_weights = {
"SELECT": 0.11, # 기본 SQL 구문이며, 데이터베이스에서 데이터를 선택하는 데 사용됨. 기본적인 문법으로 비교적 쉽다.
"FROM": 0.12, # 데이터를 추출할 테이블을 지정하는 데 사용. 기본적인 SQL 문법의 일부로 쉽게 이해할 수 있다.
"WHERE": 0.09, # 조건을 지정하여 데이터를 필터링하는 데 사용. 조건식 작성의 난이도가 조금 있지만 비교적 이해하기 쉬운 편.
"JOIN": 0.52, # 0.5 두 개 이상의 테이블을 결합하는 데 사용. 결합 조건과 다양한 형태의 조인을 이해하는 데 약간의 난이도가 있다.
"WITH": 0.58, # 서브쿼리를 정의하는 데 사용되는 공통 테이블 표현식(CTE) 구문. 서브쿼리를 다루는 점에서 약간의 복잡성이 있다.
"AS": 0.1, # 0.1 별칭을 지정하는 데 사용. 단순한 구문으로 이해하기 쉽다.
"ORDER BY": 0.11, # 결과 집합을 정렬하는 데 사용. 기본적인 정렬 개념으로 이해하기 쉬움.
"LIMIT": 0.09, # 반환할 행의 수를 제한하는 데 사용. 사용법이 간단하여 이해하기 쉽다.
"CASE": 0.51, # 조건에 따라 다른 값을 반환하는 데 사용. 다양한 조건을 처리할 수 있어 약간의 복잡성이 있다.
"WHEN": 0.49, # CASE 구문의 일부로 조건을 지정. CASE 구문과 함께 이해해야 하므로 난이도가 비슷하다.
"THEN": 0.48, # CASE 구문의 일부로 조건이 참일 때 반환할 값을 지정. WHEN과 유사한 난이도.
"LEFT JOIN": 0.61, # 0.6 기본 JOIN에 비해 약간 더 복잡한 개념으로, 왼쪽 테이블의 모든 행과 오른쪽 테이블의 일치하는 행을 결합.
"ON": 0.39, # JOIN 조건을 지정하는 데 사용. JOIN 구문과 함께 사용되므로 약간의 복잡성이 있다.
"INTERVAL": 0.41, # 날짜나 시간을 조작하는 데 사용. 시간 연산을 이해해야 하므로 약간의 난이도가 있다.
"TO_DATE": 0.31, # 문자열을 날짜로 변환하는 데 사용. 변환 함수로 이해하기 쉬움.
"ROUND": 0.19, # 숫자를 반올림하는 데 사용. 수학적 함수로 이해하기 쉬움.
"IF": 0.38, # 조건에 따라 다른 값을 반환하는 함수. 논리적 조건 처리가 필요하여 약간의 난이도가 있다.
"SUM": 0.21, # 집계 함수로, 숫자의 합계를 구하는 데 사용. 단순한 집계 함수로 이해하기 쉬움.
"ROW_NUMBER": 0.47, # 결과 집합에 순위 번호를 할당하는 윈도우 함수. 윈도우 함수 개념을 이해해야 하므로 난이도가 있다.
"PARTITION BY": 0.53, # 윈도우 함수의 일부로, 결과 집합을 파티션으로 나누는 데 사용. 윈도우 함수와 함께 이해해야 하므로 난이도가 있다.
"OVER": 0.48, # 윈도우 함수의 일부로, 윈도우를 정의하는 데 사용. 윈도우 함수와 함께 이해해야 하므로 난이도가 있다.
"CONCAT": 0.23, # 문자열을 연결하는 함수. 사용법이 단순하여 이해하기 쉽다.
"CAST": 0.29, # 데이터 타입을 변환하는 함수. 다양한 데이터 타입을 이해해야 하므로 약간의 난이도가 있다.
"GROUP BY": 0.42, # 데이터를 그룹화하여 집계 결과를 생성하는 데 사용. 집계와 그룹화를 이해해야 하므로 약간의 난이도가 있다.
"SUBSTR": 0.32, # 문자열의 일부를 추출하는 함수. 문자열 처리에 대한 기본 이해가 필요.
"DISTINCT": 0.27, # 중복된 값을 제거하는 데 사용. 단순한 개념이지만 대용량 데이터에서는 성능 문제를 고려해야 함.
"RIGHT JOIN": 0.59, # 0.6 오른쪽 테이블의 모든 행과 왼쪽 테이블의 일치하는 행을 결합. JOIN의 복잡성을 포함.
"FULL OUTER JOIN": 0.71, # 두 테이블의 모든 행을 결합하며 일치하지 않는 행도 포함. 가장 복잡한 JOIN 형태 중 하나.
"CROSS JOIN": 0.57, # 두 테이블의 모든 행을 결합하여 데카르트 곱을 생성. 사용 시 주의가 필요하여 난이도가 있다.
"UNION": 0.49, # 두 결과 집합을 결합하여 중복을 제거. 중복을 처리하는 점에서 약간의 복잡성이 있다.
"UNION ALL": 0.52, # 두 결과 집합을 결합하되 중복을 제거하지 않음. UNION과 비슷한 난이도.
"MIN": 0.22, # 집계 함수로, 최소값을 구하는 데 사용. 단순한 집계 함수로 이해하기 쉽다.
"MAX": 0.21, # 집계 함수로, 최대값을 구하는 데 사용. 단순한 집계 함수로 이해하기 쉽다.
"AVG": 0.18, # 집계 함수로, 평균값을 구하는 데 사용. 단순한 집계 함수로 이해하기 쉽다.
"COUNT": 0.2, # 집계 함수로, 행의 수를 구하는 데 사용. 단순한 집계 함수로 이해하기 쉽다.
"HAVING": 0.43, # GROUP BY 결과에 조건을 적용하는 데 사용. WHERE과 유사하지만 그룹화된 데이터에 적용되므로 약간의 난이도가 있다.
"EXISTS": 0.48, # 서브쿼리의 결과 존재 여부를 확인하는 조건문. 서브쿼리를 이해해야 하므로 난이도가 있다.
"NOT EXISTS": 0.51, # 서브쿼리의 결과 존재 여부가 거짓인지 확인하는 조건문. EXISTS와 비슷한 난이도.
"ANY": 0.39, # 서브쿼리의 결과 중 하나라도 조건을 만족하는지 확인. 서브쿼리를 이해해야 하므로 약간의 난이도가 있다.
"ALL": 0.42, # 서브쿼리의 결과가 모두 조건을 만족하는지 확인. 서브쿼리를 이해해야 하므로 약간의 난이도가 있다.
"IN": 0.31, # 지정된 목록이나 서브쿼리의 결과에 값이 포함되는지 확인. 간단한 조건문이지만 서브쿼리 사용 시 약간의 난이도가 있다.
"NOT IN": 0.28, # 지정된 목록이나 서브쿼리의 결과에 값이 포함되지 않는지 확인. IN과 비슷한 난이도.
"BETWEEN": 0.29, # 값이 두 값 사이에 있는지 확인. 간단한 조건문으로 이해하기 쉽다.
"LIKE": 0.32, # 문자열 패턴 매칭을 위한 조건문. 기본적인 패턴 매칭으로 이해하기 쉬움.
"RANK": 0.49, # 결과 집합에 순위를 매기는 윈도우 함수. 윈도우 함수의 개념을 이해해야 하므로 약간의 난이도가 있다.
"DENSE_RANK": 0.52, # 결과 집합에 중복 없이 순위를 매기는 윈도우 함수. RANK와 비슷한 난이도.
"UNLOAD": 0.51, # AWS Athena에서 결과를 파일로 저장하는 명령어. AWS 서비스와의 연동을 이해해야 하므로 약간의 난이도가 있다.
"USING": 0.41, # 테이블 결합 시 사용할 칼럼을 지정하는 조건. JOIN 구문과 함께 사용되어 약간의 난이도가 있다.
"EXTERNAL": 0.54, # 외부 테이블을 정의하는 데 사용. 외부 데이터 소스를 이해해야 하므로 약간의 난이도가 있다.
"LOCATION": 0.42, # 외부 테이블의 위치를 지정. 외부 데이터 소스를 이해해야 하므로 약간의 난이도가 있다.
"STORED AS": 0.38, # 데이터 저장 형식을 지정. 다양한 저장 형식을 이해해야 하므로 약간의 난이도가 있다.
"SERDE": 0.48, # 직렬화 및 역직렬화 라이브러리를 지정. 기술적인 이해가 필요하여 난이도가 있다.
"WITH SERDEPROPERTIES": 0.52, # SERDE의 속성을 지정. 세부 속성을 이해해야 하므로 약간의 난이도가 있다.
"WITH PARAMETERS": 0.47, # 테이블 생성 시 파라미터를 지정. 다양한 파라미터를 이해해야 하므로 약간의 난이도가 있다.
"TBLPROPERTIES": 0.36, # 테이블 속성을 지정. 다양한 속성을 이해해야 하므로 약간의 난이도가 있다.
"MSCK REPAIR TABLE": 0.64, # AWS Athena에서 테이블 파티션을 복구. 특정 서비스와의 연동을 이해해야 하므로 난이도가 있다.
"ADD PARTITION": 0.37, # 테이블에 파티션을 추가. 파티션 개념을 이해해야 하므로 약간의 난이도가 있다.
"DROP PARTITION": 0.43, # 테이블에서 파티션을 삭제. 파티션 개념을 이해해야 하므로 약간의 난이도가 있다.
"SHOW PARTITIONS": 0.29, # 테이블의 파티션을 표시. 단순한 명령어로 이해하기 쉽다.
"SHOW CREATE TABLE": 0.28, # 테이블 생성 스크립트를 표시. 단순한 명령어로 이해하기 쉽다.
"SHOW TBLPROPERTIES": 0.31, # 테이블 속성을 표시. 단순한 명령어로 이해하기 쉽다.
"DESCRIBE": 0.3, # 테이블 구조를 설명. 단순한 명령어로 이해하기 쉽다.
"SHOW DATABASES": 0.32, # 데이터베이스 목록을 표시. 단순한 명령어로 이해하기 쉽다.
"SHOW TABLES": 0.33, # 테이블 목록을 표시. 단순한 명령어로 이해하기 쉽다.
"SHOW COLUMNS": 0.29, # 테이블의 칼럼을 표시. 단순한 명령어로 이해하기 쉽다.
"SHOW FUNCTIONS": 0.28, # 사용 가능한 함수를 표시. 단순한 명령어로 이해하기 쉽다.
"ANALYZE": 0.41, # 테이블 통계를 수집 및 분석. 데이터 분석 개념을 이해해야 하므로 약간의 난이도가 있다.
"VACUUM": 0.37, # 테이블을 정리하여 저장 공간을 확보. 데이터 정리 개념을 이해해야 하므로 약간의 난이도가 있다.
"COPY INTO": 0.47, # 데이터를 테이블에 복사. 데이터 이동 개념을 이해해야 하므로 약간의 난이도가 있다.
"ALTER TABLE": 0.39, # 테이블 구조를 변경. 다양한 변경 옵션을 이해해야 하므로 약간의 난이도가 있다.
"ALTER DATABASE": 0.42, # 데이터베이스 구조를 변경. 다양한 변경 옵션을 이해해야 하므로 약간의 난이도가 있다.
"ALTER VIEW": 0.37, # 뷰 구조를 변경. 다양한 변경 옵션을 이해해야 하므로 약간의 난이도가 있다.
"REFRESH TABLE": 0.28, # 테이블을 새로 고침. 단순한 명령어로 이해하기 쉽다.
"REFRESH DATABASE": 0.29, # 데이터베이스를 새로 고침. 단순한 명령어로 이해하기 쉽다.
"MERGE INTO": 0.63, # 테이블을 병합하여 업데이트. 데이터 병합 개념을 이해해야 하므로 난이도가 있다.
}3. 쿼리 별 complexity score 계산
def calculate_query_complextity_score(keyword_counts, weights):
    complextity_score = 0
    for keyword, count in keyword_counts.items():
        complextity_score += weights.get(keyword, 0) * count
    return complextity_score
4. complexity score 기반 클러스터링
gpt4o가 생성한 초기 complexity score를 기반으로 난이도 클러스터링을 진행합니다. 군집화된 각 난이도의 쿼리를 처리하는 개별 llm agent가 중점적으로 봐야 하는 쿼리문 스타일 별 DB를 구성해서, RAG를 용이하도록 합니다.
AWS Athena에 누적된, 실행 성공한 1000개의 쿼리들의 complexity score 를 오름차순 정렬 후 k=4 KMeans를 진행합니다.
SQL 쿼리 예시)
score : 0.32, query : SELECT * FROM A.A LIMIT A
score : 0.32, query : select B from A.A where A = 'A'
score : 0.32, query : SELECT * FROM A.A WHERE A = 'A'
score : 0.32, query : SELECT A, A FROM A.A LIMIT A
score : 0.32, query : select * from A.A order by A LIMIT A
score : 0.81, query : SELECT A, A AS "A", A AS "A", A AS "A A", A AS "A", A FROM A.A WHERE A = 'A' AND A = 'A' LIMIT A
score : 0.82, query : select A as "A" from A.A where A(A, 'A') = A and A = 'A' and A != A order by A LIMIT A
score : 0.82, query : select A ,A as "A" from A.A where A(A, 'A') = A and A = 'A' and A != A order by A LIMIT A
score : 0.83, query : SELECT * FROM A.A where A like 'A' and A(NULLIF(A,'A') as A)=A LIMIT A
score : 0.83, query : select A, A(A) A, A(A) A FROM A.A where A='A' and A='A' group by A LIMIT Ascore : 1.5, query : SELECT DISTINCT B FROM A.A A A A JOIN A.A A ON A.A ='A' and A.A = A.A WHERE A = 'A'
score : 1.5, query : SELECT DISTINCT B FROM A.A A A A JOIN A.A A ON A.A ='A' and A.A = A.A WHERE A = 'A' AND A = 'A'
score : 1.55, query : SELECT * FROM ( SELECT * from A.A where A(A as INTEGER) >= A and A = 'A' ) AS A, ( SELECT * FROM A.A ) AS A where A.A = A.A LIMIT A
score : 1.69, query : select B(A, 'A', A) AS "A", A from A.A where A like 'A' and A >= A and A(A, 'A') = A - INTERVAL 'A' A and A = 'A'
score : 1.71, query : select A, A(A(A as A) ) A, A(distinct A) A FROM A.A where A='A' and A='A' and (A like 'A') and A='A' group by Ascore : 4.01, query : select A, A(A,A,'A') A, A(A,A(A,A,'A')) B(A) A, A(A) A, A(A)/A(A)/A A, A(A)/A(A) A , A(A) A, A(A) A ,A(A) A, A(A) A, A(A) A ,A(A)/A(A) A ,A(A)/A(A) A from A.A where A>='A' and A<='A' and A in ( 'A', 'A', 'A', 'A', 'A', 'A' ) group by B
score : 4.05, query : SELECT A AS "A", A AS "A", A AS "A", A AS "A", A AS "A/A", A AS "A", A AS "A", A AS "A", A AS "A", A AS "A(A)", A AS "A(A)", A AS "A(A)", A AS "A(A)", A AS "A(A)", A AS "A(A)", A AS "A(A)", A AS "A(A)", A AS "A", A AS "A", A AS "A", A AS "A", A AS "A", A AS "A", A AS "A", A AS "A", A AS "A", A AS "A", A AS "A", A AS "A(A)", A AS "A", A AS "A", A AS "A(A)" FROM A.A WHERE A = (SELECT A(A) FROM A.A) and A = 'A' LIMIT A
score : 4.07, query : select A.A, A.A, A.A, A.A, A.A, A.A, A.A as "A", A.A as "A", A(A.A as A)+A(A.A as A)/A as "A", A.A as "A", A.A as "A", A.A as "A", A.A as "A", A.A as "A", A.A as "A" from ( SELECT B FROM A.A where A = A(A(A('A', -A, A) AS A), 'A', 'A') and A like 'A' )A A join ( select A , A , A , A , A , A , A, A , A From A.A where A = A(A(A('A', -A, A) AS A), 'A', 'A') )A on A.A = A.A LIMIT A
score : 4.11, query : select A, A(A,A,'A') A, A(A,A(A,A,'A')) B(A) A, A(A) A, A(A)/A(A)/A A, A(A)/A(A) A , A(A) A, A(A) A ,A(A) A, A(A) A, A(A) A ,A(A)/A(A) A ,A(A)/A(A) A from A.A where A>='A' and A<='A' and A like 'A' group by B LIMIT A
score : 4.21, query : select A.A, A.A, A.A, A.A, A.A, A.A, A.A, A.A, A.A, A.A, A.A, A.A, A.A, A.A, A.A, A.A, A(A.A,'A',A.A,'A',A.A,'A',A.A) as A, A.A, A(A.A as A)+A(A.A as A)/A +(A(A.A as A)+A(A.A as A)/A)/A as "A", A(A.A as A)+A(A.A as A)/A +(A(A.A as A)+A(A.A as A)/A)/A as "A" from ( SELECT B FROM A.A where A = A(A(A('A', -A, A) AS A), 'A', 'A') and A like 'A' )A A join ( select A , A , A , A , A , A , A, A , A From A.A where A = A(A(A('A', -A, A) AS A), 'A', 'A') )A on A.A = A.A인하우스 데이터 보안 및 sql문의 구조적 정보만을 표현하기 위해, value값들은 A or B로 치환했습니다.
5. 가중치 업데이트
인하우스 데이터에 대해, Text2SQL모델들의 오류가 일어나는 횟수를 기준으로 구문 별 가중치를 업데이트합니다. llm agent가 어려워하는 문제일수록 complexity score가 높아지도록 하는 적응형 난이도 평가 기준 을 구성하고자 합니다.
이를 위해 우선 LLM agent가 쿼리를 정확하게 생성하는가에 대한 측정이 필요합니다. 문법적 오류가 있거나 어떤 키워드를 빠트리는 경우 해당 키워드의 가중치를 증가시킵니다. 예를 들어 Y = gold label sql 쿼리이고 Y^ = LLM이 생성한 sql 쿼리일 경우, Y에는 join이 3번 언급되었고 Y^에는 2번 언급되었다면 sql_command_weights의 "JOIN": 0.52를 "JOIN": 0.53으로 업데이트합니다. 이를 반복적으로 수행하여 쿼리 별 최종 complexity score를 부여하고, 해당 점수를 기반으로 라우터가 query를 어떤 llm agent에 전송할 지 결정하게 됩니다.
개별 llm agent는 LoRA fine-tuned sllm(8~20B) 혹은 skt llm api(skt-gpt4o, skt-claude-Opus)의 개별 프롬프트 + 개별 RAG db입니다. LoRA fine-tuned sllm(8~20B)을 사용하게 되는 경우, 특정 complexity class에 속하는 문제들에 특화된 파인튜닝 모델을 여러 개 학습해야 합니다. skt llm api(skt-gpt4o, skt-claude-Opus)를 사용하게 되는 경우, 특정 complexity class에 속하는 문제들에 특화된 프롬프트와 DB를 구축해야 합니다. (벡터 DB 전체를 검사하는 것이 아닌, 난이도별 DB를 검사함으로써 retrieval의 소요 시간을 줄이기 위함입니다.) 두 경우 모두를 위해 정밀한 난이도 분류가 필요합니다.
기존 연구(DINSQL의 난이도 분류는 특정 구문 키워드(join, 서브쿼리)에 편향된 단순한 분류방식이라는 한계가 있습니다. 이번 연구를 통해, 실제 데이터에 대한 Text2SQL 실행 결과의 오류 type에 기반한 complexity score를 난이도 분류의 새로운 지표로 제시하고자 합니다.
The module classifies each query into one of the three classes: easy, non-nested complex and nested complex.
The easy class includes single-table queries that can be answered without join or nesting. The non-nested class includes queries that require join but no sub-queries, and the queries in the nested class can contain joins, sub-queries and set operations.
The class labels are important for our query generation module, which uses different prompts for each query class. (DIN-SQL)
2.2.3. Retrieval 평가
AutoRAG를 활용하여 retrieval이 잘 수행되었는지 평가하고자 합니다. 특히 아래 두 가지의 기준을 중심으로 검색 성능을 평가할 것입니다.
retrieval된 output example이 ‘입력 자연어의 난이도’ 및 ‘유사한 gold 라벨(db에 저장된 sql문 중 입력 자연어와 구조적으로 가장 비슷한 레벨 )의 sql문의 구조’와 비교할 때, 유사한 난이도와 구조의 예시인지 : 구조 매칭률 지표
retrieval된 컬럼 정보가 잘 검색되었는지 : 입력 자연어 문장에서 ner된 value값들을 표현하는 컬럼이 추출됐는지 = gold data의 자연어 value와 컬럼 이름 간 1:1매핑이 잘 돼 있어야 합니다 : 컬럼 매칭률 지표
1.구조 매칭률 지표
Query 1: SELECT B(B) as A ,A(A(A),A) as A FROM A.A WHERE A>='A' AND A<='A' AND A>='A' AND A<='A' and A = 'A' group A B having A(A) >= A LIMIT A
Query 2: SELECT B,* FROM A.A WHERE A='A' and A='A' and A='A' and A='A' and A in ('A') LIMIT A
Query 3: SELECT B,* FROM A.A WHERE A='A' and A='A' and A='A' and A='A' and A in ('A') LIMIT A
Query 4: SELECT B FROM A.A WHERE A='A' and A='A' and A='A' and A='A' and A='A' and A='A' LIMIT A
Query 5: select A, A(A(A as A) ) A, A(distinct A) A FROM A.A where A='A' and A='A' and (A like 'A') and A='A' group A A
Query 6: select distinct A from A.A where A= 'A' and A like 'A' and A in (B)
Query 7: SELECT B FROM A.A WHERE A='A' and A='A' and A='A' and A='A' and A='A' and A='A' LIMIT A
Query 8: select A, A(A as A), A , A('A', A, A(A as A)) , A('A', A, A) , A(A(A as A) = B) from A.A where A='A' and A='A' limit A
Query 9: SELECT A, A(A) AS A, A(A) AS A ,A FROM A.A WHERE A = 'A' AND A = 'A' AND A = 'A' GROUP A A, A ORDER A A A LIMIT A
이와 같은 방식으로, table과 column를 전부 A로 치환하여 transformer decoder모델들이 ‘구조 정보’에 집중할 수 있도록 합니다. Y와 Y^의 구조를 이와 같은 방식으로 변경한 다음, 일치율을 비교하여 LLM의 구조 이해도를 평가할 수 있습니다. 일치율은 Y와 Y^의 complexity score difference 기반으로 평가합니다.
2.컬럼 매칭률 지표
A에 대응하는 table과 column이 정확해야 합니다.
구조 정보 + 컬럼 정보를 프롬프트에 예시로 제공
입력 자연어(벡터)와 DB자연어(벡터) 간 구조적 유사성이 높은 retrieval이 되었는지에 대한 평가를 아래 방식으로 진행합니다.
구조 정보만 남긴 입력 자연어를 llm을 통해 sql문으로 변경한 것
DB자연어에 매핑돼있던 sql문에서 구조 정보만 남긴 것
1,2사이의 complexity score 차이를 기준으로 평가합니다.
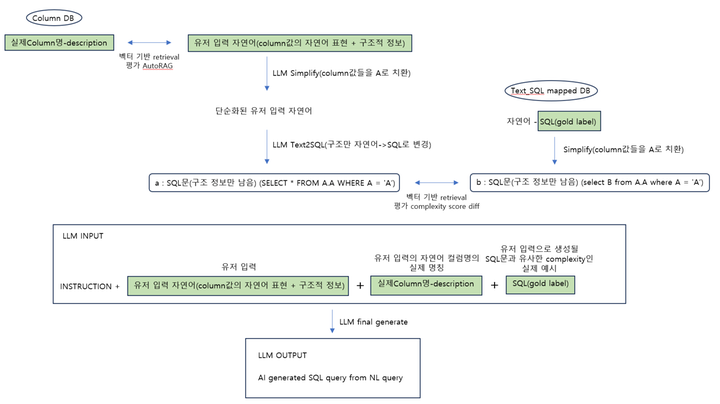
Step1: 유저입력 자연어(InputText) → 밸류값들을 “A”, “B”로 대체(Input_SimpleText) → DB의 자연어들도 값을 “A”,”B”로 저장(DB_SimpleText)합니다.
Step2: 단순화된 문장과 코사인 유사도가 높은 DB의 자연어 문장-sql문 쌍을 가져옵니다.
Step3: CoT통해서 단순화된 입력 문장을 sql문 형태로 바꾸게 한 다음, Input_SimpleText 및 DB_SimpleText 각각의 complexity score 측정하여, 둘이 유사하면 좋은 Retrieval로 평가합니다.
Step4: 해당 난이도의 text2sql에 특화된 llm agent로 유저입력 자연어**(InputText)와 (SimpleText)**전송합니다.
Step5: retrieval : 유저입력 자연어**(InputText)**의 밸류값들을 뽑을 수 있는 컬럼들을 description기반으로 컬럼 db에서 검색, llm의 프롬프트로 가져옵니다.
Step6: 입력으로 instruction, 컬럼 정보, 출력 예시를 받아서 출력으로 최종 sql문을 생성합니다. val set에 대한 EX, EM를 기준으로 최종 출력의 정확도를 평가합니다.
# SQL문 단순화 전략
# 1. 구조적 특성을 잘 표현하는 형태로 바꾸기 위함
# 2. 인하우스 데이터의 value값을 외부 유출시키지 않기 위함
def DELETE_blank(sql_query):
    sql_query = re.sub(r'\s+', ' ', sql_query).strip()
    return sql_query

def REPLACE_value_to_A(sql_query):
    # 정규 표현식 패턴 정의
    # 1. 문자열 리터럴
    string_pattern = r"'.*?'"
    # 2. 숫자 리터럴
    number_pattern = r"\b\d+(\.\d+)?\b"
    # 3. 테이블이나 필드명을 제외한 단어 리터럴
    word_pattern = r"\b(?!SELECT|FROM|WHERE|GROUP\s+BY|ORDER\s+BY|HAVING|JOIN|ON|AS|AND|OR|NOT|NULL|IS|LIKE|IN|BETWEEN|EXISTS|ALL|ANY|SOME|UNION|INTERSECT|LIMIT|MINUS|DISTINCT|CASE|WHEN|THEN|ELSE|END)\w+\b"
    # 문자열 리터럴을 "A"로 대체
    sql_query = re.sub(string_pattern, "'A'", sql_query, flags=re.IGNORECASE)
    # 숫자 리터럴을 "A"로 대체
    sql_query = re.sub(number_pattern, "A", sql_query, flags=re.IGNORECASE)
    # 단어 리터럴을 "A"로 대체
    sql_query = re.sub(word_pattern, "A", sql_query, flags=re.IGNORECASE)
    return sql_query

def REPLACE_consecutive_A_to_B(sql_query):
    # 연속적인 A를 B로 대체
    sql_query = re.sub(r'\b(A,\s*){2,}A\b', 'B', sql_query)
    sql_query = re.sub(r"\('A',\s*'A'(,\s*'A')*\)", '(B)', sql_query)
    return sql_query
3. 팀 소개
3.1. 팀원 소개
저희 skql팀은 연세대학교 대학원생 이지훈, 김지원, 김민정으로 구성된 팀입니다.
훌륭하신 멘토님들과 협업하여 SKT의 AI 기술 도약에 기여할 수 있도록 노력하겠습니다.
사용자 자연어 쿼리를 기반으로 SQL문을 작성하는 본 과제(A-02번)는, 저희 연구실이 중점적으로 연구하는 주제(LLM, Conversational AI)와 연관성이 매우 큽니다.
SKT AI Fellowship A-02번 과제 공고를 보자마자 이 과제는 저희를 위한 것이라고 생각하였습니다.
앞으로 남은 기간동안 멘토님들의 지도편달을 받으며 "열심히", "즐기며", "잘" 연구하겠습니다.
3.2. ground rule
펠로우 정기 회의는 격주 수요일에 진행하고, 온라인과 오프라인을 번갈아 가며 미팅을 진행할 계획입니다.
정기 회의를 통해 프로젝트 진행 상황을 공유하고 트러블 슈팅, 앞으로 진행 방향 등에 대해 얘기 나눌 예정입니다.
정기 회의 외에도 대화 채널을 통해 실시간으로 긴급한 사안이나 간단한 논의 사항에 대해 소통하여 더욱 원활하고 효율적인 작업 환경을 조성할 것입니다.
3.3. 팀 채널
Notion과 Slack, AWS repository를 통해 일정과 진행 상황, 코드를 실시간으로 멘토님들 및 팀원들과 공유하고 있습니다.
kk8081 님의 최신 블로그
더보기-
- AI Chatbot for Data Analytics Text2SQL - 연구결과(3)
- 안녕하세요! 저희는 'AI Chatbot for Data Analytics Text2SQL' 주제를 연구한 skql팀 입니다. 이번 포스트에서는 10월 31일 진행되었던 최종발표에서 발표한 저희 주제 및 내용을 공유드리겠습니다. 1. Background 연구배경 SQL은 데이터베이스에서 자료를 처리하는 용도로 사용되는 구조적 데이터 질의 언어이며, SQL을 통해 사용자들은 데이터베이스에서 쉽게 자료를 찾거나 저장할 수 있습니다. 데이터 분석을 통해 인사이트를 발견하는 것부터, 파이프라인 개발이나 프로그래밍에 활용하는 등 다양한 곳에 데이터가 사용되면서 SQL의 중요성이 증가하는 추세입니다. IDCube (ICT Infra의 data warehouse 및 분석 환경...
-
- AI Chatbot for Data Analytics Text2SQL - 연구과정(2)
- 안녕하세요! 저희는 'AI Chatbot for Data Analytics Text2SQL' 주제를 연구 중인 skql팀 입니다. 이번 포스트에서는 8월 22일 진행되었던 중간발표에서 발표한 저희 주제 및 진행 상황에 대해 설명드리고, 중간발표에서 얻은 피드백 기반으로 설립한 향후 계획을 공유드리겠습니다! 1. 과제의 주요 내용 저희는 현재 크게 두 개의 태스크, Text2SQL과 이벤트 분석을 진행하고 있습니다. Text2SQL 연구 목표 / 내용 / 배경 저희가 개발 중인 Text2SQL 챗봇은 자연어를 입력하면 SQL문을 반환해 주는 챗봇입니다. 이는 SQL에 익숙지 않은 데이터 분석가 및 기타 유저들을 위해 만들어졌고, 그들의 업무 편리성 및 효율성을 제공...
-
- RAG 및 LLM 파인튜닝을 통한 Text2SQL 모델 성능 개선 - 연구계획(1)
- 안녕하세요! 저희는 SKT AI Fellowship 6기 a-02번 과제를 맡은 skql(슼큐엘) 팀입니다! 이번 포스트를 통해 저희 팀의 연구 주제와 진행 방법에 관해 설명드리겠습니다! 1. 연구 과제 소개 1.1. 연구 목표/내용/배경 데이터분석에 관심이 많으신 분이라면 SQL을 한 번 쯤은 들어보셨을텐데요. SQL은 데이터베이스에서 자료를 처리하는 용도로 사용되는 구조적 데이터 질의 언어이고, SQL을 통해 사용자들은 데이터베이스에서 쉽게 자료를 찾거나 저장할 수 있습니다. 데이터 분석을 통해 인사이트를 발견하는 것부터, 파이프라인 개발이나 프로그래밍에 활용하는 등 다양한 곳에 데이터가 사용되면서 SQL의 중요성이 증가하고 있습니다. 이에 저희는 IDCube...
DEVOTEE 추천 블로그
-

- 지능형 데이터 검색 엔진 개발 - 연구결과(3)
- 안녕하세요. SKT AI FELLOWSHIP 3기 2번 과제 지능형 Data 검색 엔진 개발 프로젝트에 참여한 D905입니다. 저희 팀은 SKT 내부 통신 데이터 분석 서비스 개발이라는 프로젝트에 참여하였고 본 서비스는 데이터베이스에 대한 자연어 질문을 SQL 질의로 변경해주는 태스크 중점으로 진행되었습니다. 본 포스팅에서는 6개월간의 Fellowship 기간 동안 진행했던 최종 연구 결과물을 정리하고자 합니다. @ 연구계획 보러가기 https://devocean.sk.com/search/techBoardDetail.do?ID=163214 @ 연구과정 보러가기 https://devocean.sk.com/search/techBoardDetail.do?ID=16333...
-
- AI Chatbot for Data Analytics Text2SQL - 연구과정(2)
- 안녕하세요! 저희는 'AI Chatbot for Data Analytics Text2SQL' 주제를 연구 중인 skql팀 입니다. 이번 포스트에서는 8월 22일 진행되었던 중간발표에서 발표한 저희 주제 및 진행 상황에 대해 설명드리고, 중간발표에서 얻은 피드백 기반으로 설립한 향후 계획을 공유드리겠습니다! 1. 과제의 주요 내용 저희는 현재 크게 두 개의 태스크, Text2SQL과 이벤트 분석을 진행하고 있습니다. Text2SQL 연구 목표 / 내용 / 배경 저희가 개발 중인 Text2SQL 챗봇은 자연어를 입력하면 SQL문을 반환해 주는 챗봇입니다. 이는 SQL에 익숙지 않은 데이터 분석가 및 기타 유저들을 위해 만들어졌고, 그들의 업무 편리성 및 효율성을 제공...
-
- AI Chatbot for Data Analytics Text2SQL - 연구결과(3)
- 안녕하세요! 저희는 'AI Chatbot for Data Analytics Text2SQL' 주제를 연구한 skql팀 입니다. 이번 포스트에서는 10월 31일 진행되었던 최종발표에서 발표한 저희 주제 및 내용을 공유드리겠습니다. 1. Background 연구배경 SQL은 데이터베이스에서 자료를 처리하는 용도로 사용되는 구조적 데이터 질의 언어이며, SQL을 통해 사용자들은 데이터베이스에서 쉽게 자료를 찾거나 저장할 수 있습니다. 데이터 분석을 통해 인사이트를 발견하는 것부터, 파이프라인 개발이나 프로그래밍에 활용하는 등 다양한 곳에 데이터가 사용되면서 SQL의 중요성이 증가하는 추세입니다. IDCube (ICT Infra의 data warehouse 및 분석 환경...
-
- IA팀: LLM 기반 데이터 리니지 활용 Impact Analysis 대화형 에이전트 기술 개발 - 연구계획 (1)
- 안녕하세요! 👋 저희는 SKT AI Fellowship 7기에서 "LLM 기반 데이터 리니지 활용 Impact Analysis 대화형 에이전트 기술 개발" 과제를 수행하고 있는 IA 팀입니다! IA는 Impact Analysis의 머릿글자를 따서 지은 이름이에요. 이름처럼 인사이트풀한 문제를 분석하고 풀어내서 영향력 있는 팀이 되겠다는 포부를 담고 있습니다! 다음으로 본격적인 연구 과제를 소개하고 저희 팀이 그 과제를 어떻게 풀어나가려고 하는지에 대해서 자세히 적어보겠습니다. 1. 연구 과제 소개 🔎 연구 배경 및 필요성 현대의 데이터 플랫폼에서는 테이블 컬럼 하나만 바꿔도 대시보드가 깨지고, 모델이 실패하고, 그 책임은 누군가에게 돌아갑니다. 실제로 테이블 ...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.