
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
[반도체 데이터분석 도전기] (1) 주제 선정 및 NAND Cell Distribution 기초

- DEVOTEE 요약
- SSD의 내부 동작을 관리하는 펌웨어가 정상적으로 작동하는지 검증하는 업무를 맡고 있는데 데보션에서는 'NAND Distribution Analysis Tool' 및 불량 분석 프로젝트를 도전해보고 싶습니다. 또한, 데이터를 생성하고 분석하는 과정에서 주의해야 할 여러 요소들을 고려하고 있습니다.
안녕하세요 😀 SK하이닉스에서 SSD Verification 관련 일을 하고 있는 정해웅 TL이라고 합니다.
이렇게 DEVOCEAN에 처음 인사드리게 되었습니다.
대학부터 꾸준히 기술 관련 블로그를 써왔고 회사에서도 관련 기회가 있으면 좋을 것 같다 생각했었는데,
SK 그룹에서 운영하는 데보션이라는 좋은 취지의 기술 커뮤니티에 개발 전문가로 동참하게 되어 영광이라고 생각하고 있습니다.
1️⃣ 무슨 일을 하고 있는지?
개발 관련 이야기를 하기 전에, 회사에서 어떤 일을 하고 있는지 먼저 소개드리는게 맞는 순서인 것 같아 간략하게 설명드리고자 합니다.
저는 SK하이닉스의 Solution PE라는 직무로 입사하였고, 현재는 SSD Verification 관련 팀에 있습니다.
SSD는 컴퓨터에 탑재되는 저장장치입니다. SSD가 겉으로 보기에는 사진, 문서 등 저장하고 있는 단순한 저장매체로 생각하실 수 있지만, 내부에서는 굉장히 많은 동작들이 돌아가고 있습니다.
예를 들어, 단순히 컴퓨터에 저장된 문서를 지우거나 쓸 때도 실제 내부에서는 이러한 동작들을 효율적으로 관리하기 위해 열심히 내부 동작이 돌아가고 있습니다.
이러한 SSD의 내부 동작들을 HW 부품인 'Controller'와 이를 운용하는 SW인 'Firmware'를 기반으로 관리하고 있고,
저는 그중 SSD 내부 동작을 관리하는 'Firmware'가 정상적으로 동작하고 있는지를 검증(Verification)하는 업무를 맡고 있습니다.
이를 위해 Firmware가 잘 동작하고 있는지를 판별할 수 있는 코드를 짜고 있고, 다수의 PC에서 SSD를 Test하여 비정상적으로 동작하는 불량을 찾아내고
결론적으로는 SW, HW적으로 불량이 없는 SSD를 개발하여 소비자와 고객사에게 전달하는 임무를 맡고 있습니다.
그중 저는 client SSD, 즉 PC나 노트북에 들어가는 SSD를 개발하고 있고 현재도 새로운 SSD를 개발하고 있습니다.
개인적으로 '불량 분석'이라는 분야를 좋아했던 저에게 흥미로운 분야라고 생각하고 있고,
열심히 검증하고 불량 찾아내어 모두 개선된 SSD가 소비자, 고객사들에게까지 간다면 굉장히 뿌듯할 것 같습니다.
하기 그림은 현재 저희 부서에서 개발 중인 Soluition 제품들입니다.
그림1. https://news.skhynix.co.kr/post/jeonginseong-column-ai-3
2️⃣ 데보션에서 해보고 싶은 Side Project는?
저는 데이터분석과 반도체를 대학교 시절부터 꾸준히 좋아해왔습니다.
특히 반도체 데이터분석에 관련된 ML, DL, Visualization 등 다양한 프로젝트를 진행해왔는데요.
이번에 데보션에서 해보고 싶은 프로젝트는 바로 'NAND Distribution Analysis Tool 및 불량 분석'을 관련하여 진행해보려고 합니다.
SSD에 데이터를 쓰면 NAND라는 반도체에 해당 데이터가 쓰여지게 되고 이는 셀 저장방식에 따라 SLC, MLC, TLC, QLC 등으로 쓰이게 되는데요.
이렇게 저장되면 NAND 산포에 의해 일정한 형태의 그래프를 그리게 됩니다.
이러한 NAND Distribution에 대해 분석하고, 또 불량이 발생했을 때 Detect하는 알고리즘을 개발하고자 합니다.
하기 순서로 프로젝트를 진행해보려고 합니다.
NAND Distribution에 대한 기초 지식 습득 (논문 등 파악)
NAND Distribution 관련 실험 데이터 생성
해당 데이터 Visualization 및 Analysis Tool 개발
불량 Wordline Anomaly Detection 알고리즘 개발
3️⃣ 실험 데이터 관련 주의사항
먼저 NAND Distribution이라는 것 자체가 회사마다 특성과 데이터의 형태가 다를 것이고,
이는 보안과도 연결되어 있어 Side Project로 분석하기 위해선 실험 데이터를 생성해야겠다는 생각을 했습니다.
NAND Distribution의 경우, 여러 논문에서도 다루는 주제이기도 하고 형태 자체가 찾기 어려운 형태가 아니므로 정형적인 NAND Cell 분포를 직접 만들어보고 분석하는 형태로 진행해볼까 합니다.
4️⃣ 데이터 생성 시 고려해야할 점
(1) 데이터 형태(2) Scale(3) Cell Number(4) Fail 유형 (Retention, Disturb 등)를 먼저 고려해야 하는데요.
1) 데이터 형태
NAND Cell Distribution의 경우, 행 : Threshold Voltage, 열 : Wordline, Value : # of Cell의 형태로 구성되어 있습니다. 이를 기반으로 데이터 형성하려고 합니다. 관련 형태는 사진 첨부드리겠습니다.
2) Scale
NAND Cell 분포의 경우, 데이터 형성 후 Log Scale로 변환하여 데이터를 보게 됩니다. Log Scale로 변환 시, 데이터 간의 상대적 비율로 나타낼 수 있기 때문에 더 넓은 범위의 값을 분석할 수 있게 됩니다.
3) Cell Number
NAND에는 데이터 저장 방식에 따라 SLC, MLC, TLC, QLC 등으로 나눌 수 있는데요. 이에 따라 Distribution 형태가 바뀌게 됩니다. 저는 SLC와 TLC에 대한 데이터를 형성해볼까 합니다.
4) Fail 유형
저희가 ML, DL 등의 실험을 할 때 가장 중요한 것은 라벨링이 아닐까 싶은데요. 실험 데이터 형성에 있어서 Fail 유형을 어떻게 할까 고민하다가,
다중 분류를 시도해보는 것이 어떨까 싶어 Disturb, Retention 등 NAND Flash에서 발생할 수 있는 불량 유형들을 공부하고 삽입해보려고 합니다.
NAND Distribution 데이터는 하기 그림처럼 Cell Number에 따라 다르게 분포됩니다.
그림2. https://news.skhynix.co.kr/post/data-in-nand-flash-memory
이렇게 먼저 데이터 형태에 대해 고려해봤습니다.
무턱대고 만드는 것보다 논문과 블로그 등 살펴보면서 천천히 데이터 생성하는 작업 진행해보려고 합니다.
다음 게시물에는 실제로 NAND Distribution Dataset 생성하는 것으로 돌아오겠습니다 😇
감사합니다.
해롱 님의 최신 블로그
더보기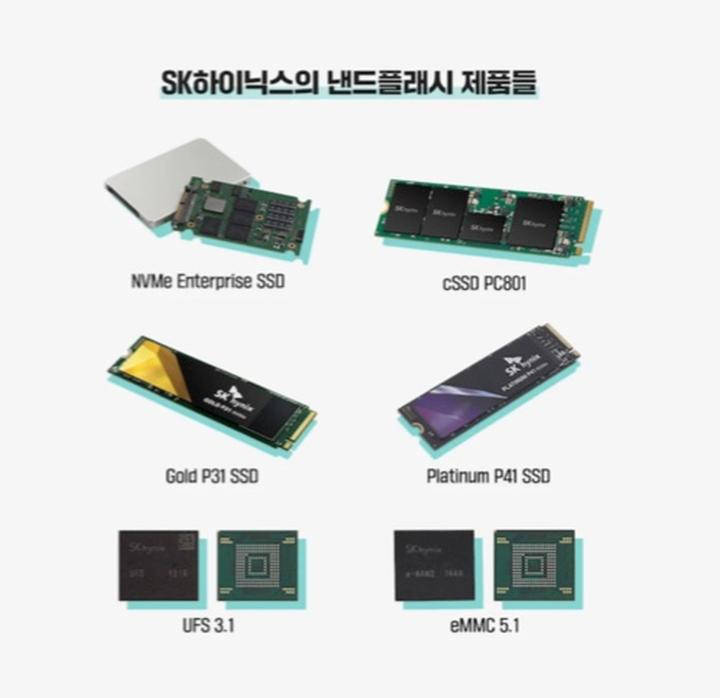

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.