
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
대용량 벡터 검색 라이브러리, Faiss를 소개합니다.

- DEVOTEE 요약
- 빅데이터를 다루기 위해서는 텍스트, 이미지, 소리 등의 비정형 데이터를 기계가 이해할 수 있는 연속형 수치인 벡터로 변환하는 인코딩 과정이 필요합니다. 이렇게 생성된 컨텍스트 벡터를 벡터 공간에 효율적으로 투영하고, 유사도 기반 검색을 위해 Faiss라는 라이브러리를 사용할 수 있습니다. Faiss는 Facebook에서 개발한 벡터의 유사도 측정과 클러스터링에 최적화된 라이브러리로, GPU 지원과 C++ 개발로 인해 대용량 데이터 처리에 매우 빠르고 효율적입니다.
늘어나는 빅데이터는 대용량 Vector Space로 이어져..
Text, Image, Sound 등 다양한 비정형 정보원을 데이터로써 다룰 때, 먼저 고민하는 부분은 Machine이 이해할 수 있는 연속형 수치, 즉 Vector로 변환하는 것에 대해서 입니다.
다양한 Modality에 담겨있는 맥락과 정보를 함축한 Context Vector를 어떻게 잘 만들까 에 대한 고민이죠, 흔히 인코딩이라고 불리는 작업입니다.
좋은 인코딩을 통해 Context Vector들을 하나의 Vector Space에 투영했다면, 그 다음엔 이것을 어떻게 잘 활용할까 에 대한 고민이 뒤따릅니다.
Embedding 작업이 잘 되었다면 하나의 Vector Space안에서는 맥락이 유사한 Vector들은 가까이 위치하게 됩니다.
이를 활용해서 유사도 기반의 검색(retrieval) 서비스를 제공할 수 있습니다.
이때 유사도는 주로 거리 기반의 유클리드 거리(Euclidean distance)와 각도 기반의 코사인 유사도(cosine similarity)를 통해 측정하며,
흔히 최근접 이웃(K-Nearest Neighbors) 알고리즘을 활용하여 검색시 k개의 유사한 결과를 출력합니다.
[Cosine similarity vs Euclidean distance]
하지만 점차 늘어나는 대용량 데이터에 따라 Vector Space 내 검색을 위한 연산 비용은 기하급수적으로 늘어날 수 밖에 없습니다.
이때 고민해 볼 수 있는 라이브러리, Faiss를 소개해 드립니다.
What is Faiss?
Faiss는 Facebook에서 개발 및 배포한 밀집 벡터의 유사도 측정과 클러스터링에 효율적인 라이브러리입니다.
보통 벡터 유사도(vector similarity)를 구할 때는 numpy나 scikit-learn에서 제공해주는 cosine similarity등 을 많이 사용하는데,
GPU를 지원하며, C++로 개발된 덕분에 Faiss를 사용하면 훨씬 빠르고 강력하게 유사도를 측정할 수 있습니다.
Quick Start
본 Demo에서는 Google Colab을 활용하였으며,
설치는 CPU와 GPU에 따라 다음 구분을 통해 install 할 수 있습니다.
# CPU instance with colab
#!apt install libomp-dev
#!pip install faiss

# GPU instance with colab
!pip install faiss-gpu
Demo를 위해 200*300의 가상의 Vector space를 만들어보죠.
np.random.seed(10)
vector_data = np.random.rand(200, 300).astype('float32')
사용법은 너무나 쉽습니다.
Vector space의 차원수를 넘겨주면서, IndexFlatL2 해주면 L2, 즉 유클리드 거리를 기반으로 Indexing을 하겠다는 설정입니다.
이후 데이터를 add해주면 indexing이 이루어 집니다.
vector_dimension = vector_data.shape[1]
index = faiss.IndexFlatL2(vector_dimension)
index.add(vector_data)
이후 검색할 search vector를 지정하고, 가장 가까운 10개를 찾아줘라는 의미인 k=10과 함께 index.search 구문을 실행하면
검색 결과가 distance엔 거리 계산값이 indices엔 index가 담겨 반환됩니다.
# set search vector
search_vector = vector_data[8].reshape(1,-1)

# search
k = 10  # 유사도 검색할 k
distance, indices = index.search(search_vector.reshape(1,-1),k)
cosine similarity로 유사도 산출하려면..
코사인 유사도를 통해 유사도를 계산하고자 한다면, 역시 너무나 간단합니다.
IndexFlatL2 대신 IndexFlatIP 을 활용하면 되는데, 여기서 IP는 짐작하시다시피 코사인 유사도와 밀접한 Inner Product, 내적을 의미합니다.
원할한 코사인 유사도 산출을 위해서 data를 add해 주기전 normalize 해주는 것 정도 유의하면 간편하게 활용할 수 있습니다.
vector_dimension = vector_data.shape[1]
index = faiss.IndexFlatIP(vector_dimension)
faiss.normalize_L2(vector_data)

index.add(vector_data)
별도의 사용자 정의 index와 사용하고 싶다면..
한가지 더 알고 있으면 좋은 tip은 보통 Vector Space를 다룰 때 lookup table을 두는 경우가 많은데,
원본 데이터의 각종 카테고리, 코드 등 부가 정보와 생성한 Vector와의 매핑을 위해서이죠.
그럼 이렇게 유사도 기반 Indexing을 할 때에도 원래의 데이터를 찾아가기 위한 index를 함께 넘겨주면 활용에 있어 풍부해 질 것입니다.
아래처럼 ids 에 넘겨줄 index list를 주고, 이를 add_with_ids 구문과 함께 indexing하면 됩니다.
그러면 검색 결과로 내가 부여한 index가 반환 되게 되어 자유도 높게 작업을 진행할 수 있습니다.
# FAISS의 Index로 넘겨주기 위한 object
ids = ...

# 사용자정의 Index와 함께 사용..
vector_dimension = vector_data.shape[1]
index = faiss.IndexFlatL2(vector_dimension)
index = faiss.IndexIDMap2(index)
index.add_with_ids(x=vector_data, ids=ids)
간략하게 유사도 기반의 대용량 벡터 검색 라이브러리 Faiss를 살펴보았는데, 도움이 되시길 바라는 마음으로 글을 마칩니다.
박병선(알파를찾아서) 님의 최신 블로그
더보기-
- Advanced RAG Technique 기반 생성형AI 서비스 개발에 대한 연구 (6-7회차: RAG 구축)
- Advanced RAG Technique 모임 기록을 남깁니다. 길었던 명절 연휴도 있었고, 이번 모임은 6-7회차 예정된 Agenda를 Intensive하게 통합 하여 진행 하였습니다. 지난 다섯 번의 모임을 통해서 RAG의 시작부터 Advanced Techniques를 아우르는 총 15편의 논문을 Study하고 리뷰하였는데요. 이번 모임에서는 실제 RAG 구축에 있어 필수적인 Agenda를 중심으로 실증적인 내용들을 살펴보았습니다. 먼저 이종민님이 "Basic RAG using LangChain: Retriever & Reranker" 를 주제로 발표를 해주셨습니다. RAG 구축에 보편적으로 사용하는 Lang Chain을 활용하면 손쉽게 RAG Techniqu...
-
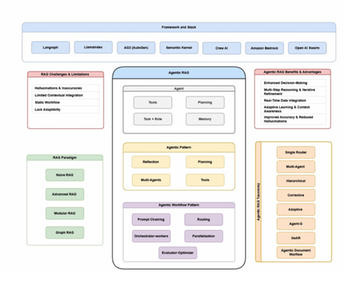
- Advanced RAG Technique 기반 생성형AI 서비스 개발에 대한 연구 (5회차: RAG 논문 정복)
- Advanced RAG Technique 5회차 모임기록을 남깁니다. 어느덧 5번째 모임을 가졌네요. 금일 살펴본 4편의 논문을 포함하여 벌써 15편의 RAG 관련 주요 논문을 살펴보고 있습니다. 여러 RAG Technique를 통해서 최종 응답 품질을 향상 시켜나가지만, 기본 Retriever의 성능에 일정 부분 의존 할 수 밖에 없습니다. 먼저 "최고의 Retriever" 에 관하여 논의하기 위해 관련 논문을 살펴 보았습니다. 성능 평가를 위한 framework, Sparse Retriever의 역할, 앙상블 접근의 유효성 등 에 대해 살펴볼 수 있는 시간이었습니다. LLM 관련 과제를 진행하다보면 항상 고민하게 되는 부분이 어떻게 응답 품질의 신뢰성을 평가하...
-
- Advanced RAG Technique 기반 생성형AI 서비스 개발에 대한 연구 (4회차: RAG 논문 정복)
- 벌써 오픈랩 모임 4회차를 진행하게 되었습니다. 금일은 RAG분야 주요 논문 중 하나인 "Modular RAG..." 를 포함해서 RAG 관련 논문 3편을 리뷰 했습니다. 높은 참여율 속에 각 발표 담당자께서 성실히 준비해 주신 덕분에 RAG에 대한 논문을 바탕으로 심도있게 이야기 나누어 볼 수 있었던 자리였습니다. RAG Master를 향하여 Go Go !
-
- Advanced RAG Technique 기반 생성형AI 서비스 개발에 대한 연구 (3회차: RAG 논문 정복)
- 지난주에 이어 연달아 오픈랩 모임을 가졌습니다. 연이어 RAG 관련 논문 4편을 리뷰 했는데, 발표를 성실히 준비해 주신 덕분에 RAG에 대한 인사이트에 더불어 여러 이야기들을 심도있게 나눌 수 있었습니다. 현업에서도필수 논문이라 불리어지는 100+ 개의 연구가 집약된 서베이 논문을 살펴보았고, 자가 검증의 피드백 흐름을 제언한 Self-RAG, Corrective RAG, 그리고 Fusion 의 개념을 살펴볼 수 있는 논문도 함께 살펴보았습니다. 좋은 장소에서 유익한 시간을 보내었네요. 오늘 하루도 수고 많으셨습니다~!!
DEVOTEE 추천 블로그
-
- 벡터 유사도 검색이 무엇인가요? (What is Vector Similarity Search?)
- AI 인프라/도구 개발사 ENCORD의 글을, 허락 하에 번역하여 공유합니다. ENCORD에서 작성한 원문은 아래 링크를 눌러 보실 수 있습니다. ⚠️ 이 글에는 ENCORD의 Annotate 서비스 등을 홍보하는 문구가 포함되어 있습니다. 원문 : https://encord.com/blog/vector-similarity-search/?utm_source=pytorchkr 번역문 : https://discuss.pytorch.kr/t/what-is-vector-similarity-search/2475 벡터 유사도 검색은 무엇인가요? / What is Vector Similarity Search? Akruti Acharya • June 12, 2023 • 5 mi...
-

- 영화 추천 여정으로 이해하는 Qdrant 벡터 데이터베이스
- 요즘 RAG를 프로젝트에 도입하면서 Qdrant를 Vector DB로 도입하여 구축을 진행하고 있습니다. Qdrant Vector DB에서 사용하는 용어를 데이터의 생성부터 CRUD 측면으로 이해해 보는 것이 좋을 것 같습니다. 당신은 영화 추천 시스템을 구축하기 위해 Qdrant라는 벡터 데이터베이스를 만나게 되었습니다. 이 데이터베이스를 이용해 데이터를 저장하고 검색하면서 CRUD 개념을 자연스럽게 이해하게 될 것입니다. 이번 글에서는 Qdrant의 주요 기능을 실제 API 요청 예시와 함께 알아보겠습니다. 이를 통해 사용 예시와 함께 Qdrant의 강력한 기능을 직접 체감해 보세요. 영화 데이터의 저장소: Collection과 Point Qdrant에서 데이...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.