
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
LangChain LCEL과 RAGAS를 사용한 Native RAG 평가
- DEVOTEE 요약
- LangChain의 LCEL을 사용해 Native RAG를 구현하고, RAGAS 라이브러리로 평가를 진행한 내용입니다. 먼저, Azure LLM을 임포트하고 Embedding 초기화를 진행했으며, 웹 기반 로더를 통해 문서를 로딩하고 Vectorstore에 저장했습니다. 그 다음, LCEL을 사용해 RAG Chain을 구현하고, RAGAS를 사용해 문서와 생성된 응답을 평가했습니다. 이 과정을 통해 faithfulness, answer relevancy, context recall, context precision, answer correctness 등의 평가 지표를 얻을 수 있었습니다.
LangChain LCEL을 사용해서 Native RAG를 구현하고 RAGAS library를 사용해 평가를 진행해보겠습니다.
최근에 LangChain에 추가된 LCEL과 새로운 package 구조도 체험해보고, RAG 평가를 손쉽게 도와주는 RAGAS도 한번에 확인해보려고 합니다.
코드 예제는 Nayak님의 Medium 글을 참고하면서, 최신 LangChain 버전에 맞게 코드를 일부 업데이트 하였습니다.
Azure LLM 과 Embedding 초기화
import os
from langchain_openai import AzureChatOpenAI
from langchain_openai import AzureOpenAIEmbeddings

embeddings = AzureOpenAIEmbeddings(
    model="text-embedding-ada-002",
    openai_api_version="2024-02-15-preview",
    azure_endpoint=os.getenv("AZURE_ENDPOINT"),
    api_key=os.getenv("AZURE_OPENAI_KEY"),
)

llm = AzureChatOpenAI(
    model="gpt-4-32k",
    azure_endpoint = os.getenv("AZURE_ENDPOINT"),
    api_key=os.getenv("AZURE_OPENAI_KEY"),
    api_version="2024-02-15-preview"
)
문서 로딩하고 Vectorstore에 저장하기
from langchain_community.document_loaders import WebBaseLoader
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.vectorstores import Chroma

loader = WebBaseLoader(
    "https://blog.langchain.dev/langchain-v0-1-0/"
)
documents = loader.load()

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size = 1250,
    chunk_overlap = 100,
    length_function = len,
    is_separator_regex = False
)
split_docs = text_splitter.split_documents(documents)
vectorstore = Chroma.from_documents(
    documents=split_docs,
    embedding=embeddings,
    persist_directory="./Vectorstore/chromadb"
)
LCEL 사용해 RAG Chain 구현
from operator import itemgetter

from langchain import hub
from langchain_core.runnables import RunnablePassthrough
from langchain_core.output_parsers import StrOutputParser

retriever = vectorstore.as_retriever()
prompt = hub.pull("rlm/rag-prompt")

def format_docs(args):
    docs = args["source_docs"]
    return "\n\n".join(doc.page_content for doc in docs)

rag_chain = (
    RunnablePassthrough.assign(
        question=itemgetter("question")
    )
    | {
        "source_docs" : itemgetter("question") | retriever,
        "question": itemgetter("question"),
    }
    | {
        "source_docs": itemgetter("source_docs"),
        "answer": {
            "context": format_docs,
            "question": itemgetter("question"),
        } | prompt | llm | StrOutputParser()
    }
)

rag_chain.invoke({"question" : "What are the major changes in v 0.1.0?"})
RAGAS 평가 시 참고한 문서도 필요하기 때문에, LangChain Retrieval LCEL 예제를 참고해
생성된 응답("answer") 외에도 참고한 문서("source_docs")를 함께 return하도록 했습니다.
{'source_docs': [Document(page_content='versioning policy for a little over a month now.langchain itself, however, still remained on 0.0.x versions. ... See more towards the end of this post on our plans for that.While re-architecting the', metadata={'language': 'en', 'source': 'https://blog.langchain.dev/langchain-v0-1-0/', 'title': 'LangChain v0.1.0'}),
  ... ],
 'answer': 'The major changes in v 0.1.0 include a new versioning standard where breaking changes to the public API result in a minor version bump and bug fixes or new features result in a patch version bump. Additionally, the v 0.1.0 release of langchain is the first stable version, fully backwards compatible, available in both Python and JavaScript with improved focus and documentation. Architectural changes were made such as separating langchain-core and partner packages from langchain and old, unused functionality was removed.'}
RAGAS 사용해서 Synthetic Testset 만들기
from ragas.testset.generator import TestsetGenerator
from ragas.testset.evolutions import simple, reasoning, multi_context

generator = TestsetGenerator.from_langchain(
    generator_llm=llm,
    critic_llm=llm,
    embeddings=embeddings
)
testset = generator.generate_with_langchain_docs(split_docs, test_size=10, distributions={simple: 0.5, reasoning: 0.25, multi_context: 0.25})

test_df = testset.to_pandas()
test_questions = test_df["question"].values.tolist()
test_groundtruths = test_df["ground_truth"].values.tolist()
test_df.head()
기본적으로 OpenAI를 사용하지만, from_langchain을 이용하면 위에서 설정한 Azure OpenAI API를 그대로 사용가능합니다.
RAG Chain을 사용해 응답 생성
from datasets import Dataset

answers = []
contexts = []

for question in test_questions:
  response = rag_chain.invoke({"question": question})
  answers.append(response['answer'])
  contexts.append([context.page_content for context in response['source_docs']])

response_dataset = Dataset.from_dict({
    "question" : test_questions,
    "answer" : answers,
    "contexts" : contexts,
    "ground_truth" : test_groundtruths
})
RAG 평가하기
from ragas import evaluate
from ragas.metrics import (
    faithfulness,
    answer_relevancy,
    answer_correctness,
    context_recall,
    context_precision,
)

metrics = [
    faithfulness,
    answer_relevancy,
    context_recall,
    context_precision,
    answer_correctness,
]

naive_results = evaluate(response_dataset, metrics, raise_exceptions=False)
평가 결과
{
 'faithfulness': 1.0000,
 'answer_relevancy': 0.9347,
 'context_recall': 1.0000,
 'context_precision': 0.8750,
 'answer_correctness': 0.6409
}
이렇게 Native RAG 평가를 수행해 보았습니다.
원본 예제에는 Native RAG 외에도 Reranker나 Contextual Compression Pipeline을 포함하는 Advanced RAG 예제도 있습니다.
그 경우, Faithfulness와 context precision과 recall이 향상된 것을 확인할 수 있어 관심있는 분들은 참고하셔도 좋을 것 같습니다.
Injee 님의 최신 블로그
더보기-
- LangChain LCEL과 RAGAS를 사용한 Native RAG 평가
- LangChain LCEL을 사용해서 Native RAG를 구현하고 RAGAS library를 사용해 평가를 진행해보겠습니다. 최근에 LangChain에 추가된 LCEL과 새로운 package 구조도 체험해보고, RAG 평가를 손쉽게 도와주는 RAGAS도 한번에 확인해보려고 합니다. 코드 예제는 Nayak님의 Medium 글을 참고하면서, 최신 LangChain 버전에 맞게 코드를 일부 업데이트 하였습니다. Azure LLM 과 Embedding 초기화 import os from langchain_openai import AzureChatOpenAI from langchain_openai import AzureOpenAIEmbeddings embeddings = ...
-
- 개발자의 글쓰기 : Technical Writing #3
- 안녕하세요! Technical Writing 사내 스터디 모임에서 연재하는 세번째 글입니다. 이전 게시글은 아래 링크에서 보실 수 있습니다. #1 Technical Writing 소개 및 주요 독자 #2 문서화 계획과 초안 작성 이어서 오늘은 Docs for Developers 5~7 장의 내용인 기술 문서 내 샘플 코드, 시각(비쥬얼) 콘텐츠 그리고 문서 배포 전략에 대해서 간단히 다루겠습니다. 5장. 샘플 코드 통합의 미학 개발 문서에서 샘플 코드의 중요성은 두말할 나위 없습니다. 샘플 코드는 개발자들에게 실제로 어떤 작업을 하는지를 보여주는 '길잡이' 역할을 합니다. 이러한 코드는 다음과 같은 특징을 가져야 합니다. 실용성: 코드는 실제로 사용할 수 있어야 ...
DEVOTEE 추천 블로그
-
- OpenLab - LLMOps : Ragas Getting Started
- Installation 파이썬 가상환경에서 pipenv 도구를 통해 파이썬 패키지를 설치합니다. pipenv install !cat ../Pipfile Generate a Synthetic Test Set 이 튜토리얼에서는 RAG 파이프라인을 평가하기 위한 합성 평가 데이터 세트를 만드는 방법을 안내합니다. 이를 위해 OpenAI 모델을 활용합니다. 사용자 환경 내에서 OpenAI API 키를 환경변수로 입력합니다. 아래 코드의 경우 .env 파일에 OPENAI_API_KEY= 설정하고, load_dotenv 함수를 이용하여 환경변수를 한번에 로딩했습니다. from dotenv import load_dotenv import os load_dotenv(verbose...
-
- OpenLab - OpenLLM, LLaMA3 을 이용한 RAG 구축 + Ollama 사용법 정리
- 스터디 운영자님의 스터디 운영 경과와 함께 스터디 내용 요약 정리해보았습니다. 0. 스터디 운영 공지 대부분의 멤버가 OpenLLM을 이용한 RAG 코드 개념 이해하는 것으로 확인되어 다음 스터디(6/19) 전(6/16)까지 3개 주제별로 OpenLLM 을 이용한 챗봇까지 개발해서 충분한 주석을 포함하고 챗봇 화면을 캡처해서 완성된 코드 버전을 제출할 예정입니다. 1. RAG Llama3-KO 를 이용해 RAG 를 구현해 보겠습니다. RAG 에 사용할 PDF로 근로기준법을 다운로드하여 사용했습니다. https://www.law.go.kr/법령/근로기준법 필요한 라이브러리 임포트 import os import warnings warnings.filterwarning...
-
- OpenLab - LLMOps, RAGAS LLM 평가지표 (Faithfulness)
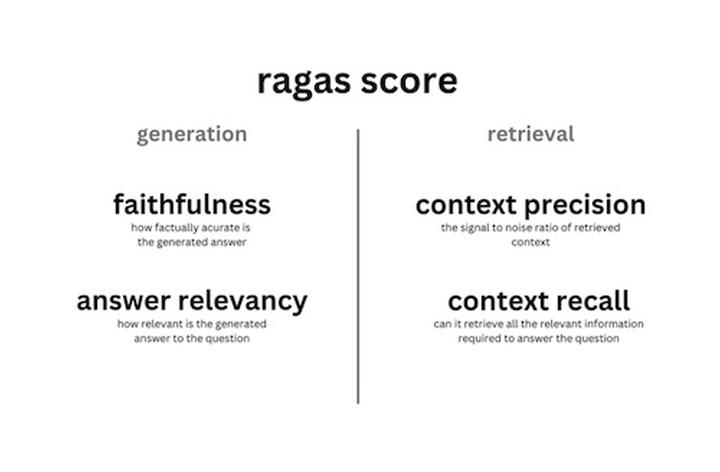
- RAGAS 는 LLM 평가를 위한 데이터셋을 생성하고, 이를 평가하기 위한 LLM Evaluation 프레임워크 입니다. 주요 평가 지표 항목으로 아래 그림 (ragas score)과 같이 생성 (generation), 데이터 획득 (retriever) 을 제공합니다. Component-Wise Evaluation 다른 머신 러닝 시스템과 마찬가지로 LLM 및 RAG 파이프라인 내의 개별 구성 요소의 성능은 전체 경험에 큰 영향을 미칩니다. Ragas는 RAG 파이프라인의 각 구성 요소를 개별적으로 평가하기 위한 맞춤형 메트릭을 제공합니다. Ragas 주요 성능 메트릭을 살펴보면 크게 Retrieval, Generation 각 카테고리 별 측면에서 메트릭을 정의할...
-

- RAG 파이프라인과 사고의 사슬(CoT) 프롬프팅을 활용한 최종 답변 출력 예시
- 환경 변수 로드: load_dotenv() 함수를 사용하여 .env 파일에 저장된 설정값을 호출 LLM 초기화: ChatOpenAI 클래스를 이용해 OpenAI의 챗 모델을 초기화temperature=0.0으로 지정하여 일관된 답변을 얻도록 함. 가짜 Retriever 정의: RAG 기법(Retrieval-Augmented Generation, 검색 증강 생성)에서 retriever는 질문과 관련된 문서를 검색해 주는 역할을 합니다. 이 예제에서는 간단히 미리 준비된 docs 딕셔너리에 세 개의 문서를 담아 두고, fake_retriever 함수를 통해 항상 상위 3개 문서를 반환하도록 하였습니다. 실제로는 검색 엔진이나 벡터 DB를 활용합니다. 최종 답변 파서 ...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.