
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
MLX: Apple silicon 용 Machine Learning 프레임워크 - 03.Multi-Layer Perceptron example
- DEVOTEE 요약
- 본 블로그는 MNIST 데이터셋을 활용하여 멀티레이어 퍼셉트론(MLP)을 구현한 예시를 제시하며, 이를 위해 MLX 라이브러리를 사용했습니다. 이 프로세스에서 MLP 클래스를 생성하고, 관련 모듈을 Import하여 학습을 진행했습니다. 또한, 동일한 코드를 PyTorch로 구현하여 비교해보았고, MLX 라이브러리의 장점인 CPU와 GPU의 통합 메모리 사용을 통해 학습 속도가 증가하는 것을 확인했습니다.
Multi-Layer Perceptron (MLP) example
MNIST 데이터셋을 이용한 Multi-Layer Perceptron (MLP) 예제를, MLX 를 이용해 구현해보도록 하겠습니다.
Torch 로 구현하는 것과 어떤 차이를 보이는지 비교해볼 예정입니다.
MLX 를 이용한 MLP 구현
우선 관련 모듈들을 import 해주겠습니다.
import mlx.core as mx
import mlx.nn as nn
import mlx.optimizers as optim

import numpy as np
from matplotlib import pyplot as plt

from time import time
MLP class 를 하나 만들어줍니다. 잘 보면 torch.nn 을 사용할 때와 거의 유사함을 확인할 수 있습니다.
라이브러리를 만들면서 이런 점들을 고려하지 않았을까 싶네요.
코드들을 건드리지 않고 import 하는 부분만 import torch.nn as nn 에서 import mlx.nn as nn 등으로 바꾸기만 해도 코드가 돌아갈 수 있는 것을 의도하지 않았을까요 (뇌피셜)
class MLP(nn.Module):
    def __init__(
        self,
        num_layers: int,
        input_dims: int,
        hidden_dims: int,
        output_dims: int
    ):
        super().__init__()
        layer_sizes = [input_dims] + [hidden_dims] * num_layers + [output_dims]
        self.layers = self._make_layers(layer_sizes)

    def _make_layers(self, layer_sizes):
        layers = []
        for idim, odim in zip(layer_sizes[:-1], layer_sizes[1:]):
            layers += [
                            nn.Linear(idim, odim),
                            nn.ReLU()
                       ]

        return nn.Sequential(*layers[:-1])

    def __call__(self, x):
        return self.layers(x)
Loss function 과 evaluation function 도 만들어주겠습니다.
이 또한 torch 와 거의 유사하게 구현되었습니다.
def loss_fn(model, X, y):
    # nn.losses.cross_entropy 는 logit 과 target 사이의 loss 를 계산해줌
    return mx.mean(nn.losses.cross_entropy(model(X), y))

def eval_fn(model, X, y):
    return mx.mean(mx.argmax(model(X), axis=1) == y)
Hyperparam 들을 설정하고, MNIST 데이터셋을 다운받아 전처리 해주도록 하겠습니다.
MLP 를 사용하기 때문에 ( 28 X 28 ) 의 이미지를 768 dimensions 으로 flatten 해줍니다.
num_layers = 2
hidden_dim = 256
num_classes = 10
batch_size = 256
num_epochs = 10
learning_rate = 1e-2

# Load the data
import mnist
train_images, train_labels, test_images, test_labels = map(
    mx.array, [
        mnist.train_images(),
        mnist.train_labels(),
        mnist.test_images(),
        mnist.test_labels(),
    ]
)
# Flatten the images
train_images = mx.reshape(train_images, [train_images.shape[0],-1])
valid_images, test_images = test_images[:-10], test_images[-10:]
valid_labels, test_labels = test_labels[:-10], test_labels[-10:]
valid_images = mx.reshape(valid_images, [valid_images.shape[0],-1])
Batch iterator 를 구현해주겠습니다. torch 는 dataloader 가 구현되어 있죠.
아직 MLX 는 따로 구현되어 있는 것은 찾지 못했습니다. (2023/12/17 기준)
def batch_iterate(batch_size, X, y):
    perm = mx.array(np.random.permutation(y.size))
    for s in range(0, y.size, batch_size):
        ids = perm[s : s + batch_size]
        yield X[ids], y[ids]
그럼 만들어진 MLP 를 학습시켜 보겠습니다.
PyTorch 와 다른 부분은 update 부분이 되겠습니다.
PyTorch 같은 경우 loss function 만 정의한 뒤 loss.backward(), optimizer.step(), optimizer.zero_grad() 를 통해 업데이트를 하죠.
MLX 는 nn.value_and_grad 를 통해 loss와 gradient를 구해주고, optimizer.update(model, gradient) 를 통해 model 을 업데이트합니다.
일단 제일 Learning scheduleer 같은 걸 쓰지 않고 SGD 로 간단하게 학습해보겠습니다.
Parameter initialize 도 랜덤이므로 가끔 학습이 안될때도 있으니 주의!!
# Load the model
model = MLP(num_layers=num_layers,
            input_dims=train_images.shape[-1],
            hidden_dims=hidden_dim,
            output_dims=num_classes)
mx.eval(model.parameters())

# loss and grad fn
loss_and_grad_fn = nn.value_and_grad(model, loss_fn)

# optimizer
optimizer = optim.SGD(learning_rate=learning_rate)

accuracy = []
tic = time()
for epoch in range(num_epochs):
    for X, y in batch_iterate(batch_size, train_images, train_labels):
        loss, grads = loss_and_grad_fn(model, X, y)
        optimizer.update(model, grads)

        # 이거 꼭 필요할까?
    accuracy += [eval_fn(model, valid_images, valid_labels).item()]

mx.eval(model.parameters(), optimizer.state)
toc = time()

print(f"Training time: {(toc-tic)/num_epochs:.2f} sec/epoch")

plt.figure(figsize=(4,3))
plt.plot(range(1,num_epochs+1), accuracy)
plt.plot(range(1,num_epochs+1),[1.0]*num_epochs, ls='--')
plt.xlabel("Epoch")
plt.ylabel("accuracy")
plt.show()
Training time: 0.21 sec/epoch보면 1 epoch 당 0.2 초 정도 걸리는 것을 확인할 수 있습니다.
여러번 돌려보니 Accuracy 는 0.2 일때도 있고 0.9까지 오를 때도 있네요.
잘 학습될 때를 노려 test set 평가를 해보겠습니다.
num_images = len(test_images)

# 한 줄에 표시할 그림의 개수를 정합니다. 이 값은 필요에 따라 조정할 수 있습니다.
images_per_row = 5

# 전체 행의 개수를 계산합니다.
num_rows = (num_images + images_per_row - 1) // images_per_row

# 전체 행과 열에 대한 subplot을 생성합니다.
fig, axes = plt.subplots(num_rows, images_per_row, figsize=(images_per_row * 2, num_rows * 2))

# 각 subplot에 이미지와 예측값, 정답을 표시합니다.
for i, (test_img, test_lb) in enumerate(zip(test_images, test_labels)):
    row = i // images_per_row
    col = i % images_per_row
    ax = axes[row, col]

    pred = mx.argmax(model(test_img.reshape([1,-1])), axis=1).item()
    ax.imshow(np.array(test_img.reshape(28, 28) * 255), cmap='gray')
    ax.set_title(f'Predict: {pred}\nTrue: {test_lb.item()}')
    ax.axis('off')  # 축을 숨깁니다.

# 남은 빈 subplot을 숨깁니다.
for i in range(num_images, num_rows * images_per_row):
    axes[i // images_per_row, i % images_per_row].axis('off')

plt.tight_layout()
plt.show()
PyTorch 를 이용한 MLP 구현
이제 동일한 코드를 Torch 로 구현해보도록 하겠습니다.
PyTorch 도 device="mps" 를 사용하면 GPU 를 사용할수는 있습니다.
그렇다면 MLX 의 장점은 무엇인가 하면 CPU와 GPU 의 unified memory 라는 점입니다.
즉 메모리를 공유하니까 GPU 로 메모리를 이동시키는 시간이 줄어들겠죠.
PyTorch + CPU 학습
import torch
import mnist

# Load the data
train_images, train_labels, test_images, test_labels = map(
    torch.Tensor, [
        mnist.train_images(),
        mnist.train_labels(),
        mnist.test_images(),
        mnist.test_labels(),
    ]
)
# Flatten the images
train_labels, test_labels = train_labels.long(), test_labels.long()
train_images = torch.reshape(train_images, [train_images.shape[0],-1])
valid_images, test_images = test_images[:-10], test_images[-10:]
valid_labels, test_labels = test_labels[:-10], test_labels[-10:]
valid_images = torch.reshape(valid_images, [valid_images.shape[0],-1])

class torchMLP(torch.nn.Module):
    def __init__(
        self,
        num_layers: int,
        input_dims: int,
        hidden_dims: int,
        output_dims: int
    ):
        super().__init__()
        layer_sizes = [input_dims] + [hidden_dims] * num_layers + [output_dims]
        self.layers = self._make_layers(layer_sizes)

    def _make_layers(self, layer_sizes):
        layers = []
        for idim, odim in zip(layer_sizes[:-1], layer_sizes[1:]):
            layers += [
                            torch.nn.Linear(idim, odim),
                            torch.nn.ReLU()
                       ]

        return torch.nn.Sequential(*layers[:-1])

    def __call__(self, x):
        return self.layers(x)

def loss_fn(model, X, y):
    # nn.losses.cross_entropy 는 logit 과 target 사이의 loss 를 계산해줌
    return torch.nn.CrossEntropyLoss()(model(X), y)

def eval_fn(model, X, y):
    return torch.mean((torch.argmax(model(X), axis=1) == y).float())

def batch_iterate(batch_size, X, y):
    perm = torch.randperm(y.size(0))
    for s in range(0, y.size(0), batch_size):
        ids = perm[s : s + batch_size]
        yield X[ids], y[ids]

# Load the model
model = torchMLP(num_layers=num_layers,
            input_dims=train_images.shape[-1],
            hidden_dims=hidden_dim,
            output_dims=num_classes)

# optimizer
optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)

accuracy = [eval_fn(model, valid_images, valid_labels).item()]
tic = time()
for epoch in range(num_epochs):
    for X, y in batch_iterate(batch_size, train_images, train_labels):
        loss = loss_fn(model, X, y)
        loss.backward()
        optimizer.step()
        optimizer.zero_grad()

    accuracy += [eval_fn(model, valid_images, valid_labels).item()]

toc = time()
print(f"Training time: {(toc-tic)/num_epochs:.2f} sec/epoch")

plt.figure(figsize=(4,3))
plt.plot(range(num_epochs+1), accuracy)
plt.plot(range(num_epochs+1),[1.0]*(num_epochs+1), ls='--')
plt.xlabel("Epoch")
plt.ylabel("accuracy")
plt.show()
Training time: 0.39 sec/epochPyTorch + GPU (mps) 학습
import torch
import mnist

device = torch.device("mps:0") if torch.backends.mps.is_available() else 'cpu'
print(f"Device: {device}")

# Load the data
train_images, train_labels, test_images, test_labels = map(
    torch.Tensor, [
        mnist.train_images(),
        mnist.train_labels(),
        mnist.test_images(),
        mnist.test_labels(),
    ]
)
# Flatten the images
train_labels, test_labels = train_labels.long(), test_labels.long()
train_images = torch.reshape(train_images, [train_images.shape[0],-1])
valid_images, test_images = test_images[:-10], test_images[-10:]
valid_labels, test_labels = test_labels[:-10], test_labels[-10:]
valid_images = torch.reshape(valid_images, [valid_images.shape[0],-1])

class torchMLP(torch.nn.Module):
    def __init__(
        self,
        num_layers: int,
        input_dims: int,
        hidden_dims: int,
        output_dims: int
    ):
        super().__init__()
        layer_sizes = [input_dims] + [hidden_dims] * num_layers + [output_dims]
        self.layers = self._make_layers(layer_sizes)

    def _make_layers(self, layer_sizes):
        layers = []
        for idim, odim in zip(layer_sizes[:-1], layer_sizes[1:]):
            layers += [
                            torch.nn.Linear(idim, odim),
                            torch.nn.ReLU()
                       ]

        return torch.nn.Sequential(*layers[:-1])

    def __call__(self, x):
        return self.layers(x)

def loss_fn(model, X, y):
    # nn.losses.cross_entropy 는 logit 과 target 사이의 loss 를 계산해줌
    return torch.nn.CrossEntropyLoss()(model(X), y)

def eval_fn(model, X, y):
    return torch.mean((torch.argmax(model(X), axis=1) == y).float())

def batch_iterate(batch_size, X, y):
    perm = torch.randperm(y.size(0))
    for s in range(0, y.size(0), batch_size):
        ids = perm[s : s + batch_size]
        yield X[ids], y[ids]

# Load the model
model = torchMLP(num_layers=num_layers,
            input_dims=train_images.shape[-1],
            hidden_dims=hidden_dim,
            output_dims=num_classes)
model.to(device)

# optimizer
optimizer = torch.optim.SGD(model.parameters(), lr=learning_rate)

accuracy = [eval_fn(model, valid_images.to(device), valid_labels.to(device)).item()]
tic = time()
for epoch in range(num_epochs):
    for X, y in batch_iterate(batch_size, train_images, train_labels):
        X, y = X.to(device), y.to(device)
        loss = loss_fn(model, X, y)
        loss.backward()
        optimizer.step()
        optimizer.zero_grad()

    accuracy += [eval_fn(model, valid_images.to(device), valid_labels.to(device)).item()]

toc = time()
print(f"Training time: {(toc-tic)/num_epochs:.2f} sec/epoch")

plt.figure(figsize=(4,3))
plt.plot(range(num_epochs+1), accuracy)
plt.plot(range(num_epochs+1),[1.0]*(num_epochs+1), ls='--')
plt.xlabel("Epoch")
plt.ylabel("accuracy")
plt.show()
Device: mps:0
Training time: 0.53 sec/epoch사실 MLP 의 경우 CNN 같은 구조보다 GPU 활용도는 떨어집니다. GPU 를 이용한 시간 단축 효과를 크게 보기 어렵다는 것이죠.
실제로 PyTorch 로 구현한 코드의 결과를 보면 CPU 를 활용한 학습의 경우 1 epoch 당 0.39 초가 걸렸지만, GPU 를 활용한 학습의 경우 1 epoch 당 0.53 초가 걸렸습니다.
Unified Memory 가 아니기 때문에 메모리를 device 로 옮기는데서 시간 손해를 보기도 하고, 최적화도 덜 되어 있고 판단할 수 있겠습니다.
Conclusion
아주 간단한 MLP 를 MLX 를 통해 구현해보았습니다.
이전의 Linear regression 보다 모델의 크기가 더욱 커진 상태에서 MLX 를 이용하면 학습 속도가 증가하는 것을 확인할 수 있었습니다.
다음에는 Transformer 구조의 LLM 처럼 더 큰 모델의 경우 어느정도 Throughput 을 낼 수 있을지 알아보겠습니다.
References
https://ml-explore.github.io/mlx/build/html/examples/mlp.html
감자 님의 최신 블로그
더보기-

- LLaDA: Diffusion language model과 LLM reversal curse
- 몇 달 전에 Gemini Diffusion 모델이라는 게 나왔다는 뉴스를 봤다. 일단 첫 번째로 Diffusion으로 어떻게 language model을 만든거지? 가 궁금했고, 두 번째로는 데모 비디오를 봤는데 미친듯이 빠른 속도가 눈에 띄었다. (꼭 데모 비디오 보시길!) 그래서 한번 근간이 되는 논문을 읽어보기로 했다. Alibaba Ant group 에서 써낸 Large Language Diffusion Models, 일명 LLaDA 라는 모델을 제안한 논문이 되겠다 (근데 마지막 A가 제목에는 없음...Large Language diffusion with mAsking 라고 함) 꽤 재미있게 읽은데다가, 중간에 LLM reversal curse 라는 개념...
-

- Think-fusion 의 여러가지 방식 (feat. DeepSeek-V3.1, GPT-5)
- 2025년 LLM 필드에서 가장 중요한 키워드 하나를 꼽으라면 바로 'Reasoning'일 것입니다. Test-time-computing을 통해서 LLM은 사람처럼 생각하는 과정을 거쳐 답변을 이끌어냈고, 이는 다양한 벤치마크 성능을 극적으로 끌어올렸습니다. 하지만 이 Reasoning 모델은 일반 사용자들 (단순한 태스크에 LLM을 적용하려는) 에게는 큰 영향을 주지 못했습니다. 금방 대답할 수 있는 질문들에도 쓸데없는 사고과정을 거치면서 답변을 기다리는 사용자들을 지치게 만들곤 했기 때문입니다. 그래서 제안된 방식 중 하나가 바로 Think-fusion입니다. 이전 블로그 글에서 Qwen3에 적용된 Hybrid think mode 에 대해서 살펴본 바 있습니다...
-
- NVIDIA Isaac Sim 으로 배우는 Physical AI (3회차 모임)
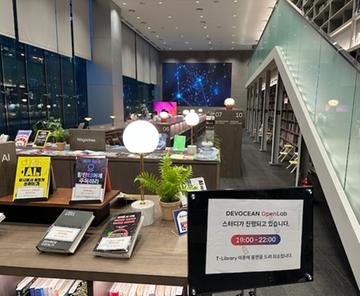
- 안녕하세요, Devocean OpenLab NVIDIA Isaac Sim 으로 배우는 Physical AI에 참여하고 있는 조재경입니다. 3회차 스터디는 T타워 1층에 있는 T-library 에서 진행하였습니다. 상기님도 와주셔서 저희를 응원해주셨네요!! 이번 3회차에는 1) 로봇을 제어하기 위한 미들웨어인 ROS2의 기초와 2) 유저의 발화만으로 로봇을 컨트롤하여 원하는 곳으로 이동시키기 위해 제안된 효율적 방법론인 ReMEMbR 에 대해서 알아보았습니다. ROS2의 기초는 스터디 대장님인 유석님께서 설명해 주셨습니다. 아주 명쾌한 설명에 무릎을 탁 치면서 감탄하며 들었네요. ReMEMbR는 제가 세미나 형식으로 준비해서 발표를 해보았는데요. 오랜만에 로봇 관련...
-

- Qwen3 의 Hybrid thinking mode
- 2025년 4월 29일 새벽에 Alibaba의 Qwen3 가 릴리즈되었다. Qwen3 공식 블로그 Technical report 가 공개되지 않고, 블로그로만 공개되었기 때문에 학습이 어떻게 이루어졌는지는 아주 제한적으로 공개되었다. 모델은 총 6개로 MoE 모델 2개와 Dense 모델 6개로 구성되었다. MoE 모델은 235B (22B activate), 30B (3B activate), Dense 모델은 32B, 14B, 8B, 4B, 1.7B, 0.6B 의 사이즈다. 블로그 글에 따르면 각각 가장 큰 모델만 학습한 뒤, strong-to-weak distillation 을 통해 나머지 모델들을 학습한 것으로 보인다. 아마도 base model 들은 pruni...
DEVOTEE 추천 블로그
-

- MLX: Apple silicon 용 Machine Learning 프레임워크 - 02.Regression example
- MLX examples 몇 가지 Machine learning 예제들을 통해 MLX 사용법을 익혀보도록 하겠습니다. 사실 numpy 나 torch, scipy 등의 라이브러리에 익숙하다면 그렇게 크게 어렵지 않기 때문에 잘 따라할 수 있습니다. 메쏘드들이 거의 유사하게 구현되었거든요. Linear Regression 아주 간단한 Linear Regression 예제를 돌려보겠습니다. 임의의 함수를 만들어 데이터를 합성하고, 해당 데이터를 이용해 역으로 함수를 approximate 하는 예제입니다. 우선 관련 모듈들을 import 하고 hyperparam 들을 세팅해줍니다. import mlx.core as mx import time num_features = 10...
-

- MLX: Apple silicon 용 Machine Learning 프레임워크 - 04.LLM inference example
- LLM Inference with MLX MLX 라이브러리를 이용한 LLM inference 에서 어느 정도 속도의 이득을 볼 수 있을지 확인해보도록 하겠습니다. Transformer를 기반으로 하는 LLaMA 모델을 직접 구현하는 작업이 포함되어 있습니다. 갑자기 드는 개인적 의견 LLaMA 모델을 직접구현해야 한다...이런 부분에서 단점이 보이는데...PyTorch 같은 경우 huggingface 라는 엄청난 플랫폼과의 연계성이 돋보입니다. 코드 4~5줄만으로도 huggingface hub 에 있는 모델들을 다운받고 inference 할 수 있습니다. 뭐 MLX 는 아직 나온지 얼마 안된 라이브러리니까 개선의 여지는 많이 남아있습니다만, torch 와 동일한 ...
-

- 고등학생도 이해하는 Transformer (Deep Learning) #5 (업데이트)
- 고등학생도 이해하는 Transformer (Deep Learning) #1 고등학생도 이해하는 Transformer (Deep Learning) #2 고등학생도 이해하는 Transformer (Deep Learning) #3 고등학생도 이해하는 Transformer (Deep Learning) #4 지난 시간에 내적의 의미를 다시 한번 생각 해봤습니다. 내적의 의미를 알면 계산을 하지 않아도 어느 벡터가 서로 얼마나 유사한지, 영향을 주는지, 닮았는지 형태만 보고서도 알 수 있었습니다. 지금까지 나온 이야기가 딥러닝과 너무 거리가 멀다는 이야기가 있어서 이번에는 실제 코드로 내적을 실습 해보고자 합니다. (아~ 고등학생은 Python 모를려나요? ^^;; 대신 그...
-
- Vision Transformer 구현 — TensorFlow/Keras로 손글씨(MNIST) 분류하기
- 안녕하세요. SK AX 의 송영목 매니저입니다. Vision Transformer(ViT)를 TensorFlow/Keras로 직접 구현하면서, 개념 → 수식/구조 → 코드 → 실행 결과 순서로 한 단계씩 설명합니다. 전체 소스 코드는 글 맨 아래에 첨부하였습니다. 들어가며 Vision Transformer(ViT)는 자연어 처리에서 쓰이던 Transformer 구조를 이미지 분류에 그대로 적용한 모델입니다. 핵심 아이디어는 단순합니다. "이미지를 작은 조각(패치)들로 잘라서, 각 패치를 문장 속 단어처럼 취급하고 Transformer로 처리하자." 이 글에서는 MNIST 손글씨 숫자(0~9) 이미지를 입력받아 어떤 숫자인지 분류하는 ViT를 구현해 보았습니다. C...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.