
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Deep Learning 기반 Depth Estimation with Mono Camera - 연구과정(2)
안녕하세요! 저희는 이번 SKT AI Fellowship 5기에서 “Deep Learning 기반 Depth Estimation with Mono Camera” 연구 과제를 수행중인 IDE 팀입니다.
두번째 포스트인데요, 저희가 약 7~8월 기간동안 진행한 연구를 소개해드리도록 하겠습니다.
저희는 우선 기존 모노 뎁스 연구들의 문제점을 파악하고 해결하는 전략을 세웠습니다.
기존 모노뎁스 모델의 방법과 문제점
기존 모노 뎁스 모델의 경우,
크게 (1) 딥러닝 방식 / 여러 시점 이미지에 대해 (2) structure from motion을 적용한 방식으로 나눌 수 있습니다.
각각의 방식에 대한 문제점은 다음과 같습니다.
(1) 딥러닝방식
-연속적인 두 장의 이미지들 간의 disparity를 분석 및 다양한 네트워크 구조를 이용하여 카메라의 상대적인 위치와 모션을 계산
->[한계점] : 학습된 depth정보를 도출하므로 scale을 알 수 없기 때문에 예측한 깊이 정보가 실제 세계 깊이 정보와 scale이 일치하지 않을 수 있음
(2) SFM 기반 방식
-두 장의 이미지에 대해 삼각측량법을 적용하여 정확한 scale의 depth 값을 추출 , 대체로 정확한 추정 가능
(두 개 이상의 다른 관측 지점에서 특징점들을 추출하고, 이 각도와 거리의 변화를 이용하여 해당 점의 정확한 위치를 측정하는 방식)
->[한계점] : 두 이미지의 특징점을 추출해내는 과정에서 error 발생
: 특징점이 아닌 경우 이미지 간 매칭이 어려우므로 pixel by pixel matching 이 불가
제안 방법
기존 깊이 추정 기술에서의 scale 정보 부재 문제 해결을 위해 depth scale까지 추정 가능한 Visual Inertial Odometry 기반 모델 개발
삼각 측량 기법의 아이디어에서 착안하여 딥러닝 모델 구성
IMU 데이터를 함께 사용함으로써 두 장의 Image 만으로 부족한 정보를 보완
기대효과
삼각 측량의 단점 보완하여 depth 추정 성능 개선
정확한 scale 까지 추정해내는 모델 개발
제안 딥러닝 모델
->IMAGE와 IMU 활용 트랜스포머 인코더 기반 퓨전 모델
Input: 특정 시간 차의 이미지 쌍과 IMU 데이터를 사용
Output: Pose 및 Depth를 출력으로 하여 모델에 보다 정확한 스케일 정보 부여 가능
과제 수행 내용
1) 사용 데이터 셋
이미지만 활용할 수 있는 NYU 데이터와 IMU까지 활용할 수 있는 VOID 데이터셋의 비교를 위해
멀티모달 기반 모델의 효용성에 대하여 실내와 실외를 비교기 위해 KITTI와 VOID 데이터셋 활용
2) 데이터 전처리
시간순으로 수많은 이미지와 IMU 값들이 존재했는데 특정 시점 T와 T+i, i는 0.4~0.9초사이의 random 하게 sampling하여 일반화가 잘될 수 잇도록 구성
이 두시점의 이미지와, 두시점 사이의 IMU값들 선형가속도3개 자이로3개 총6개의 데이터를 불러옴
IMU의 경우 약 100Hz로 샘플링이 되기 때문에 0.05~0.08초 정도에 한번씩 데이터를 불러올 수 있또록 진행
약 60~100개의 imu값들이 사용되게 됨
Output으로는 두시점에 대해 각각 카메라의 절대pose값이 존재하고 이에 대해 pose 변화량을 계산하여 relative pose를 사용하였고 depth image를 깊이추정용으로 사용
3) IMAGE 트랜스포머 인코더
이미지와 imu 를 처리하는 모델을 각각 구성하였는데 image를 처리하는 비전 기반 네트워크의 경우 swin transformer을 사용
Swin transformer의 경우 Vision Transformer의 문제점을 개선한 모델로써 Shifted window를 이용하여 window 간의 연결성 반영한것이 특징
Scale variant를 처리하기 위한 계층적 특징맵 이용한 모델로써 이런 mono depth estimation에서 효과적인 구조를 가짐
이웃한 두 프레임의 영상을 입력하여 feature를 추출한 뒤에, 이를 단순 concatenate하고, depth decoder와 pose decoder에 입력하여 깊이 및 포즈를 추정
4) IMU 트랜스포머 인코더
IMU의 경우 time series transformer을 사용
시계열 특성상 decoder가 굳이 필요 없어 트랜스포머 인코더와 linear prediction layers들을 통해 pose만을 예측하는 모델을 사용
인풋으로 6개의 데이터와 각 imu 시간스텝간의 편차를 사용하여 relative pose를 예측
결과
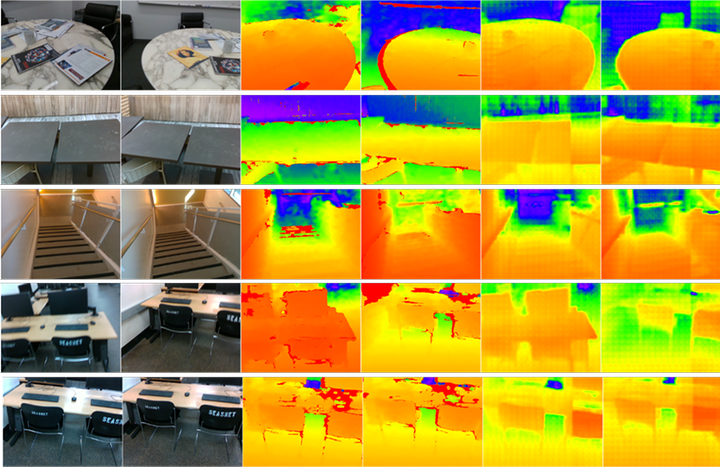
1) Depth estimation
기존 shallow 딥러닝 모델들에 비해 뎁스표현이 많이 개선된것을 볼 수 있었습니다.
- NYU dataset
- VOID dataset
2) Pose estimation
VOID 데이터셋에 대해서는 IMU 기반으로 포즈 추정을 진행
상대포즈를 어떤 회전 변환 표현식으로 추정하면 잘 추정할 수 있을지 다양한 도메인 지식을 넣어 pose추정에 최적화된 데이터 구조를 만드는데 집중
일반적으로 사용되는 회전행렬과 translation vector을 합친 4by 4 transformation matrix 표현을 통해 진행했고 카메라의 회전과 이동이 얼마나 되었는지에 대한 12차원데이터를 거의 정확하게 추정할 수 있었음
또한, 회전행렬을 Rodrigues rotation angle로 표현하여 기존의 translation vecto와 합쳐 6차원으로 추정할 수 도 있는데, 이방식은 회전행렬을 하나의 축으로 표현하는 방식으로 보다 간결하고 단위벡터로 표현되기 때문에 회전축을 직관적으로 이해할 수 있는 장점이 있고, 실제로 테스트한결과 우수한 성능을 보일 수 있었음
차후계획
남은 8월기간동안 pretraine한 두 트랜스포머 모델을 통합할 계획이고, 이과정에서 cross attention과 같이 효과적으로 멀티모델을 다룰 수 있는 모델을 개발할 계획
그 다음에는 아이폰으로 취득한 데이터를 활용하여 depth image를 추출하고 3D point cloud 형태로 변환하여 실내공간을 3차원으로 바꿀 예정
Jay 님의 최신 블로그
더보기-
- Deep Learning 기반 Depth Estimation with Mono Camera - 연구 결과 (3)
- 안녕하세요! 저희는 이번 SKT AI Fellowship 5기에서 “Deep Learning 기반 Depth Estimation with Mono Camera” 연구 과제를 수행했던 IDE 팀입니다. 벌써 6개월이 지나 마무리를 하게 되었네요 비전공자로써 다양한 연구들을 보며 시야를 넓히고 저희의 역량을 기를 수 있었던 소중한 시간이었습니다:) 연구 결과에 대한 이야기로 마지막 포스트를 올리며 마무리 하고자 합니다 기존 모노뎁스 모델의 방법과 문제점 지난 포스트에서도 말씀드렸듯이 기존 모노 뎁스 모델의 경우, 크게 (1) 딥러닝 방식 / (2) 삼각측량법을 적용한 방식으로 나눌 수 있습니다. 각각의 방식에 대한 문제점은 다음과 같습니다. (1) 딥러닝방식 -단일 ...
-
- Deep Learning 기반 Depth Estimation with Mono Camera - 연구과정(2)
- 안녕하세요! 저희는 이번 SKT AI Fellowship 5기에서 “Deep Learning 기반 Depth Estimation with Mono Camera” 연구 과제를 수행중인 IDE 팀입니다. 두번째 포스트인데요, 저희가 약 7~8월 기간동안 진행한 연구를 소개해드리도록 하겠습니다. 저희는 우선 기존 모노 뎁스 연구들의 문제점을 파악하고 해결하는 전략을 세웠습니다. 기존 모노뎁스 모델의 방법과 문제점 기존 모노 뎁스 모델의 경우, 크게 (1) 딥러닝 방식 / 여러 시점 이미지에 대해 (2) structure from motion을 적용한 방식으로 나눌 수 있습니다. 각각의 방식에 대한 문제점은 다음과 같습니다. (1) 딥러닝방식 -연속적인 두 장의 이미지들...
-
- Deep Learning 기반 Depth Estimation with Mono Camera - 연구계획(1)
- 안녕하세요! 저희는 이번 SKT AI Fellowship 5기에서 “Deep Learning 기반 Depth Estimation with Mono Camera” 연구 과제를 수행중인 IDE 팀입니다. 참고로 IDE는 Indoor Depth Estimation의 약자로 아이드라고 읽으셔도 되고 입에 착 붙어서 선정하게 되었습니다 :) 첫 포스트인데요, 저희가 진행하고자 하는 연구를 소개하고 향후 계획에 대해 말씀드리려고 합니다! 1.연구 과제 소개 1) 연구 배경 1-1) Mono depth estimation 이란? Mono depth estimation은 컴퓨터 비전 분야에서 뎁스가 포함된 Stereo camera를 사용하지않고 일반 단일 카메라의 이미지로부터 ...
DEVOTEE 추천 블로그
-
- AI 기반 고화질 3D 변환 기술 - 연구과정(2)
- 안녕하세요! 흥미로운 분석 결과와 함께 돌아온 NeRF Maverick입니다! 이번 중간 발표 결과의 핵심 내용은 다음과 같습니다. 기존 3D 배경 제작의 문제점 활동 내용 향후 연구 계획 1. 기존 3D 배경 제작의 문제점 SKT TEAM Studio에서는 현재 Unreal Engine을 이용하여 실시간 렌더링을 하고, 그 결과물을 배경 LCD에 올리는 방법을 사용하고 있는데요, 위의 그림처럼 보통 다섯 단계로 진행합니다. Step 1, 2, 3은 영상 촬영 전에 모델링 전문가 분들의 손길을 거치고, Step 4는 현장에서 실시간으로, Step 5는 영상 전문가 분들께서 영상 촬영 후에 진행하고 있습니다. 여기서 문제는, Step 1, 2, 3의 과정에 수 개월...
-
- Deep Learning 기반 Depth Estimation with Mono Camera - 연구 결과 (3)
- 안녕하세요! 저희는 이번 SKT AI Fellowship 5기에서 “Deep Learning 기반 Depth Estimation with Mono Camera” 연구 과제를 수행했던 IDE 팀입니다. 벌써 6개월이 지나 마무리를 하게 되었네요 비전공자로써 다양한 연구들을 보며 시야를 넓히고 저희의 역량을 기를 수 있었던 소중한 시간이었습니다:) 연구 결과에 대한 이야기로 마지막 포스트를 올리며 마무리 하고자 합니다 기존 모노뎁스 모델의 방법과 문제점 지난 포스트에서도 말씀드렸듯이 기존 모노 뎁스 모델의 경우, 크게 (1) 딥러닝 방식 / (2) 삼각측량법을 적용한 방식으로 나눌 수 있습니다. 각각의 방식에 대한 문제점은 다음과 같습니다. (1) 딥러닝방식 -단일 ...
-
- 스마트폰 센서 활용 PDR 모델 연구 - 연구계획(1)
- 안녕하세요! SKT AI Fellowship 6기에서 스마트폰 센서 활용 PDR 모델 연구 과제를 수행하는 팀 슼폰지입니다. 슼폰지라는 팀 이름은 SKT + 스마트폰 지도라는 의미를 가지고 있는데요, 곧 소개드릴 저희 연구 내용을 압축하여 담아보았습니다. 먼저 저희 연구에 대해 전반적인 소개를 드린 후 관련 연구, 연구 계획, 목표 순으로 설명드리겠습니다. 연구 소개 먼저 PDR (Pedestrian Dead Reckoning)이라는 분야가 생소하실 것 같습니다. PDR은 보행자의 이동 경로와 위치를 추정하고자 하는 기술 분야입니다. 우리도 일상생활에서 보행하면서 지도 앱에서 현재 위치를 확인하곤 하는데요, 이 때에는 보통 GPS 가 사용됩니다. 하지만 실내에서는...
-
- 스마트폰 센서 활용 PDR 모델 연구 - 연구 결과(3)
- 안녕하세요! SKT AI Fellowship 6기 슼폰지 팀입니다. 저희는 스마트폰 센서를 활용한 보행자 위치 추정(PDR: Pedestrian Dead Reckoning) AI 모델 개발을 주제로 약 5개월간 연구를 진행했습니다. 이전 포스팅에서 (1)연구 소개 (2)연구과정을 공유했는데요, 마지막 포스팅인 만큼 이번에는 저희 연구를 간략하게 다시 소개드리고, 최종 수행 과정과 결과를 공유하겠습니다. 연구 소개 현대 사회에서 위치 기반 애플리케이션은 우리의 일상생활에 깊숙히 자리 잡고 있습니다. 길찾기 앱부터 자전거 공유 서비스, 운동 기록 앱, 그리고 위치 기반 게임까지 GPS를 활용한 실시간 위치 추적 기술은 다양한 분야에서 사용되고 있습니다. 이러한 기술은...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.