
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
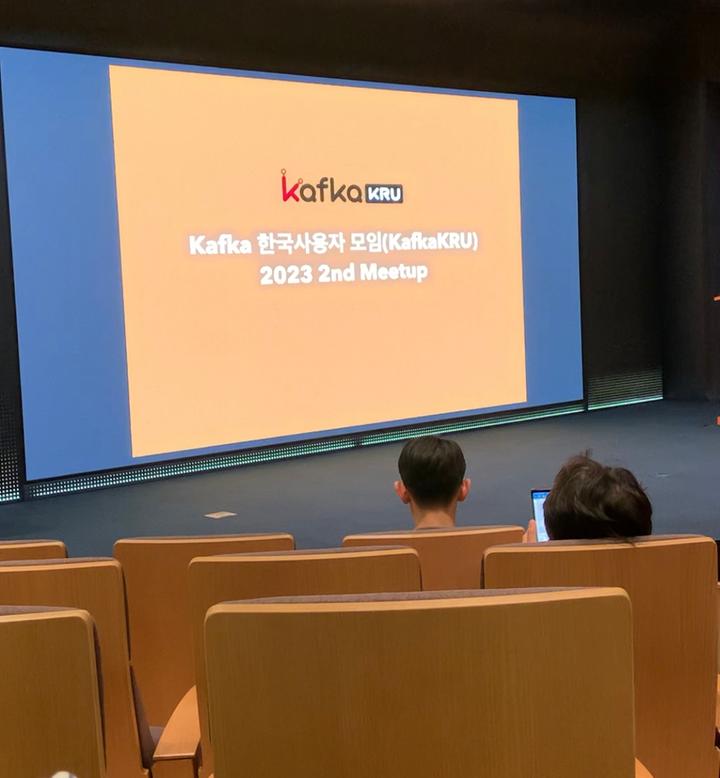
KAFKA 한국 사용자 모임(KafkaKRU) 2023 2nd Meetup 후기

안녕하세요! DEVOCEAN YOUNG 2기 권지윤입니다.
지난 8/9일에는 KAFKA 한국 사용자 모임 밋업에 참석했습니다.
현재 채팅 서버 프로젝트를 진행 중이며, 메시지 브로커로 아파치 카프카를 활용하고자 하는데, 딱 맞는 시기에 이 밋업이 개최되어 즉시 참가했습니다.
밋업에서는 두 가지 주요 세션으로 진행되었습니다:
“1000만 회원, MAU 500만을 위한 빅데이터 아키텍처”
카프카 클러스터 인증/인가의 중요성
아래에는 이번 세션의 주요 내용을 요약해서 공유하겠습니다.
1000만 회원, MAU 500만을 위한 빅데이터 아키텍처
먼저 첫 번째 주제로 다루어진 "1000만 회원, MAU 500만을 위한 빅데이터 아키텍처"에 대해 소개하겠습니다.
데이터 아키텍처 변화의 필요성
거래액, 브랜드, 회원 수 및 인원(동료)의 증가로 인해 무신사의 데이터 아키텍처 변화의 필요성이 대두되었습니다.
지금의 구조가 문제를 해결 가능한가?
문제가 발생할 경우 바로 해결하거나, 불가능할 경우 아키텍처를 개선합니다.
아키텍처 의사결정 기록(ADR)이 중요하며, 이를 통해 아키텍처 변경의 이유를 기록하고 설명하는 것이 중요합니다.
주요 문제점 및 개선점
긴 기간의 데이터 조회 문제
직접 DB에 접속하여 데이터를 조회하는 방식이 비효율적입니다.
index가 없거나 긴 기간의 데이터를 조회하는 것이 불가능합니다.
개선: DB 데이터를 파일 기반으로 저장하여 분산 처리 가능한 환경 구축합니다.
near-realtime 추천
사용자 행동 데이터를 실시간으로 추천하는 요구사항이 추가되었습니다.
개선: API GW와 kinesis를 통해 실시간 데이터 수집 환경 구축합니다.
API GW + kinesis
API GW의 사용량 증가로 인한 비용 급증했습니다.
트래픽이 몰리는 경우 Auto scale → 오토 스케일링은 지연이 발생 후 되기 때문에 타임아웃 다수 발생
개선: API를 직접 개발하고 kinesis를 MSK로 대체합니다.
아키텍처
물리적 및 논리적 데이터 아키텍처
데이터 아키텍처의 논리적 구조를 잘 정의하는 것이 중요합니다.
“데이터 커버넌스(논리적 데이터 아키텍처)” → 논리적 아키텍처를 통해 데이터에 대한 정의 및 원본 데이터 처리 방식을 명확히 합니다.
원본 데이터 = object + activity으로 분리합니다.
예: "김신사"가 "슬랙스"를 "클릭"하는 데이터를 "회원정보"라는 object , "상품정보"라는 object , "액션"으로 분리할 수 있습니다.
지표
metric * demension
action ⇒ metric
object ⇒ demension
더 많은 동료가 데이터에 접근
N명의 동료와 일하기
데이터 파이프라인을 구축하는데 유용한 pyspark와 같은 도구 도입합니다.
컨벤션 → 각 팀원 간의 소통을 원활하게 하기 위한 SQL 등의 통일된 언어 사용합니다.
기술 의사 결정은 팀과 함께한다.
다른 데이터 조직 랜딩
SQL, python notebook, BI 환경 제공합니다.
작업 흐름 환경과 데이터 레이크 제공합니다.
요청이 두 번 이상 오면 자동화 프로세스 도입합니다.
N백명의 동료와 일하기
데이터 거버넌스 구축: 접근 권한 설정 및 데이터 카탈로그 제공합니다.
데이터 활용 수준에 따라 다양한 환경 제공합니다.
질의 응답이 아닌 가이드를 중심으로 일을 합니다.
카프카 클러스터 인증/인가의 중요성
다음은 두 번째 주제인 "카프카 클러스터 인증/인가의 중요성"에 대한 요약입니다.
카프카 클러스터에서 인증과 인가는 데이터의 보안 및 안정성 확보를 위한 핵심 요소입니다. 부적절한 설정은 데이터 유출, 시스템 장애 등 여러 위험을 초래할 수 있습니다.
이 세션에서는 다양한 인증 및 인가 방법에 대해 설명 받았습니다.
특히, SASK/OAUTHBEARER 인증 구성에 대한 상세한 정보는 연사님의 최근 게시글(https://medium.com/spitha-techblog/kafka-sasl-0authbearer-인증-구성-7fcd2218e753)에서 확인하실 수 있습니다.
1. 인증과 인가의 중요성
Producer:
특정 토픽, 파티션에 추가할 메시지를 생성하여 브로커로 전송할 경우
잘못된 포맷의 메시지를 관련 없는 토픽에 추가하면 문제가 발생할 수 있습니다.
Consumer:
특정 토픽이나 파티션의 메시지를 읽어간다.
인가 없이 다른 컨슈머 그룹에 참여하면 문제가 발생할 수 있습니다.
CLI 도구:
무분별하게 모든 기능을 사용할 수 있어서 문제가 될 수 있습니다.
Admin Client API:
다양한 관리용 함수 제공합니다.
존재하지 않는 토픽을 만들려는 시도가 있을 수 있습니다.
2. 인증 프로토콜
인증 없음:
PLAINTEXT: 평문 통신. 클라이언트(프로듀서, 컨슈머, 어드민 클라이언트 ↔ 브로커간 평문 통신)
SSL: 암호화 통신으로 서버 확인. (클라이언트 ↔ 브로커간 암호화 통신)
인증 사용:
SASL_PLAINTEXT: SASL 인증 프로토콜 평문 통신
SASL_SSL: SASL 인증 프로토콜 암호화 통신
3. SASL (Simple Authentication and Security Layer)
클라이언트와 서버 간의 인증 매커니즘을 협상하는 프로토콜입니다.
4. 인증 구성 방법
GSSAPI: Kerberos v5 기반, 복잡한 구성.
PLAIN: Username과 password로 인증, client 인증 정보를 static file에 보관 → 불편
SCRAM: zookeeper에 계정정보 보관, kraft storage에 인증정보 보관, 해시된 값 비교, 카프카와 가장 잘 통합되어 있음
OAUTHBEARER:카프카 3.1.0 버전에서 릴리즈 , OAuth 위에 OIDC 기반, keycloak 등 OIDC 지원 인증 서버와 연계 가능.
5. 인가 구성
ACL (Access Control Lists):
P: principal(allow, denied)
O: operation
H: host
R: 토픽에 대한 읽기/쓰기 허용.
토픽, 클러스터, 토픽 , Transactional ID
6. Advanced
위임 토큰: 카프카 자체 내에서 위임 토큰을 생성한다. 브로커에서 생성하여 zookeeper에 보관하고 scram 매커니즘으로 인증합니다. → 발급 갱신 폐기가 간편하다는 장점이 있습니다.
사용량 제한 (Throttling): 전체 서비스 품질을 보장하기 위해 특정 작업 혹은 클라이언트의 대역폭 등을 제한할 필요가 있으므로 → 특정 작업이나 클라이언트의 리소스 사용을 제한합니다.
⇒ 카프카에 내장된 기능인 Client Quotas로 네트워크 대역폭과 요청 속도 할당량 설정이 가능합니다.
좋은 세션을 준비해주신 연사님들과 데보션분들께 감사드립니다! 🙇♀️
(데보션에서 준비해주신 샌드위치와 과일 정말 맛있었습니다!!)👍
june0216 님의 최신 블로그
더보기-

- 🌱 취준생/주니어 성장 스터디 오프라인 행사 생생 후기 (feat. 커뮤니티의 힘)
- 🌱 취준생/주니어 성장 스터디 오프라인 행사 생생 후기! 여름의 끝자락, 마지막 더위가 기승을 부리던 9월 13일, 6주간 매주 목요일을 뜨겁게 달궜던 여정에 마침표를 찍었습니다. 멘토님들과 스페셜 게스트분들의 도움으로 스터디원들과 함께 각자의 성장을 공유하고 더 성장하기 위해 한자리에 모였습니다. 지난 6주는 단순히 지식을 습득하는 시간이 아니었습니다. 매주 자신이 공부한 내용을 화이트보드에 직접 그려가며 발표하는 과정을 통해, 어렴풋이 알던 개념들이 비로소 머릿속에 단단히 자리 잡는 시간이었습니다. 스터디원 10명, 든든한 멘토님 3분, 그리고 특별한 경험을 나눠주기 위해 찾아주신 스페셜 게스트 5분과 행사 지원을 위해 달려와 주신 큰일꾼님까지, 총 20명의...
-
- KAFKA 한국 사용자 모임(KafkaKRU) 2023 2nd Meetup 후기
- 안녕하세요! DEVOCEAN YOUNG 2기 권지윤입니다. 지난 8/9일에는 KAFKA 한국 사용자 모임 밋업에 참석했습니다. 현재 채팅 서버 프로젝트를 진행 중이며, 메시지 브로커로 아파치 카프카를 활용하고자 하는데, 딱 맞는 시기에 이 밋업이 개최되어 즉시 참가했습니다. 밋업에서는 두 가지 주요 세션으로 진행되었습니다: “1000만 회원, MAU 500만을 위한 빅데이터 아키텍처” 카프카 클러스터 인증/인가의 중요성 아래에는 이번 세션의 주요 내용을 요약해서 공유하겠습니다. 1000만 회원, MAU 500만을 위한 빅데이터 아키텍처 먼저 첫 번째 주제로 다루어진 "1000만 회원, MAU 500만을 위한 빅데이터 아키텍처"에 대해 소개하겠습니다. 데이터 아키텍...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.