
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
멀티 턴 대화 토픽 추출 - 연구계획(1)
안녕하세요! 저희는 SKT AI Fellowship 5기 07번 과제를 맡게 된 ‘자연어쩔티비내리는호남선’ 팀 입니다 😁
이번 포스트를 통해 저희 팀의 연구 주제와 진행 방법에 관해 설명드리겠습니다!
1. 연구 과제 소개
1) 연구 배경
요즈음에는 안 사용해본 사람을 찾기가 더 힘든 LLM 기반 대화형 인공지능! (ChatGPT, Bard, Bing AI 등)
이러한 대화형 인공지능 서비스에는 이전에 사용했던 대화 세션으로 돌아가 했던 대화를 이어서 하거나, 인공지능의 답변을 다시 확인할 수 있는 기능을 제공합니다.
따라서 진행된 대화가 무슨 내용의 대화인지 알 수 있도록 하는 **‘대화 토픽 추출(Dialogue Topic Extraction)’**의 정확도를 높이는 것이 서비스 품질 향상의 중요한 열쇠가 되었다고 할 수 있습니다.
현재 가장 대표적인 대화형 인공지능 서비스인 ChatGPT의 경우 대화 세션의 제목이 첫 번째 대화 내용에 기반해서 생성되고, 그 이후의 대화는 반영되지 않고 있다는 한계점이 존재합니다.
저희 ‘자연어쩔티비내리는호남선’ 팀은 이 부분에 주목하여 연구 과제를 설정했습니다.
2) 연구 개발 목표
저희 팀의 연구 개발 목표는 대화 시스템에서의 토픽 이동, 확대, 축소를 실시간으로 정교하게 추적하는 프레임워크를 개발하는 것입니다.
개발하는 과정에서는 대용량 코퍼스의 토픽에 대한 효율적인 클러스터링 방법론을 부차적으로 연구할 계획이며, 개발 후 실제로 다양한 챗봇 혹은 사람 간 채팅 시스템에 적용할 수 있는지 데모 프로그램을 개발하여 검증할 것입니다.
2. 연구 수행 계획
1) 데이터셋 구축
대화의 주제를 생성해내는 모델 학습을 위해선 질문과 답변으로 구성된 대화와 대화의 토픽이 라벨링 되어있는 데이터셋이 필요합니다.
현재 언어를 가리지 않고 ChatGPT등의 LLM 기반 대화형 인공지능을 활용한 대화 데이터셋을 많이 찾아볼 수 있는데요(awsome chatgpt,koalpaca 데이터셋등) ,
대화의 토픽이 함께 포함되어있는 데이터셋은 아직 등장하지 않았기 때문에 저희 연구 팀이 기존 데이터셋을 활용해 토픽을 포함한 대화 데이터셋을 새로 구축할 예정입니다.
대화 문장에 걸맞는 토픽은 LLM에게 질문 문장과 답변 문장과 함께 ‘다음의 대화와 어울리는 주제를 설명해줘.’ 와 같은 프롬프트를 제공하는 식으로 추출할 예정입니다.
2) 연구 개발 목표
저희 팀의 연구 개발 목표는 대화 시스템에서의 토픽 이동, 확대, 축소를 실시간으로 정교하게 추적하는 프레임워크를 개발하는 것입니다.
개발하는 과정에서는 대용량 코퍼스의 토픽에 대한 효율적인 클러스터링 방법론을 부차적으로 연구할 계획이며,
개발 후 실제로 다양한 챗봇 혹은 사람 간 채팅 시스템에 적용할 수 있는지 데모 프로그램을 개발하여 검증할 것입니다.
2-a) 사전학습 코퍼스에 대한 토픽 추출
클러스터링 기법은 다양한 곳에서 활용될 수 있는데요,
언어 모델 학습에 사용되는 문헌은 각 문서에 관한 메타데이터가 포함이 되어있는 경우도 있지만, 광범위한 문서가 마땅한 구별 없이 코퍼스에 포함되어있는 경우도 많습니다.
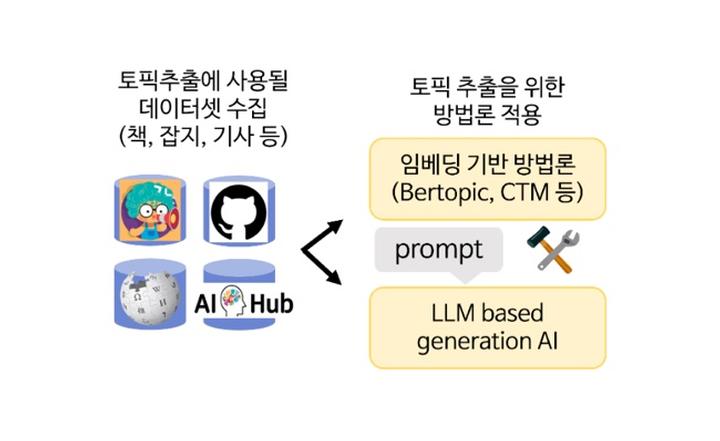
따라서 저희는 사전학습을 위한 대용량 코퍼스에서 문서 관리를 효율적으로 하기 위한 클러스터링 방법론 연구도 같이 진행할 예정입니다.
사전학습 코퍼스에 대한 토픽 추출 과정은 아래 그림과 같이 진행할 예정입니다.
3) 멀티턴 대화 토픽 추출
단계 1)
먼저 대화 내에서 적절한 토픽을 추출하기 위해, 대화 쌍 {Q, A}를 이용해 토픽 T를 예측하는 모델이 필요합니다.
모델은 생성형 언어 모델을 사용할 계획이며, 모델을 훈련시키기 위한 {Q, A, T}로 구성된 데이터셋이 필요합니다.
하지만 토픽을 포함한 문장 쌍 데이터셋은 비교적 수집하기 어렵습니다.
따라서, {Q, A}로 구성된 데이터셋을 추가로 수집하고 ChatGPT API와 같은 적절한 토픽 예측이 가능한 LLM이나 Human Annotation을 이용해 토픽을 문장 쌍 별로 추가하여 데이터셋으로 사용할 것입니다.
단계 2)
대화를 진행하다보면, 대화의 주제가 중간에 바뀔 수도 있습니다. 새 대화가 생성되었을 경우 토픽 추출 모델은 새로운 대화에 관한 토픽을 추출하게 되고, 이전 시점의 대화 토픽과 비교해 유사도를 계산합니다.
그림의 왼쪽 케이스와 같이 맥락이 유지되는 대화의 경우 각 대화 토픽의 유사도가 높으므로 토픽은 바뀌지 않고 유지됩니다.
그러나 오른쪽 케이스와 달리 이전 시점의 대화와 현재 시점의 대화의 토픽이 달라지는 경우 유사도에 따라 토픽이 업데이트 됩니다.
대화 토픽 사이의 연관성이 존재하는 경우 토픽들을 포괄하여 설명할 수 있는 새로운 토픽으로 바뀌게 되고, 토픽들이 상이하다면 최근에 한 대화에 맞추어 토픽이 변경됩니다.
단계 3)
하지만 완전히 다른 주제로 이동하거나 현재 주제를 유지하는 표현만으로는 주제의 미묘한 변화를 표현할 수 없습니다.
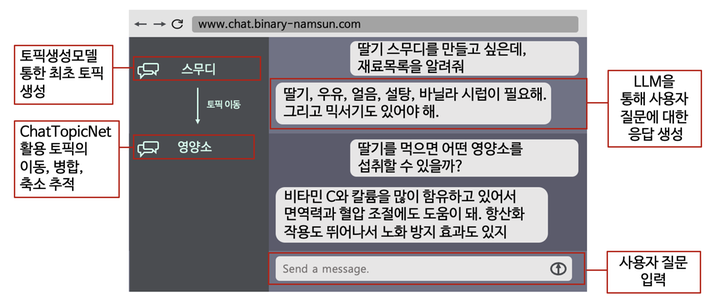
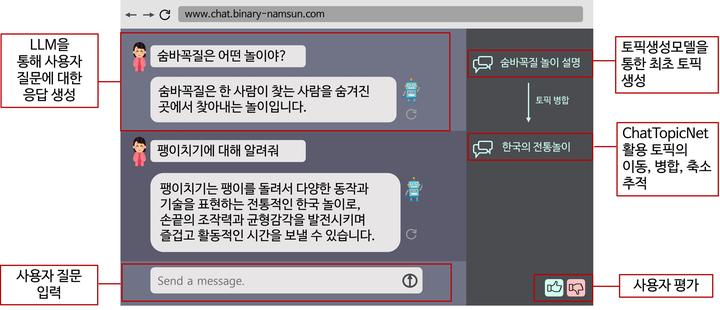
대화의 주제는 이동이나 유지 외에도 아래의 예시와 같이, 기존 주제에서 더 심층적인 주제로 확대되거나, 포괄적인 주제로 축소될 수 있습니다.
우리는 이러한 주제의 미묘한 변화을 실시간으로 추적하기 위해, 그래프 상에서의 포인터 이동을 이용해 해결하고자 합니다.
포인터는 클러스터링으로부터 구축된 덴드로그램이나 지식 그래프 내에서 특정 노드를 가리키는 역할을 하며, 토픽을 추출한 순간마다 포인터가 벡터 공간 내에서 해당 토픽에 상응하는 위치로 이동합니다.
따라서 같은 토픽이 연속적으로 추출될 경우 포인터가 해당 토픽과 매우 가까워지며, 비슷한 분야의 토픽이 연속적으로 추출될 경우 해당 분야를 잘 표현할 수 있는 점으로 포인터가 이동합니다.
위의 예시에서 숨바꼭질, 팽이치기 순서로 토픽이 추출될 경우, 포인터는 ‘숨바꼭질 놀이’ 노드를 나타낸 후 ‘팽이치기 놀이’ 노드와 가까워지도록 ‘전통놀이’의 방향으로 이동합니다.
이러한 방법을 이용해, 토픽의 양상을 입체적으로 추적할 수 있습니다.
단계 4)
마지막 단계에서는 단계 3에서 추적한 토픽 표현을 자연어로 디코딩하여 인터페이스에 표시합니다.
마지막으로 확장 프로그램으로 개발하여 SKT의 에이닷과 같은 대화형 인공지능, 더 나아가 대화 생성이 필요없는 사람 간 대화에서도 적용할 것입니다.
아래 이미지는 저희가 목표로 하는 프로그램의 인터페이스 데모 화면이고, gradio등의 프로그램을 이용하여 구현할 예정입니다!!
3. 연구 일정
연구 일정은 다음과 같으며, 프로젝트 진행 상황에 따라 변동사항이 있을 수 있습니다.
4. 팀원 소개
프로젝트를 진행할 저희 팀원을 소개하겠습니다!
그
리
고
.
.
.
레전드다 .. ٩(╹⌓╹ )۶ 레전드가 나타났다 !! (● ˃̶̀ロ˂̶́)੭⁾⁾
자연🌱어쩔티비🖥내리는💧호남선🚝의 빛✨️과 어둠🌚 소금과 설탕, 신🙇♂️, god🙇♀️, 神🙇, 태양☀️과 달🌕
프로젝트를 도와주실 저희 멘토님이십니다!! 프로젝트 주제 선정부터 연구 과정까지 전 방면에서 저희 팀을 도와주고 계십니다!!!!
이상으로 저희 포스트를 마칩니다! 읽어주셔서 감사합니다🙇
Reference
https://github.com/MilaNLProc/contextualized-topic-models
https://github.com/voidful/awesome-chatgpt-dataset
용상 님의 최신 블로그
더보기-
- 멀티 턴 대화 토픽 추출 - 연구 결과(3)
- 안녕하세요, 저희는 SKT AI Fellowship 5기 07번 과제 ‘한국어 언어 모델 응용 과제’를 맡게 된 자연어쩔티비내리는호남선 유용상, 정민화, 이승민 입니다. 어느덧 6개월이 지나 연구가 마무리되어 저희 성과를 전해드릴 수 있게 되어 정말 감회가 뜻깊습니다. 연구 배경 및 목적 ChatGPT와 같은 대화형 인공지능 서비스, 다들 사용해 보셨을텐데요. 이와 같은 서비스를 사용할 때 한 번 했던 대화를 다시 확인할 수 있도록 왼쪽에 세션 제목이 생성되는데, 현재 대부분의 서비스가 보시는 것처럼 첫 번째 대화 내용에 기반해서 세션 제목이 생성되고, 첫 번째 대화 이후 대화 주제가 변하더라도 그것이 반영되지 않는다는 한계점이 존재합니다. 화면의 예시 대화를 보...
-
- 멀티 턴 대화 토픽 추출 - 연구과정(2)
- 안녕하세요! 저희는 SKT AI Fellowship 5기 07번 과제를 맡게 된 ‘자연어쩔티비내리는호남선’ 팀 입니다 😁 이번 포스트에서는 8월 24일 진행되었던 중간발표 세션에서 발표했던 저희 팀의 연구 주제와 진행 상황에 대해 설명드리겠습니다! 1. 연구 배경 및 목적 문서에서 주제를 추출하는 과제는 중요하지만 주제의 변화를 추적하는 시도는 이제껏 시도된 적이 없었습니다. 예를 들어, 하나의 세션에서 LLM기반 인공지능과 대화할 때 첫 대화에 대한 주제만 반영되는 한계가 존재하고, 신문기사에서는 문단에 따라 논지가 바뀌는 경우가 생기며, 온라인 게시판은 한 게시판에 여러 주제의 게시글이 올라오는 경우가 대부분입니다. 이에, 저희는 LLM기반 인공지능 대화 주...
-
- 멀티 턴 대화 토픽 추출 - 연구계획(1)
- 안녕하세요! 저희는 SKT AI Fellowship 5기 07번 과제를 맡게 된 ‘자연어쩔티비내리는호남선’ 팀 입니다 😁 이번 포스트를 통해 저희 팀의 연구 주제와 진행 방법에 관해 설명드리겠습니다! 1. 연구 과제 소개 1) 연구 배경 요즈음에는 안 사용해본 사람을 찾기가 더 힘든 LLM 기반 대화형 인공지능! (ChatGPT, Bard, Bing AI 등) 이러한 대화형 인공지능 서비스에는 이전에 사용했던 대화 세션으로 돌아가 했던 대화를 이어서 하거나, 인공지능의 답변을 다시 확인할 수 있는 기능을 제공합니다. 따라서 진행된 대화가 무슨 내용의 대화인지 알 수 있도록 하는 **‘대화 토픽 추출(Dialogue Topic Extraction)’**의 정확도를...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.