
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
더 똑똑해진 GPT-4 발표! 무엇이 달라졌을까?
독일 마이크로소프트 CTO 안드레아스 브라운은 2023년 3월 9일 독일에서 개최한 이벤트(AI in Focus-Digital Kickoff)에서 "다음 주 GPT-4가 공개될 예정이다"라고 깜짝 발표를 했습니다.
텍스트 뿐만 아니라 음성, 이미지, 영상까지 처리하는 멀티모달 시스템(Multimodal System)이라고 설명하며 기대를 갖게 했습니다.
그런데 2023년 3월 14일 GPT-4가 진짜 출시를 했습니다.
저와 같이 유료 구독 서비스인 ChatGPT Plus를 이용하고 계신 분께서는 현재 즉시 이용이 가능하고 그렇지 않으신 분은 Waitlist에 추가하실 수 있습니다. (2023년 3월 15일 기준)
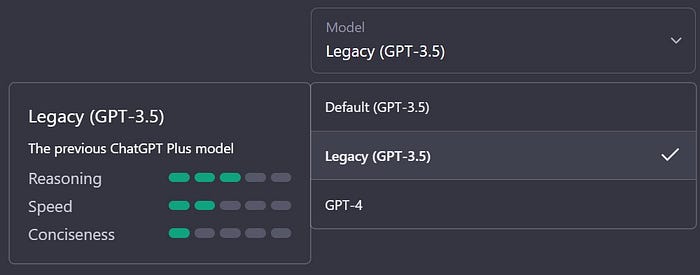
Legacy (GPT-3.5)

Default (GPT-3.5)
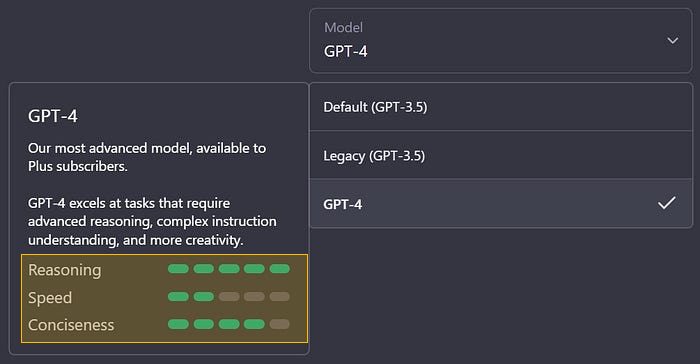
GPT-4
GPT-4는 GPT-3.5에 비해 Speed는 떨어졌지만 Reasoning과 Conciseness가 많이 올라간 것으로 보입니다.
사실 최근 빅테크 기업들이 파라미터(매개변수) 증가, 거대화 전쟁이 시작되면서 GPT-4의 파라미터 개수에 대해서도 관심이 많을 텐데요.
GPT-4의 파라미터(매개변수) 수는 GPT-3.5의 파라미터(1750억 개) 보다 증가되었지만 정확히 어느 정도인지는 공개하지 않았습니다.
일부에서 GTP-4는 100조 개의 파라미터 모델이 될 것이라는 예상 했었는데 OpenAI CEO 샘 알트만은 터무니없는 이야기라고 일축하기도 했습니다.
100조 개의 파라미터를 가진 모델을 학습시키려면 엄청난 컴퓨팅 리소스가 필요하고 데이터세트 역시 그에 상응하는 양이 필요하기 때문이죠.
자 그럼 GPT-4가 GPT-3.5에 비해 얼마나 좋아졌을지 구체적으로 살펴보겠습니다.
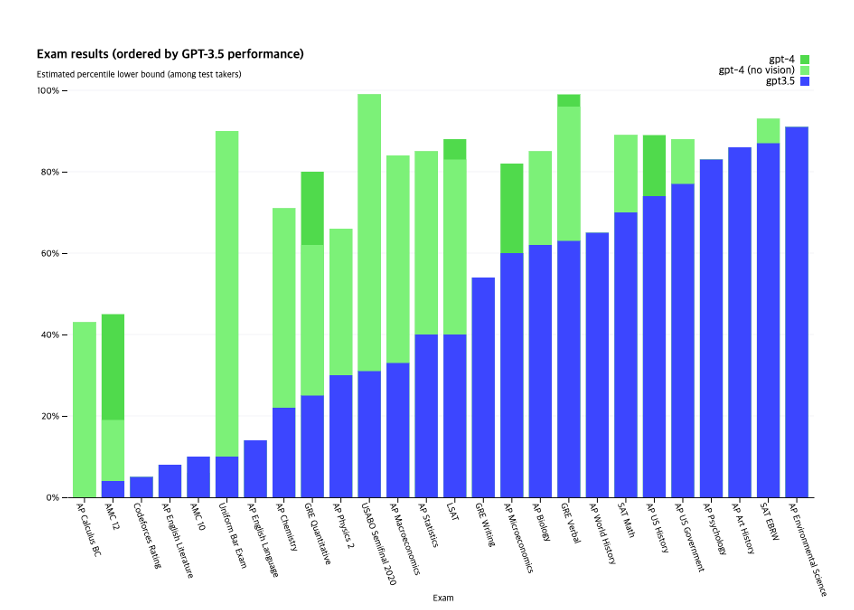
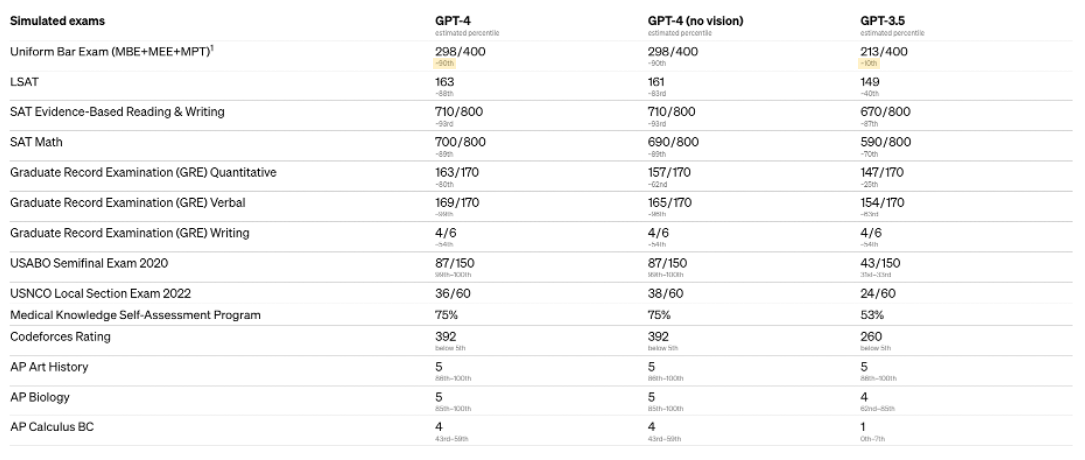
OpenAI에서는 GPT-4가 미국의 모의 변호사 시험에서 백분위 90%, 대학입시시험 SAT에서는 89%를 기록하며 인간 수준의 성능을 발휘했다고 설명하고 있습니다.
이전 모델인 GPT-3.5는 모의 변호사 시험에서 백분위 10% 성적을 기록한 바 있습니다.
위에서 보이는 그래프는 다양한 시험에 대한 성적 그래프인데 파란색 그래프가 GPT-3.5의 성적이고 초록색 그래프가 GPT-4의 성적입니다.
확실히 GPT-3.5보다 높은 성적을 보여주고 있습니다. 조금 더 진한 초록색은 GPT-4의 vision이 포함된 버전인데 no vision보다 높은 성적을 보였다고 합니다.
단순히 텍스트만 보고 시험을 치렀을 때보다 이미지가 포함되면 이미지 해석 후 시험을 치렀을 때 더 성적이 높았다는 겁입니다. 멀티모달의 장점을 소개하기 위한 것 같습니다.

GPT-3.5와 또 다른 차이점은 영어 외 다른 언어에 대한 지원이 강화되었다는 점입니다.
OpenAI가 Microsoft Azure 번역을 활용하여 벤치마크(MMLU) 테스트 결과, GPT-4는 전 세계 26개 언어 중 한국어를 포함한 24개 언어에서 높은 성능을 보였습니다.
파란색 그래프가 GPT-3.5인데 GPT-3.5뿐만 아니라 경쟁사의 구글 팜(PaLM), 딥마인드 친칠라(Chinchilla) 등의 모델과 비교하더라도 GPT-4는 전체적으로 우위를 보입니다.
GPT-3.5 English가 70.1% 인데 GPT-4의 Korean이 77%의 성적이니 매우 기대가 됩니다.
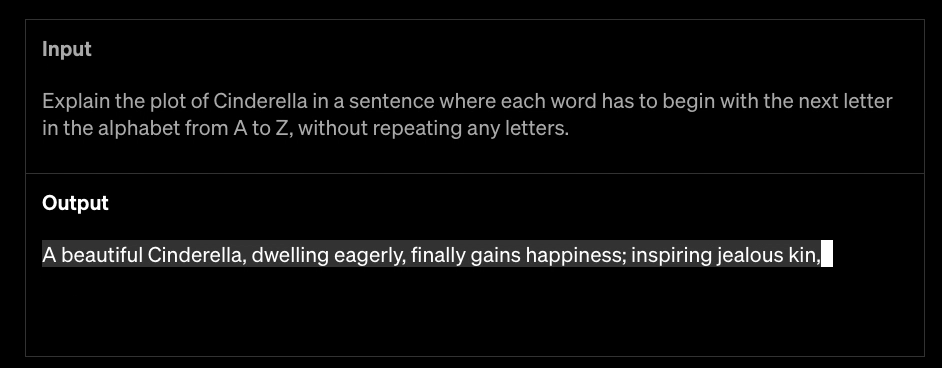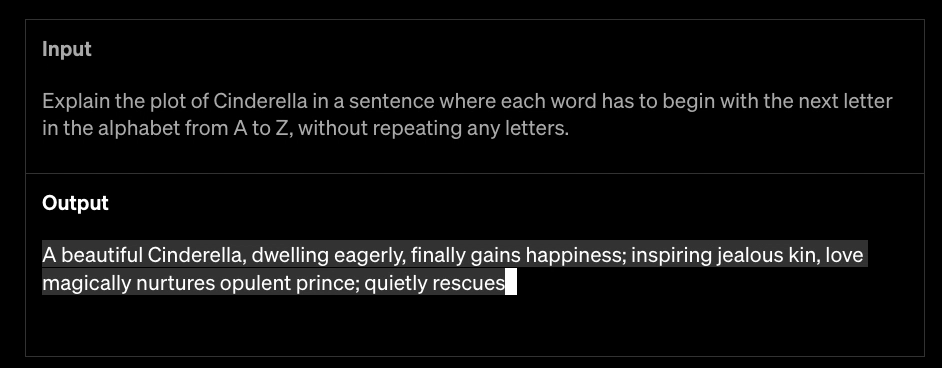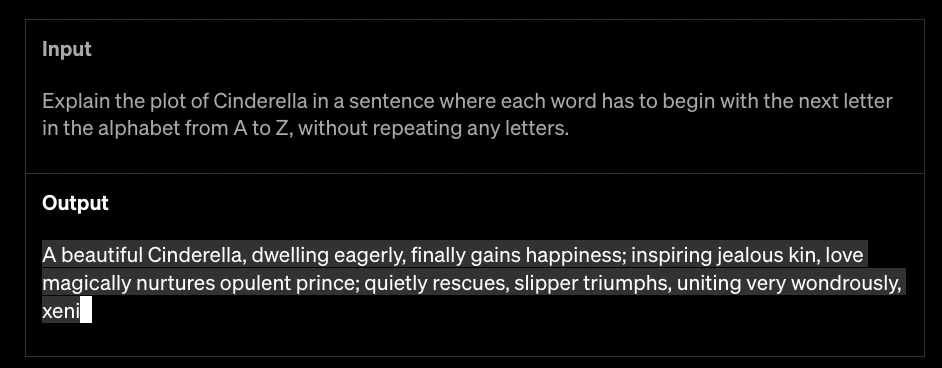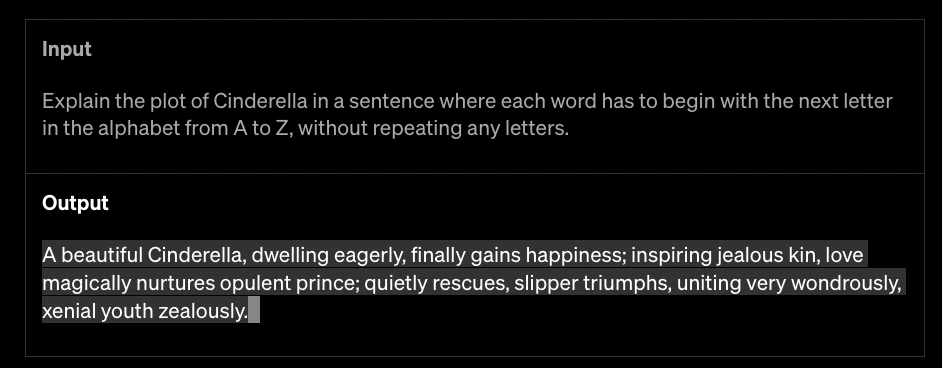
위 예제는 문자를 반복하지 말고 A~Z로 시작하는 단어를 순서대로 나열하면서 신데렐라의 줄거리를 설명하라는 명령입니다. "A beautiful Cinderella.." 이 예제를 통해 GPT-4의 창의성을 강조합니다.
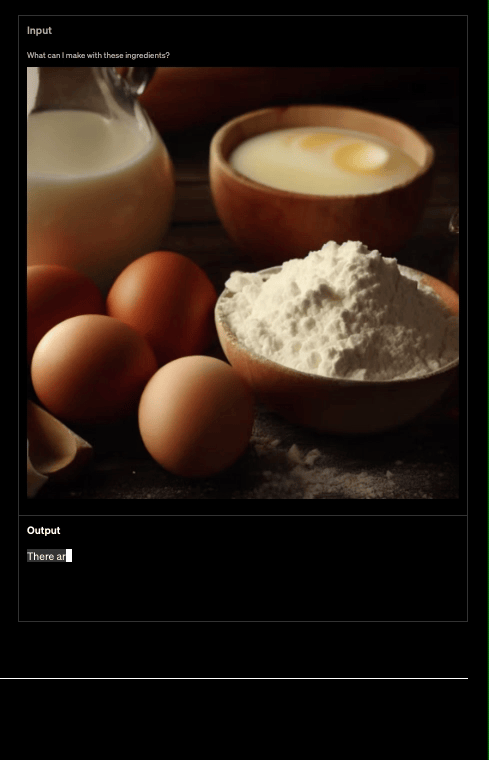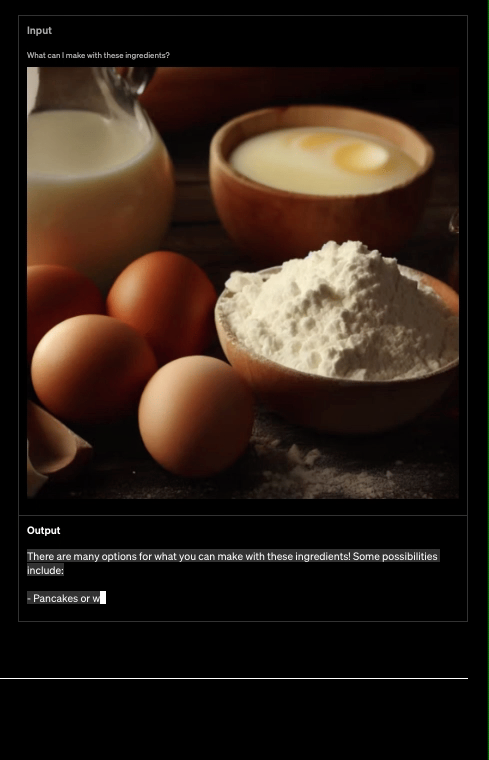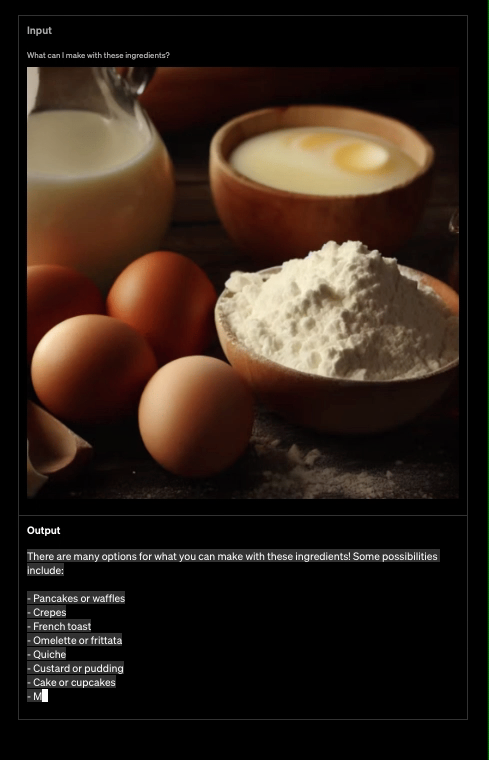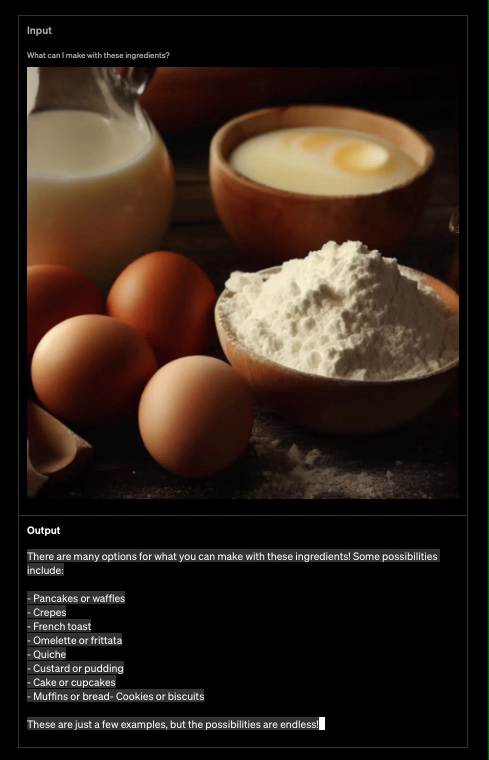
GPT-4의 가장 큰 변화는 GPT-3.5와 달리 여러 데이터 형태를 인식하는 멀티모달 모델이라는 것입니다.
프롬프트에 텍스트뿐 아니라 이미지를 입력하면 해석하여 원하는 답변 준다는 것입니다.
위 예제를 보면 사진을 주고 이 사진에 나온 재료로 무엇을 만들 수 있는지 질문을 하니 다양한 요리를 답해줍니다.
(하지만 아직 리서치 프리뷰 단계라 이미지를 입력하는 기능은 사용이 제한되어 있으며 비디오 지원은 포함되지 않았습니다.)

GPT-3.5의 경우에는 텍스트 3,000 단어까지 처리가 가능했습니다.
GPT-4는 8배 증가한 25,000 단어까지 처리가 가능합니다. 정말 긴 내용의 글도 입력이 가능해졌습니다.
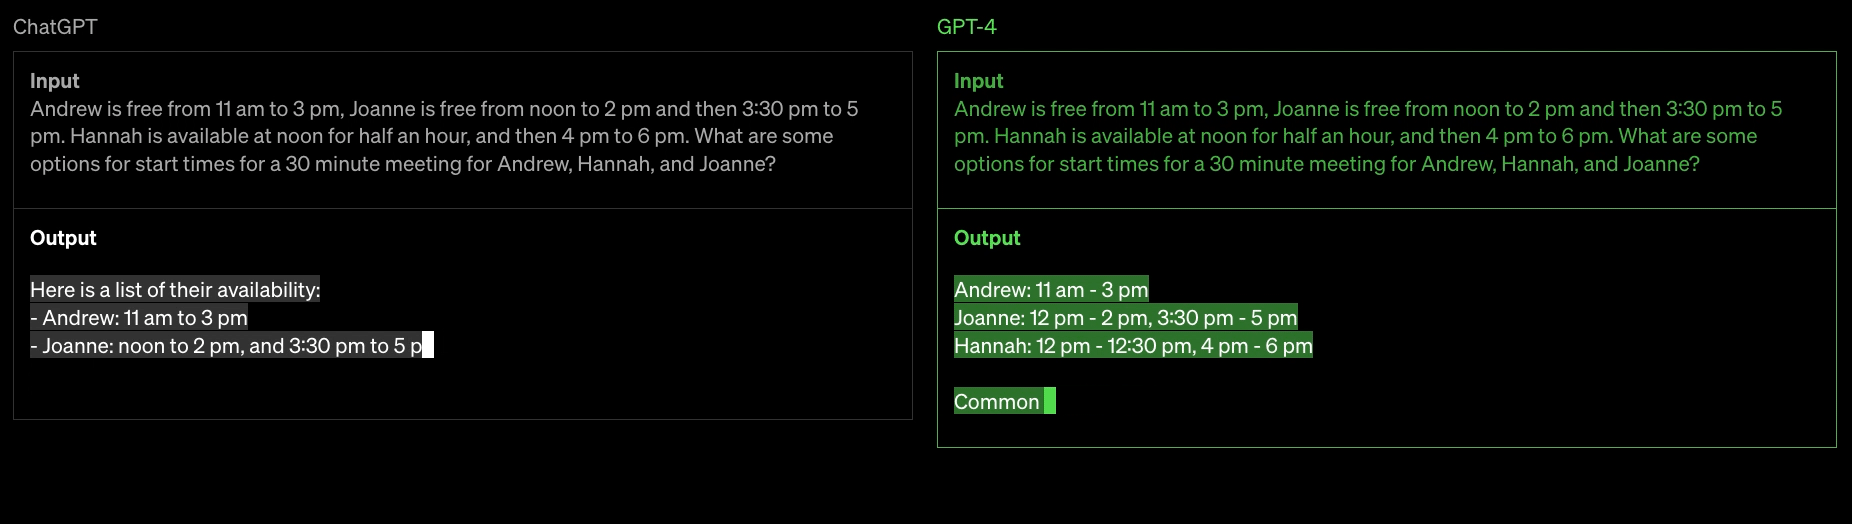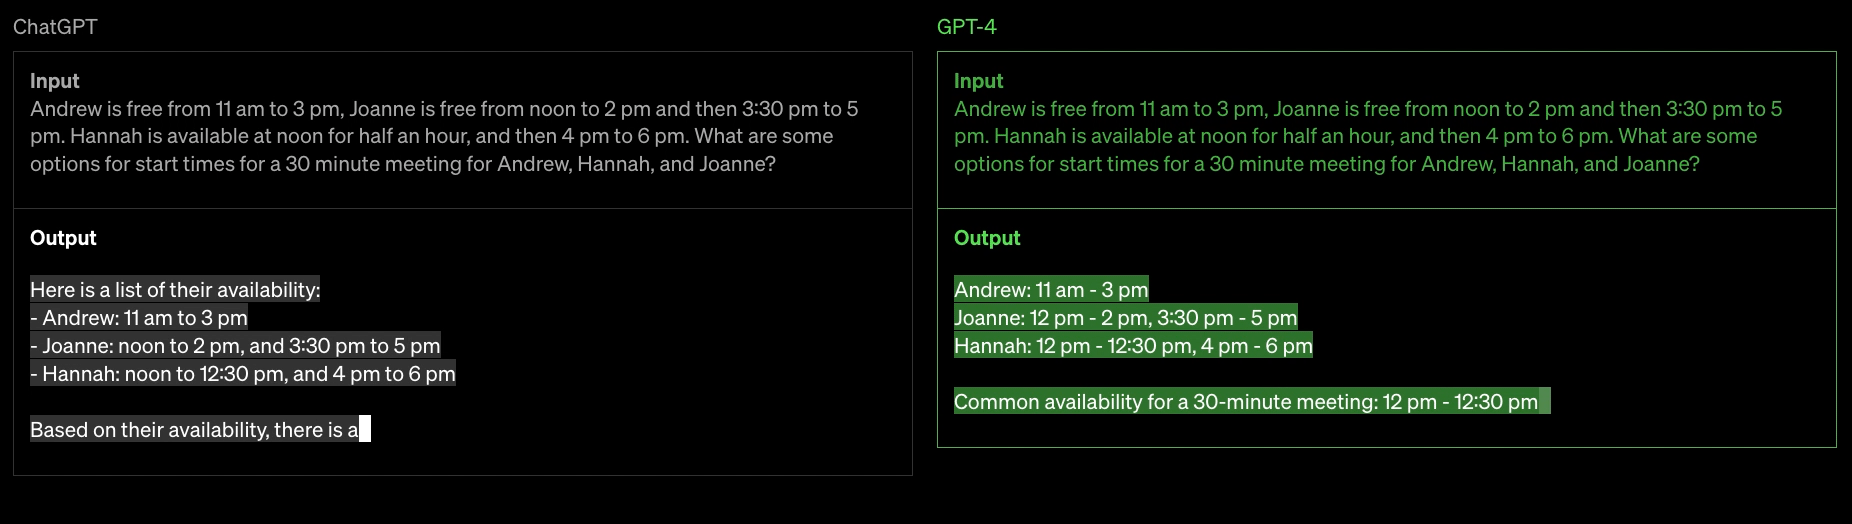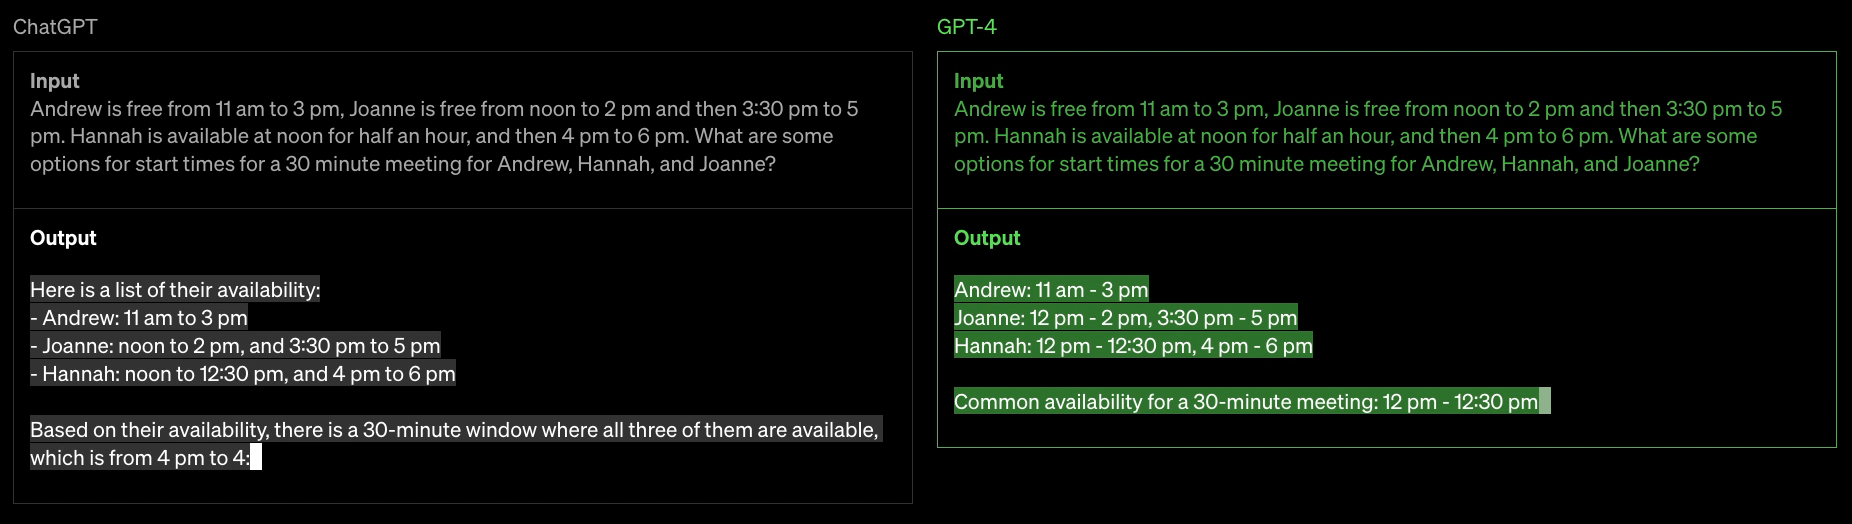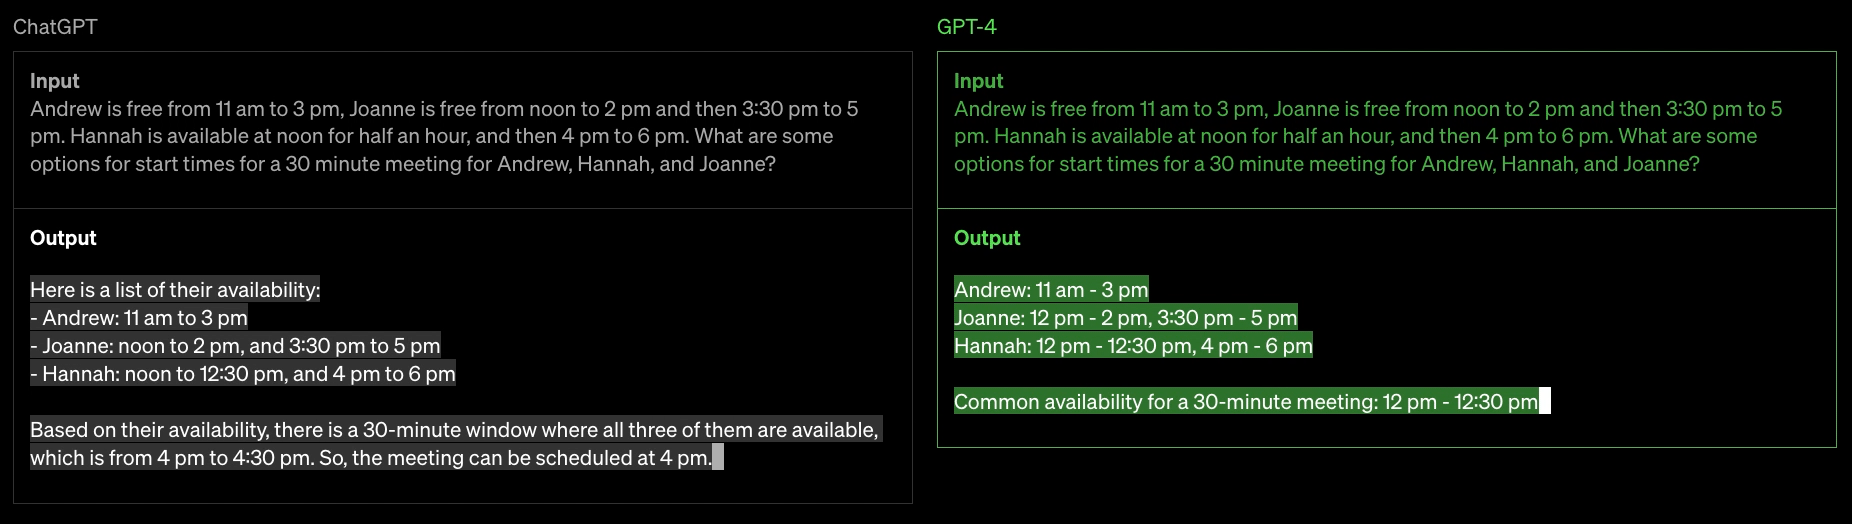
그리고 GPT-3.5보다 미묘한 지시사항을 잘 처리한다고 설명하고 있는데요.
위 예제는 여러 사람의 일정을 넣고 공통적으로 어느 시간에 회의가 가능할 것인지에 대해 질문을 한 것입니다.
살펴보면 확실히 GPT-3.5보다 더 고급 추론이 가능해진 것 같습니다.
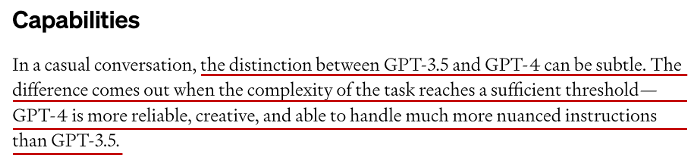 출처: OpenAI
추가적으로 OpenAI Blog 게시물을 보면 "일상 대화에서 GPT-3.5와 GPT-4의 차이가 미묘할 수 있습니다.
그러나 작업의 복잡성이 충분한 임계값에 도달했을 때 차이가 나타납니다.
GPT-4는 GPT-3.5보다 훨씬 안정적이고 창의성이 뛰어나며, 미묘한 지시사항을 더 잘 처리할 수 있습니다."라고 설명하고 있습니다.
조금더 나아가서 그 미묘한 차이를 알아보도록 하겠습니다.
#1 질문 : 강 건너기 문제 (늑대, 양, 풀)
정해진 용량의 운송수단으로 주어진 물체, 사람 등을 옮기는 유형의 문제입니다.
예전에 예능 프로그램인 무한도전에 나왔던 문제입니다.
"늑대, 양, 풀이 있는데 한 번에 하나씩 밖에 옮길 수 없고, 사람이 없으면 늑대는 양을, 양은 풀을 먹어버린다. 모두 무사히 건너기 위해서는 어떻게 해야할까?"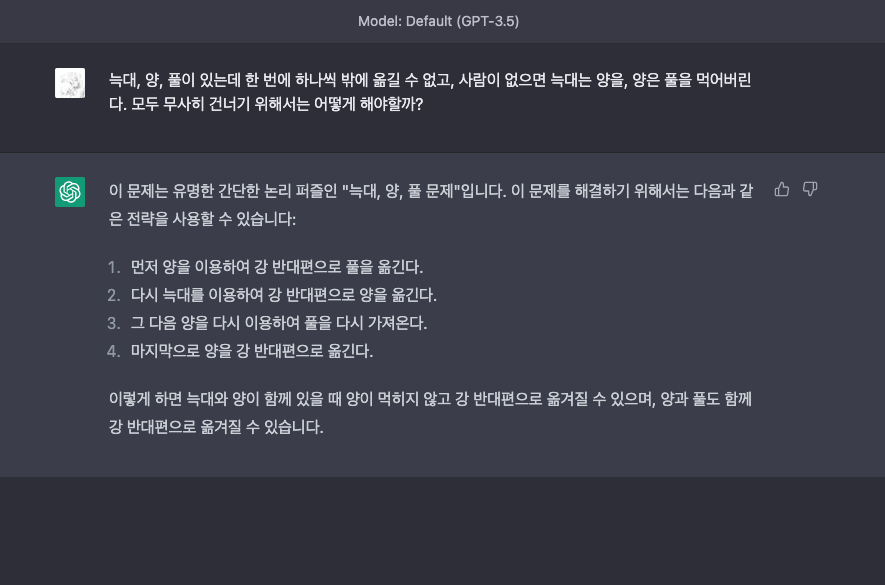
GPT-3.5 잘못된 답변

GPT-4 올바른 답변
이 문제에 대한 답을 보면 GPT-3.5도 설득력 있게 설명하고 있지만 자세히 들여다보면 왜곡된 설명이고 잘못된 답입니다.
그런데 GPT-4는 늑대, 양, 풀 문제를 정확하게 풀었습니다. 단계 역시 올바른 순서로 명확하게 명시하고 있습니다.
#2 질문 : 외판원 문제 (Traveling Salesman Problem, TSP)
여행 판매원 문제는 인기 있는 수학 문제로, n개의 도시들 사이의 거리가 주어지고 모든 도시를 정확히 한 번씩 돌아 제자리로 돌아와야 하는데 지점과 거리를 고려하여 가장 효율적인 궤도를 구하는 문제입니다.
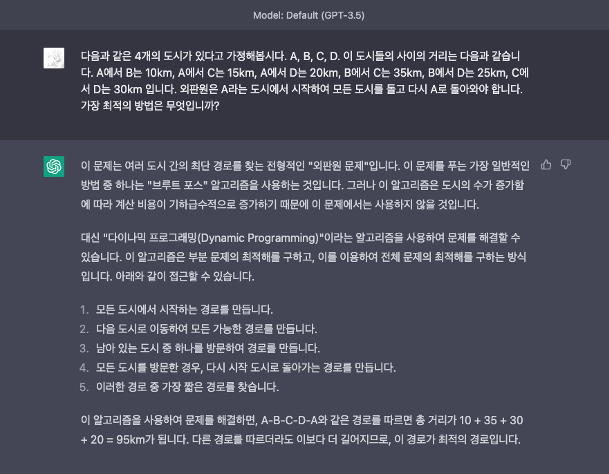
GPT-3.5는 Brute force 알고리즘을 사용했습니다. 알고리즘으로 올바른 결과를 얻었지만 이것은 세일즈맨에게 실제 최단 경로가 아닙니다.
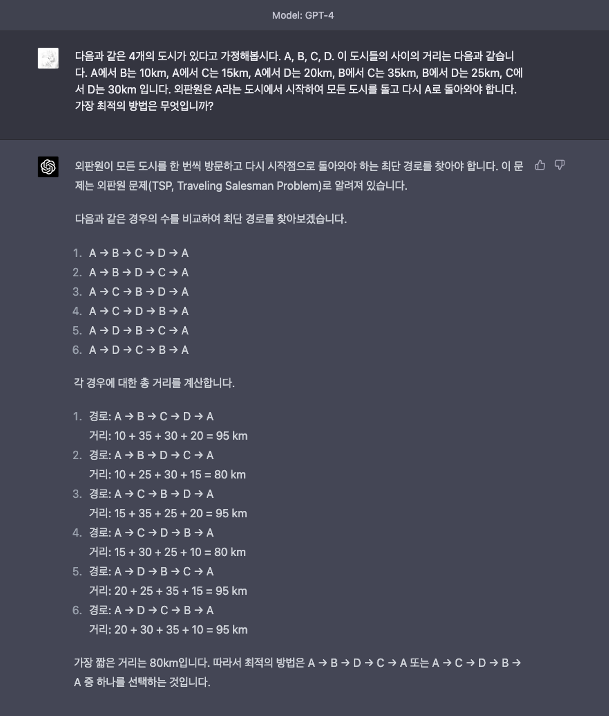
GPT-4는 4개 도시의 외판원 문제를 성공적으로 해결했습니다.
외판원 문제에서 GPT-3.5는 틀린 답을 내놓았지만 GPT-4는 성공적으로 해결했습니다.
정리 및 의견
여전히 GPT-4도 오류가 발생하지만 GPT-3.5보다 확실히 개선이 되었습니다.
OpenAI는 GPT-4가 많은 실세계 시나리오에선 아직 인간보다 능력이 떨어지지만 딥러닝을 확장하기 위한 노력의 최신 이정표라고 설명하고 있습니다.
매우 놀라운 것은 ChatGPT가 서비스된 지 몇 개월도 되지 않아 충분히 놀란만 한 성능을 보이는 GPT-4를 발표했다는 것입니다.
당초 2023년 말이나 되어야 나올 것이라는 예상과는 다르게 말이죠.
위에 여러 예시만 보더라도 생성형 AI의 무궁무진한 활용 가능성을 충분히 보여주고 있는 것 같습니다.
One 님의 최신 블로그
더보기-

- StableCode 사용 가이드 (Feat. AI 코딩 도구)
- Github에서 진행한 Survey reveals AI’s impact on the developer experience 설문조사에 따르면, 미국 개발자의 92%가 업무 내외에서 AI 코딩 도구를 사용하고 있으며 이 중 70%는 AI 코딩 도구가 더 나은 품질, 완성 시간 단축, 문제 해결 등에서 이점을 제공한다고 응답했습니다. 또한, 5명 중 4명의 개발자가 AI 코딩 도구가 협업을 강화하는데 도움이 될 것이라고 생각한다고 답하였습니다. StableCode 공개 지난 8월 8일 Stability AI는 프로그래밍 언어 코드 생성을 가능하게 하도록 설계된 새로운 개방형 대규모 언어 모델(LLM)인 StableCode의 첫 공개 릴리스를 발표하였습니다. Stable...
-

- ChatGPT : Voice Conversations으로 이젠 듣고 말한다 (사용법)
- 이전에는 "ChatGPT: 'Chat with Images'로 이젠 본다"라는 주제로 이미지와의 대화 기능을 소개했었습니다. ChatGPT: 'Chat with Images'로 이젠 본다 (사용법) 이번에는 ChatGPT가 어떻게 '듣고 말한다'는 것인지 대해 다루려 합니다. 사실, 저를 포함해 많은 사람들이 이 기능에 대해 엄청난 기대감을 갖고 있을 것입니다. '언제쯤 이 기능을 직접 사용해 볼 수 있을까?'라는 생각으로 기다렸는데, 제가 오해를 하고 있었습니다. 이 'Voice Conversations'기능은 모바일 App에서만 사용 가능한 기능이었습니다. 이번 글에서는 이 'Voice Conversations' 기능에 대해 자세히 알아보고, 그 특징과 활용 ...
-
- 맞춤형 GPTs의 시대: 나만의 AI 만들기 (초보가이드)
- OpenAI DevDay에서 발표된 GPT-4 Turbo는 분명히 주목할만했지만 개인적으로 더 큰 충격과 흥미를 불러일으킨 것은 바로 맞춤형 GPT, 개인화된 인공지능 어시스턴트를 만들고 배포할 수 있는 GPTs였습니다. 맞춤형 GPTs란 무엇인가? 맞춤형 GPTs는 기본적으로 사용자의 특정 요구사항과 맥락에 맞춰 조정된 AI 모델입니다. 기존의 일반적인 GPT 모델과는 다르게, 특정 분야의 전문 지식이나 특정 언어 스타일, 심지어 개인적 취향에 맞춰 훈련될 수 있습니다. 이러한 맞춤형 접근 방식은 GPT의 활용 범위를 대폭 확장시키며, 더욱 개인화된 경험을 제공합니다. OpenAI DevDay에서는 이러한 맞춤형 GPTs의 중요성에 대해 강조하며, 고급 기술에 ...
-
- ChatGPT : Chat with Images로 이젠 본다 (사용법)
- AI 분야는 지속적인 혁신과 발전의 흐름 속에서 또 다른 역사적인 순간을 맞이하였습니다. 2023년 3월 14일, OpenAI는 GPT-4를 세상에 공개하였는데, 이는 AI의 대화 능력이 단순한 텍스트 기반에서 벗어나 이미지와 텍스트를 동시에 처리할 수 있는 멀티모달 시스템으로 발전했음을 의미했습니다. 더 똑똑해진 GPT-4 발표! 무엇이 달라졌을까? 이전에 저는 GPT-4의 발표와 관련하여 그 특징 중 하나인 멀티모달 기능에 대해 간략하게 언급한 바 있습니다. 당시에는 이 기능이 앞으로 사용이 가능할 것이다라고 소개만 되었지, 실제로 사용자들이 사용하는 것은 불가능했습니다. 그러나 최근의 업데이트를 통해 'Chat with images'라는 기능이 실제로 도입되...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.