
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
실시간 유해 콘텐츠 필터링 - 연구과정(2)

오랜만입니다! 저희는 “실시간 유해 콘텐츠 필터링”을 주제로 SKT AI Fellowship 4기에 참여중인 팀 “Aegis”입니다.
SKT AI Fellowship가 시작된지 얼마지나지 않은 것 같은데 어느덧 여름이 끝나고 가을을 맞이하게 되었네요.
오늘은 연구계획에 이어서 저희가 진행상황 및 변경점에 대해서 공유드리는 한편, 남은 기간동안 진행할 내용에 대해서도 공유드리려고 합니다.
연구계획은 링크에서 확인할 수 있습니다.
1. 연구과제 소개
기존에도 미디어 시장은 영상 콘텐츠와 화상 회의가 활발한 양상이었습니다.
하지만, 2019년 12월 코로나 팬데믹이 전세계를 강타하면서 화상 회의의 빈도는 급속도로 증가하였고, 비대면 생활상에 따른 영상 콘텐츠 공급과 수요의 증가는 기하급수적으로 상승하였습니다.
영상 매체의 증가세에 반하여, 영상 매체의 관리 검열은 사람이 직접 검수하는 방식을 사용하고 있습니다.
이는 느리고 소모적일 뿐 아니라, 각 나라의 문화적 기준에 따라 검수 기준 또한 상이합니다.
따라서 이러한 영상 매체를 효율적으로 검수할 수 있는 서비스가 필요합니다.
Overview
연구계획서에서 자세히 설명했지만, 저희는 Scene Understanding task 중 하나인 **
HOI Detection**을 이용하여 이 문제를 해결하고자 합니다.이미지나 영상에서 이미지 전체의 상황적인 정보를 포착하지 못한다면 해당 장면의 유해성을 명확히 판단하기 어렵습니다. Object detection이나 Pose estimation으로는 이런 상황적인 정보를 정확하게 포착해낼 수 없습니다.
HOI detection을 이용하면 앞선 두 개의 task의 장점뿐만 아니라 상황적인 정보까지 포착할 수 있기 때문에 “유해성”이라는 모호한 정보를 가장 잘 포착할 수 있습니다.
2. 예상 결과물
Model
저희는 기존 HOI 모델들을 Survey하여 기존 모델들의 한게점을 파악했습니다. 대부분의 HOI detection 논문은 DETR 모델의 구조에서 decoder만을 수정하는 방식을 사용하였고, 특히나 AP에 초점을 맞추어 inference time은 신경쓰지 않고 decoder를 복잡하게 만드는 연구 동향이 이어졌습니다.
저희는 HOI detection를 서비스화 시키기 위해서 AP와 inference time 사이의 trade-off를 줄이고자
'ViDT+' 를 이용한 “VTD 모델”을 제안합니다.
Service
저희는 또한 VTD 모델을 서비스에 적용시켜 최종적으론 웹 어플리케이션 형태로 만들려고 합니다.
Youtube, Netflix와 같은 영상 매체 배포 과정에서 편리한 사전 검수가 가능하도록 하고
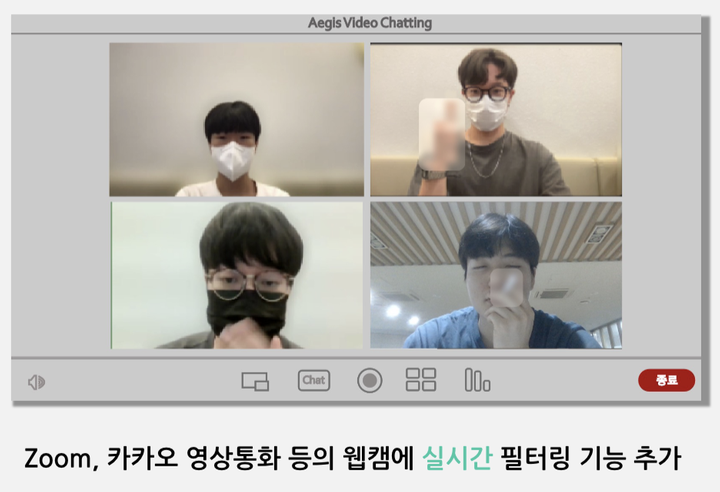
화상통화시 실시간으로 유해 콘텐츠를 필터링 할 수 있도록 하는 것이 저희의 목표입니다.
특히, 영상 콘텐츠 검수 과정에서 유해 콘텐츠의 타입, 등급의 타임로그와 유해 콘텐츠의 위치를 표시해준다면, OTT업체 등 많은 콘텐츠 배포 서비스들에서 드는 시간과 비용에 유의미한 효과가 있을 것으로 기대합니다.
3. 연구 수행방법
저희는 VTD 모델을 만들기 위해 노션 페이지를 적극 활용한 방식으로 이용해 연구를 진행하였습니다.
기존 HOI 모델 논문 리뷰를 통한 기존 모델 카테고리화
저희는 기존 HOI detection, Object detection, Multiple instance Learning 논문들의 리뷰를 통해서 각 모델들의 특징을 카테고리화하고 그들의 장단점을 분류하는 방식으로 연구를 진행하였습니다.
연구일지 작성을 통한 연구 사항 공유
또한 각 인원이 연구일지를 작성해 효율적으로 진행 상황을 공유하였습니다.
최근에는 이 뿐만 아니라 매일 오전 음성미팅을 통해 각 인원의 진행상황에 대해서 공유하고 있습니다.
연구상황 세분화 통한 단계별 진행사항 공유
마지막으로, 큰 틀의 연구상황을 카테고리화해 단계별로 진행상황을 공유하였습니다.
3. VTD 모델
저희의 모델을 설명하기에 앞서 먼저, 저희가 이 모델을 만들게 된 결정적인 계기가 된 **ViDT+**라는 최신 detection 논문에 대하여 말씀드리겠습니다.
VIDT+
ViDT+(ICLR 2022) 모델은 최근 Object detection 분야에서 SOTA를 달성했을 뿐만 아니라 Inference time도 상당히 빠른 구조를 가지고 있습니다.DETR과 다르게 input image의 feature를 추출할 때
Swin Transformer를 사용하여, Transformer의 특징인 Contextual information과 hierarchical을 부여하였고 Patch와 DET token 전체에 대해서 Self attention을 취하는 것이 아닌Reconfigured attention module을 활용하여 Patch와 DET token 각각 따로 Self attention을 취하고 마지막 단계에서만 Cross attention을 취해주어 효율적인 연산을 가졌습니다.마지막으로 Decoder에 DET token를 입력하고 Patch token을
EPFF Module로 fusion 해준 fused multi-scale token과deformable attention을 취하고 Feed forward network를 태워 결과물을 추출하는 방식을 이용합니다.
따라서 저희는 기존 HOI detection의 가장 큰 한계점을 DETR을 기본적인 구조로 사용하는 것으로 보고 ViDT+를 활용해 HOI detection을 수행하고자 하였습니다.
VTD
Architecture
저희가 만든 모델은 위와 같습니다. 앞서 설명한
ViDT+모델의 전체적인 구조를 차용하되, HOI detection이란 task에 맞게 decoder 부분을 수정하여 만들게 되었습니다.input이 들어오게 되면,
Swin transformer구조를 이용해 patch간 self attention 연산을 수행하게 되고, detection을 위한 HOI query들끼리도 self attention 연산을 수행하게 됩니다.
이후 계층적 정보를 담은 patch token들과 HOI query간에 cross attention을 수행하여 HOI query들이 patch들의 정보를 담을 수 있도록 합니다.
query를 3개로 복사하여 self attention 연산을 수행하는데, human과 object 모두 detection을 수행하는 과정이므로 parameter sharing하여 실질적으로는 2개의 디코더를 사용하였습니다.
마지막으로
Information Fusion block을 통해 산출물로 구하고자 하는 <human, interaction, object> Triplet 내 정보 간 결속성을 부여하였습니다.
Decoder를 위와 같이 구성한 이유는 두 가지입니다.
Decoder를 Task-Specific하게 구성했을 때의 성능 향상
MSTR, Iwin에서의 성능차이
Conditional Probability에 의거한 정보의 결속성 부여
CPC에서 등장한 Conditional Probabilty한 개의 HOI triplet을 예측할때, decoder에서 det token을 통해 human, object, interaction을
각각 예측하는 것보다 서로의 정보를 알고 예측하는 경우가 더 좋은 결과물을 나타낼 수밖에 없습니다.
결과적으로 4가지의 명시적인 이점을 얻을 수 있습니다.
CNN의 Low resolution feature map을 사용하지 않고 Swin transformer를 활용해 계층적 feature map을 뽑아냄으로써 Small object에 대해서 좋은 성능 확보
Transformer의 long range depedency로 인한 Contextual information 확보
Task Specific decoder 이용함으로써 보다 Optimal한 결과물 확보
Information Fusion block을 이용한 decoder간 정보 공유 통한 triplet의 결과물간 결속성 부여
4. Sevice Pipeline
저희는 모델 개발뿐만 아니라 실제 서비스 개발도 함께 진행하여 모델을 서비스에 적용하려고 하였습니다.
또한 실시간으로 유저의 피드백을 통해 딥러닝 모델의 지속적인 학습이 가능하게끔 고려하였습니다. 이를 통해 한정적인 데이터셋에 대한 한계점을 극복하고자 하였습니다. 서비스의 전체적인 flow는 아래의 그림과 같습니다.
서비스의 빠른 배포와 모델 버전에 따른 실험을 용이하게 하고자 아래의 그림과 같은 CI/CD Pipeline을 구축하여 배포 과정을 자동화시켰습니다.
여기에 추가로 모델의 성능을 실시간으로 모니터링하고, 유저의 피드백이 일정량 이상 쌓여 모델의 재학습이 필요한 경우 자동으로 모델을 학습시키고 모델의 버전을 업데이트하는 과정까지 추가할 예정입니다.
5. 현재 진행상황
데이터셋
현재 데이터셋은 웹크롤링을 통해 폭력, 칼질, 목조르기, 흡연에 대하여 class당 100장(train set 70장/ test set 30장)으로 구성하여 HOI benchmark dataset인 V-COCO와 HICO-DET에 추가하여 사용하고 있습니다.
검출 결과물
HOI baseline 모델인
QPIC의 head 부분만 폭력성 데이터셋을 추가한 HICO-DET dataset을 이용해 fine tuning하여 HOI를 통한 유해 이미지 detection의 가능성을 검증해보았습니다.시각화한 결과물은 아래 파일로 첨부하였습니다.
6. 차후 계획
VIDT+모델에QPIC의 decoder를 붙여 benchmark dataset과 폭력성이 추가된 dataset에 대해 tuning을 진행하고 성능평가를 진행할 것입니다.이후,
VTD모델을 구현하고 성능평가를 진행해볼 예정입니다.완성된 모델들을 웹서비스에 넣고 inference time을 다시 측정할 예정입니다.
폭력성 데이터셋을 추가로 확보하고 선정성 데이터셋을 유해등급에 따라 확보할 예정입니다.
10월
전체 모델과 서비스에 대한 유지보수를 진행할 예정입니다.
allonsy07 님의 최신 블로그
더보기-
- 실시간 유해 콘텐츠 필터링 - 연구결과(3)
- 안녕하세요! SKT AI Fellowship 4기 6번 과제를 연구한 팀 Aegis입니다. 이 글이 저희의 마지막 글이 될 것 같습니다. 지금부터 저희가 과제를 수행하기 위해서 했던 공부들을 공유하려고 합니다. 과거엔 주로 TV 방송으로 미디어를 즐겼다면, 최근엔 유튜브나 OTT를 통해 대부분의 미디어를 접하게 됩니다. 미디어의 종류와 양이 풍부해짐과 동시에 이를 관리하는 시스템에 부하를 가하고 있습니다. 요즘 초등학생들과 이야기해봐도 깜짝 놀랄 때가 많죠. 교육적으로나 사회적으로나 미디어의 즉각적이고 효과적인 관리는 필수적이죠. 따라서 저희는 아직 현업에 적용하기엔 부족하지만 잠재력은 충만한 솔루션을 통해 데모 웹애플리케이션까지 만들어 보았습니다. 그럼 이야기 ...
-
- 실시간 유해 콘텐츠 필터링 - 연구과정(2)
- 오랜만입니다! 저희는 “실시간 유해 콘텐츠 필터링”을 주제로 SKT AI Fellowship 4기에 참여중인 팀 “Aegis”입니다. SKT AI Fellowship가 시작된지 얼마지나지 않은 것 같은데 어느덧 여름이 끝나고 가을을 맞이하게 되었네요. 오늘은 연구계획에 이어서 저희가 진행상황 및 변경점에 대해서 공유드리는 한편, 남은 기간동안 진행할 내용에 대해서도 공유드리려고 합니다. 연구계획은 링크에서 확인할 수 있습니다. 1. 연구과제 소개 기존에도 미디어 시장은 영상 콘텐츠와 화상 회의가 활발한 양상이었습니다. 하지만, 2019년 12월 코로나 팬데믹이 전세계를 강타하면서 화상 회의의 빈도는 급속도로 증가하였고, 비대면 생활상에 따른 영상 콘텐츠 공급과 수...
-

- 실시간 유해 컨텐츠 필터링 서비스 - 연구 계획(1)
- 1. 연구 과제 소개 시대가 발전함에 따라 소비자의 콘텐츠 소비량 및 영상 매체 제작의 접근성이 증가하여 일평균 1억개를 넘는 영상이 업로드되고 이용 시간은 일평균 10억 시간을 넘어가고 있습니다. 제작자들은 자극적인 콘텐츠를 제작하게 되고, 소비자들은 자극적인 콘텐츠에 쉽게 노출되게 됩니다. 늘어나는 수요에 맞추어 통신/미디어플랫폼 및 서비스의 확장이 이어지고 있습니다. 현재 영상매체 플랫폼에서는 부적절한 콘텐츠를 분류 및 차단하는 방식으로 영상 파일의 제목, 세부정보, 콘텐츠 등록자의 연령 제한 설정, 사용자의 신고 등을 취합하고 있습니다. 그러나 이는 유해 콘텐츠 들로부터 사용자를 보호하기에는 역부족입니다. 유해 콘텐츠들을 실시간으로 감지하고 필터링하는 기술...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.