
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Deep Learning 기반 Super-Resolution 기술 요약 연재 #1 - SRCNN, VDSR
Image, Video 화질 개선 분야에서 Deep Learning 기술의 발전을 통해 큰 혜택을 받은 Task 중 하나가 Super-Resolution입니다.
Super-Resolution은 저해상도, 저화질의 영상을 고해상도, 고화질의 영상으로 변환하는 Task를 수행합니다.
본 연재를 통해 Deep Learning 기반 Super-Resolution 연구의 초창기부터 현재까지의 주요 논문들을 핵심 아이디어만 요약하여 그 발전 과정을 소개하고자 합니다.
Super-Resolution에 처음으로 Deep Learning을 적용하여 인상적인 성과를 보임으로써
전통적인 방식의 Image/Video Signal Processing 연구자들이 Deep Learning에 관심을 가지도록 한 SRCNN 모델과 Residual Learning 개념을
Super-Resolution Task에 적절하게 도입하여 학습과 추론 성능을 모두 개선한 VDSR 모델로 시작합니다.
SRCNN
주요 특징
Super-Resolution 분야에 처음으로 Convolutional Neural Network (CNN) 기반 Deep Learning 방식 적용
기존의 Sparse Coding-based SR Method를 해석 가능한 Network Architecture 제안
기존 Sparse Coding-based SR Method
Input Image→ Bicubic Interpolation→ Patch Extraction and Representation→ Non-Linear Mapping→ Reconstruction→ Output Image
각 단계의 특화된 알고리즘을 모두 CNN Layer로 대체
Layer 1) Patch Extraction and Representation = Conv2D:c×9×9×64 / ReLU
Layer 2) Non-Linear Mapping = Conv2D:64×1×1×32 / ReLU
Layer 3) Reconstruction = Conv2D:32×5×5×c
Image 출처: https://medium.com/analytics-vidhya/srcnn-paper-summary-implementation-ad5cea22a90e
해석
첫번째 Layer에서 9x9 Convolution과 ReLU를 거쳐 입력 영상의 Spatial한 특징 추출함
두번째 Layer에서 1x1 Convolution과 ReLU를 거쳐, 각 픽셀 단위의 64개 입력 Feature를 32개 Feature로 Non-Linear Mapping함
마지막 Layer에서 5x5 Convolution을 통해 Non-Linear Mapping된 중간 출력 Feature를 기반으로 최종적인 High Resolution 영상을 Reconstruction함
기존 방식은 Handcrafted Feature를 사용하고 각 단계를 개별적으로 최적화하지만, SRCNN은 End-to-End로 모든 단계를 동시에 최적화하는 방식으로 학습
Loss Function: MSE
실험 결과
PSNR 기반 객관적 화질 및 실행 시간 비교
기존 방식 대비 PSNR과 처리 속도에서 모두 월등히 좋은 결과를 보임
주관적 화질 비교
기존 방식과 비교하여 계단 현상을 완화하고 선명도가 개선되는 것을 확인할 수 있음
VDSR
주요 특징
The Deeper, the Better (20 Layers)
SRCNN의 얕은 Layer 수로 인한 성능 한계를 개선
깊은 Layer를 통한 Receptive Field 확장 효과로 인한 많은 Contextual Information 활용 가능
Residual Learning, Adjustable Gradient Clipping 제안
Super-Resolution은 저해상도 영상에 High Frequency 성분에 상응되는 Residual을 더하는 개념으로 정의할 수 있기 때문에 Residual을 중점적으로 학습하도록 접근
Deep Network의 Gradient Vanishing/Exploding 문제 해결
High Learning Rate 사용을 가능하게 하여 Deep Network의 학습 시간을 단축
단일 Model로 Multi-Scale (x2, x3, x4) 지원
Loss Function: Residual에 대한 MSE
실험 결과
PSNR 기반 객관적 화질 비교
Residual Learning을 통한 성능 개선 효과
Performance Curve
Network Depth를 증가함에 따라 화질 개선 성능이 높아짐
Non-residual Learning은 학습이 매우 불안정하게 진행되고 수렴 시점도 매우 늦으나, Residual Learning은 빠른 수렴 속도와 안정적인 학습 진행을 보여줌
화질 비교
참고 문서
daftcoder 님의 최신 블로그
더보기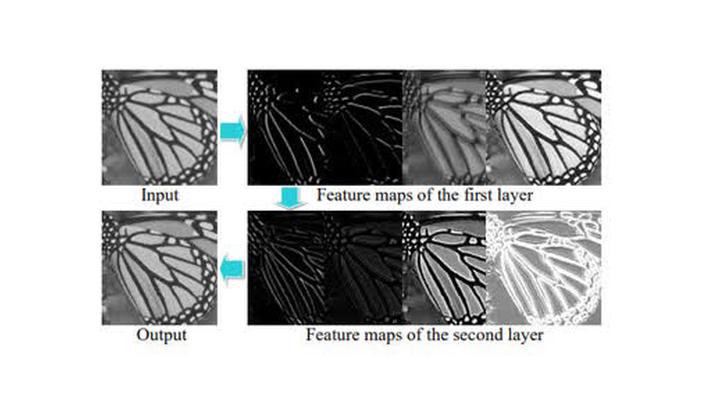

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.