
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
SKT 초고속 데이터 분석 Lightning DB 소개

본 소개자료는 SKT Lightning DB개발팀에서 전달받아 등록하는 자료입니다.
공식 사이트 : https://lightningdb.io/
Lightning DB 소개
개요
Lightning DB는 다양한 환경에서 발생하는 대용량 데이터를 실시간으로 저장하고, 처리 및 조회할 수 있는 기능을 제공하는 실시간 빅데이터 데이터베이스 엔진입니다. Lightning DB 개발팀에서는 대용량 데이터를 효율적으로 분산 처리하여 빠르고 안정적으로 데이터를 저장하고 조회하는 기능을 제공하기 위해 redis와 RocksDB, Apache Spark과 kafka와 같은 오픈소스들을 기반으로 필요한 기능들을 개발하여 Lightning DB를 만들고 SK telecom 내부의 여러 곳들에 제공 및 운영하고 있습니다. 이번에는 Lightning DB의 구조와 함께 SK telecom에서 Lightning DB가 어떻게 활용되고 있는지를 살펴보도록 하겠습니다.
구조 및 특징
Lightning DB의 중심에는 DRAM과 SSD를 효율적으로 사용하기 위해 설계하고 개발한 FlashBase가 있습니다. FlashBase는 DRAM과 SSD를 최대한 효율적으로 사용하기 위해 작은 단위로 데이터를 나누어 저장할 수 있도록 설계1 한 데이터 저장소로, redis와 RocksDB를 기반으로 구현하였습니다. FlashBase를 사용하여 데이터를 더 작은 단위로 더 많은 노드들에 분산하여 실시간으로 저장하고 조회할 수 있으며, DBMS의 주요 연산들을 데이터가 저장된 곳에서 처리하여 더 빠른 시간에 질의에 응답할 수 있습니다.
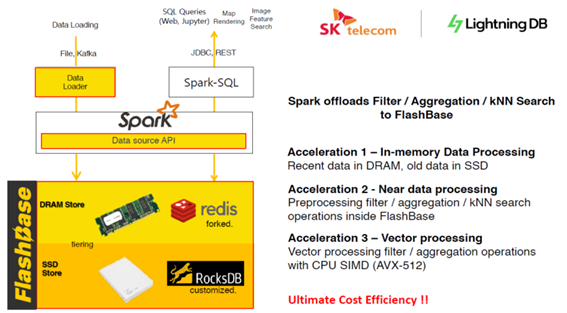
[Lightning DB의 구조 및 주요 특징]
특히, FlashBase는 단일 노드에 최대 20억개까지의 파티션을 생성하고 관리할 수 있어, 대량의 시계열(time-series) 데이터나 공간(geospatial) 데이터, 시각(vision) 데이터를 효율적으로 분산 저장하고 조회할 수 있습니다. 예를 들어, 최근 1주일 사이에 30만개의 기기에서 보내온 로그 데이터 1,420억건(약 42TB) 중에서 특정 조건을 만족하는 14,829개의 레코드(record)를 질의하는 환경을 가정해보겠습니다. HDFS를 데이터 저장소로 사용하는 Spark2은 데이터를 찾는데 약 30분 가량의 시간이 걸리지만, FlashBase를 데이터 저장소로 사용하는 Spark3에서는 동일한 조건으로 데이터들을 찾는데 1초도 걸리지 않습니다. 이와 같은 속도 차이는 더 작은 단위로 파티션을 나누어 데이터를 저장하기 때문에 발생합니다. HDFS에는 분단위로 데이터가 저장되어 있어 10,080개의 분단위 파티션(= 7일 x 24시간/일 x 60분/시간)에서 주어진 조건을 만족하는 데이터를 찾아야 하는 것에 비해, FlashBase는 기기별 x 분단위로 파티션을 나누어 데이터를 저장하고 있어 총 30억개(= 30만개의 기기별 x 10,080개의 분단위)의 파티션들에서 주어진 조건에 해당하는 파티션들만 빠르게 찾아낸 다음, 더 적은 데이터들을 대상으로 세부 조건들을 만족하는 레코드를 찾기 때문입니다.4
또한 데이터가 저장된 노드들에서 가능한 연산들을 처리하고 있어, 데이터의 처리 및 전송 과정에서 생기는 병목을 줄이고 있는 것도 주요한 특징 중 하나입니다. 일례로 최대/최소 및 평균값을 찾는 통계 연산을 수행하는 과정에서 Intel이 제공하는 SIMD 기능(AVX-512)5을 활용하여 최소 3배에서 최대 8배6까지의 성능 개선을 보이고 있습니다. 이러한 통계 연산들은 딥러닝 모델의 학습 및 추론을 위한 데이터들의 전처리(preprocessing) 과정에서 사용되기도 하는데, Lightning DB에 저장된 1분 단위의 기초 데이터를 5분 단위로 모아서 정규화하는 전처리하는 단계에서 1.8배에서 1.9배까지의 성능 향상7을 보였습니다.8
그 외 주요한 특징으로는 저장된 벡터(vector) 데이터들에 대한 KNN(K-Nearest Neighbor) 연산을 지원하는 것입니다. KNN 연산은 주어진 질의에 포함된, 저장된 데이터와 동일한 차원의 벡터들에 대해서 가장 가까운 K개의 레코드를 찾는 연산으로, Lightning DB에서는 KNN 연산의 주요한 지표로 활용되는 유클리드 거리(Euclidean distance) 및 코사인 유사도(cosine distance)를 모두 지원하고 있습니다. KNN 연산은 이미지들간의 유사도를 찾는 과정에서 많이 사용되는데, 주어진 이미지에서 추출한 특징 벡처(feature vector)를 Lightning DB에 저장된 특징 벡터들과의 KNN 연산을 통해 어떤 레코드와 가장 유사한지 찾을 수 있습니다. 일반적으로 많은 시간이 걸리는 KNN 연산은 저장된 모든 데이터에 대해서 정확한 KNN(exact KNN) 연산을 하기보다는 근사적인 KNN(approximate KNN) 연산을 하는 경우가 많은데, Lightning DB는 단일 서버에 저장된 약 190만건의 128차원 데이터에 대해서 정확한 KNN 연산을 하는데 질의 당 평균적으로 0.012초로 뛰어난 성능을 보이고 있습니다.9
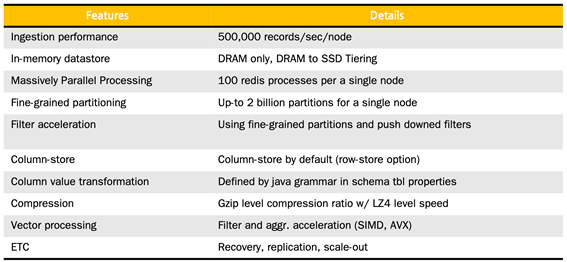
[Lightning DB의 주요 특징10]
지금까지 Lightning DB의 주요한 특징들을 살펴보았습니다. 이 외에도 Lightning DB는 위 그림2와 같은 다양한 기능들을 제공하고 있습니다. 이제 이러한 기능들을 활용하고 있는 사례들을 몇가지 살펴보도록 하겠습니다.
활용사례
먼저 통신망의 품질 분석을 위한 기지국 로그 데이터의 실시간 저장 및 분석에 사용되고 있습니다. SK telecom에서는 통신망 품질을 관리하기 위해 전국에 설치된 기지국들로부터 로그 데이터를 수집하여 실시간으로 저장 및 분석하고 있으며, 이 과정에 Lightning DB가 사용되고 있습니다. Lightning DB는 2017년 3월부터 전국의 기지국들로부터 하루 약 1,200억건, 60TB 가량의 데이터를 전송받아 실시간으로 저장하고 있으며, 필요 시 특정 시간 / 위치의 로그 데이터를 빠르게 조회할 수 있는 기능을 제공하고 있습니다.
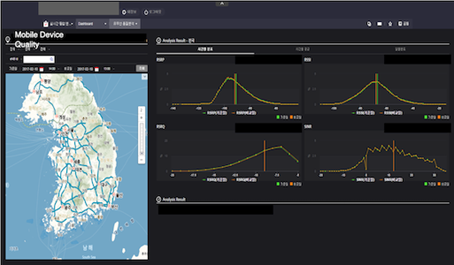
[통신망 품질 분석을 위한 모니터링 시스템 예시 화면]
다음으로는 실시간 유동 인구 분석 서비스 적용되어 있습니다. 실시간 유동 인구 분석 서비스는 SK텔레콤의 기지국별 접속자를 기반으로 특정 지역의 유동 인구를 실시간으로 확인할 수 있는 서비스로, 자체 개발한 빅데이터 플랫폼 지라프(GIRAF)를 통해 서비스되고 있습니다. Lightning DB는 지라프 플랫폼에 필요한 기지국 데이터를 하루 280억건, 14TB 가량 실시간으로 전송받아 저장하고, 총 60TB에 달하는 전체 데이터를 5분 단위로 분석하고 시각화하는데 사용되고 있습니다. 실시간 유동 인구 서비스는 코로나19(Covid-19) 확산 방지를 위해 경찰청에 무상 제공하여 인구 밀집 지역을 확인할 수 있게 하는 등, 여러 공공 기관에 제공되고 있습니다. 자세한 내용은 ‘유동인구 5분 단위로 체크한다… 빅데이터 플랫폼’ 기사 등을 참고해주세요
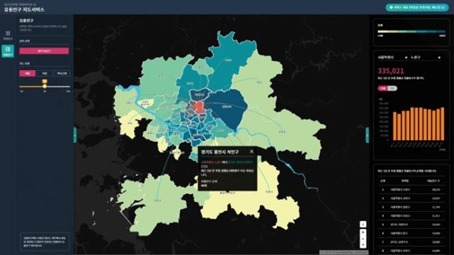
[실시간 유동 인구 서비스 예시 화면]
이처럼 인공지능 시대에 수없이 생성되는 다양한 데이터를 빠르게 저장하고 조회하여 더 나은 삶을 만드는데 Lightning DB가 일조하고 있습니다.
Reference
- Hongchan Roh, et al. B+-tree Index Optimization by Exploiting Internal Parallelism of Flash-based Solid State Drives, VLDB2012
- 20개의 노드에서 실행하였으며, 각 노드는 E5 2650 v4 CPU, 256GB DRAM, 24TB HDD로 구성하였습니다.
- 16개의 노드에서 실행하였으며, 각 노드는 E5 2680 v4 CPU, 256GB DRAM, 20TB SSD로 구성하였습니다.
- 더 자세한 내용은 2019년 Spark+AI Summit에서 발표한 내용을 참고해주세요. (발표 영상 링크)
- Intel이 제공하는 명령 집합 확장 기술(Instruction Set Extension Technology)에 대한 자세한 설명은 이곳을 참고해주세요.
- Mean 연산은 3.2배, Min/Max 연산은 각각 8.35배와 8.1배의 성능 개선을 보였습니다.
- 딥러닝 모델에 학습을 위한 데이터 제공을 할 때는 1.89배의 성능 개선이, 추론을 위한 데이터 제공을 할 때는 1.96배의 성능 개선을 보였습니다.
- 더 자세한 내용은 2020년 Spark+AI Summit에서 발표한 내용을 참고해주세요. (발표 영상 링크)
- Intel E5 CPU가 탑재된 단일 서버에서 측정한 결과입니다.
- 표기된 주요 수치들은 E5 2680 v4 CPU, 256GB DRAM, 20TB SSD로 구성한 노드에서 측정하였습니다.
DevRel 님의 최신 블로그
더보기-

- [전문가 밋업#3] 금융 AI의 진화: 컨텍스트 설계와 에이전트 아키텍처 (은행 AI 전문가가 밝힌, 아무도 말해주지 않는 3가지 진실)
- 요약 금융 산업의 인공지능(AI) 패러다임이 생성형 AI의 등장으로 근본적인 전환을 맞이하고 있습니다. 과거의 AI가 RPA(로봇 프로세스 자동화)나 예측 모델을 통해 개별 업무를 자동화하는 '조각난 효율성'에 머물렀다면, 현재는 고객의 언어를 이해하고 데이터의 '의미'를 연결하여 의사결정을 보조하는 단계로 진화하고 있습니다. 이러한 변화의 핵심은 AI를 단순히 도입하는 것을 넘어, 비즈니스 목표에 맞는 '컨텍스트(문맥)'를 어떻게 설계하고 활용하느냐에 있습니다. 금융권의 미래 경쟁력은 복잡하고 사일로화된 데이터로부터 의미 있는 관계망을 구축하는 '컨텍스트 플로우' 설계 능력에 달려 있습니다. 이를 위해 고객, 상품, 리스크, 영업, 시장이라는 5가지 핵심 컨텍스...
-

- 제9회 데보션 테크 데이 - AI와 함께 일하는 시대, 에이전트와 자동화 기술 발표 요약 및 영상 공유
- 지난 9월 1일 월요일에 SKT타워 4층 SUPEX홀에서 진행한 제9회 데보션 테크데이 발표 요약 및 영상을 공유드립니다. 본 발표 요약은 "에이닷 노트 기능"을 통하여 요약하였습니다. 전체 발표자료는 "제9회_데보션_테크데이_배포용.pdf" 참고 부탁드립니다. 1. AWS 생성형 AI 최신 기술 동향과 주요 업데이트 핵심 단어: Al 에이전트, AWS, 에이전트코어, S3벡터, 스트렌저SDK 요약 Al 에이전트의 발 전단계와 AWS의 대응 서비스 소개 Al 에이전트 개발. 운영을 위한 모델, 도구, 프레임워크 혁신 필요성 설명 AWS의 에이전트코어, S3벡터, 스트렌저 SDK 등 주요 AI 서비스 및 기능 소개 🧠 AI 에이전트 발전 단...
-

- [전문가 밋업#2] AI 서비스 경쟁력은 기능보다 최적화와 UX에서 나온다
- 주요 질문 / 답변 내용 Q. 보이저엑스는 어떤 회사이고, 어떤 제품을 만들고 있나요? A. 2017년 설립된 보이저엑스는 영상·자막 편집 서비스 ‘브루(Vrew)’, 모바일 문서 스캐너 ‘브이플랫(vFlat)’ 등 크리에이터와 지식 노동자를 위한 AI 기반 툴을 개발하는 스타트업입니다. 브루(Vrew): 자동 자막 생성, 텍스트 기반 컷 편집, 텍스트 기반 비디오 생성 기능을 제공합니다. 브이플랫(vFlat): 책이나 문서를 스캔헤 PDF로 변환합니다. 이외에도 AI를 이용한 다양한 서비스들을 출시하고 있습니다. Q. 현재 맡고 계신 역할은 무엇인가요? A. vFlat에 들어가는 on-device 모델을 학습하기도 하고, AI 모델을 서빙하거나 서빙된 모델을 최...
-

- 제8회 데보션 테크 데이 - AI 인프라의 핵심, 데이터센터를 말하다 발표 요약 및 영상 공유
- 지난 7월 10일 목요일에 SKT타워 4층 SUPEX홀에서 진행한 제8회 데보션 테크데이 발표 요약 및 영상을 공유드립니다. 본 발표 요약은 "에이닷 노트 기능"을 통하여 요약하였습니다. 전체 발표자료는 "제8회_데보션_테크데이_배포용.pdf" 참고 부탁드립니다. 위 행사와 관련된 현장 스케치 보도 기사는 아래 SKT 뉴스룸에서 확인하실 수 있습니다. https://news.sktelecom.com/213870 00.Keynote AI 데이터 센터의 구조와 운영 변화 : AI 데이터 센터, GPU 클러스터, 토큰 제조 공장, 전력 최적화, SK 솔루션 요약 AI 데이터 센터는 초병렬 연산과 고전력 소비로 기존 데이터 센터와 구조와 운영 방식...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.