
로그인 선택
미리보기
커뮤니티
1,234

 23.06.15
글 등록
카테고리를 선택해주세요.
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함에 저장되었습니다.
저장일시 : 2022.5.17 14:29:08
임시저장함
제목을 선택하시면 이어서 작성이 가능하며,
최대 20건까지 저장합니다.
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
효율적인 데보션 서비스 이용 및
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 실패
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab - OpenLLM, RAG 2차 챗봇 구현
- DEVOTEE 요약
- OpenLLM 스터디 챗봇 구현 코드로 업데이트했습니다. 주요 파일은 llm.py, langserv_server.py, stream_main.py로 나뉩니다. 각 파일별로 사용될 모델 설정, 서버 설정, 챗봇 UI 코드가 포함되어 있으며, 실행 방법도 제공됩니다.
안녕하세요.
[OpenLLM 스터디] RAG 1차 구현 에 이어서, 챗봇을 만드는 코드로 업데이트 해 보았고, 참고 링크도 동일합니다.
파일은 크게 3개로 구분됩니다.
파일명 | 내용 | 비고 |
|---|---|---|
llm.py | 사용할 open llm 모델 선택 | ollama 환경 모델 |
langserv_server.py | 챗봇이 llm 과 통신할 수 있도록 제공 | |
stream_main.py | 챗봇 UI streamlit 코드 |
1) llm.py
from langchain_community.chat_models import ChatOllama
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate

# LangChain이 지원하는 다른 채팅 모델을 사용합니다. 여기서는 Ollama를 사용합니다.
llm = ChatOllama(model="ggml-q5-km:latest")
2) langserv_server.py
from fastapi import FastAPI
from fastapi.responses import RedirectResponse
from fastapi.middleware.cors import CORSMiddleware
from typing import List, Union
from langserve.pydantic_v1 import BaseModel, Field
from langchain_core.messages import HumanMessage, AIMessage, SystemMessage
from langserve import add_routes
from llm import llm as model


app = FastAPI()

# Set all CORS enabled originsapp.add_middleware(
    CORSMiddleware,    allow_origins=["*"],    allow_credentials=True,    allow_methods=["*"],    allow_headers=["*"],    expose_headers=["*"],)


@app.get("/")
async def redirect_root_to_docs():
    return RedirectResponse("/llm/playground")


class InputChat(BaseModel):
    """Input for the chat endpoint."""    messages: List[Union[HumanMessage, AIMessage, SystemMessage]] = Field(
        ...,        description="The chat messages representing the current conversation.",    )


add_routes(app, model, path="/llm")


if __name__ == "__main__":
    import uvicorn

    uvicorn.run(app, host="0.0.0.0", port=8000)
3) stream_main.py
import os
import streamlit as st
from langchain.embeddings import CacheBackedEmbeddings
from langchain.storage import LocalFileStore
from langchain_openai import OpenAIEmbeddings
from langchain_community.embeddings.huggingface import HuggingFaceEmbeddings
from langchain_core.prompts import ChatPromptTemplate
from langchain_core.output_parsers import StrOutputParser
from langchain_core.runnables import RunnablePassthrough
from langchain_core.messages import ChatMessage
from langchain_text_splitters import RecursiveCharacterTextSplitter
from langchain_community.document_loaders.unstructured import UnstructuredFileLoader
from langchain_community.vectorstores.faiss import FAISS
from langserve import RemoteRunnable
from langchain_openai import ChatOpenAI
from langchain_core.callbacks.streaming_stdout import StreamingStdOutCallbackHandler


# Embedding 설정# USE_BGE_EMBEDDING = True 로 설정시 HuggingFace BAAI/bge-m3 임베딩 사용 (2.7GB 다운로드 시간 걸릴 수 있습니다)# USE_BGE_EMBEDDING = False 로 설정시 OpenAIEmbeddings 사용 (OPENAI_API_KEY 입력 필요. 과금)USE_BGE_EMBEDDING = True# LangServe 모델 설정(EndPoint)# 1) REMOTE 접속: 본인의 REMOTE LANGSERVE 주소 입력# (예시)# LANGSERVE_ENDPOINT = "https://poodle-deep-marmot.ngrok-free.app/llm/"LANGSERVE_ENDPOINT = "https://NGROK에서_할당받은_URL/llm/"# 2) LocalHost 접속: 끝에 붙는 N4XyA 는 각자 다르니# http://localhost:8000/llm/playground 에서 python SDK 에서 확인!# LANGSERVE_ENDPOINT = "http://localhost:8000/llm/c/N4XyA"LANGSERVE_ENDPOINT = "http://localhost:8000/llm/c/N4XyA"# 필수 디렉토리 생성 @Mineruif not os.path.exists(".cache"):
    os.mkdir(".cache")
if not os.path.exists(".cache/embeddings"):
    os.mkdir(".cache/embeddings")
if not os.path.exists(".cache/files"):
    os.mkdir(".cache/files")

# 프롬프트를 자유롭게 수정해 보세요!RAG_PROMPT_TEMPLATE = """당신은 질문에 친절하게 답변하는 AI 입니다. 검색된 다음 문맥을 사용하여 질문에 답하세요. 답을 모른다면 모른다고 답변하세요.Question: {question} Context: {context} Answer:"""st.set_page_config(page_title="OpenLLM local 테스트", page_icon="💬")
st.title("OpenLLM Local 테스트")


if "messages" not in st.session_state:
    st.session_state["messages"] = [
        ChatMessage(role="assistant", content="무엇을 도와드릴까요?")
    ]


def print_history():
    for msg in st.session_state.messages:
        st.chat_message(msg.role).write(msg.content)


def add_history(role, content):
    st.session_state.messages.append(ChatMessage(role=role, content=content))


def format_docs(docs):
    # 검색한 문서 결과를 하나의 문단으로 합쳐줍니다.    return "\n\n".join(doc.page_content for doc in docs)


@st.cache_resource(show_spinner="Embedding file...")
def embed_file(file):
    file_content = file.read()
    file_path = f"./.cache/files/{file.name}"    with open(file_path, "wb") as f:
        f.write(file_content)

    cache_dir = LocalFileStore(f"./.cache/embeddings/{file.name}")

    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=500,        chunk_overlap=50,        separators=["\n\n", "\n", "(?<=\. )", " ", ""],        length_function=len,    )
    loader = UnstructuredFileLoader(file_path)
    docs = loader.load_and_split(text_splitter=text_splitter)

    if USE_BGE_EMBEDDING:
        # BGE Embedding: @Mineru        model_name = "BAAI/bge-m3"        # GPU Device 설정:        # - NVidia GPU: "cuda"        # - Mac M1, M2, M3: "mps"        # - CPU: "cpu"        model_kwargs = {
            # "device": "cuda"            "device": "mps"            # "device": "cpu"        }
        encode_kwargs = {"normalize_embeddings": True}
        embeddings = HuggingFaceEmbeddings(
            model_name=model_name,            model_kwargs=model_kwargs,            encode_kwargs=encode_kwargs,        )

    cached_embeddings = CacheBackedEmbeddings.from_bytes_store(embeddings, cache_dir)
    vectorstore = FAISS.from_documents(docs, embedding=cached_embeddings)
    retriever = vectorstore.as_retriever()
    return retriever


def format_docs(docs):
    # 검색한 문서 결과를 하나의 문단으로 합쳐줍니다.    return "\n\n".join(doc.page_content for doc in docs)


with st.sidebar:
    file = st.file_uploader(
        "파일 업로드",        type=["pdf", "txt", "docx"],    )

if file:
    retriever = embed_file(file)

print_history()


if user_input := st.chat_input():
    add_history("user", user_input)
    st.chat_message("user").write(user_input)
    with st.chat_message("assistant"):
        # ngrok remote 주소 설정        ollama = RemoteRunnable(LANGSERVE_ENDPOINT)
        chat_container = st.empty()
        if file is not None:
            prompt = ChatPromptTemplate.from_template(RAG_PROMPT_TEMPLATE)

            # 체인을 생성합니다.            rag_chain = (
                {
                    "context": retriever | format_docs,                    "question": RunnablePassthrough(),                }
                | prompt
                | ollama
                | StrOutputParser()
            )
            # 문서에 대한 질의를 입력하고, 답변을 출력합니다.            answer = rag_chain.stream(user_input)  # 문서에 대한 질의            chunks = []
            for chunk in answer:
                chunks.append(chunk)
                chat_container.markdown("".join(chunks))
            add_history("ai", "".join(chunks))
        else:
            prompt = ChatPromptTemplate.from_template(
                "다음의 질문에 간결하게 답변해 주세요:\n{input}"            )

            # 체인을 생성합니다.            chain = prompt | ollama | StrOutputParser()

            answer = chain.stream(user_input)  # 문서에 대한 질의            chunks = []
            for chunk in answer:
                chunks.append(chunk)
                chat_container.markdown("".join(chunks))
            add_history("ai", "".join(chunks))
4) 실행
$ python langserv_server.py
INFO:     Started server process [28441]
INFO:     Waiting for application startup.

 __          ___      .__   __.   _______      _______. _______ .______     ____    ____  _______
|  |        /   \     |  \ |  |  /  _____|    /       ||   ____||   _  \    \   \  /   / |   ____|
|  |       /  ^  \    |   \|  | |  |  __     |   (----`|  |__   |  |_)  |    \   \/   /  |  |__
|  |      /  /_\  \   |  . `  | |  | |_ |     \   \    |   __|  |      /      \      /   |   __|
|  `----./  _____  \  |  |\   | |  |__| | .----)   |   |  |____ |  |\  \----.  \    /    |  |____
|_______/__/     \__\ |__| \__|  \______| |_______/    |_______|| _| `._____|   \__/     |_______|

LANGSERVE: Playground for chain "/llm/" is live at:
LANGSERVE:  │
LANGSERVE:  └──> /llm/playground/
LANGSERVE:
LANGSERVE: See all available routes at /docs/

LANGSERVE: ⚠️ Using pydantic 2.7.0. OpenAPI docs for invoke, batch, stream, stream_log endpoints will not be generated. API endpoints and playground should work as expected. If you need to see the docs, you can downgrade to pydantic 1. For example, `pip install pydantic==1.10.13`. See https://github.com/tiangolo/fastapi/issues/10360 for details.

INFO:     Application startup complete.
INFO:     Uvicorn running on http://0.0.0.0:8000 (Press CTRL+C to quit)
$ streamlit run stream_main.py --server.port 8080
You can now view your Streamlit app in your browser.
Local URL: http://localhost:8080
Network URL: http://192.168.0.69:80805) 야구 승률계산법 문의해서 RAG 동작 확인
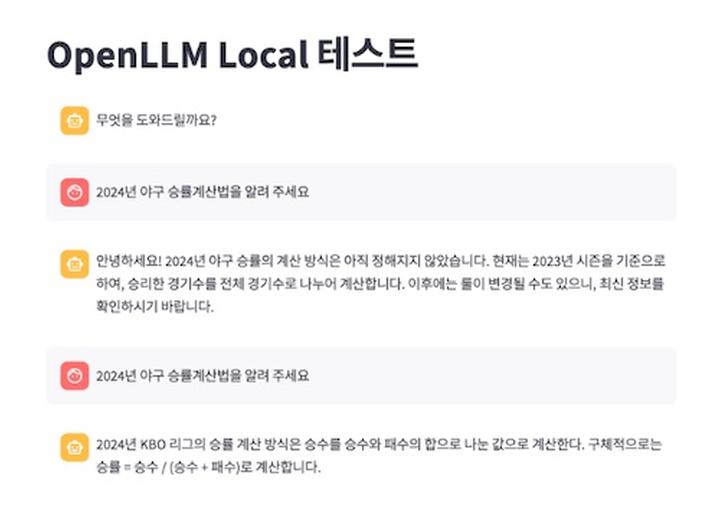
5-1)2024년 KBO 규정을 임베딩 하기 전에 질문하기
5-2)2024년 KBO 규정을 임베딩 한 후 질문하기
위와 같이 정상적으로 제1장에 있는 승률계산법을 정확하게 답변한 것을 볼 수 있습니다.
제1장 KBO 정규시즌
제1조 경기방식
1. 단일 리그제로 각 구단은 144경기(구단간 16차전)씩 총 720경기를 거행한다.
2. 연장전은 12회(KBO 포스트시즌 15회)까지로 하고 승패를 가리지 못할 경우에는 무승부로 한다.
제2조 승률계산법
승률은 승수/(승수+패수)로 한다.
감사합니다.
NoOne 님의 최신 블로그
더보기-
- OpenLab - OpenLLM, RAG 2차 챗봇 구현
- 안녕하세요. [OpenLLM 스터디] RAG 1차 구현 에 이어서, 챗봇을 만드는 코드로 업데이트 해 보았고, 참고 링크도 동일합니다. 파일은 크게 3개로 구분됩니다. 파일명 내용 비고 llm.py 사용할 open llm 모델 선택 ollama 환경 모델 langserv_server.py 챗봇이 llm 과 통신할 수 있도록 제공 stream_main.py 챗봇 UI streamlit 코드 1) llm.py from langchain_community.chat_models import ChatOllama from langchain_core.output_parsers import StrOutputParser from langchain_core.prompts impor...
-
- OpenLab - OpenLLM, RAG 1차 구현
- 안녕하세요. 2024년 야구 규정을 RAG 하는 1차 개념 코드를 작성해 봤습니다. 0) ollama 에 모델을 올려두고 사용하는 코드입니다. $ ollama list NAME ID SIZE MODIFIED ggml-q5-km:latest c3ebb32b93a5 7.7 GB 2 weeks ago $ 1) RAG 는 아래의 순서로 동작합니다. 2) 위의 순서를 코드로 그대로 옮기면 다음과 같습니다. import os from langchain.document_loaders import TextLoader import warnings warnings.filterwarnings("ignore") #########################################...
-
- OpenLab - OpenLLM 1차 OT 및 오프라인 미팅 일정 정리
- 안녕하세요. 9명 스터디 멤버로 구성되었으며, 4/23(화)와 4/25(목) 온라인 OT를 통해서 5월~7월 오프라인 미팅 계획을 아래와 같이 간단하게 협의했고, 진행할 예정입니다. 오프라인 스터디 일정입니다. - 5/8(수)를 시작으로 2주 단위로 20시~21시 - 장소 : 판교사옥 - 사전 온라인 OT 에서 gemma 모델을 사용한 기본적인 LLM Fine Tuning 코드 구조 설명 전체 스터디 흐름입니다. - 5/8(수)까지 개별적으로 모델을 선택해서 예측까지 돌려보는 코드 완성 - 데보션 소통/참여〉커뮤니티에 스터디 전일 24시까지 [OpenLLM스터디] 제목 태그로 등록 - 글 작성 (변경이 적은 경우 업데이트 , 많은 경우 새글) - 월별 목표 1) ...
-
- 맥에서 한글 파일명 자소분리 문제 해결 파이썬 개발
- 안녕하세요. 맥에서 발생하는 한글 자소 분리 문제를 해결할 수 있는 파이썬 코드를 설명 드리겠습니다. 이런 일이 발생하는 이유는 한글이 윈도우와 리눅스에서는 **NFC(Normalization Form Canonical Composition)**로 맥에서는 **NFD(Normalization Form Canonical Decomposition)**로 표기되기 때문입니다. NFC(한글완성형)는 한글이 완성된 형태로 쓰여지고 읽혀지는 방식으로 한글파일.xlsx 라는 파일이 있는 경우 실제 파일명의 저장도 한글파일.xlsx 로 되고 화면에 보여 주는 것도 한글파일.xlsx 로 되는 어떻게 보면 상식적인 방식이라 문제가 없습니다. 하지만, NFD(한글조합형)는 한글파일....
DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.