
로그인 선택
미리보기
커뮤니티
1,234

 23.06.15
글 등록
카테고리를 선택해주세요.
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함에 저장되었습니다.
저장일시 : 2022.5.17 14:29:08
임시저장함
제목을 선택하시면 이어서 작성이 가능하며,
최대 20건까지 저장합니다.
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
효율적인 데보션 서비스 이용 및
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 실패
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab - OpenLLM, RAG 1차 구현
- DEVOTEE 요약
- 이 코드는 2024년 KBO 야구 규정을 RAG(검색 강화 생성) 방식으로 처리하여 질문에 답변하는 개념을 다룹니다. PyMuPDFLoader로 PDF 문서를 로드하고, RecursiveCharacterTextSplitter로 문서를 분리한 후, HuggingFaceEmbeddings로 임베딩하여 벡터 저장소에 저장합니다. 마지막으로, 검색 쿼리에 따라 관련 문서를 추출하고, 올라마 모델로 질문에 답변합니다.
안녕하세요. 2024년 야구 규정을 RAG 하는 1차 개념 코드를 작성해 봤습니다.
0) ollama 에 모델을 올려두고 사용하는 코드입니다.
$ ollama list
NAME             	ID          	SIZE  	MODIFIED
ggml-q5-km:latest	c3ebb32b93a5	7.7 GB	2 weeks ago
$
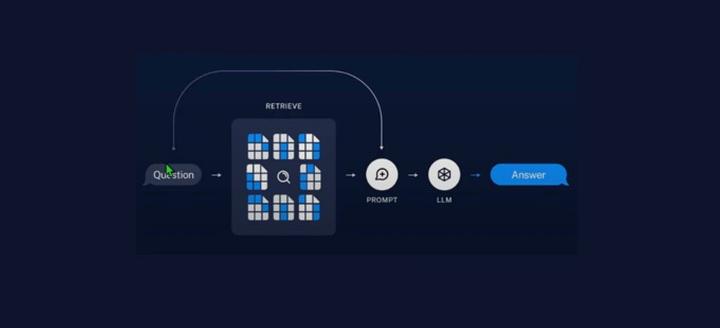
1) RAG 는 아래의 순서로 동작합니다.
2) 위의 순서를 코드로 그대로 옮기면 다음과 같습니다.
import os
from langchain.document_loaders import TextLoader

import warnings
warnings.filterwarnings("ignore")

############################################################################
## TextLoader
############################################################################
#loader = TextLoader('little.prince.txt')
#pages = loader.load()

from langchain_community.document_loaders import PyMuPDFLoader
loader = PyMuPDFLoader("2024.kbo.rules.pdf")
pages = loader.load()

text = pages[0].page_content

import tiktoken
from langchain.text_splitter import RecursiveCharacterTextSplitter


# 문장 임베딩 및 벡터 저장소 생성
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings import HuggingFaceEmbeddings
from langchain.vectorstores import Chroma

############################################################################
## TextSplitter
############################################################################
# 문서를 문장으로 분리
text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
)
docs = text_splitter.split_documents(pages)
#print(docs[0])
#print(docs[1])


############################################################################
## Text Vector Embedding
############################################################################
# 문장을 임베딩으로 변환하고 벡터 저장소에 저장
embeddings = HuggingFaceEmbeddings(
    #model_name='jhgan/ko-sroberta-nli',
    model_name='BAAI/bge-m3',
    #model_kwargs={'device':'cpu'},
    model_kwargs={'device':'mps'},
    encode_kwargs={'normalize_embeddings':True},
)


############################################################################
## VectorStore(Chroma)
############################################################################
vectorstore = Chroma.from_documents(docs, embeddings)


# 벡터 저장소 경로 설정
vectorstore_path = 'vectorstore'
os.makedirs(vectorstore_path, exist_ok=True)

# 벡터 저장소 생성 및 저장
vectorstore = Chroma.from_documents(docs, embeddings, persist_directory=vectorstore_path)
vectorstore.persist()
print("Vectorstore created and persisted")


############################################################################
## retriever
############################################################################
from langchain_core.runnables import RunnablePassthrough
from langchain_community.chat_models import ChatOllama

model = ChatOllama(model="ggml-q5-km", temperature=0)

# 검색 쿼리
query = "승률계산법을 알려 줘"

retriever = vectorstore.as_retriever(search_kwargs={'k': 3})

docs = retriever.get_relevant_documents(query)
#print(len(docs))
#print(docs[0].page_content)
#print(docs[0].metadata)


from langchain_community.chat_models import ChatOllama
from langchain_core.output_parsers import StrOutputParser
from langchain_core.prompts import ChatPromptTemplate, MessagesPlaceholder

# Prompt
template = '''Answer the question in korean based only on the following context:
{context}

Question: {question}
'''

prompt = ChatPromptTemplate.from_template(template)

def format_docs(docs):
    return '\n\n'.join([d.page_content for d in docs])

# RAG Chain 연결
rag_chain = (
    {'context': retriever | format_docs, 'question': RunnablePassthrough()}
    | prompt
    | model
    | StrOutputParser()
)

# Chain 실행
query = "승률계산법을 알려 줘"
answer = rag_chain.invoke(query)

print("Answer:", answer)
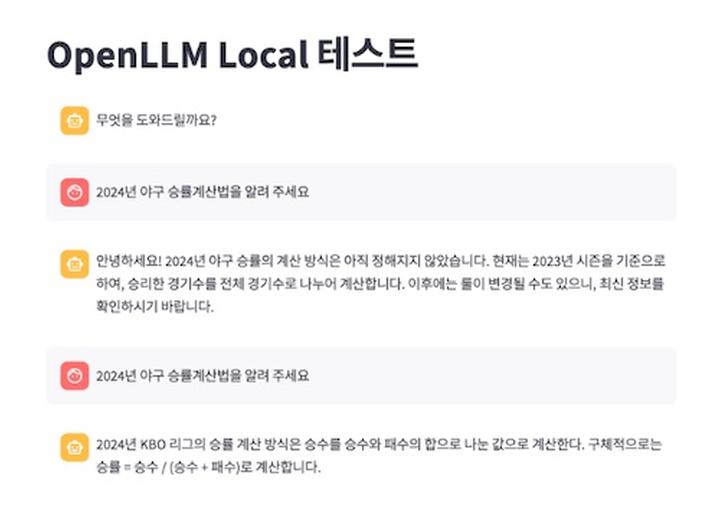
3) 실행해 보면, 승률계산법을 정확하게 답변하는 것을 볼 수 있습니다.
$ python rag_concept.py
Answer: 승률을 계산하기 위해서는 다음과 같은 공식을 사용할 수 있습니다:

승률 = (승리수 / 경기수) x 100

여기서 승리수는 팀이 이긴 게임의 수를, 경기수는 총 플레이한 게임의 수를 의미합니다. 예를 들어, 팀이 60경기 중 40경기를 이겼다면, 그 팀의 승률을 계산하려면 다음과 같이 하면 됩니다:

승률 = (40 / 60) x 100 = 67%

이는 해당 팀이 시즌 동안 67%의 경기에서 승리했음을 의미합니다.
관련해서 연결된 글은 [OpenLLM 스터디] RAG 2차 챗봇 을 참고하세요.
감사합니다.
[+] 참고 사이트 : https://www.youtube.com/watch?v=NfQrRQmDrcc
NoOne 님의 최신 블로그
더보기-
- OpenLab - OpenLLM, RAG 2차 챗봇 구현
- 안녕하세요. [OpenLLM 스터디] RAG 1차 구현 에 이어서, 챗봇을 만드는 코드로 업데이트 해 보았고, 참고 링크도 동일합니다. 파일은 크게 3개로 구분됩니다. 파일명 내용 비고 llm.py 사용할 open llm 모델 선택 ollama 환경 모델 langserv_server.py 챗봇이 llm 과 통신할 수 있도록 제공 stream_main.py 챗봇 UI streamlit 코드 1) llm.py from langchain_community.chat_models import ChatOllama from langchain_core.output_parsers import StrOutputParser from langchain_core.prompts impor...
-
- OpenLab - OpenLLM, RAG 1차 구현
- 안녕하세요. 2024년 야구 규정을 RAG 하는 1차 개념 코드를 작성해 봤습니다. 0) ollama 에 모델을 올려두고 사용하는 코드입니다. $ ollama list NAME ID SIZE MODIFIED ggml-q5-km:latest c3ebb32b93a5 7.7 GB 2 weeks ago $ 1) RAG 는 아래의 순서로 동작합니다. 2) 위의 순서를 코드로 그대로 옮기면 다음과 같습니다. import os from langchain.document_loaders import TextLoader import warnings warnings.filterwarnings("ignore") #########################################...
-
- OpenLab - OpenLLM 1차 OT 및 오프라인 미팅 일정 정리
- 안녕하세요. 9명 스터디 멤버로 구성되었으며, 4/23(화)와 4/25(목) 온라인 OT를 통해서 5월~7월 오프라인 미팅 계획을 아래와 같이 간단하게 협의했고, 진행할 예정입니다. 오프라인 스터디 일정입니다. - 5/8(수)를 시작으로 2주 단위로 20시~21시 - 장소 : 판교사옥 - 사전 온라인 OT 에서 gemma 모델을 사용한 기본적인 LLM Fine Tuning 코드 구조 설명 전체 스터디 흐름입니다. - 5/8(수)까지 개별적으로 모델을 선택해서 예측까지 돌려보는 코드 완성 - 데보션 소통/참여〉커뮤니티에 스터디 전일 24시까지 [OpenLLM스터디] 제목 태그로 등록 - 글 작성 (변경이 적은 경우 업데이트 , 많은 경우 새글) - 월별 목표 1) ...
-
- 맥에서 한글 파일명 자소분리 문제 해결 파이썬 개발
- 안녕하세요. 맥에서 발생하는 한글 자소 분리 문제를 해결할 수 있는 파이썬 코드를 설명 드리겠습니다. 이런 일이 발생하는 이유는 한글이 윈도우와 리눅스에서는 **NFC(Normalization Form Canonical Composition)**로 맥에서는 **NFD(Normalization Form Canonical Decomposition)**로 표기되기 때문입니다. NFC(한글완성형)는 한글이 완성된 형태로 쓰여지고 읽혀지는 방식으로 한글파일.xlsx 라는 파일이 있는 경우 실제 파일명의 저장도 한글파일.xlsx 로 되고 화면에 보여 주는 것도 한글파일.xlsx 로 되는 어떻게 보면 상식적인 방식이라 문제가 없습니다. 하지만, NFD(한글조합형)는 한글파일....
DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.