
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 - LLM fine tuning (6회차)

- DEVOTEE 요약
- LAC는 온디바이스 AI 구현을 위해 로컬 LLM 환경 구축을 진행 중이며 데이터 전처리부터 학습, 경량화 및 어플리케이션 확장을 목표로 합니다. 모델 최적화를 위해 Elice GPU 환경에서 GPTQ를 사용해 양자화를 진행해 추론 속도와 메모리 사용량을 개선했습니다. 앞으로는 경량화된 모델을 활용한 응용 프로그램 개발과 관련된 환경 구상을 탐구할 예정입니다.
안녕하세요 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 주제로 스터디를 진행 중인 LAC 입니다.
overview 로, 저희의 전체적인 프로젝트 진행 방향은 아래와 같습니다:
1. Dataset 전처리 (중복 제거, ... etc)
2. Training -> gemini (Distilation to Gemma)
3. Fine Tuning
4. Optimize & 경량화
5. Application으로의 확장
지난번에는 model의 학습을 위하여 elice 라는 클라우드 플랫폼을 활용하였는데요,
해당 플랫폼을 통하여 저희의 모델 최적화를 진행하였습니다.
최적화 방식으로는 Pruning과 Quantization 중 고민하다, Quantzation으로 결정하여 진행하였습니다.
직전의 elice cloud GPU 환경에서 마찬가지로 진행하였고,
GPU 환경에서 진행하며 GPTQ로 양자화를 진행하여 추론 속도 향상을 목표로 하였습니다.
아래는 해당 관련 code 일부입니다.
이제 남은 과제는, 저희가 경량화를 완료한 AI model을 바탕으로 활용할 수 있는 application 으로의 확장이네요,
다음 모임에서는 저희의 모델을 접속할 수 있는 환경 구상 및 application 응용에 대하여 탐구해보려 합니다.
"""
모델 양자화 스크립트 (AWQ / GPTQ)
학습된 모델을 AWQ 또는 GPTQ로 양자화하여 추론 속도 향상 및 메모리 사용량 감소
"""

import argparse
import logging
import os
from pathlib import Path
from typing import List, Optional

import torch
from datasets import load_dataset
from transformers import AutoModelForCausalLM, AutoTokenizer

from src.utils.log import logger


class QuantizationConfig:
    """양자화 설정"""

    def __init__(
        self,
        model_path: str,
        output_dir: str,
        quantization_type: str = "awq",
        bits: int = 4,
        group_size: int = 128,
        calibration_samples: int = 512,
        dataset_name: str = "Devocean-06/Spam_QA-Corpus",
        dataset_split: str = "train",
        max_seq_length: int = 1500,
    ):
        self.model_path = model_path
        self.output_dir = output_dir
        self.quantization_type = quantization_type.lower()
        self.bits = bits
        self.group_size = group_size
        self.calibration_samples = calibration_samples
        self.dataset_name = dataset_name
        self.dataset_split = dataset_split
        self.max_seq_length = max_seq_length

        # 양자화 타입 검증
        if self.quantization_type not in ["awq", "gptq"]:
            raise ValueError(f"지원하지 않는 양자화 타입입니다: {quantization_type}")

        # 출력 디렉토리 생성
        Path(self.output_dir).mkdir(parents=True, exist_ok=True)


class CalibrationDataProcessor:
    """Calibration 데이터 전처리기"""

    def __init__(self, tokenizer, config: QuantizationConfig):
        self.tokenizer = tokenizer
        self.config = config

    def _build_prompt(self, sample: dict) -> str:
        """Alpaca 포맷(instruction/input/output)을 프롬프트로 변환"""
        instruction = sample.get("instruction", "").strip()
        input_text = sample.get("input", "").strip()

        if input_text:
            # Chat 템플릿 형식으로 변환
            prompt = f"{instruction}\n\nInput: {input_text}"
        else:
            prompt = instruction

        return prompt

    def prepare_calibration_data(self) -> List[str]:
        """
        Calibration 데이터 준비
        - Alpaca 형식 데이터셋을 로드하여 텍스트로 변환
        """
        logger.info(f"📊 Calibration 데이터 로드: {self.config.dataset_name}")

        # 데이터셋 로드
        dataset = load_dataset(
            self.config.dataset_name,
            split=self.config.dataset_split
        )

        # 샘플 수 제한
        if len(dataset) > self.config.calibration_samples:
            dataset = dataset.shuffle(seed=42).select(range(self.config.calibration_samples))

        # 텍스트 변환
        calibration_texts = []
        for sample in dataset:
            prompt = self._build_prompt(sample)

            # Tokenizer의 chat template이 있으면 사용
            if hasattr(self.tokenizer, 'chat_template') and self.tokenizer.chat_template:
                messages = [{"role": "user", "content": prompt}]
                text = self.tokenizer.apply_chat_template(
                    messages,
                    tokenize=False,
                    add_generation_prompt=True
                )
            else:
                text = prompt

            calibration_texts.append(text)

        logger.info(f"✅ Calibration 데이터 준비 완료: {len(calibration_texts)}개 샘플")
        return calibration_texts

    def prepare_calibration_tokens(self) -> List[torch.Tensor]:
        """
        Calibration 데이터를 토크나이즈
        """
        texts = self.prepare_calibration_data()

        logger.info(f"🔄 Calibration 데이터 토크나이즈 중...")
        tokenized_data = []

        for text in texts:
            tokens = self.tokenizer(
                text,
                return_tensors="pt",
                max_length=self.config.max_seq_length,
                truncation=True,
                padding=False,
            )
            tokenized_data.append(tokens["input_ids"])

        logger.info(f"✅ 토크나이즈 완료: {len(tokenized_data)}개 샘플")
        return tokenized_data


class AWQQuantizer:
    """AWQ 양자화기"""

    def __init__(self, config: QuantizationConfig):
        self.config = config

    def quantize(self):
        """AWQ 양자화 수행"""
        try:
            from awq import AutoAWQForCausalLM
        except ImportError:
            raise ImportError(
                "AWQ 라이브러리가 설치되어 있지 않습니다. "
                "다음 명령어로 설치하세요: pip install autoawq"
            )

        logger.info("🚀 AWQ 양자화 시작")
        logger.info(f"   - 모델: {self.config.model_path}")
        logger.info(f"   - Bits: {self.config.bits}")
        logger.info(f"   - Group Size: {self.config.group_size}")

        # 토크나이저 로드
        logger.info("📚 토크나이저 로드 중...")
        tokenizer = AutoTokenizer.from_pretrained(self.config.model_path)

        # Calibration 데이터 준비
        data_processor = CalibrationDataProcessor(tokenizer, self.config)
        calibration_texts = data_processor.prepare_calibration_data()

        # AWQ 모델 로드
        logger.info("🔧 AWQ 모델 로드 중...")
        model = AutoAWQForCausalLM.from_pretrained(
            self.config.model_path,
            device_map="auto",
        )

        # 양자화 설정
        quant_config = {
            "zero_point": True,
            "q_group_size": self.config.group_size,
            "w_bit": self.config.bits,
            "version": "GEMM"
        }

        # 양자화 수행
        logger.info("⚡ AWQ 양자화 수행 중... (시간이 걸릴 수 있습니다)")
        model.quantize(
            tokenizer,
            quant_config=quant_config,
            calib_data=calibration_texts,
        )

        # 양자화된 모델 저장
        logger.info(f"💾 양자화된 모델 저장: {self.config.output_dir}")
        model.save_quantized(self.config.output_dir)
        tokenizer.save_pretrained(self.config.output_dir)

        logger.info("✅ AWQ 양자화 완료!")


class GPTQQuantizer:
    """GPTQ 양자화기"""

    def __init__(self, config: QuantizationConfig):
        self.config = config

    def quantize(self):
        """GPTQ 양자화 수행"""
        try:
            from auto_gptq import AutoGPTQForCausalLM, BaseQuantizeConfig
        except ImportError:
            raise ImportError(
                "GPTQ 라이브러리가 설치되어 있지 않습니다. "
                "다음 명령어로 설치하세요: pip install auto-gptq"
            )

        logger.info("🚀 GPTQ 양자화 시작")
        logger.info(f"   - 모델: {self.config.model_path}")
        logger.info(f"   - Bits: {self.config.bits}")
        logger.info(f"   - Group Size: {self.config.group_size}")

        # 토크나이저 로드
        logger.info("📚 토크나이저 로드 중...")
        tokenizer = AutoTokenizer.from_pretrained(
            self.config.model_path,
            use_fast=True,
        )

        # Calibration 데이터 준비
        data_processor = CalibrationDataProcessor(tokenizer, self.config)
        calibration_texts = data_processor.prepare_calibration_data()

        # GPTQ 양자화 설정
        quantize_config = BaseQuantizeConfig(
            bits=self.config.bits,
            group_size=self.config.group_size,
            desc_act=False,  # activation에 대한 정렬 비활성화 (속도 향상)
            damp_percent=0.01,
        )

        # GPTQ 모델 로드
        logger.info("🔧 GPTQ 모델 로드 중...")
        model = AutoGPTQForCausalLM.from_pretrained(
            self.config.model_path,
            quantize_config=quantize_config,
            device_map="auto",
        )

        # 양자화용 데이터셋 준비
        logger.info("📊 Calibration 데이터셋 구성 중...")

        # GPTQ는 리스트의 딕셔너리 형태를 요구
        calibration_dataset = []
        for text in calibration_texts[:self.config.calibration_samples]:
            tokens = tokenizer(
                text,
                return_tensors="pt",
                max_length=self.config.max_seq_length,
                truncation=True,
            )
            calibration_dataset.append(tokens)

        # 양자화 수행
        logger.info("⚡ GPTQ 양자화 수행 중... (시간이 걸릴 수 있습니다)")
        model.quantize(
            calibration_dataset,
            batch_size=1,
        )

        # 양자화된 모델 저장
        logger.info(f"💾 양자화된 모델 저장: {self.config.output_dir}")
        model.save_quantized(self.config.output_dir)
        tokenizer.save_pretrained(self.config.output_dir)

        logger.info("✅ GPTQ 양자화 완료!")


def main():
    """메인 함수"""
    parser = argparse.ArgumentParser(description="모델 양자화 (AWQ / GPTQ)")

    # 필수 인자
    parser.add_argument(
        "--model-path",
        type=str,
        required=True,
        help="양자화할 모델 경로 (merged 모델 또는 base 모델)"
    )
    parser.add_argument(
        "--output-dir",
        type=str,
        required=True,
        help="양자화된 모델 저장 경로"
    )

    # 양자화 설정
    parser.add_argument(
        "--quantization-type",
        type=str,
        default="awq",
        choices=["awq", "gptq"],
        help="양자화 타입 (기본값: awq)"
    )
    parser.add_argument(
        "--bits",
        type=int,
        default=4,
        choices=[2, 3, 4, 8],
        help="양자화 비트 수 (기본값: 4)"
    )
    parser.add_argument(
        "--group-size",
        type=int,
        default=128,
        help="그룹 사이즈 (기본값: 128)"
    )

    # Calibration 데이터 설정
    parser.add_argument(
        "--calibration-samples",
        type=int,
        default=512,
        help="Calibration 샘플 수 (기본값: 512)"
    )
    parser.add_argument(
        "--dataset-name",
        type=str,
        default="Devocean-06/Spam_QA-Corpus",
        help="Calibration 데이터셋 이름"
    )
    parser.add_argument(
        "--dataset-split",
        type=str,
        default="train",
        help="데이터셋 스플릿 (기본값: train)"
    )
    parser.add_argument(
        "--max-seq-length",
        type=int,
        default=1500,
        help="최대 시퀀스 길이 (기본값: 1500)"
    )

    args = parser.parse_args()

    # 양자화 설정 생성
    config = QuantizationConfig(
        model_path=args.model_path,
        output_dir=args.output_dir,
        quantization_type=args.quantization_type,
        bits=args.bits,
        group_size=args.group_size,
        calibration_samples=args.calibration_samples,
        dataset_name=args.dataset_name,
        dataset_split=args.dataset_split,
        max_seq_length=args.max_seq_length,
    )

    # 양자화 수행
    try:
        if config.quantization_type == "awq":
            quantizer = AWQQuantizer(config)
        else:  # gptq
            quantizer = GPTQQuantizer(config)

        quantizer.quantize()

        logger.info("=" * 80)
        logger.info("🎉 양자화 완료!")
        logger.info(f"   - 양자화 타입: {config.quantization_type.upper()}")
        logger.info(f"   - 저장 경로: {config.output_dir}")
        logger.info("=" * 80)

    except Exception as e:
        logger.error(f"❌ 양자화 중 오류 발생: {e}")
        raise


if __name__ == "__main__":
main() L.A.C 님의 최신 블로그
더보기-

- 나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 프로젝트 - 7회차 모임
- 나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 프로젝트 주제로 스터디 운영중인 LAC 입니다. 어느덧 7회차에 접어들면서, 스터디가 마지막에 다가왔습니다. 직전 6회차 스터디에서는 저희가 학습한 Model의 성능 최적화를 위하여 Quantization 을 도입하여 elice cloud 플랫폼에서 진행하였습니다. 이제는 Application으로의 확장 및 응용을 목표로 논의와 의견 공유를 진행하였습니다. 기본적으로 저희의 모델은 API 기반으로 호출 역시 가능하기에, LLM API 호출하듯 사용하고, Application으로는 User와 저희 Model의 Interface를 직관적으로 진행해주는 방향을 고민해보고자 합니다. 나온 아이디어는 총 2가지로,...
-
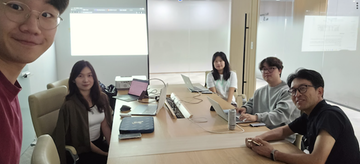
- 나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 - LLM fine tuning (6회차)
- 안녕하세요 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 주제로 스터디를 진행 중인 LAC 입니다. overview 로, 저희의 전체적인 프로젝트 진행 방향은 아래와 같습니다: 1. Dataset 전처리 (중복 제거, ... etc) 2. Training -〉 gemini (Distilation to Gemma) 3. Fine Tuning 4. Optimize & 경량화 5. Application으로의 확장 지난번에는 model의 학습을 위하여 elice 라는 클라우드 플랫폼을 활용하였는데요, 해당 플랫폼을 통하여 저희의 모델 최적화를 진행하였습니다. 최적화 방식으로는 Pruning과 Quantization 중 고민하다, Quantzation으로 결정하여 진...
-
- 나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 프로젝트 (ollama, langchain 활용) - 5회차 모임
- 5회차 활동: Cloud 환경 setup 및 학습 진행! 안녕하세요 Devocean OpenLab : 나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 프로젝트의 host LAC 입니다. 지난번까지는 모델 선정 및 학습 방식에 대한 논의 및 구체화가 진행되었고, script 작성이 진행되었습니다. 해당 환경 및 학습 방식에 대한 자세한 설명은, 아래에 Juan 님께서 자세히 설명해주신 기존 blog를 참고 부탁드립니다 https://devocean.sk.com/community/detail.do?ID=167787 (상세한 작성을 진행해주신 Juan 님께 다시 한번 감사의 말씀을 올립니다 ^-^) 이렇게 고생해서 작성된 환경이니만큼, 위의 환경을 실제로 실...
-
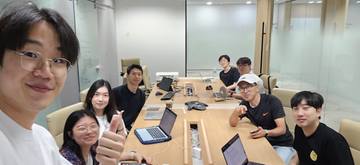
- 나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 프로젝트 (ollama, langchain 활용) - 3회차 모임
- 안녕하세요, 데보션 오픈랩 Host로 활동 중인 L.A.C 입니다. 온디바이스 AI를 위한 나만의 local llm 구축하기 주제로 3회차 모임을 진행하였습니다. 금주는 On device AI 구현을 목표로 project 주제를 선정하였으며, project plan을 수립하였습니다. [Spam 문자 필터링 On Device AI 구현 Projcet] Plan: 1:Dataset (1만개 확보 목표) -〉 중복 Data 제거 작업 2: 중복 제거된 Data를 Gemini의 Input으로 Query 함으로서 Gemini의 답변 확보 3. 확보된 Gemini의 답변을 Gemma에 knowledge Distillation 진행 4. (Optional) 중복 답변 제거 5...
DEVOTEE 추천 블로그
-
- On Device상의 (인지/판단/실행) 모델 파이프라인 기술 개발 - 연구과정(2)
- 안녕하세요 🐰 저희는 On Device상의 (인지/판단/실행) 모델 파이프라인 기술 개발 과제를 수행 중인 SKT AI Fellowship 6기 O.DA (On Device AI) 팀 이선민, 장윤서 입니다. 이번 포스트에서는 저희가 중간 발표까지 3개월동안 진행한 연구 내용에 대해 말씀드리겠습니다. 1. 연구 과제 및 목표 (1) 연구 과제 저희는 사용자로부터 받은 다양한 입력을 직접 인지, 판단, 실행할 수 있는 모델 파이프라인을 연구하고 있습니다. 인지, 판단 파이프라인은 사용자로부터 다양한 입력(ex. text, audio, image 등)을 받으면 On-Device 내에서 사용자의 입력을 처리하고 sLLM을 이용해 사용자의 의도를 파악합니다. 예를 들어...
-

- MLC LLM을 이용한 안드로이드 On-device AI 맛보기
- 들어가며 AI 기술이 급속도로 발전하면서 이제는 클라우드뿐만 아니라 모바일 기기에서도 인공지능 모델을 직접 구동할 수 있는 시대가 되었습니다. 특히, 대형 언어 모델(LLM)을 경량화하여 스마트폰에서 직접 실행할 수 있다면 네트워크 연결 없이도 AI 기능을 활용할 수 있고, 개인정보 보호 측면에서도 큰 장점이 있습니다. 이 글은 AI 분야에 깊은 지식이 없더라도, 안드로이드 디바이스에서 LLM을 직접 구동해보며 AI를 경험해보고 싶은 소프트웨어 개발자들을 위해 작성되었습니다. 제목에 소개된 MLC LLM은 다양한 플랫폼에서 LLM을 효율적으로 실행할 수 있게 해주는 오픈소스 프로젝트로, 이를 활용하면 복잡한 AI 지식 없이도 모바일 환경에서 대화형 AI 애플리케이...
-
- 나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 프로젝트 (ollama, langchain 활용) - 5회차 모임
- 5회차 활동: Cloud 환경 setup 및 학습 진행! 안녕하세요 Devocean OpenLab : 나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 프로젝트의 host LAC 입니다. 지난번까지는 모델 선정 및 학습 방식에 대한 논의 및 구체화가 진행되었고, script 작성이 진행되었습니다. 해당 환경 및 학습 방식에 대한 자세한 설명은, 아래에 Juan 님께서 자세히 설명해주신 기존 blog를 참고 부탁드립니다 https://devocean.sk.com/community/detail.do?ID=167787 (상세한 작성을 진행해주신 Juan 님께 다시 한번 감사의 말씀을 올립니다 ^-^) 이렇게 고생해서 작성된 환경이니만큼, 위의 환경을 실제로 실...
-
- 나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 프로젝트 - 7회차 모임
- 나만의 온디바이스 AI 구현을 위한 로컬 LLM 환경 구축 프로젝트 주제로 스터디 운영중인 LAC 입니다. 어느덧 7회차에 접어들면서, 스터디가 마지막에 다가왔습니다. 직전 6회차 스터디에서는 저희가 학습한 Model의 성능 최적화를 위하여 Quantization 을 도입하여 elice cloud 플랫폼에서 진행하였습니다. 이제는 Application으로의 확장 및 응용을 목표로 논의와 의견 공유를 진행하였습니다. 기본적으로 저희의 모델은 API 기반으로 호출 역시 가능하기에, LLM API 호출하듯 사용하고, Application으로는 User와 저희 Model의 Interface를 직관적으로 진행해주는 방향을 고민해보고자 합니다. 나온 아이디어는 총 2가지로,...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.