
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab 2기 - Cloud 에서 AI 활용하기 7번째 모임 (24.12.02)
안녕하세요!
데보션 오픈랩 2기의 Cloud에서 AI 활용하기(feat. AWS Certi ML 취득)에 참여하고 있는 오주원입니다.
『Generative AI on AWS 』의 9장인 Context-Aware Reasoning Applications Using RAG and Agents를 정리한 자료입니다.
이 책이 2023년에 나와 다소 outdated된 내용이 있어서 제가 RAG 개발을 하면서 느낀 경험도 넣었습니다. 감사합니다.
RAG(Retriever Augement Generation)
문제정의
LLM의 문제점
Halluacination
LLM은 Halluacination을 많이 생성함. → Halluacination은 LLM을 사용한 product 전반의 신뢰성을 저하시킴
Knowledge cutoff
LLM은 학습시킨 정보만을 답할 수 있음.
시간 상의 한계: LLM이 가지고 있는 지식은 LLM을 finetuning한 시점으로 국한됨.
정보의 한계: 공개되지 않은 사내 정보, 라이브러리 등에 대한 질문에도 답할 수 없음.
비용 문제(개인 생각)
LLM을 지속적으로 finetuning하는데 너무도 많은 비용이 소요됨.
RAG를 사용해서 질문에 답하기 위한 context를 넣어주는 작업은 finetuning에 비해서 훨씬 더 적은 비용이 소요됨.
RAG의 문제해결 방안
LLM의 지식이 학습시킨 시점에 국한된다면, LLM에 질문에 답하기 위한 지식을 context로 넣어주자.
RAG의 정의
외부 지식 소스를 사용해서 context를 넣어주어, LLM의 문제를 보완하는 방법.
RAG가 작동하는 순서
유저가 질의를 집어 넣음
Retrieve: 유저의 질의와 관련된 context를 외부 저장소에서 가져옴
Augment Prompt: 검색한 context를 prompt에 추가하여, LLM에 질의할 프롬프트를 생성함(augment)
Call LLM: Prompt를 LLM에 넣어서 return을 받음.
External sources of knowledge
목적
유저가 입력한 질문에 답하기 위한 context를 가져오기 위해서.
context 검색 기준
검색 기준: 유저가 입력한 input query와 적재된 데이터 사이의 유사도를 측정하여 context를 증강함.
일반적으로 사용되는 유사도는 Semantic similarity와 Lexical similarity.
Semantic similarity
embedding model등을 기반으로 측정한 semantic한 유사도.
유사도가 높다는 의미 → 두개의 vector 사이의 distance가 더 가깝다.
distance는 manhattan, euclidian 등의 distance를 의미함.
Lexical similarity: 동일한 keyword의 유무를 기반으로 판단하는 유사도.
BM25 등의 수치를 사용함.
context를 보다 잘 가져오기 위한 Advanced RAG 기법들이 다수 존재함.
RAG Workflow
Document Loading
목적: 질문에 답하기 위한 문서와 문서의 메타데이터를 External knowledge sources/vector store에 적재할 준비를 하는 과정
vector store: 준비된 문서들은 embedding model을 통해서 만들어진 embedding vector를 저장하고 있는 저장소.
embedding model 들은 특정한 어휘의 의미론적 맥락론적인 유사성을 vector 표현으로 변경해줌.
이미지 출처: 테디노트 fastcampus 강의
vector store를 사용하면 원하는 문서를 빠르게 검색하여 context를 검색하는게 가능함.
문서의 내용과 메타데이터 모두를 사용할 수 있음.
Document Loading에서의 주의 사항
일반적으로 많은 문서는 유저가 원하는 질문에 대한 내용만 가지고 있지는 않음.
다양한 주제를 내포하고 있거나, 문서가 지나치게 길 경우 문서 검색을 최적화 할 수 있는 chunking 방법을 선택해야 함.
Chunking
정의: vector store에 적재할 문서를 길이나 의미를 기준으로 자르는 기술
단일 chunk에는 의미론적으로 유의미한 context 정보가 존재해야 함.
고려 사항
원본 document content의 크기
책이나 복잡한 내용을 답고 있는 문서의 경우 chunk size를 키우는 것이 검색과 관련된 정보를 검색하는데 도움을 줌.
작은 product review 등의 경우 chunk size가 큰 의미가 없을 수 있음.
context size: 사용하는 LLM의 context size를 초과하지 않게 주의해야 함.
overlap: 서로 다른 두 chunk사이에 겹치는 부분이 있게 하는 방법.
조금 더 구체적인 chunking option에 대한 정보들
https://velog.io/@autorag/Semantic-%EC%B2%AD%ED%82%B9%EC%97%90-%EB%AC%B8%EC%9E%A5-%EB%B6%84%EB%A6%AC%EA%B8%B0%EB%A5%BC-%EB%B0%94%EA%BF%94%EB%B3%B4%EC%9E%90
Document Retrieval and Reranking
Retrieval: External knowledge sources를 검색하여 질문에 답하기 위한 정보를 불러오는 방법
→ RAG는 결국 LLM에 삽입할 Prompt에 context를 넣어주는 방법
검색을 하기에 LLM이 학습하지 않은 정보에 대한 질문에도 답할 수 있음.
검색 sequence
Reranker
정의: vector store에서 검색한 결과의 순위를 재정렬하주는 기법
reranker와 vector store 검색의 차이점
핵심: Reranker 모델의 경우 유저의 질의와 후보 document를 함께 모델에 넣어서 유사도를 평가함.
cross encoder만 reranker로 사용할 수 있는 것은 아님
LLM 자체에 reranker prompt를 넣어서 reranker와 유사한 용도로 사용할 수 있음.
https://www.linkedin.com/pulse/llm-based-reranking-consistency-junhong-kim-01dgc/
하지만 candidate document를 전부 다 비교해야 하기에 transformer 기반의 reranker 모델에 비해서는 latency와 throughput이 많이 내려가는 문제가 있음.
Embedding 검색 자체가 내재한 취약성도 있음.
Embedding 모델은 반의어, 중의적인 문장등을 잘 다루지 못함.
이런 문제을 handling하는 방법은 case나 usecase 에 따라 달라짐.
특정한 domain에서 사용되는 어휘가 Embedding 모델에는 그리 중요하지 않은 어휘일 수도 있음.
ex) LLM 분야에서 TGI(**Text Generation Inference)**를 찾고 싶은데, TGI Friday가 나오는 경우.
→ 이런 이유로 Keyword search를 함께 사용하는 경우가 많음. 하지만 Keyword search의 경우에도 tokenizer가 매우 중요함.
tokenizer가 좋지 않으면 전혀 제대로 된 역할을 할 수 없음.
→ keyword search 때문에 생각보다 BM25 + Lucene 기반의 검색을 동시에 지원하는 vector DB의 수요가 있음.
ex) Elastic search/Open search
Prompt Augumentation
정의: 사전에 지정된 prompt에 검색된 context를 삽입하는 과정
검색 구조도
RAG Orchestration and Implementation
RAG Orchestration의 기능
데이터 준비, 검색, reranking, 증강에 이르기까지의 과정을 조금 더 쉽게 구현, 통합 할 수 있도록 도와주는 도구.
아래의 부분들에서는 Langchain을 사용해서 RAG를 구현하는 구체적인 코드를 보여줌.
Orchestration을 선택할 때 고려할 수 있는 부분
반드시 Orchestraion tool을 사용해야 하는 것은 아님.
각 요소별로 자체적으로 잘 구현되어 있는 잘 구현되어 있는 tool도 있음. ex) LanceDB
Orchestration Tool의 장점
직접 구현하는 것에 비해서 관리와 사용이 용이함.
“Orchestration Tool”이라는 말처럼 RAG는 다양한 역할을 하는 외부 library와의 연계가 중요함.
Langchain이나 Llama index 등은 이런 외부 라이브러리와 쉽게 연결할 수 있게 해줌.
ex) Langchain clickhouse, lamma index의 PGvector 관련한 기능
→ 개발자가 비지니스 로직 자체에 더욱 전념할 수 있게 해줌.
Langchain의 경우 잘 구현된 객체지향의 장점을 잘 보여줌.
LCEL(Lanchain Expression Language)이 좋음
Langchain 생태계의 장점
Langchain이 사실 거의 표준이 되어 버림
LangGraph, LangServe, Langsmith 등과 연계해서 쓰기 편함.
하지만 반드시 Langchain을 써야 위의 것들을 쓸 수 있는 것은 아님.
Orchestration tool의 단점
내가 꼭 사용하고 싶은 기능이 orchestration tool 에 없을때가 많음.
ex) Langchain PGvector를 지원하지 않음.
Langchain의 안좋은 부분이 내 product로 전이됨.
ex) Langchain 0.2 버전에서 pydantic 1.0 version 만 지원되는 문제.
→ Langsmith, Langserve 등에서도 pydatic 2.0 version을 사용하면 문제를 일으킴.
내가 사용하고 싶은 부분이 없는 경우가 있음.
→ 어떤 부분에서는 내가 class 호환이 가능하게 개발해야 함.
ex) Langchain PGvector의 문제. Triton등에서 직접 class 호환이 되게 개발해야 했음.
너무 class 상속 관계가 복잡함. class 상속을 이어나가다 보니 type hinting 등에서 문제를 일으키는 부분이 있음.
Document Loading and Chunking
기능 정의: Langchain은 다양한 문서를 원하는 chunk를 사용해서 vector store에 loading하기 위한 기능을 제공함
예시: PyPDFLoader: PDF 양식의 문서를 불러오는 class
import glob

from langchain.document_loaders import PyPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter

data_root_path = "./data"
filenames = glob.glob(data_root + "*.pdf")

documents = []

for filename in filenames:
    loader = PyPDFLoader(data_root + file)
    document = loader.load()
    for document_fragment in document:
        # Extract year from filename
        year = filename.split("-").split()[1]
        # Set metadata
        document_fragment.metadata = {"year": year, "source": filename}
    documents += document  # Chunk the docs

text_splitter = RecursiveCharacterTextSplitter(
    chunk_size=512,
    chunk_overlap=100,
)

docs = text_splitter.split_documents(documents)
Embedding Vector Store and Retriever
Langchain을 사용해서 VectorStore 객체를 구성하고, 검색을 하는 코드
AWS는 다양한 embedding 모델과 자산 등을 제공함.
Opensearch: K-NN/ANN 기반의 검색 알고리즘을 지원함.
→ HNSW(Hierarchical Navigable Small World Graphs)랑 IVFFlat (Inverted File with Flat Compression) 쓴다는 거.
구체적인 설명
의미: 일반적인 vector store 보다 빠르게 query에 근접한 vector 값을 찾을 수 있음.
Postgre의 PGvector에서도 지원함.
AWS Kendra
AWS에서 제공하는 관리형 서비
Amazon S3, Microsoft SharePoint, Salesforce, ServiceNow, and Zendesk등과의 connector들을 지원
다양한 format의 데이터를 넣고, metadata, relevance 등을 기반으로 검색을 할 수 있음.
예시
from langchain.vectorstores import FAISS
from langchain.embeddings import SagemakerEndpointEmbeddings
from langchain.embeddings.sagemaker_endpoint import \
EmbeddingsContentHandler
from sagemaker.jumpstart.model import JumpStartModel

embedding_model_checkpoint = "..."
# embedding model
embedding_model =JumpStartModel(model_id=embedding_model_checkpoint).deploy()
embeddings_content_handler = EmbeddingsContentHandler()
embeddings = SagemakerEndpointEmbeddings(
    endpoint_name=embedding_model.endpoint_name,
    content_handler=embeddings_content_handler
)# Load the FAISS vector store with the documents

vector_store = FAISS.from_documents(docs, embeddings)
query = "How has AWS evolved?"
results_with_scores = vector_store.similarity_search_with_score(
query)

for doc, score in results_with_scores:
    print(f"Content: {doc.page_content}")
    print(f"Metadata: {doc.metadata}")
    print(f"Score: {score}\n\n")
    print('----')


## output
Content: AWS is still in the early stages of its evolution, and has a chance
for unusual growth in the next decade.
Metadata: {'year': 2022, 'source': 'AMZN-2022-Shareholder-Letter.pdf'}
Score: 0.5685306191444397
----
Content: AWS continues to deliver new capabilities rapidly (over 3,300 new
features and services launched in 2022), and invest in long-term inventions
that change what’s possible.
Metadata: {'year': 2022, 'source': 'AMZN-2022-Shareholder-Letter.pdf'}
Score: 0.7789842486381531
----

# 특정한 조건을 기반으로 필터링하는 것도 가능함.
filter={"year": 2022}
results_with_scores = vector_store.similarity_search_with_score(query, filter=filter)
for doc, score in results_with_scores:
	print(f"Content: {doc.page_content}")
	print(f"Metadata: {doc.metadata}")
	print(f"Score: {score}\n\n")
	print('----')
Retriever Chains
Chain의 정의
RAG에 필요한 다양한 프로덕트를 한번에 호출할 수 있는 하나의 호출 시퀀스/단위.
예시
from langchain import SagemakerEndpoint
from langchain.chains import RetrievalQA
from langchain.prompts import PromptTemplate

prompt_template = """
User: Use the following pieces of context to provide a concise answer
to the question at the end. If you don't know the answer, just say
that you don't know, don't try to make up an answer.
{context}
Question: {question}
Assistant:
"""
prompt = PromptTemplate(
    template=prompt_template, input_variables=["context", "question"]
)
llm_model_checkpoint = "..."
# generative model like Llama2
llm_model = JumpStartModel(model_id=llm_model_checkpoint).deploy()
llm = SagemakerEndpoint(endpoint_name=llm_model.endpoint_name)

**qa_chain = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",  # stuff the prompt
    retriever=vector_store.as_retriever(
        search_type="similarity", search_kwargs={"k": 3}
    ),
    return_source_documents=True,
    chain_type_kwargs={"prompt": prompt},
)**
query = "How has AWS evolved?"
# Chain을 호출하는 부분.
result = **qa_chain({"query": query})**
print(result["result"])
print("----")
print(f"Context Documents: ")
Reranking with Maximum Marginal Relevance
MMR의 정의
Retriever의 검색 유형로써 문서들 사이의 중복을 최소화 하기 위해서 사용하는 검색 유형
다양성 점수 argument: lambda_mult라는 0에서 1사이의 값을 통해서 문서의 다양성을 조절할 수 있음.
https://wikidocs.net/231585
예시
retriever = vector_store.as_retriever(
    search_type="mmr", search_kwargs={"k": 3, "lambda_mult": 0.1}
)
qa_chain = RetrievalQA.from_chain_type(
    llm=llm,
    chain_type="stuff",
    retriever=retriever,
    return_source_documents=True,
    chain_type_kwargs={"prompt": prompt},
)
query = "How has AWS evolved?"
result = qa_chain({"query": query})
Agent
Agent의 정의
LLM을 추론엔진으로 사용해서 Chain내부의 다양한 요소를 판단하고, 운영하는 기능을 하는 객체.
Agent의 기능: worflow 내부에서 사용자의 입력, 외부 데이터 저장소, 어플리케이션 등을 운영하는 역할을 함.
예시: chain-of-thought (CoT) 프롬프트 등을 사용하면 LLM으로 하여금 step-by-step action plans을 만들도록 하는게 가능함.
action plans을 기반으로 llm이 “python 계산 script나 SQL Query, 인터넷 검색 툴, API 등을 사용”하여, 유저의 query를 해결하게 할 수 있음.
작업 순서
유저의 query를 해결하기 위한 작업 계획을 만듦.
Agent는 미리 정의되어 있는 tool 등을 사용해서 유저의 질의에 답하기 위한 데이터 조회나 API 사용을 할 수 있음.
작성된 prompt를 강화하여 모델이 답변에 필요한 정보를 얻을 수 있게 도와줌.
LLM이 prompt를 사용해서 유저의 질의에 답변함.
Agent를 사용하기 위한 도구들
Langchain Agent, Huggingface, Bedlock 등에서 agent와 연계된 도구들이 존재.
ReAct Framework
정의: COT reasoning과 action planing을 결합한 prompt 전략
prompt에 하나 이상의 질문, 사고, 행동, 관찰 예시등이 있어야 함.
React의 구성요소들
question: 사용자가 요청한 문제나 작업
thought: 문제를 해결하기 위해서 필요한 조치들을 LLM에게 알려주는 reasoning step
action: 모델이 사용할 수 있는 api, tool들
모델이 수행할 수 있는 작업 목록은 example prompt 앞의 목록으로 제공된다.
observation: 행동을 수행한 결과들
예시
유저의 질문: “하와이에서 가장 인기있는 해변에 가까운 호텔의 이름”
React Prompt의 예시
Solve a question answering task with interleaving Thought, Action, Observation steps.
Thought can reason about the current situation, and Action can be three types: (1) wikipedia_search[topic], which searches the topic on Wikipedia and returns the first paragraph if it exists. If not, it will return a similar topic to search.
(2) hotel_database_lookup[request], which performs an API call to the hotel
database to gather hotel information defined in request
(3) Finish[answer], which returns the answer and finishes the task.

생각, 행동, 관찰 단계를 번갈아 가며 질문에 답하는 과제를 해결합니다.
생각은 현재 상황에 대해 추론할 수 있으며, 행동은 세 가지 유형이 있습니다.
(1) 위키피디아에서 주제를 검색하여 존재할 경우 첫 번째 문단을 반환하는 wikipedia_search[topic]. 존재하지 않으면 검색할 유사한 토픽을 반환합니다.
(2) hotel_database_lookup[request], 요청에 정의된 호텔 정보를 수집하기 위해 호텔 데이터베이스에 대한 API 호출을 수행합니다.
데이터베이스에 API 호출을 수행하여 요청에 정의된 호텔 정보를 수집합니다.
(3) Finish[answer]: 답변을 반환하고 작업을 완료합니다.
답변 예시
thought: action을 통해서 나온 답을 확인하고 다음 작업을 계획함.
action: 작성된 다음 작업을 외부의 tool을 사용해서 실행함.
Observation: 찾은 정보를 prompt context로 가져옴.
Question: Which hotel is closest to the most popular beach in Hawaii?
Thought 1: I need to search for the most popular beach in Hawaii and find the
closest hotel for that location.
Action 1: wikipedia_search["most popular beach in Hawaii"]
Observation 1: Waikiki is most famous for Waikiki Beach.
Thought 2: I need to find the hotel closest to Waikiki Beach.
Action 2: hotel_database_lookup["hotel closest to Waikiki Beach"]
Observation 2: <MyDreamHotel> is closest to Waikiki Beach.
Thought 3: <MyDreamHotel> is closest to Waikiki Beach, the most popular beach
in Hawaii. So the answer is <MyDreamHotel>.
Action 3: Finish["MyDreamHotel"]
질문: 하와이에서 가장 인기 있는 해변에서 가장 가까운 호텔은 어디인가요?
**생각 1: 하와이에서 가장 인기 있는 해변을 검색하고 해당 위치에서 가장 가까운
가장 가까운 호텔을 찾아야 합니다.**
실행 1: wikipedia_search["하와이에서 가장 인기 있는 해변"]
관찰 1: 와이키키는 와이키키 해변으로 가장 유명합니다.

**생각 2: 와이키키 해변에서 가장 가까운 호텔을 찾아야 합니다.**
실행 2: hotel_database_lookup["와이키키 해변에서 가장 가까운 호텔"]
관찰 2: <마이드림호텔>이 와이키키 해변에서 가장 가깝습니다.

**생각 3: <마이드림호텔>은 하와이에서 가장 인기 있는 해변인 와이키키 해변에 가장 가깝습니다.**
와이키키 비치에서 가장 가깝습니다. 정답은 <마이드림호텔>입니다.
액션 3: 완료["MyDreamHotel"]
주의: 모델을 문제를 해결하기 위해서 필요한 만큼 반복을 계속함.
문제점: LLM의 경우 수학 연산에 약함.
Program-Aided Language Framework(PAL)
정의: 중간 추론 단계에서 프로그램을 작성하고, 그 프로그램의 결과를 모델로 반환함
구조
특징: PAL 예시가 들어있는 prompt를 기반으로 python script를 만들고, script를 실행하여 답변을 도출함.
예시
"""
Translate a math problem into an expression that can be executed using Python's numexpr library.
Use the output of running this code to answer the question.
Question: ${{Question with hard calculation}}
${{Code that prints what you need to know}}

## 예시
Question: I have four bananas and buy three more, how many bananas do I have?
def solution():
	initial_bananas = 4
	extra_bananas = 2
	return initial_bananas + extra_bananas

## 기대하는 답변
Question: {question}
"""
장점
간단한 사측연산만이 아니라, 미적분, 삼각함수 등의 연산을 직접 해결할 수 있음.
LLM을 바로 사용하는 것에 비해서 정확하고 신뢰성 높은 계산을 할 수 있는 방법.
ReAct와 PAL을 동시에 사용한 예시
serpapi: 검색을 제공해주는 api
주의: langchain.agents는 Langgraph로 이동함.
from langchain.agents import AgentType, initialize_agent, load_tools
from langchain.llms import HuggingFacePipeline
from transformers import AutoModelForCausalLM, AutoTokenizer, pipeline

model_checkpoint = "..."
# generative model like Llama2, Falcon
tokenizer = AutoTokenizer.from_pretrained(model_checkpoint)
model = AutoModelForCausalLM.from_pretrained(model_checkpoint)
pipeline = pipeline("text-generation", model=model, tokenizer=tokenizer)
llm = HuggingFacePipeline(pipeline=pipeline)
tools = load_tools(["serpapi", "llm-math"], llm=llm)
agent = initialize_agent(
    tools, llm, agent=AgentType.ZERO_SHOT_REACT_DESCRIPTION, verbose=True
)
agent.run("""
Which hotel is closest to the most
popular beach in Hawaii, and how much
is each night with 50% discount?
""")
Generative AI Applications
문제정의: LLM과 RAG를 기반으로 생성형 AI 애플리케이션을 관리, 구축하기 위해서 필요한 도구들이 있음.
AWS에서는 이런 요소들을 패키지로 제공함.
인프라
엔드투엔드 애플리케이션을 지원하는 구성 요소에 필요한 핵심 구성 요소.
개인의 사용사례에 맞춰서 다양한 AWS component를 선택할 수 있음.
예시
LangChain은 기본 인프라에서 실행되어야 합니다.
이벤트 중심의 서버리스 컴퓨팅 플랫폼인 AWS Lambda와 같은 AWS 컴퓨팅 서비스에 LangChain을 배포하는 것이 가능.
AWS Lambda를 기반으로 chain을 만들고, 다른 AWS product와 연결한 예시
- 체인에 일련의 장기 실행 프로세스가 포함되어 있는 경우, 컨테이너용 서버리스 컴퓨팅 엔진인 AWS Fargate와 같이 장기 실행 프로세스를 더 잘 지원할 수 있는 인프라를 고려할 수 있습니다.
→ Lambda는 최대 실행시간이 15분이내로 제한되는 event 기반 실행환경. 따라서 chain내부에 장기 실행 프로세스가 있으면 fargate가 나음.
생성 모델 및 머신 러닝(ML) 모델 지원
Amazon SageMaker 등의 infra에서 ML, LLM, Embedding 모델 등을 전부 배포할 수 있음.
정보 source 지원
Vector DB + OpenSearch, PostgreS 등의 RDB를 RAG에 사용할 수 있음.
생성형 모델의 응답을 cache하는 기능도 존재.
External systems / Tools and frameworks
Agent가 action을 수행하는데 필요한 tool을 제공하는 것도 용이함.
모델 허브 등에 접근하는 것도 용이 ex) Amazon SageMaker JumpStart
Monitoring and logging
인프라, 네트워크, 보안 등 엔드투엔드 시스템을 지원하는 모든 구성 요소를 모니터링하고 로깅할 수 있음.
모델과 RAG 기반 워크플로우의 주요 구성 요소에 대한 지속적인 모니터링도 가능
생성형 AI System 전반을 평가하는 Metric을 제공.
Generated outputs and feedback
Caching: 사용된 생성된 출력과 입력 프롬프트를 캡처하고 저장할수 있는 기능. LLM 연산의 비용이 저장하는 것보다 크기에 LLM의 답변을 저장하는 방법을 많이 사용함.
Feedback: 악의적인 사용자의 사용을 저지하기 위한 guardrail로 많이 사용.
ex) jail breaking 등을 막기 위한 경우.
애플리케이션 인터페이스
aws는 Lambda 등을 사용해서 REST API 형태로 쉽게 사용자에게 제공할 수 있도록 도와줌
Amazon API Gateway: 프런트엔드 인터페이스로써 완료에 대해서 즉각적으로 응답하고, 요청과 트래픽을 관리하고 권한 부여자와 연결을 관리할 수 있음.
Cognito: API에 접근할 수 있는 사용자와 수준을 결정할 수 있음.
Operational tooling
CI-CD 제공
생성형 AI를 프로덕트를 만들때 사용할 수 있는 AWS 도구들
FMOps: Generative AI Project Life Cycle 운영하기
FMOps(Foundational Model Operations)
생성형 AI 프로덕션을 구축, 배포 운영하기 위해서 필요한 안정적이고 효율적이며, 반복 가능한 메커니즘을 구축하는 것.
GenAIOps, FMOps 또는 LLMOps라고도 부름.
LLM을 활용하는 것에 더불어서 Finetuning하는 것도 포괄함.
전체 사이클 소개
Experiments
목표: 가용한 LLM 모델을 실험하고 가장 적합한 후보를 식별하는 것입니다.
모델 성능을 평가하는 자동화된 프레임워크를 구축해야함.
프롬프트 카탈로그
용도
특정 도메인에서 성공한 프롬프트의 패턴을 문서화 하는 도구
성공한 프롬프트의 패턴을 기반으로 새로운 모델을 평가하거나, 미세조정할때 사용할 수 있음(? sft에서 prompt를 사용한다는 건가?).
평가 데이터 저장
실험 카탈로그 제공 기능이 필요함.
Autorag에서 얼추 다 됨.
Development Considerations
Model lineage
정의: 모델이 어떻게 구축되었는지, 어떤 성과를 내었는지, 어떤 데이터로 학습되었는지 기록하는 도구.
일반적인 MLops와의 유사성
모델의 입력, 평가 metric, version과 관련된 모델 artifact를 저장함.
차이점
완전한 의미에서 lineage를 기록하는 것은 어려움.
→ 많은 자칭 “opensource LLM”들은 가중치만을 공개하는 경우가 많음. 모델의 세부정보를 기록해야 lineage가 됨.
FMOPs의 예시
Production Deployment Considerations
LLM production을 배포할 때 고려해야하는 사항들
IaC 등으로 모델을 프로비저닝 할 수 있는 형태로 두는게 좋음. ex) Docker compose나 terraform과 같은 형식으로 언제든지 재배포 할 수 있는 형태로 두기.
쉬운 재현, 롤백, AB test 등이 전부 가능함.
모델 레지스트리 관리하기
예시: Lora등을 사용하려면 모델과 관련된 종속성, meta data 정보들이 관리되야 함.
제대로 Lora를 사용하기 위해서는 Foundational model, LoRA Adaptor 등의 정보가 전부 필요함.
komnenos 님의 최신 블로그
더보기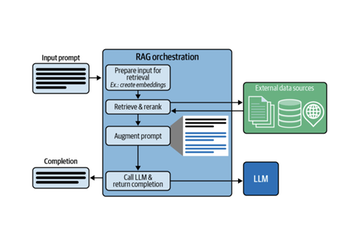

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.