
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
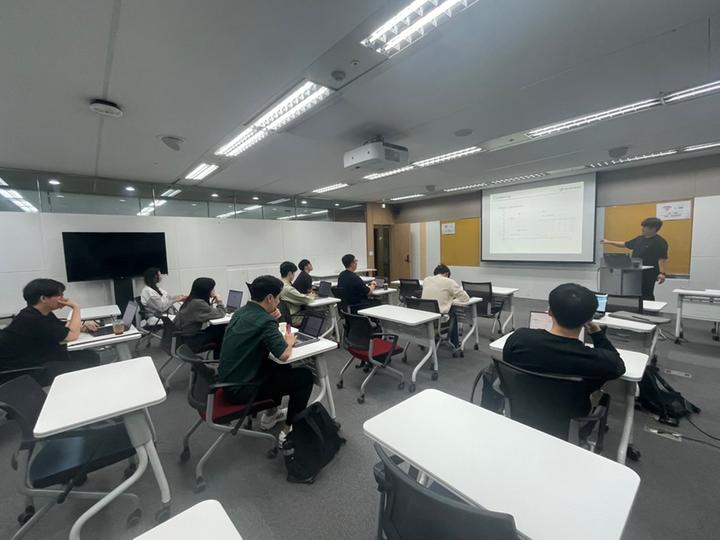
OpenLab 2기 - Cloud 에서 AI 활용하기 세번째 모임: 시각화와 모델링 with AWS
- DEVOTEE 요약
- 데보션 오픈랩 2기에서 클라우드에서 AI 활용을 학습하는 프로그램에 참여하여 데이터 시각화와 이해를 중심으로 AWS QuickSight 사용법을 익히고, 머신러닝 모델에 관한 심화 학습을 진행했습니다. 데이터 시각화의 4가지 주요 유형과 Amazon QuickSight의 다양한 기능을 배웠으며, Amazon EMR과 SageMaker를 활용한 데이터 모델링과 내장 알고리즘도 탐구했습니다. 참여자들이 쌍방향으로 즐겁게 학습하며 클라우드에서 AI 활용을 증진할 수 있는 유익한 시간이었다고 합니다.
안녕하세요, 데보션 오픈랩 2기의 Cloud에서 AI 활용하기 (AWS Certi MLS 취득) 에 참여하는 강호현 입니다.
1부에서는 제가 Cloud에서 AI를 활용한다면 빠질 수 없는 데이터 시각화와 이해,
그리고 AWS QuickSIght에 대해 발표 하고 구성원간 질의 응답과 해당 내용에 대한 각자의 경험을 나누는 시간을 가졌습니다.
2부에는 더욱 재밌고 고급스러운 머신러닝 모델에 대해 깊이 있게 학습해 볼 수 있었습니다.
데보션 영으로도 활동 중이신 박병영님의 발표가 더해져서 신선하고 재미있게 배울 수 있었습니다.
간단히 후기를 남겨보고자 합니다.
1부: 데이터 이해 그리고 시각화 with Amazon QuickSight
데이터를 이해하고 그에 맞게 시각화하는 방법에 대해 배웠습니다. 데이터 시각화의 목적에 따라 약 4가지 유형으로 나눌 수 있습니다.
변수간 관계를 살펴보거나, 두개 이상의 변수를 비교하고, 데이터의 분포를 볼 수 있습니다.
마지막으로 하나의 변수를 이루는 구성 요소를 나누어 살펴보는 방법을 생각할 수 있습니다.
1. 관계(Relationship)
두 변수의 관계를 살펴본다면, 산점도(scatter plot)와 버블 차트(bubble chart)가 적합합니다.
산점도는 두 변수의 관계를 정적이거나 부적, 혹은 관계 없음을 한눈에 살펴보기 좋은 시각화 방법입니다.
주로, 상관관계를 시각적으로 먼저 살펴볼 때 유용하게 쓰입니다. 한 변수가 증가할 때, 다른 변수가 감소하는지, 함께 증가하는지, 그대로인지 등 경향성을 살펴볼 수 있습니다.
버블 차트는, 그 산점도에 하나의 축인 버블의 크기를 더한 것입니다. 상관관계 외에도 한가지 더 설명하고 싶을 때 유용할 것입니다.
2. 비교(Comparisons)
두 개 이상의 변수가 있다면, 비교를 하고 싶습니다. 변수를 비교할 때는, 막대 그래프(Bar chart), 스택 컬럼 차트(stacked column charts), 컬럼 차트, 선 그래프(line charts) 등이 있습니다.
막대 그래프는, 한 변수에 다양한 클래스가 있다면 한눈에 비교하기 좋습니다.
한국에 여러 지역구에서 코로나 양성 환자 수를 비교한다면, 막대 그래프로 지역별로 코로나 양성 환자의 수를 막대 하나씩 놓고 비교할 수 있겠습니다.
스택 컬럼 차트는, 여기에 하나의 조건을 추가한 것입니다. 가령 타이타닉 호에서 생존자와 사망자 수를 비교하는데, 여기서 성별을 나누어 비교해볼 수 있습니다.
사망자 수가 생존자 수보다 많은데, 그 중에서 생존자 중에서는 여성이 많고, 사망자 중에서는 남성이 많은 것을 그래프로 한눈에 확인할 수 있습니다.
컬럼 차트와 선 그래프는, 변수의 시간에 따른 변화량을 함께 볼 수 있습니다.
즉, 하나의 시점을 본다면 막대 그래프, 스택 컬럼 차트를 사용하고, 시간의 변화량을 보려면 컬럼 차트, 선 그래프를 생각할 수 있습니다.
3. 분포(Distributions)
데이터의 분포를 한눈에 확인하려면, 히스토그램이 가장 적합합니다. 전반적인 분포를 보기 좋고, 별도 어려운 프로그래밍이 필요하지 않습니다.
각 구간에 맞는 빈도 수를 그래프로 표현하고 있어 아주 유용합니다. 다만, 특정한 경우에는 굉장히 치우친(skew) 경우가 있습니다.
이런 경우에는 구간을 더 나누거나 조정해주는 게 필요하겠습니다.
다른 방법으로는 상자 그래프 혹은 Box plots가 있습니다.
단순한 빈도수로 전반적인 분포를 확인하는 것 외에도 중앙값, 1분위수, 3분위수, 최대값, 최소값, 이상치까지 한눈에 확인할 수 있는 도구입니다.
통계량을 함께 표현할 때는 상자 그래프를 사용해봅시다.
4. 구성(Compositions)
하나의 변수 안에 다양한 요소가 있습니다. 이 요소간 비중을 비교해볼 수도 있고, 그 구성 방식을 다양하게 보여줄 수 있습니다.
파이 차트(Pie chart), Stacked chart, tree map 등을 활용해보면 좋습니다. 그 외에도 KPIs(핵심 성과 지표)를 활용해서 시각화를 할 수 있다는 점을 배웠습니다.
그 지표로는 이탈율, 기업 충성도 지표인 NPS, ROI 등이 있다고 합니다.
이를 적절히 사용하면 훌륭한 시각화가 가능할 것입니다.
AWS에서는 자랑하는 완전 관리형 시각화 도구인 Amazon QuickSight라는 서비스가 있습니다. 이것을 활용해보는 방법을 배울 수 있었습니다.
5. Amazon QuickSight
AWS Cloud 기반의 분석 서비스 중에 데이터 시각화 및 사후 분석 기능을 제공합니다.
특히, 다양한 데이터 소스를 지원하고 있는데요. AWS가 제공하는 Redshift Aurora, RDS, Athena 외에도 온프레미스 데이터 솔루션도 데이터 소스로 활용할 수 있다고 합니다.
특히, S3가 가능하고, 형식은 Excel, CSV, 로그 파일 부터 다른 써드 파티 SaaS 솔루션도 지원한다고 하니 유용해보입니다.
특히 SPICE(Super-fast, Parallel, In-memory, Calculation Engine)이라는 기능이 있어서, 데이터셋을 이 QuickSight에 최적화된 구조로 만들 수 있다고 합니다.
이 기능에 대해 좀 더 공부해볼 예정입니다.
이렇게 사용 방법도 간단하고, 시각화 외에도 간단한 데이터 준비를 도울 수 있는 기능이 있습니다.
비용이 문제일 뿐이죠. 다른 시각화 도구와 비교해보면 더욱 와닿는 부분입니다.
즐거운 퀴즈 타임
배운 내용을 복습하는 퀴즈 시간을 보냈습니다. 많은 분들의 적극적인 참여로 저도, 구성원도 즐겁게 보낼 수 있는 시간이었습니다.
물론 상품은 없었지만, 다들 빠르고 정확한 답변으로 성장하는 기분을 느껴볼 수 있었네요!
2부: 데이터 모델링 with Amazon EMR and SageMaker
아마존에는 머신러닝 및 딥러닝과 같은 도구를 활용해서 데이터를 분석할 수 있는 플랫폼이 있습니다.
아마존 세이지 메이커(SageMaker)라는 도구입니다. 이 도구를 이해하기 위해서 다양한 내장된 알고리즘을 배울 수 있었습니다.
데보션 영으로 활동하시는 박병영님의 명쾌한 발표가 큰 도움이 되었습니다.
대략 6개 정도의 내장 알고리즘을 배웠습니다. 일부는 이미 들어보셨을 수도 있겠네요.
기존에 머신러닝에서 사용하는 모델을 AWS SageMaker에서 사용할 수 있도록 이름만 살짝 바꾼 것도 있습니다.
Linear learner
Factorization machines
XGBoost
KNN
Object2Vec
DeepAR forecasting
이와 관련해서 지도학습, 비지도학습의 정의와 차이점, 위 함수(알고리즘)의 기능을 사례로 들어 재밌게 비교해볼 수 있었습니다.
이러한 도구를 활용한다면, Cloud에서 AI를 활용한 데이터 분석이 좀 더 효과적으로 가능할 것이라 생각합니다.
물론, 관리형 도구인 만큼 어느 정도 비용은 감안해야겠지만요!
이렇게 클라우드의 매력을 한껏 느껴볼 수 있는 시간이었고, 기존에 AI 분야로 현직에서 활동 중이신 주원님의 추가 설명도 어려운 머신러닝 알고리즘을 이해하는데 큰 도움이 되었습니다.
다양한 분야에서 알고 있는 전문 지식을 나누면서 함께 성장할 수 있는 OpenLab, 앞으로의 모습이 기대가 됩니다.
stats 님의 최신 블로그
더보기-
- OpenLab 2기 - Cloud 에서 AI 활용하기 세번째 모임: 시각화와 모델링 with AWS
- 안녕하세요, 데보션 오픈랩 2기의 Cloud에서 AI 활용하기 (AWS Certi MLS 취득) 에 참여하는 강호현 입니다. 1부에서는 제가 Cloud에서 AI를 활용한다면 빠질 수 없는 데이터 시각화와 이해, 그리고 AWS QuickSIght에 대해 발표 하고 구성원간 질의 응답과 해당 내용에 대한 각자의 경험을 나누는 시간을 가졌습니다. 2부에는 더욱 재밌고 고급스러운 머신러닝 모델에 대해 깊이 있게 학습해 볼 수 있었습니다. 데보션 영으로도 활동 중이신 박병영님의 발표가 더해져서 신선하고 재미있게 배울 수 있었습니다. 간단히 후기를 남겨보고자 합니다. 1부: 데이터 이해 그리고 시각화 with Amazon QuickSight 데이터를 이해하고 그에 맞게 시각...
-
- Dev Chat" 데브렐: IT 주도 회사는요? 요약 후기(3)
- IT 회사의 데브렐 아마도 이 글이 마지막입니다. 2부와 3부를 정리해보면서, 주로 IT 주도 회사(라인, 네이버, 카카오) 이야기라는 점을 깨달았어요. 크게 보면, 2부는 DevRel의 성장과 다양성을 주제로 하고, 3부는 함께 성장하기란 주제라고 합니다. 공통적으로 성장하는 다양한 케이스를 다룬다고 볼 수 있고, 웅진씽크빅-Udemy, 카카오, 라인, 네이버/네이버커넥트, 유플러스-아이들나라 출신 분들께서 발표해주셨습니다. 3부 마지막으로 진행한 패널 토크 세션은, 그 내용이 생각보다 많이 솔직합니다. 그래서 제 의견만을 최대한 많이 작성할 생각입니다. 어떤 패널이 무엇을 말하였는가보다, 그냥 제 생각을 통해 해석한 내용으로 정리해보겠습니다. DevRel 로서...
-
- Dev Chat" 데브렐: 대기업은요? 요약 후기(2)
- 전통 대기업의 데브렐 이번에는 1부를 정리해보겠습니다. 무려 대기업편! OEM 회사와 SWITCH 사무국, Beyond 데브렐 이야기를 담아보았습니다. 참고로 항상 요약을 먼저 하고, 의견을 남기는 편입니다. 중간에 섞기도 하는데, 그게 습관이 된것 같네요. OEM, 어디일까요? 현대차입니다. SWITCH, 어디죠? 삼성전자입니다. beyONd, 어딘가요? 롯데 ON입니다. 그런 기업에 다니는 분들 개인의 의견이란 점을 감안해서 보면 좋겠습니다. 이 세분의 공통점이 뭘까요? "전통적인 대기업" 출신입니다. 그 규모에서 데브렐, 궁금합니다. OEM 회사에서의 DevRel, IT업계의 DevRel과 어떤 점이 가장 다른가? - 새롭게 변화하는 모빌리티의 개발 방식: ...
-
- Dev Chat" 데브렐: 개발자 도와주는 거에요? 요약 후기(1)
- Dev Chat" 로고 실제 사진 데보션이 공간 대여 & 케이터링을 해주셨고(정정), 현대자동차가 굿즈 등을 지원한 모임, 데브렐 컨퍼런스(Devchat)에 참여했습니다. 제목에 (1)을 보셨나요? 지금 예상으로는 두 개로 나눠야 할 것 같은데, 일단 이 컨퍼런스는 따로 공개가 안되므로 따로 다시 돌려볼 수가 없습니다. 기억에 남는대로 정리한 것과 제 생각을 담아 후기로 남겨봅니다. 취준생 입장합니다 데브렐, DevRel, Developer Relation, DR 이게 도대체 뭐지? 요새 뜨는 건지 제 눈에 보이는 건지 모르는 용어가 새록 생겨나고 있습니다. 이러한 궁금증을 풀어줄 시원한 모임 한번 가주는게 또 예의가 아니겠습니까? 그래서 신청했습니다. 사전등록 ...
DEVOTEE 추천 블로그
-
- OpenLab - 토이프로젝트 첫 만남을 소개합니다!
- 안녕하세요! 데보션 영 3기 디바 조의 이승연입니다 💃 다들 이번에 데보션에서 AI 중심의 오픈 스터디 프로그램 DEVOCEAN OpenLab 을 진행해서 참여 신청을 받았던 것 알고 계신가요? AI부터 토이 프로젝트까지 주제도 다양하고 SK 현직 개발자분들과 스터디를 진행할 수 있는 너무 좋은 기회라고 생각했습니다. 더불어 다양한 지원도 받으며 스터디를 진행할 수 있기에 주저 없이 바로 신청했고, 주위 사람들에게도 많이 추천 했었는데요! 저는 다양한 주제들 중에 Data&AI DevOps팀 김한성 개발자님이 개설하신 토이프로젝트 스터디에 참여하게 되었습니다! 스터디의 목적은 다음과 같은데요. 토이프로젝트를 말로만 해야지 해야지만 하는 사람들을 위한 스스로 채찍...
-
- OpenLab 2기 - 데이터시각화를 통한 Insight 얻기 (1회차 모임)
- 안녕하세요! 데보션영 3기 TechWave팀의 염정입니다! 이번에 좋은 기회로 데보션 오픈랩 2기에 참여하게 되었는데요! 9/10일 첫 만남을 가진 오픈 랩, 데이터 시각화를 통한 Insight 얻기의 후기를 적어보고자 합니다. 먼저 앞으로의 오픈 랩 일정에 대한 설명을 들었는데요! 태블로 기초 실습 이후, 데이터 전처리, AI를 활용한 대시 보드 자동화, 마지막 세션에서는 본인이 제작한 대시 보드를 발표하는 시간을 가질 것이라고 소개해 주셨습니다. 직접 대시 보드도 제작해보고 다른 분들의 다양한 결과물도 볼 수 있다는 생각에 벌써부터 설레고 기대되었습니다:) 이후에 간단한 자기소개 시간을 가졌는데 대학생, 대학원생, 현직자 분들의 소개를 들으며 함께 할 수 있어...
-
- OpenLab 2기 - Cloud 에서 AI 활용하기 두번째 모임
- 안녕하세요. 데보션 오픈랩 2기의 Cloud에서 AI 활용하기(feat. AWS Certi ML 취득)에 참여하게 된 문대한입니다. 두번째 모임도 역시 을지로 삼화타워에 모여서 진행을 했습니다. 두번째 모임은 Chapter 3의 AWS Services for Data Migration and Processing와 Chapter 4의 Data Preparation and Transformation에 대하여 공부해오는 것이었습니다. 저는 3장 발표를 하게 되었고, 조인환님이 4장 발표를 하게 되었습니다. 원래는 제가 먼저 발표를 했어야 하나 늦게 도착을 하게 되어 조인환님이 먼저 발표를 진행해주셨습니다ㅠ (이 자리를 통해 조인환님께 감사의 말씀을 전합니다..!) 조인...
-
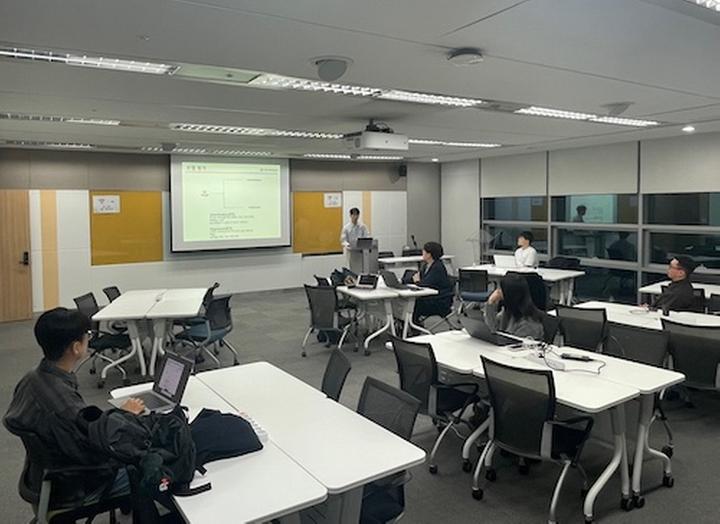
- OpenLab 2기 - Cloud 에서 AI 활용하기 4번째 모임(24.10.21)
- 안녕하세요. 데보션 오픈랩 2기의 Cloud에서 AI 활용하기(feat. AWS Cert ML Specialty 취득)에 참가하고 있는 강형근입니다. 10.21 모임도 을지로 삼화타워 room3에서 모여 진행을 했습니다. 이번 모임은 Chapter 7의 Evaluating and Optimizing Models와 Chapter 8의 AWS Application Services for Al/ML에 대하여 공부해오는 것이었습니다. 제가 7장, 그리고 정경일님께서 8장을 발표해주셨습니다. 사실 제가 늦게 도착하는 바람에 정경일님께서 먼저 발표를 해주셨습니다. 정말 죄송하게 생각합니다 ㅜㅜ 제가 발표를 맡은 Chapter 7은 모델 평가 및 최적화 관련 내용으로 머신러닝...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.