
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab - Generative AI 스터디 4번째 모임

- DEVOTEE 요약
- 6월 10일 Generative AI 스터디에서 "DreamPose: Fashion Video Synthesis with Stable Diffusion" 논문을 다뤘습니다. 이 논문은 Diffusion 기반 Image-to-video 생성 모델로, 입력 이미지와 포즈 시퀀스를 사용해 포토리얼리스틱한 비디오를 만듭니다. 자세한 내용은 논문을 참고하세요.
안녕하세요! 6월 10일 Generative AI 스터디의 4번째 모임을 진행하였습니다.
금일은 "DreamPose: Fashion Video Synthesis with Stable Diffusion" 의 내용을 살펴봤습니다.
이 논문은 ICCV2023에 발표된 논문으로 Diffusion 기반 Image-to-video 생성 모델입니다.
입력된 사람의 이미지와 포즈 시퀀스를 기반으로 DreamPose는 입력된 사람이 포즈 시퀀스를 따르는 Photo-realistic 한 비디오를 생성합니다.
모델의 전체 구조는 아래 그림과 같습니다.
그림에 보면 DreamPose 는 입력 이미지와 포즈를 별도 인코더를 사용는데 이는 입력 이미지가 포즈와 공간적으로 Align 되어 있지 않기 때문입니다.
즉 이미지를 CLIP 이미지 인코더를 한번 거쳐 공간적으로 align 시킴과 동시에 추가 VAE 인코더를 사용하여 영상의 디테일을 살리는데 집중하였습니다.
그리고 입력으로 사용된 포즈는 DensePose 를 사용하여 추출하였네요.
마지막으로 학습에는 Univ. British Columbia 에서 공개한 Fashion Video Dataset을 사용하였습니다.
더 자세한 사항이 궁금하신 분은 논문을 참고해주세요!!!
poderoso 님의 최신 블로그
더보기-

- 06. 음악 기반 자동 안무 동영상 생성 모델 개발
- 1. 연구 소개 1.1. 우리의 연구 목적! Dance Generation! 기본 아이디어는 아래 동영상 처럼 심플함 그 자체! (Volume 높이고~~!!!) 사진 1장과 음악이 입력되면 사진의 인물이 음악에 맞춰 춤을 추는 안무 동영상을 생성합니다. 나의 사진을 넣고 K-pop 스타처럼 춤추는 영상을? 만들면 어떨까요? Intro Movie - 여기를 클릭해서 동영상을 확인하세요! 즉, 음악과 댄스 동작간의 관계를 이해하고, 이를 바탕으로 자동으로 안무 동영상을 생성하는 모델을 개발하는 것이 본 연구 그룹의 목표입니다. 2. 연구 목표 아이디어는 심플하지만, 연구해야 될 분야는 아주 다양합니다. 각 분야 모두 최신 생성형 AI 기술분야이며 흥미진진합니다. 본 ...
-
- OpenLab - Generative AI 스터디 5번째 모임
- 안녕하세요! 7월8일 5번째이자 마지막 스터디를 진행하였습니다. 오늘의 논문은 "Champ: Controllable and Consistent Human Image Animation with 3D Parametric Guidance" 입니다. 이논문읜 최근에 Arxiv 에 올라왔습니다. 아직 학회에 발표되진 않았습니다. 본 논문은 앞서 소개했던 논문과 달리 SMPL 기반의 3D 포즈 guidance를 적용하였습니다. 3D 사용의 장점으로 인간의 기하학적 구조를 잘 보존한다는 강점을 지녔다고 강조합니다. 아래 영상에서 왼쪽의 reference 이미지와 중간의 SMPL 기반 특성이 주어지면 오른쪽의 동영상을 생성하게 됩니다. 모델 구조는 다음과 같습니다. 우선 입력이...
-
- OpenLab - Generative AI 스터디 4번째 모임
- 안녕하세요! 6월 10일 Generative AI 스터디의 4번째 모임을 진행하였습니다. 금일은 "DreamPose: Fashion Video Synthesis with Stable Diffusion" 의 내용을 살펴봤습니다. 이 논문은 ICCV2023에 발표된 논문으로 Diffusion 기반 Image-to-video 생성 모델입니다. 입력된 사람의 이미지와 포즈 시퀀스를 기반으로 DreamPose는 입력된 사람이 포즈 시퀀스를 따르는 Photo-realistic 한 비디오를 생성합니다. 모델의 전체 구조는 아래 그림과 같습니다. 그림에 보면 DreamPose 는 입력 이미지와 포즈를 별도 인코더를 사용는데 이는 입력 이미지가 포즈와 공간적으로 Align 되어 ...
-
- OpenLab - Generative AI 스터디 3번째 모임
- 안녕하세요 5월 27일 저희의 3번재 모임을 진행하였습니다. 금일 저희 스터디에서 발표한 논문은 다음입니다. "PEEKABOO: Interactive Video Generation via Masked-Diffusion" 최근 비디오 생성분야의 빠른 진전이 있었지만 아직도 공간-시간을 제어하기 위해선 모델의 재훈련이나 외부 어댑터등이 필요합니다. 이러한 작업은 매우 어렵고 시간과 자원이 많이 소요됩니다. 본 논문은 다음과 같은 문제를 다룹니다. "초원에서 말이 달린다" 라를 프롬프트와 말이 포함된 사진이 주어졌을때 짧은 동영상 클립을 생성하는 문제입니다. Peekaboo는 기존 방법과는 달리 재훈련이나 추론시간을 늘이지 않고 기존 공간 및 시간 축을 제어하는 모델을...
DEVOTEE 추천 블로그
-
- OpenLab - Generative AI 스터디 1번째 모임
- 오픈랩 - Generative AI Study모임의 첫 모임을 4/29 가졌습니다. 처음이라, 미흡한 부분이 많았지만 7월까지 차근차근 진행하면 모두 좋은 결과 얻을거라 생각됩니다. 저희 모임은 6시에 판교 SK텔리콤 사옥에서 진행되었구요. 진행 내용은 다음과 같습니다. 팀원간 소개 고준석님의 Diffusion Model 발표 NCSN, DDPM, Diffusion Model beat GAN on Image Synthesis, Calssifere free guidance, Stable diffusion, ControlNet 등의 내용을 명확하게 소개하였습니다. 피자와 함께하는 토론 시간 다음 일정 / 스터디 목표 수립 최근 SORA의 발표로 비디오 생성모델에 관심...
-
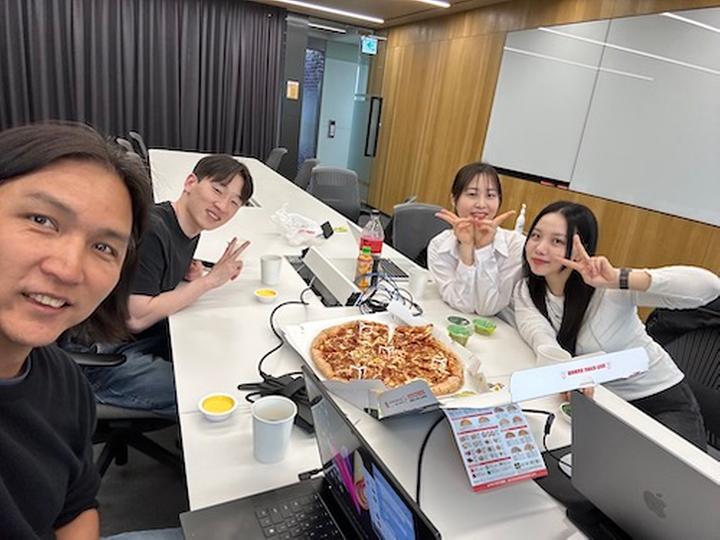
- OpenLab - Generative AI 스터디 2번째 모임
- 안녕하세요! 5월 17일 2번째 모임을 판교 사옥에서 진행하였습니다. 발표는 이정인 님께서 수고해 주셨어요. 발표 논문은 다음과 같습니다. "Follow-Your-Pose : Pose-Guided Text-to-Video Generation using Pose-Free Videos" 본 논문은 Pose 를 입력으로 동영상을 생성하며 데모는 다음 링크에서 볼수 있습니다. 링크 이 논문에서의 특징정은 2 단계 학습입니다. 일반적으로 Pose video 와 캡션이 있는 데이터는 공개된 것이 없고 또 대량으로 수집하기기 어려워 본 논문에서는 2단계 학습을 제안합니다. 1단계에선 이미지 기반으로 포즈를 추출하여 포즈 기반으로 이미지를 생성하는 방법을 학습을 시기키고 2단계...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.