
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab - Kotlin 6회차, Kafka

- DEVOTEE 요약
- 이번 블로그는 오픈랩 코틀린 스터디 마지막 6회차에서 배운 Kafka 내용을 정리하고 회고하려고 합니다. Kafka는 로그 기반의 분산 스트리밍 플랫폼으로, 대용량의 실시간 데이터 처리가 가능하고, 이를 SpringBoot 프로젝트에서 사용하는 방법도 학습했습니다. 스터디 참여를 통해 Spring 공부에 방향을 잡을 수 있었고, 많은 새로운 기술들을 배우며 성장할 수 있었습니다.
안녕하세요, kchabin이란 이름으로 활동 중인 강다빈입니다.😎
저번엔 오픈랩 코틀린 스터디 5회차 후기글을 작성했었는데요, 이번엔 마지막 6회차 스터디에서 배운 Kafka 내용 정리와 회고를 해보고자 합니다.
Kafka
Kafka는 로그 기반의 분산 스트리밍 플랫폼입니다.
Kafka와 RabbitMQ의 차이점
둘 다 스트림 처리에 사용할 수 있는 메시지 대기열 시스템입니다. Kafka는 대용량의 실시간 데이터를 처리하고 저장하는데 중점을 두고, RabbitMQ는 메시지를 송신자에서 수신자로 전달하는데 중점을 둡니다.
(AWS:Kafka와 RabbitMQ의 차이점은 무엇인가요?)
이미지 출처 : Part 1: RabbitMQ for beginners - What is RabbitMQ?
RabbitMQ로 전달된 메시지는 queue로 전달되지 않고, 전화교환원 같은 exchange로 전달됩니다.
여기서 key에 따라서 어떤 큐로 넣을지 달라지고, 이 exchange가 SOPF가 될 수 있어 이를 안 두는 방식으로 쓰기 위해 Kafka를 사용한다는 걸 지난 스터디에서 간단히 배웠습니다.
Kafka는 RabbitMQ와 메시지 큐 전달 방식이 다릅니다.
Broker : producer가 consumer에게 데이터를 스트리밍하게 해주는 kafka의 서버.
Topic = 카테고리로, 메시지 송수신용 통로 역할을 합니다. broker 내부에 존재합니다.
zookeeper는 kafka 메타데이터와 클러스터 상태를 관리합니다.
Partition : Topic 내부엔 여러 개의 partition이 존재합니다. kafka producer가 write 동작을 할 때, producer가 생성한 레코드는 broker -> topic -> partition 순으로 이동하여 저장됩니다.
partition 개수는 얼마만큼 병렬 처리를 할 것인가에 따라서 달라집니다.
kafka의 주요 기능들을 좀 더 알아보겠습니다.
Offset
Consumer가 읽은 곳에 offset이 가 있게 됩니다. 읽어가는 위치를 찍어놓고, 메시지가 들어올 때마다 producer offeset은 최신 위치를 가리키게 됩니다.
kafka는 offset을 통해서 레코드를 읽게 됩니다.
READ: 레코드를 파티션으로부터 읽어오기PROCESS: 특정 처리 수행COMMIT: 처리 완료 후 커밋을 브로커로 보내서 처리 완료 알림
Partitioner
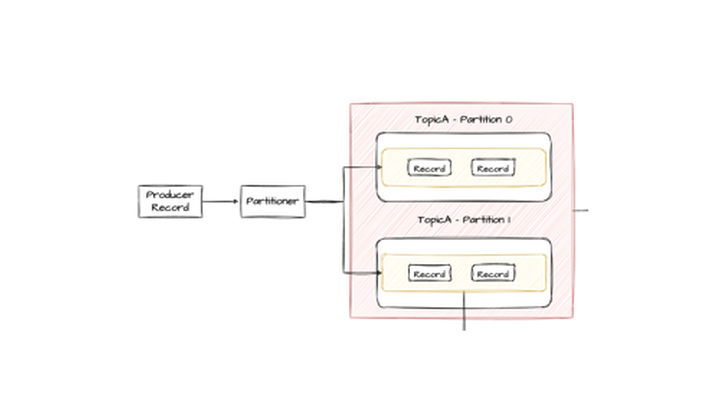
partition 내부는 큐같아서, 순서를 보장하지만 partition끼리는 순서가 보장되지 않습니다.
그림처럼, partitioner가 producer가 생성한 레코드를 지정된 토픽의 특정 파티션으로 전달할 때 key의 유무에 따라 방식이 달라집니다.
Key가 있다 | 해시 값으로 결정 |
|---|---|
Key가 없다 | 라운드로빈으로 전달 -> 순서 보장 x |
hash값에 따라 파티셔닝을 할 때, 동일한 해시 결과가 나오는 키를 가진 레코드는 동일한 파티션에만 들어갑니다.
이 때문에 해시값을 사용하는 방식은 파티션 내 레코드의 순서가 보장됩니다.
Kafka with SpringBoot
Kafka를 스프링부트 프로젝트에서 사용하려면 어떻게 해야하는지도 간단히 배웠습니다.
dependecies:
Spring web
Lombok
Spring for Apache Kafka
스터디에선 docker-compose.yaml 파일을 만들어 zookeeper, kafka broker를 설정했습니다.
의존성 설정 -> 애플리케이션 설정 -> kafka producer 설정 -> 메시지 객체 생성 -> ProducerController 작성 -> kafka consumer 설정 -> kafka listener 설정 등이 이뤄져야 합니다.
의존성 설정
implementation ('org.springframework.kafka:spring-kafka:2.8.1')Kafka 접속 설정
# Kafka endpoint for endpoint
 kafka.bootstrap-servers=localhost:29092,localhost:29093,localhost:29094
bootstrap-servers : broker를 위한 endpoint 경로
KafkaAdmin
Spring Kafka에서 제공하는 클래스로, Topic을 생성 및 수정, 삭제하는 역할을 합니다.
기본적으로 localhost:9092에 접속하도록 설정되어있어 bootstrap-servers로 접속하도록 수정해야 합니다.
@Configuration
public class KafkaAdminConfig {

    @Value("${kafka.bootstrap-servers}")
    private String bootstrapServer;

    @Bean
    public KafkaAdmin kafkaAdmin() {
        Map<String, Object> configs = new HashMap<>();
        configs.put(AdminClientConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServer);

        return new KafkaAdmin(configs);
    }
}
Topic 생성
 @Autowired
 private KafkaAdmin kafkaAdmin;

//토픽 생성 메서드
 private NewTopic defaultTopic() {
     return TopicBuilder.name(DEFAULT_TOPIC)
                .partitions(2)
                .replicas(2)
                .build();
    }

private NewTopic topicWithKey() {
    return TopicBuilder.name(TOPIC_WITH_KEY)
                .partitions(2)
                .replicas(2)
                .build();
}defaultTopic(): key가 없는 토픽을 생성하는 메서드.topicWithKey(): 키가 있는 토픽 객체를 생성하는 메서드.
Producer 생성
@Configuration
public class KafkaProducerConfig {

    @Value("${kafka.bootstrap-servers}")
    private String bootstrapServer;

    private ProducerFactory<String, Object> producerFactory() {
        Map<String, Object> configProps = new HashMap<>();
        configProps.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServer);
        configProps.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class);
        configProps.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, JsonSerializer.class);

        return new DefaultKafkaProducerFactory<>(configProps);
    }

    @Bean
    public KafkaTemplate<String, Object> kafkaProducerTemplate() {
        return new KafkaTemplate<>(producerFactory());
    }
}
@Value 로 접속 설정 정보를 가져온다.
ProducerFactory: 키로 String, 값은 Object를 갖도록 팩토리를 지정합니다.Broker의 엔드포인트, 전송될 key, 전송될 값을 직렬화하는 방법 설정. 보통 JsonSerializer가 많이 쓰입니다.
KafkaTemplate : Spring Kafka에서 Kafka 브로커로 메시지를 전송하는 데 사용되는 핵심 클래스입니다.
주요 메서드로
send,sendDefault등 토픽에 데이터를 전송하는 메서드들이 있습니다.
메시지 객체
Kafka에 produce하고 consume할 매시지 객체
@Data
@NoArgsConstructor
@AllArgsConstructor
public class testEntity {
    private String title;
    private String contents;
    private LocalDateTime time;
}
ProducerController
메시지를 전송하기 위한 컨트롤러 입니다.
@Slf4j
@RestController
@RequestMapping("/api")
public class ProducerController {

    // kafka producer를 위한 KafkaTemplate를 지정
    private final KafkaTemplate<String, Object> kafkaProducerTemplate;

    public ProducerController(KafkaTemplate<String, Object> kafkaProducerTemplate) {
        this.kafkaProducerTemplate = kafkaProducerTemplate;
    }

    @PostMapping("produce")
    public ResponseEntity<?> produceMessage(@RequestBody TestEntity testEntity) {
        testEntity.setTime(LocalDateTime.now());

        // kafkaProducerTemplate.send를 이용하여 메시지를 전송
        // send(String topic, String data)은 지정된 토픽에 데이터를 전송
        // ListenableFuture로 전송 결과 확인
        ListenableFuture<SendResult<String, Object>> future = kafkaProducerTemplate.send(KafkaTopicConfig.DEFAULT_TOPIC, testEntity);

        // 메시지 처리는 비동기로 처리
        future.addCallback(new ListenableFutureCallback<SendResult<String, Object>>() {
            @Override
            public void onFailure(Throwable ex) {
                log.error("Fail to send message to broker: {}", ex.getMessage());
            }

            @Override
            public void onSuccess(SendResult<String, Object> result) {
                log.info("Send message with offset: {}, partition: {}", result.getRecordMetadata().offset(), result.getRecordMetadata().partition());
            }
        });

        return ResponseEntity.ok(testEntity);

    }
}
Listenable Future
Google의 Guava 라이브러리
비동기 처리의 결과를 나타내는 future의 확장판
기본 future는 스레드가 대기하고 있다가 응답이 오면 변환합니다.
콜백을 등록하여 비동기 작업이 완료되었을 때 특정 동작을 수행할 수 있습니다.
future 는 ListenableFuture<SendResult<String, Object>> 타입의 객체로, Kafka에 메시지를 전송하는 작업의 결과를 저장합니다.
addCallBack() 으로 작업 완료 결과를 처리하는 콜백을 등록하는데 ListenableFutureCallback 인터페이스가 제공하는
메서드 onSuccess ,onFailure 를 사용해서 정상적인 케이스와 비정상 케이스로 나누어 처리되도록 합니다.
onSuccess -> 메시지의 오프셋과 파티션을 로그에 기록
onFailure -> 실패 메시지를 로그에 기록
Kotlin에선 Coroutine 을 사용합니다.
순차적인 코드 스타일 -> 좋은 가독성.
async와 await를 사용하여 비동기 작업을 쉽게 조합 가능
CoroutineScope -> 구조적 동시성
import kotlinx.coroutines.*

fun main() = runBlocking {
    val result = async {
        // 비동기 작업 수행
        "Result"
    }
    // 결과 처리
    println(result.await())
}
Consumer 설정
@EnableKafka
@Configuration
public class KafakConsumerConfig {

    @Value("${kafka.bootstrap-servers}")
    private String bootstrapServer;

    private ConsumerFactory<String, Object> consumerFactory(String groupId) {
        Map<String, Object> props = new HashMap<>();

        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServer);
        props.put(ConsumerConfig.GROUP_ID_CONFIG, groupId);

        JsonDeserializer<Object> jsonDeserializer = new JsonDeserializer<>();
        // Deserialize에 대해서 신뢰하는 패키지를 지정한다. "*"를 지정하면 모두 신뢰하게 된다.
        jsonDeserializer.addTrustedPackages("*");

        return new DefaultKafkaConsumerFactory<>(props, new StringDeserializer(), jsonDeserializer);
    }

    @Bean
    public ConcurrentKafkaListenerContainerFactory<String, Object> defaultKafkaListenerContainerFactory() {
        ConcurrentKafkaListenerContainerFactory<String, Object> factory = new ConcurrentKafkaListenerContainerFactory<>();
        factory.setConsumerFactory(consumerFactory("defaultGroup"));
        factory.setConcurrency(1);
        factory.setAutoStartup(true);
        return factory;
    }
}
@EnableKafka가 있어야 @KafkaListener가 활성화 됩니다.
ConsumerFactory는 consumer를 생성합니다.
ConcurrentKafkaListenerContainerFactory : 동시에 Kafka Cluster로부터 메시지를 읽을 수 있도록 합니다.
consumerFactory를 파라미터로 전달 -> consumer 생성
setConcurrency : 동시에 읽을 consumer 개수 지정
setAutoStartup : true로 설정하면 서버가 부트업될 때 자동 실행됩니다.
Partition Key가 있는 토픽 생성
메시지 키가 있어야 hashing 방식으로 파티션에 메시지를 할당하고,키에 따라 들어온 순서대로 메시지가 적재됩니다.
Key 할당을 위한 생성
# 토픽 키를 이용 설정
kafka.topic-with-key=topic-key
Topic 설정
package com.schooldevops.kafkatutorials.configs;

import org.apache.kafka.clients.admin.NewTopic;
import org.apache.kafka.common.config.TopicConfig;
import org.springframework.beans.factory.annotation.Autowired;
import org.springframework.beans.factory.annotation.Value;
import org.springframework.context.annotation.Configuration;
import org.springframework.kafka.config.TopicBuilder;
import org.springframework.kafka.core.KafkaAdmin;

import javax.annotation.PostConstruct;

@Configuration
public class KafkaTopicConfig {

    public final static String DEFAULT_TOPIC = "DEF_TOPIC";

    @Value("${kafka.topic-with-key}")
    public String TOPIC_WITH_KEY;

    @Autowired
    private KafkaAdmin kafkaAdmin;

    private NewTopic defaultTopic() {
        return TopicBuilder.name(DEFAULT_TOPIC)
                .partitions(2)
                .replicas(2)
                .build();
    }

    private NewTopic topicWithKey() {
        return TopicBuilder.name(TOPIC_WITH_KEY)
                .partitions(2)
                .replicas(2)
                .build();
    }

    @PostConstruct
    public void init() {
        kafkaAdmin.createOrModifyTopics(defaultTopic());
        kafkaAdmin.createOrModifyTopics(topicWithKey());
    }
}createOrModifyTopics: 어플리케이션이 기동될때 토픽이 있다면 수정, 없다면 새로 생성
Listener 생성
... 생략
    @KafkaListener(topics = "${kafka.topic-with-key}", containerFactory = "defaultKafkaListenerContainerFactory")
    public void listenTopicWithKey(Object record) {
        log.info("Receive Message from {}, values {} with key", record);

    }
... 생략
팩토리는 꼭 쓰지 않아도 자동으로 생성됩니다.
메시지를 수신하면 단순하게 로깅하는 코드.
ProducerController
default 토픽과 kafkaProducerTemplate의 send 메서드에 전달하는 값이 달라집니다. key 를 전달해서 키에 의한 파티셔닝이 이뤄지도록 합니다.
ListenableFuture<SendResult<String, Object>> future = kafkaProducerTemplate.send(TOPIC_WITH_KEY, key, testEntity);스터디 회고
대학 입학 후 약 2년을 진로 선택을 고민하며 보냈습니다.
데보션영 2기 활동을 통해 개발자라는 직업에 진지하게 고민해볼 수 있게 되었고,
많은 분들이 데보션 커뮤니티나 블로그, 기술 행사에서 지식을 공유하고 네트워킹 하는 모습들에 반해 올해 초부터 본격적으로 백엔드 공부를 시작했습니다.
혼자서 하면서도 이게 맞는 건지 잘 모르겠는 것들이 많았을 때OpenLab 스터디 참여 기회를 얻게 되었습니다.
스터디를 통해 막막하던 spring 공부에 어느정도 길이 보이기 시작했고, api 작성 경험, 테스트 코드 성공시키기 경험, 새롭게 알게 된 exposed, redis, kafka 등 많이 배우고 성장할 수 있었습니다.
그리고 이 성장엔 아직 부족한 점이 너무 많은 학생과 진행하는 스터디임에도 열심히 알려주시고 도와주신 좋은 스터디장 배기도님과 다른 스터디원분들 덕분이었습니다!
이번에 이렇게 좋은 기회로 배운 것들, 만난 분들 다 잊지 않고 열심히 공부해서 저도 언젠간 저 같은 학생에게 도움이 될 수 있는 멋진 소프트웨어 개발자가 되겠습니다. 😊
kchabin 님의 최신 블로그
더보기-
- OpenLab - Kotlin 6회차, Kafka
- 안녕하세요, kchabin이란 이름으로 활동 중인 강다빈입니다.😎 저번엔 오픈랩 코틀린 스터디 5회차 후기글을 작성했었는데요, 이번엔 마지막 6회차 스터디에서 배운 Kafka 내용 정리와 회고를 해보고자 합니다. Kafka Kafka는 로그 기반의 분산 스트리밍 플랫폼입니다. Kafka와 RabbitMQ의 차이점 둘 다 스트림 처리에 사용할 수 있는 메시지 대기열 시스템입니다. Kafka는 대용량의 실시간 데이터를 처리하고 저장하는데 중점을 두고, RabbitMQ는 메시지를 송신자에서 수신자로 전달하는데 중점을 둡니다. (AWS:Kafka와 RabbitMQ의 차이점은 무엇인가요?) 이미지 출처 : Part 1: RabbitMQ for beginners - Wha...
-
- OpenLab - Kotlin 5회차, Cache 도입하기
- 안녕하세요 전 데보션영 2기로 활동했던 강다빈입니다. 지난 6월 25일 화요일 OpenLab 백엔드 코틀린 스터디에서 공부한 것들과 후기를 공유하고자 합니다. Cache를 사용해봅시다 지난 번 스터디때는 Exposed라는 Kotlin 기반 ORM 프레임워크를 스프링 부트 프로젝트에 적용하는 방법과 테이블에서 PK 만드는 관계 등을 공부했고, Transactional의 여러가지 propagation 방식, 스프링의 Auto Config(참고 추천 -〉 SpringBoot 나만의 의존성 설정하기), Kotlin의 문법과 TDD에 필요한 어노테이션 등을 공부했습니다. 배운 것들을 바탕으로 프로젝트에 UserServiceTest 코드를 잘 돌아가게 만들어보려고 밤새 고군...
-
- [2기 개발 과제] DEVOCEAN 배포 자동화 프로젝트
- 안녕하세요, DEVOCEAN YOUNG 2기 AllinOne의 강다빈입니다. 지난 11월 3일 금요일, T타워 4층 Supex 홀에서 발표했던 개발 프로젝트 최종 결과물을 소개하고자 글을 올리게 되었습니다. AllinOne의 주제는 바로 DEVOCEAN 배포 자동화 프로젝트였는데요, 지금부터 차근차근 저희의 프로젝트를 소개해보도록 하겠습니다. 🤗 전체적인 개발 과정 Tech Day 시작은 4월에 진행된 테크 데이 행사였습니다. 데보션 전문가 안승규님의 Kubernetes 기반 애플리케이션 배포 시스템 구축 방법 관련한 세션을 들으면서 그때 처음 k8s에 대해 알게 되었습니다. 거기에 우리 DEVOCEAN 마스터 김상기 님께서 DEVOCEAN도 컨테이너에 올릴 계...
-
- 데보션 영의 Dokubernetes 첫 번째 오프라인 스터디!
- 안녕하세요, DEVOCEAN YOUNG 2기로 활동 중인 강다빈입니다. DEVOCEAN에서 감사하게도 YOUNG들에게 스터디도 할 수 있도록 지원해주고 계셔서 현재 Docker, Kubernetes를 주제로 Dokubernetes라는 이름의 스터디그룹을 운영하고 있습니다. Docker 스터디! 현재 '시작하세요! 도커/쿠버네티스' 라는 책을 활용해서 스터디를 진행 중인데, 스터디를 직접 만들고 운영해보는 건 이번이 처음이어서, 일단 5월 한 달간 책의 'Docker' 관련 부분을 읽고 각자의 방식으로 공부한 뒤, 마지막 주 금요일에 오프라인으로 만나서 각자 맡은 부분을 리뷰하는 방식으로 진행했습니다. 승연 : 도커 이미지와 컨테이너, 도커 컨테이너 다루기 다빈 :...
DEVOTEE 추천 블로그
-
- [Kafka KRU] 2023 스터디 모임 후기 (feat. 실전 카프카 개발부터 운영까지)
- 안녕하세요 저는 데이터 엔지니어링을 공부하고 있는 취업준비생 추태욱입니다. 😊 Kafka KRU에서 주최했던 2023 kafka 스터디 후기를 간략하게 정리해볼까합니다. 0. 스터디를 접하게된 경로 처음 접하게 된 경로 올해 7월에 데이터 엔지니어 과정을 들은 뒤, kafka에 대해 관심이 생겨 여러 책과 인강으로 홀로 공부하고 있는 중이였습니다. 카프카 관련 서적으로 〈실전 카프카 - 개발부터 운영까지〉라는 책을 접하게 되었습니다. 책에 대한 서칭을 해보다 마침 책의 저자 분(고승범님)께서 KafkaKRU의 스터디를 모집하고 있다는 게시글을 보게 되어 스터디를 신청하게 되었습니다. [Kafka 모임 공지 캡처] 1. Kafka 개요 카프카를 처음 접하시는 분들...
-
- [Kafka KRU] 2023 스터디 후기 및 카프카 성능 관련 이야기
- 안녕하세요! 저는 5년차 백엔드 개발자인 김홍규 입니다. 좋은 기회로 참여했던 KafaKRU - Kafka 한국 사용자 모임에서 주최한 스터디 회고 및 카프카 성능 관련 내용을 공유드려 보겠습니다. 0. Intro - 계기 저는 kafka 라는 기술에 관심은 많았으나 사용할 기회가 없던 찰나에 현재 진행하는 프로젝트 아키텍처 구성에 kafka 도입을 구상하였고 아래 스터디를 발견하였습니다. 사실 저는 2022년도에 지원했지만 탈락의 고배를 마셨습니다.. 😂 그래서 이번에는 취준의 기억을 되살려 상황의 절실함과 배움의 의지를 그득히 담아서 작성하였습니다. 그 결과 아래와 같은 메일을 받게 되어 2023 kafka 스터디를 참여하게 되었습니다!! 1. 스터디 회고 ...
-

- OpenLab - Kotlin 웹 어플리케이션 개발 오프라인 모임(1회차)
- 안녕하세요 :) 데보션 영 3기 Commit조 김경환 입니다. 저번 4월 30일에 첫 오프라인 Kotlin Study 시간을 가졌습니다! 온라인 OT때 스터디원 분들에 대해 소개를 들었지만,, 오프라인으로 뵈니 더 멋있고 굉장하신..! 분들을 뵈어 영광이였습니다. 사실 저는 대학생 신분으로 대기업 현업자 분들을 만날 기회가 많이 없어 많이 떨리기도 했지만, 기대반 설램반으로 참석했습니다 :) SKT T타워 지하에서 진행했는데요! 도착하니 저희 꼬마집사님께서 김밥과 음료를 들고 와주셔서 너무 반갑고 감사했습니다 ㅎㅎ (사실 저녁을 못먹고 가서... 저에게는 너무 한줄기 빛 같았던.. 〉_〈) 스터디 시간에는 실제로 현업에서 어떻게 일하는지, 어떤 프로세스를 가지고,...
-
- OpenLab - Kotlin 5회차, Cache 도입하기
- 안녕하세요 전 데보션영 2기로 활동했던 강다빈입니다. 지난 6월 25일 화요일 OpenLab 백엔드 코틀린 스터디에서 공부한 것들과 후기를 공유하고자 합니다. Cache를 사용해봅시다 지난 번 스터디때는 Exposed라는 Kotlin 기반 ORM 프레임워크를 스프링 부트 프로젝트에 적용하는 방법과 테이블에서 PK 만드는 관계 등을 공부했고, Transactional의 여러가지 propagation 방식, 스프링의 Auto Config(참고 추천 -〉 SpringBoot 나만의 의존성 설정하기), Kotlin의 문법과 TDD에 필요한 어노테이션 등을 공부했습니다. 배운 것들을 바탕으로 프로젝트에 UserServiceTest 코드를 잘 돌아가게 만들어보려고 밤새 고군...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.