
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab - LLMOps, AutoRAG에서 지원하는 다양한 노드&모듈
- DEVOTEE 요약
- OpenLab LLMOps 모임에서 AutoRAG의 다양한 노드와 모듈들을 정리했습니다. 주로 쿼리 확장 및 검색 과정에 관련된 노드와 모듈들이 포함되어 있는데, 여기엔 BM25, Vectordb, 하이브리드 검색 모듈들이 있습니다. 이들은 각각의 특성과 파라미터를 통해 검색 결과의 정확성, 리콜, 정밀도 등을 평가하고 개선하는 데 사용됩니다.
OpenLab LLMOps 모임에서 살펴본 AutoRAG에서 지원하는 다양한 노드와 모듈에 대해 정리했습니다.
Introduce
AutoRAG 에서 지원하는 다양한 모듈에 대해서 살펴봅니다.
Nodes & Modules
1. Query Expansion
사용자 쿼리를 즉시 검색에 사용하지 않고 쿼리에 담긴 표현을 변형하여 검색결과의 관련성을 향상시키는 과정 → 다양한 쿼리 유형에 대응가능 & RAG 정확도 향상
Node Params
N/A
Strategy
query_expansion 노드 결과만으로 노드의 성능을 측정할 수 없음
query_expansion이 적용된 쿼리로 검색 후에 검색 결과로 성능평가
Strategy Params
Metrics
retreival_f1retreival_recallretrieval_precision
Speed Threshold
speed_threshold모든 노드에 적용되어 쿼리의 평균처리 시간을 초과하는 메서드가 사용되지 않도록 한다.
Top_k
검색 평가단계에서 고려할 상위 결과의 수
Retrieval_Modules
bm25vectordbhybrid_rrfhybrid_cc
2. Retrieval(검색)
Definition
쿼리를 사용해서 corpus로부터 관련있는 컨텐츠를 가져오는 과정
Parameters
노드 파라미터
Top_k노드 수준에서 코퍼스에서 검색할 상위 k개
전략(Strategy) 파라미터
Metricsretrieval_f1,retrieval_recall,retrieval_precision검색 과정의 효율성 평가지표
검색된 컨텐츠의 정확성, 리콜 및 정밀도 측정
Speed Threshold쿼리의 평균 처리시간 초과 메서드 사용 X
모든 노드에 적용
- node_line_name: retrieve_node_line
	node:
		- node_type: retrieval
			strategy:
				metrics: [retrieval_f1, retrieval_recall, retrieval_precision]
				speed_threshold: 10
			top_k: 10
			modules:
			- module_type: bm25
			- module_type: vectordb
				embedding_model: openai
			- module_type: hybrid_rrf
				target_module: ('bm25', 'vectordb')
				rrf_k: [3, 5, 10]
			- module_type: hybrid_cc
				target_modules: ('bm25', 'vectordb')
				weights:
				- (0.5, 0.5)
				- (0.3, 0.7)
				- (0.7, 0.3)
BM25
단어가 문서에 얼마나 중요한지를 반영하는 검색의 가장 일반적인 TF-IDF 방법 (a.k.a sparse retrieval, ≠ dense retrieval)
단어의 수를 사용해서 유사도 검색
특정 도메인 문서를 사용하는 경우 vectordb를 사용하는 것보다 유리
passage의 랭킹과 스코어링에 BM25Okapi 알고리즘 사용
Module Parameters
bm25_tokenizerbm25에서 사용할 토큰화 방식 선택 가능porter_stemmer (default)영어에 최적화된 방법
문장 → 단어 → stem 추출
studying, studies → study 가 된다
ko_kiwi한국어에 최적화
‣
space공백을 기준으로 토큰화
Multilingual 문서에 최적화
Huggingface AutoTokenizer허깅페이스의 AutoTokenizer 사용가능
허깅페이스 레포 경로 입력하면 된다.
Example config.yaml
modules:
  - module_type: bm25
    bm25_tokenizer: [ porter_stemmer, ko_kiwi, space, gpt2 ]
Vectordb
벡터DB를 백엔드로 사용하는 검색모듈
Dense Retrieval
임베딩 모델로 임베딩하여 벡터DB에 저장 → 검색시 쿼리가 임베딩 모델로 임베딩 되어 벡터 DB에서 가장 유사한 벡터 검색 후 반환
Backend Support
현재 vectordb 모듈은 ChromaDB만 지원
인터넷 연결, 서버 비용, API 키 필요 X, 오픈소스
Module Parameters
embedding_model지원하는 임베딩 모델 목록: openai 임베딩모델, 일부 로컬모델, 커스텀모델
import autorag
from llama_index.embeddings.huggingface import HuggingFaceEmbedding

autorag.generator_models['kosimcse'] = HuggingFaceEmbedding("BM-K/KoSimCSE-roberta-multitask")
Example config.yaml
modules:
  - module_type: vectordb
    embedding_model: openai
Hybrid-rrf
multiple retrievals에서 passage를 검색
최종 유사도 점수 계산에 RRF(Reciprocal Rank Fusion) 알고리즘 사용
각 검색에서 passage의 랭킹(순위)를 기반으로 검색 점수를 매김
rrf
Reciprocal Rank Fusion
관련성이 다른 여러 결과 집합을 결합하는 방식
각 검색의 점수가 아닌 순위만을 가지고 계산이 이루어지기 때문에 관련성이 다른 여러 결과 집합을 결합하는 것이 가능
$RRF \rm{score}(d\in D) = \sum_{r \in R} \frac{1}{k+r(d)}$
score = 0.0
for q in queries:
    if d in result(q):
  	    score += 1.0 / ( k + rank( result(q), d ) )
return score

# k는 순위에 대한 상수입니다.
# q는 질의(query)의 집합에서 하나의 질의를 의미합니다.
# d는 q의 결과 집합에서의 문서(document)를 나타냅니다.
# result(q)는 질의 q의 결과 집합을 의미합니다.
# rank(result(q), d)는 d가 result(q)에서의 순위를 나타냅니다. 순위는 1부터 시작합니다.
각 쿼리(query)에 대해서 순회하면서 해당 문서(d)가 질의의 결과 집합(result(q))에 존재한다면 점수(score)에 1.0을 해당 문서의 순위의 역수로 더한다.
여기서 순위는 1부터 시작하는데 순위가 낮을수록 높은 점수를 얻게 된다.
Elasticsearch RRF(Reciprocal Rank Fusion)
[IR] RRF(Reciprocal Rank Fusion) 설명과 파이썬 코드
Module Parameters
target_moduleshybrid_rrf 모듈을 적용할 대상 모듈rrf_k각 검색순위가 최종 순위에 미치는 영향력target_module_params
Example config.yaml
modules:
  - module_type: hybrid_rrf
    target_modules: ('bm25', 'vectordb')
    rrf_k: [3, 5, 10]
Hybrid-cc
multiple retrievals에서 passage를 검색
CC(Convex Combination) 알고리즘 사용
각 검색 간에 가중치를 다르게 주어서 점수 계산
CC
Convex Combination
검색 알고리즘이나 다양한 최적화 문제에서 여러 개의 후보 해답이나 데이터 포인트를 결합하여(두 개 이상의 벡터를 결합) 더나은 결과를 도출하는 방법
$y=λ_1x_1+λ_2x_2+⋯+λ_nx_n$
$x_i$ 결합하고자 하는 벡터들
$\lambda_i$ 가중치(가중치의 합은 1이 되어야함)
즉, 원래 벡터들로부터 생성된 선형 결합 중 가장 간단한 형태
Module Parameters
target_modulesweightstarget_module_params
Example config.yaml
modules:
  - module_type: hybrid_cc
    target_modules: ('bm25', 'vectordb')
    weights:
      - (0.5, 0.5)
      - (0.3, 0.7)
      - (0.7, 0.3)
Hybrid-rsf
multiple retrievals에서 passage를 검색
RSF
Relative Score Fusion(RSF)
target_modules 검색으로 출력되는 메트릭을 각각 정규화하여 각 개체 점수를 도출
가장 높은 값은 1, 가장 낮은 값 0
총 점수는 정규화된 target_modules 점수의 스케일링된 합으로 계산
Module Parameters
target_modulesweighttarget_module_params
Example config.yaml
modules:
  - module_type: hybrid_rsf
    target_modules: ('bm25', 'vectordb')
    weights:
      - (0.5, 0.5)
      - (0.3, 0.7)
      - (0.7, 0.3)
Hybrid-dbsf
multiple retrievals에서 passage를 검색
dbsf
Distribution-based Score Fusion
각 임베딩의 분포 꼬리(tails)를 고려하여 서로 다른 인코더의 검색 점수를 커스텀 피처 범위가 있는 MinMax 스케일링을 사용해 정규화
Distribution-Based Score Fusion (DBSF), a new approach to Vector Search Ranking
Module Parameters
target_modulesweighttarget_module_params
Example config.yaml
modules:
  - module_type: hybrid_dbsf
    target_modules: ('bm25', 'vectordb')
    weights:
      - (0.5, 0.5)
      - (0.3, 0.7)
- (0.7, 0.3)sysmoon 님의 최신 블로그
더보기-
- 멀티모달 기반 AI 챗봇 기술 연구&개발 (6회차, Dify & Morphik MCP 연동테스트 방법)
- 소개 DEVOCEAN OpenLab 2025 프로젝트의 일환으로 진행된 '멀티모달 기반 AI 챗봇 기술 연구 및 개발' 중 Dify와 Morphik MCP(Model Context Protocol) 연동 테스트 결과를 자세히 공유합니다 [i]. 이 글은 MCP가 무엇인지부터 실제 연동 과정에서 발생한 기술적 문제, 그리고 성능 분석을 통해 얻은 향후 개선 방향을 소개합니다. 세미나 발표자료 파일 첨부하여 드립니다. (Dify & Morphik MCP 연동테스트 결과) 1. AI와 외부 도구 연결의 핵심: MCP(Model Context Protocol)란? AI 모델이 단순히 질문에 답하는 것을 넘어 외부 서비스나 도구를 활용하려면 표준화된 통신 방식이 필요합니다...
-
- 멀티모달 기반 AI 챗봇 기술 연구&개발 (5회차, Agno로 에이전트 구축하기)
- 안녕하세요! 이번 포스팅에서는 에이전트 오케스트레이션(Agent orchestration)에 특화된 Agent 프레임워크 Agno에 대해 소개합니다. Agent Framework TOP 5 에 속하지는 않지만, Agno 의 발전속도와 미래를 보면 LangGraph 와 같이 사용할 경우 큰 시너지를 낼 수 있다고 생각합니다. 각자의 상황에 맞게 전략적으로 활용해보시면 좋을 것 같습니다. 첨언하면 아시는 분은 아시겠지만 Agno 는 Phidata 프로젝트에서 시작해서 Agno 로 새롭게 브랜딩 된 프로젝트 입니다. Phidata 를 유심히 지켜보신 분들은 아마 Agno 의 멀티에이전트 철학에 대해 이해하고 쉽게 접근하실 수 있을 것입니다. Agno (Agent Fra...
-
- 멀티모달 기반 AI 챗봇 기술 연구&개발 (4회차, VLM(ColPali) & MUVERA 기술 소개)
- 오늘은 Morphik(Multimodal Agent Framework) 에 대해 소개하고, 이 기술의 핵심인 VLM 을 이용하여 문서 청킹/파싱 과정 없이 시각적으로 맥락을 이해하기 위한 ColPali 와 멀티벡터를 빠르게 인덱싱&검색하기 위한 MUVERA 기술에 대해 소개합니다. Morphik의 핵심 기술 심층 분석 (ColPali & MUVERA) Morphik은 복잡한 문서(PDF, 이미지)를 정확하고 빠르게 검색하기 위해 설계된 멀티모달 프레임워크이며, 특히 전통적인 RAG 시스템의 한계였던 시각 정보 처리 및 멀티 벡터 검색 속도 문제를 해결하는 데 중점을 둡니다. 1. ColPali: 시각적 맥락을 이해하는 멀티모달 검색 엔진 ColPali는 ColBE...
-
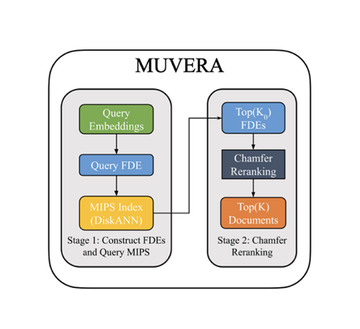
- Morphik - 멀티모달티를 위한 ColPali와 MUVERA 기술에 대하여
- 목차 서론 ColPali MUVERA 1. 서론 지난글애서는 Morphik - 멀티모달티를 위한 RAG에서 문서 파싱 없이 이미지를 사용하는 방법 에 대해서 소개했고, 오늘은 이어서 Morphik 을 이용한 멀티 모달 기반 문서 검색 시스템의 핵심 기술인 ColPali & MUVERA & Late Interaction 개념에 대해 자세히 소개합니다. 우리가 흔히 사용하는 텍스트 추출 기반 RAG는 꽤 똑똑하지만, 현실에서는 몇 가지 아쉬움이 있습니다. PDF를 파싱하거나 OCR, 캡처링을 거치면서 중요한 정보가 사라지거나 오류가 생기기 쉽습니다. 문서를 제대로 다루려면 복잡한 전처리 과정이 필요하고, 시간과 비용이 상당히 소요됩니다. 결국, 단순 텍스트만 활용하는...
DEVOTEE 추천 블로그
-
- OpenLab - LLMOps, AutoRAG에서 쿼리 확장 해보기 (Query Expansion with AutoRAG)
- 안녕하세요, OpenLab LLMOps 프로젝트에 참여중인 김하림입니다 🤗 저는 이번에 AutoRAG에서의 쿼리 확장(Query Expansion) 기법에 대해 소개하고자 합니다. 이 글은 쿼리 확장의 정의와 장점, 그리고 주요 파라미터에 대해 다루고 있습니다. 검색 엔진이나 정보 검색 시스템에서 쿼리 확장은 검색 결과의 관련성을 높이고, 더 나은 데이터를 제공할 수 있습니다. 이 블로그 포스트에서는 쿼리 확장의 기본 개념부터 구체적인 파라미터 설정까지 자세히 설명하고 있으니, AutoRAG를 처음 접하시는 분들도 쉽게 이해할 수 있을 것입니다. 먼저, AutoRAG가 무엇인지 간단하게 소개드리고 바로 Query Expansion에 대해 설명해보겠습니다. Aut...
-
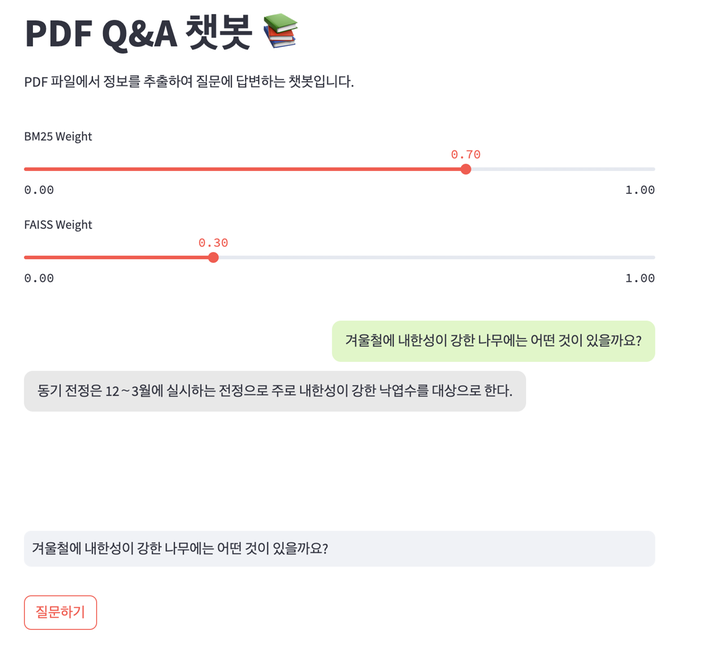
- OpenLab - OpenLLM, Ensemble Retriever(pre), Rerank(post)가 적용된 RAG 챗봇 구현하기
- OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 RAG 챗봇 내용을 함께 공유드립니다. 스터디 모임 경과 - 주제 : OpenLLM 스터디 4차 오프라인 모임 - 일시 : 6/19 20:00 ~ 21:00 - 장소 : 판교사옥 - 참석 : 멤버 7명 중 4명 10명에서 3명 탈퇴(1명:이직, 2명:업무변경) - 스터디 내용 1) RAG 에서 Pre/Post Retriever 코드 구현 공유 및 의견 교환 2) RAG 평가 ragas 공유 3) 다음 스터디까지 제출 코드(파이썬 가상환경 requirements 포함) openllm 별도 로딩 및 서비스 시작 파일 업로드: 질문에 답변할 문서 데이터셋(pdf)을 업로드 Splitter: 업로드된 파일을 분...
-
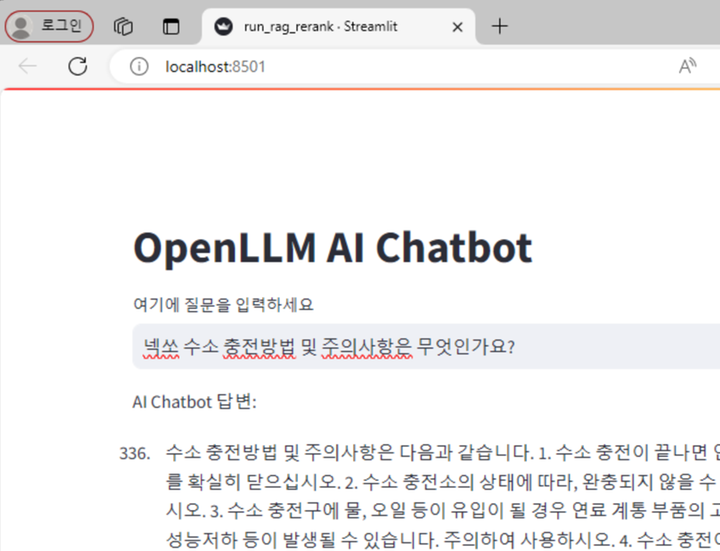
- OpenLab - OpenLLM, Llama-2 7B, FAISS, LangChain 활용한 RAG 구현
- OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 RAG 챗봇 내용을 함께 공유드립니다. 스터디 모임 경과 - 주제 : OpenLLM 스터디 5차 오프라인 모임 - 일시 : 7/3 20:00 ~ 21:00 - 장소 : 판교사옥 - 참석 : 멤버 6명 중 4명 [+] 7명에서 1명 탈퇴(1명:취업) - 스터디 내용 1) RAG 에서 Pre/Post Retriever 코드 구현 공유 및 의견 교환 2) 특이점 토의 ollama 로 모델이 배포되지 않은 경우 vllm 사용 pre/post retriever 부분에서 시간 지연이 큰 경우 정상동작하는 다른 멤버의 코드 참고 langchain 과 LlamaIndex 중 langchain 의 평가가 좋지 않은 것으...
-

- OpenSearch의 하이브리드 검색 소개
- OpenSearch 소개 안녕하세요. Auto서비스개발팀 신철민입니다. 에이닷 오토는 RAG(Retrieval-Augmented Generation) 기반 서비스를 통해 고객에게 더 정확하고 상황 인지형 답변을 제공할 예정입니다. RAG 시스템의 핵심은 사용자 질문의 의도를 정확히 이해하고, 이에 맞는 컨텍스트를 신속하게 검색하는 데 있습니다. 하지만 초기 테스트에서 키워드 검색만으로는 “ELF-7W30” 같은 전문 용어 외에 “겨울용 오일” 같은 일상적 표현을 포착하지 못하는 한계가 있었고, 의미 기반 검색은 “TPMS 경고등” 같은 정형화된 키워드 매칭에서 누락을 일으켰습니다. 자동차 정비라는 도메인의 특수성상, 두 검색 방식을 유기적으로 결합한 전략이 필수적...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.