
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
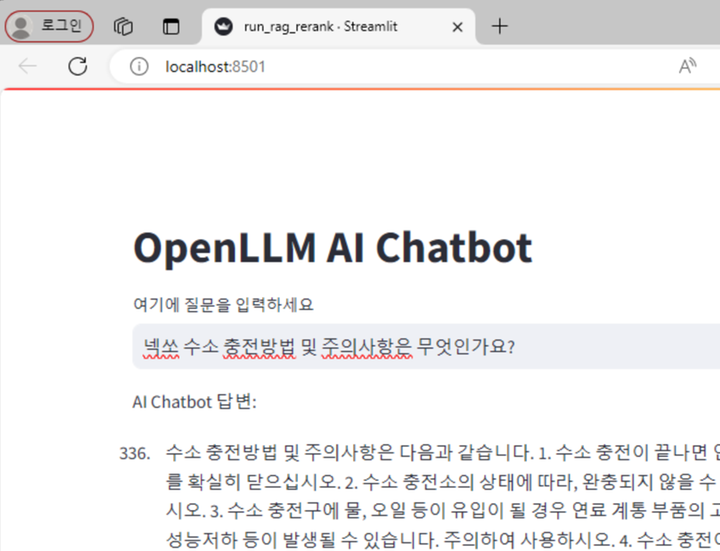
OpenLab - OpenLLM, Advanced RAG를 이용한 chatbot 구현
- DEVOTEE 요약
- OpenLLM 스터디 모임에서는 Advanced RAG 챗봇 개발을 위한 기능 구현을 진행했습니다. 7명 중 6명이 필요한 기능을 현업에서도 활용 가능한 수준으로 완료했습니다. 마지막 모임에서는 multi-query 기능을 적용하여 검색 정확도를 높이는 방법을 구현해 보았습니다.
OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 Advanced RAG 챗봇 내용을 함께 공유드립니다.
스터디 모임 경과
주제 : OpenLLM 6차 오프라인 모임(종료)
일시 : 7/17 20:00 ~ 21:00
장소 : 판교사옥
참석 : 멤버 7명 중 7명
스터디 내용
1) 결론 : 각자 필요한 기능 구현 7명 중 6명 완료(7명 전원 코드 개념 이해)
2) 결론 정리
최초 모델은 EEVE-Korean-Instruct-10.8B-v1.0-GGUF 를 사용
임베딩 모델은 BAAI/bge-m3 사용
PDF 로딩에는 PyPDFLoader() 이 유연하다
post/pre retriever 를 사용하면 성능이 향상된다
3) 현업 활용
방장을 포함한 멤버 7명 중 6명이 현업에서 사용할 수 있는 수준의 코드 구현 또는 설계 완료
OpenLLM 스터디 5차 과제
1. summary.
지금 까지 Advanced RAG의 기법 중 post retrieval에 해당하는 BM25 , reranking을 사용해 봤는데요
이번은 pre retrieval 기법 중 하나인 multi-query 를 적용 해 보았습니다.
2. Multi Query
LLM에 query를 input으로 주어, 주어진 query와 유사한 n 개의 query를 생성.
이 n+1개의 query로 retrieval 하여 정확도를 높이는 방법 입니다.
3. implementation
사용하고 있는 llamaIndex는 multi query가 구현 되어 있지 않음
하기와 같이 multi query class를 구현하여 이를 처리 하였음
특이 사항은 LLM이 주는 답변을 parsing해야 하는 수고를 줄이기 위해
prompt에 json 형식으로 주기를 요청했고 prompt 말미에 하기와 같이 올바른
json 방식을 유도 하였음
[
{{ "문장":
class MultiQueriesRetriever:

	def __init__(self, base_retriever, model, model_name):
		self.base_retriever = base_retriever
		self.model = model
		self.model_name = model_name

	def _get_top_n_unique(self,topks, n):
		sorted_topks = sorted(topks, key=lambda x: x.score, reverse=True)
		unique_nodes = []
		seen_ids = set()
		for node_with_score in sorted_topks:
			if node_with_score.id_ not in seen_ids:
			unique_nodes.append(node_with_score)
			seen_ids.add(node_with_score.id_)
			if len(unique_nodes) == n:
				break
		return unique_nodes

	def _gen_queries(self, question) -> List[str]:

		prompt = f"""주어진 문장에 대해 동일한 내용을 갖는 유사한 한글 문장 5개를 생성합니다. json 형태로 생성해 주세요. json 내용이외의 내용은 생성하지 마세요.
		문장: {question}
		[
			{{ "문장": """

		res = self.model.chat.completions.create(
		model=self.model_name,
		messages=[
			{"role": "system", "content": "당신은 한글 생성 모델입니다. 요청한 내용에 맞게 문장을 생성해 주세요. "},
			{
			"role": "user",
			"content": prompt
			}
		],
		temperature=0.,
		max_tokens=512,
		top_p=1
		)

		questions=[question]
		try:
			responses=json.loads(res.choices[0].message.content)
			for i,element in enumerate(responses):
				questions.append(element['문장'])
		except:
			print(f'{res=} not proper response from llm')
		return questions

		def get_topk(self,question,n):
			questions=self._gen_queries(question)
			topks=[]
			for i,q in enumerate(questions):
				topks+=self.base_retriever.as_retriever(similarity_top_k=n).retrieve(q)
			topks=self._get_top_n_unique(topks,n)

			return topks
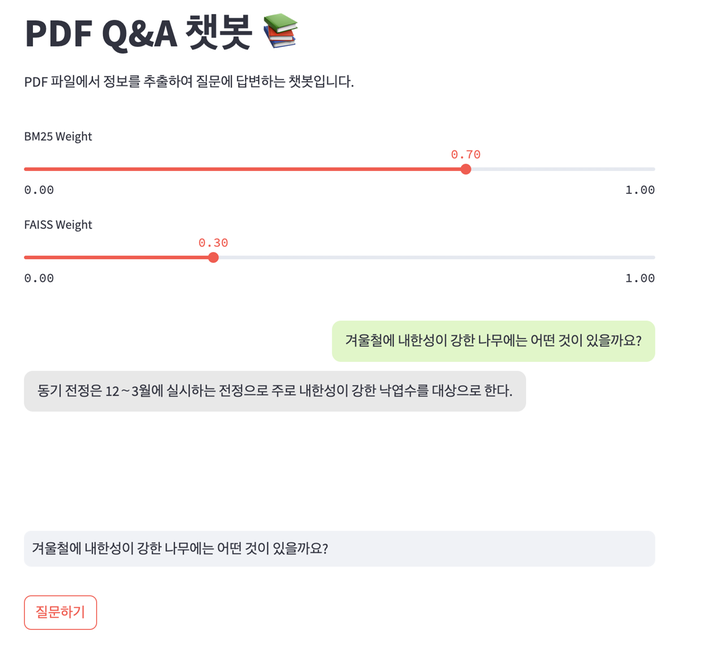
실행
source code
첨부 중 multiquery.py 와 chatbot.py 만 기존 4차 구현 대비 수정 되었습니다.
tica 님의 최신 블로그
더보기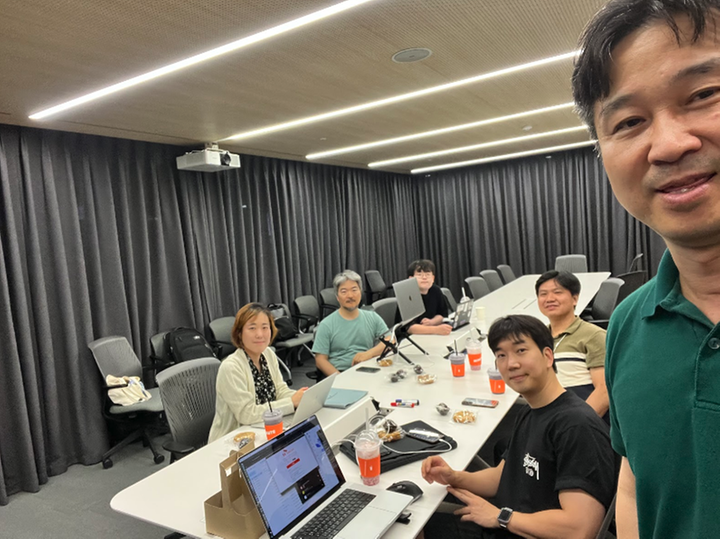
DEVOTEE 추천 블로그
-
- OpenLab - OpenLLM, Llama3-8b | LlamaIndex | qdrant 로 만들어본 RAG 요약 LLM
- 지난 5월22일 오후 8시~9시에 판교사옥에서 2차 오프라인 미팅을 진행하였습니다. 주제 : OpenLLM 스터디 2차 오프라인 모임 일시 : 5/22 20:00 ~ 21:30 장소 : 판교사옥 참석 : 멤버 9명 중 6명 스터디 내용 가. RAG, Langchain 1차 개발 경험 상호 공유 나. 향후 계획 RAG 2차 완성 코드 개발 개발 소스코드를 첨부하고 다른 사람의 코드를 모두 실행해 보면서, RAG와 Langchain의 정확한 이해 다. 스터디 목표 법 요약/문장요약/Q&A 에 대한 RAG 및 Fine-tuning 완료 완성 형태 : 챗봇 또는 Web 등 완성품 형태의 UI 포함 라. 일정 RAG : 6/5 또는 6/19 Fine-Tuning : 6/1...
-
- OpenLab - OpenLLM, Ensemble Retriever(pre), Rerank(post)가 적용된 RAG 챗봇 구현하기
- OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 RAG 챗봇 내용을 함께 공유드립니다. 스터디 모임 경과 - 주제 : OpenLLM 스터디 4차 오프라인 모임 - 일시 : 6/19 20:00 ~ 21:00 - 장소 : 판교사옥 - 참석 : 멤버 7명 중 4명 10명에서 3명 탈퇴(1명:이직, 2명:업무변경) - 스터디 내용 1) RAG 에서 Pre/Post Retriever 코드 구현 공유 및 의견 교환 2) RAG 평가 ragas 공유 3) 다음 스터디까지 제출 코드(파이썬 가상환경 requirements 포함) openllm 별도 로딩 및 서비스 시작 파일 업로드: 질문에 답변할 문서 데이터셋(pdf)을 업로드 Splitter: 업로드된 파일을 분...
-
- OpenLab - OpenLLM, Llama-2 7B, FAISS, LangChain 활용한 RAG 구현
- OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 RAG 챗봇 내용을 함께 공유드립니다. 스터디 모임 경과 - 주제 : OpenLLM 스터디 5차 오프라인 모임 - 일시 : 7/3 20:00 ~ 21:00 - 장소 : 판교사옥 - 참석 : 멤버 6명 중 4명 [+] 7명에서 1명 탈퇴(1명:취업) - 스터디 내용 1) RAG 에서 Pre/Post Retriever 코드 구현 공유 및 의견 교환 2) 특이점 토의 ollama 로 모델이 배포되지 않은 경우 vllm 사용 pre/post retriever 부분에서 시간 지연이 큰 경우 정상동작하는 다른 멤버의 코드 참고 langchain 과 LlamaIndex 중 langchain 의 평가가 좋지 않은 것으...
-
- Advanced RAG Technique 기반 생성형AI 서비스 개발에 대한 연구 (6-7회차: RAG 구축)
- Advanced RAG Technique 모임 기록을 남깁니다. 길었던 명절 연휴도 있었고, 이번 모임은 6-7회차 예정된 Agenda를 Intensive하게 통합 하여 진행 하였습니다. 지난 다섯 번의 모임을 통해서 RAG의 시작부터 Advanced Techniques를 아우르는 총 15편의 논문을 Study하고 리뷰하였는데요. 이번 모임에서는 실제 RAG 구축에 있어 필수적인 Agenda를 중심으로 실증적인 내용들을 살펴보았습니다. 먼저 이종민님이 "Basic RAG using LangChain: Retriever & Reranker" 를 주제로 발표를 해주셨습니다. RAG 구축에 보편적으로 사용하는 Lang Chain을 활용하면 손쉽게 RAG Techniqu...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.