
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab - 대규모 시스템 설계 기초 #5
- DEVOTEE 요약
- 이번 대규모 시스템 설계 스터디의 9장 "크롤러 설계"와 10장 "알림 시스템 설계"에 대해 다루었습니다. 크롤러 설계에서는 단순한 데이터 수집이 아닌 확장 가능하고 지속 가능한 운영을 위한 크롤러 아키텍처, 크롤링의 예절, 안정성 및 효율성을 위한 전략 등을 학습하였고, 알림 시스템 설계에서는 iOS와 안드로이드 푸시 알림, SMS, 이메일 등의 알림 서비스를 통합하고 안정성을 보장하는 방법을 다루었습니다.
안녕하세요!
<대규모 시스템 설계 기초> 스터디 다섯번째 글입니다.
지난글
3회차 : OpenLab - 대규모 시스템 설계 기초 #3-1, #3-2
스터디 목차
1회차
1장 사용자 수에 따른 규모 확장성
2장 개략적인 규모 추정
2회차
4장 처리율 제한 장치의 설계
3회차
5장 안정 해시 설계
6장 키-값 저장소 설계
4회차
7장 분산 시스템을 위한 유일 ID 생성기 설계
8장 URL 단축기 설계
5회차
9장 크롤러 설계
10장 알림 시스템 설계
스터디 개요
이번 회차에서는 9장 “크롤러 설계”와 10장 “알림 시스템 설계”를 스터디했습니다.
스터디는 한 멤버가 내용을 리뷰하고, 중간에 궁금한 점이나 실무 사례를 공유하는 방식으로 진행되었습니다.
9장 “크롤러 설계”에서는 단순한 데이터 수집이 아닌, 확장 가능하고 지속적으로 운영할 수 있는 크롤러 아키텍처에 대해 다루었습니다.
많은 사람들이 파이썬 등의 언어로 간단한 크롤러를 구현해 데이터를 수집해본 경험이 있을 것입니다.
특히, 데이터 분석이나 딥러닝 모델 생성을 위해 필요한 데이터를 직접 크롤링하는 경우가 종종 있습니다.
그러나 이런 임시 크롤러는 웹사이트가 조금만 변경되어도 작동하지 않는 문제가 발생할 수 있습니다.
9장에서는 이러한 단점을 극복하고, 지속 가능한 서비스/시스템 운영을 위해 설계된 크롤러에 대해 학습했습니다.
또한, 크롤링이 생각보다 오래된 기술로, 관련 논문도 오래전부터 있었다는 점을 알게 되었습니다.
10장 “알림 시스템”에서는 iOS와 Android에서의 푸시 알림, SMS, 이메일 등을 포함한 알림 시스템 설계에 대해 다루었습니다.
iOS에서는 APNS(Apple Push Notification Service)를, Android에서는 FCM(Firebase Cloud Messaging)을 사용하여 알림을 발송할 수 있습니다.
SMS와 이메일은 3자 서비스를 사용하거나, 규모가 크지 않을 경우 자체 서비스를 개발하여 구축할 수 있습니다.
책에서는 또한 알림 서버가 단일 장애 지점(SPOF)이 되지 않도록 구조를 개선하는 방법도 다루었습니다.
Chapter 9 - 웹 크롤러 설계
Robot또는 Spider라고도 부름
검색엔진에서 널리 쓰이며 웹의 새로 갱신된 콘텐츠를 찾아내는 것이 주 목적
콘텐츠는 웹페이지, 이미지, 비디오 또는 PDF 등
크롤러 사용 유형
검색 엔진 인덱싱(Search Engine Indexing)
웹페이지를 모아 검색 엔진을 위한 로컬 인덱스 생성
Googlebot은 구글 검색 엔진이 사용하는 웹 크롤러
웹 아카이빙(Web Archiving)
웹페이지를 장기보관 하기 위해 정보를 모으는 절차
많은 국립 도서관이 크롤러를 돌려 웹 사이틀 아카이빙 중
웹 마이닝(Web Mining)
인터넷에서 유용한 지식을 도출해내는 작업
유명 금융 기업들은 크롤러를 사용해 주주총회 자료나 연차 보고서를 다운받아 핵심 사업 방향 도출
웹 모니터링(Web Monitoring)
저작권이나 상표권 침해 사례 모니터링
디지마크(Digimarc)사는 웹 크롤러로 해적판 저작물을 찾아내서 보고
문제 이해 및 설계 범위 확정
웹 크롤러 기본 알고리즘
URL 집합이 입력으로 주어지면, 해당 URL들이 가리키는 모든 웹 페이지 다운로드
다운 받은 웹 페이지에서 URL 추출
추출된 URL들을 다운로드할 URL 목록에 추가하고 위 과정을 처음부터 반복
크롤러 요구사항
규모 확장성
수십억개의 페이지를 크롤링하기 위해 병행성을 활용하면 효과적으로 크롤링 가능
안정성
반응 없는 서버, 장애, 악성 코드들을 잘 대응할 수 있어야함
예절(politeness)
대상 웹 사이트에 짧은 시간 동안 너무 많은 요청을 하면 안 됨
확장성
새로운 형태의 콘텐츠를 지원하기 쉬워야함
개략적 규모 추정
매달 10억 개의 웹페이지 다운로드
QPS=10억/30일/24시간/3600초 = 대략 400페이지/초
최대(Peak) QPS = 2 X QPS = 800
웹페이지 크기 평균은 500k라고 가정
10억 페이지 x 500k = 500TB/월
5년간 보관한다고 가정하면 500TB x 12개월 x 5년 = 30PB
개략적 설계안 제시 및 동의 구하기
시작 URL 집합
웹 크롤러가 크롤링을 시작하는 출발점
미수집 URL 저장소
다운로드할 URL을 저장 관리하는 컴포넌트
FIFO Queue 구조
HTML 다운로더
웹페이지를 다운로드하는 컴포넌트
다운로드할 페이지는 미수집 URL 저장소가 제공
도메인 이름 변환기
URL을 IP 주소로 변환
콘텐츠 파서
파싱과 검증 절차 진행
이상한 웹페이지를 걸러냄
중복 콘텐츠인가?
웹상의 29% 가량의 콘텐츠는 중복된 자료들
중복을 가려내기 위해 웹피이지의 해시 값을 비교하는 방법 사용 가능
콘텐츠 저장소
HTML 문서를 보관하는 시스템
본 설계안에서는 디스크와 메모리를 동시 사용
데이터 양이 너무 많아 대부분의 콘텐츠는 디스크 저장
인기 있는 콘텐츠는 메모리 저장
URL 추출기
HTML 페이지를 파싱하여 링크들을 골라냄
상대 경로는 전부 절대 경로로 변환
URL 필터
다음과 같은 URL들을 크롤링 대상에서 제외
특정한 콘텐츠 타입이나 파일 확장자를 갖는 URL
접속시 오류가 발생하는 URL
접근 제외 목록에 포함된 URL
이미 방문한 URL?
이미 방문한 적 있는 URL을 추적하여 여러번 처리하거나 무한루프에 빠지는 것을 방지
블룸 필터나 해시 테이블을 자료구조로 사용 가능
URL 저장소
이미 방문한 URL을 보관하는 저장소
상세 설계
DFS를 쓸 것인가, BFS를 쓸 것인가
웹은 유향(directed graph) 그래프
페이지는 노드, 하이퍼링크는 에지(edge)
크롤링은 유향 그래프를 에지를 따라 탐색하는 과정
DFS, BFS는 그래프 탐색에 널리 사용되는 알고리즘
DFS(depth-first search)는 그래프 크기가 클 경우 어느 정도로 깊이 가게 될지 가늠하기 어려움
웹 크롤러는 보통 BFS(breadth-first search)를 사용
BFS를 사용하는 경우 다음과 같은 문제 발생
링크들을 병렬로 처리하는 경우 같은 서버에 수많은 요청을 하여 과부하게 걸리게됨
BFS는 URL간 우선순위가 없음
미수집 URL 저장소
미수집 URL 저장소를 활용하여 위 문제 개선 가능
URL 사이의 우선순위와 freshness를 구별하는 크롤러 구성 가능
예의
웹 크롤러는 수집 대상 서버에 짧은 시간 안에 너무 많은 요청을 보내는 것을 감가해야함
DoS 공격으로 간주될 수 있음
한 번에 한 페이지만 요청하는 구조가 되어야함
웹 사이트의 호스트명과 다운로드를 수행하는 작업 스레드 사이의 관계를 유지해 구현
큐 라우터(queue router)
같은 호스트에 속한 URL은 언제나 같은 큐(b1, b2, ...bn)로 가도록 보장
매핑 테이블(mapping table)
호스트 이름과 큐 사이의 관계를 보관하는 테이블
FIFO Queue
같은 호스트에 속한 URL은 언제나 같은 큐에 보관
큐 선택기(queue selector)
큐들을 순회하면서 큐에서 URL을 꺼내 작업 스레드에 전달
작업 스레드(worker thread)
전달된 URL을 다운로드하는 작업 수행
우선순위
유용성에 따라 URL의 우선순위를 나눌 때는 페이지랭크, 트래픽 양, 갱신 빈도 등 다양한 척도 사용
전면 큐 : 우선순위 결정 과정 처리
후면 큐 : 크롤러가 예의 바르게 동작하도록 보증
신선도(freshness)
웹페이지는 수시로 추가, 삭제, 변경 됨
freshness를 유지하기 위해 이미 다운로드한 페이지라도 주기적으로 재수집(recrawl) 해야함
모든 URL을 재수집하는 것은 많은 리소스 필요
최적화 방안
웹 페이지의 변경 이력 활용
우선순위를 활용하여 중요한 페이지는 좀 더 자주 재수집
HTML 다운로더
Robots.txt
이 파일에는 크롤러가 수집해도 되는 페이지 목록들 존재
성능 최적화
분산 크롤링
각 서버가 여러 스레드를 돌려 다운로드 작업 처리
도메인 이름 변환 결과 캐시
DNS 요청 처리에 보통 10ms ~ 200ms 소요
도메인 이름과 IP 주소 관계를 캐시 보관
크론잡 등으로 주기적으로 갱신
지역성
크롤링 서버가 크롤링 대상 서버와 지역적으로 가까우면 다운로드 시간이 개선됨
지역성 활용 전략은 크롤 서버, 캐시, 큐, 저장소 등 대부분의 컴포넌트에 적용 가능
짧은 타임아웃
응답이 느리거나 응답이 없는 서버를 걸러냄
안정성
안정해시 : 부하 분산에 사용
크롤링 상태 및 수집 데이터 저장 : 장애가 발생해도 쉽게 복구할 수 있도록 기록
예외처리 : 전체 시스템이 중단되지 않도록 고려
데이터 검증 : 시스템 오류 방지를 위해 검증 작업 수행
문제 있는 콘텐츠 감지 및 회피
중복 콘텐츠
해시나 체크섬 등을 사용하여 중복 콘텐츠 탐지
거미 덫(spider trap)
크롤러를 무한 루프에 빠지도록 설계된 웸 피이지
URL 최대 길이를 제한하여 회피 가능
데이터 노이즈
광고나 스크립트 코드, 스펨 URL 같은 것은 불필요하여 제외 해야함
참고
크롤링
https://velog.io/@mowinckel/%EC%9B%B9-%ED%81%AC%EB%A1%A4%EB%A7%81-I
https://courses.cs.washington.edu/courses/cse454/15au/papers/mercator.pdf
Chapter 10 - 알림 시스템 설계
최신 뉴스, 제품 업데이트, 이벤트, 선물 등 고객에게 중요할 만한 정보를 비동기적으로 제공
알림 시스템은 모바일 푸시 알림 외에도 SMS 메시지, 이메일 등도 있음
알림 유형별 지원 방안
iOS 푸시 알림
알림 제공자(provider)
알림 요청을 만들어 애플 푸시 알림 서비스(APNS: apple push notification service)로 보내는 주체
단말 토큰(device token) : 알림 요청을 보내는데 필요한 고유 식별자
페이로드(payload) : 알림 내용을 담은 JSON 딕셔너리
APNS : 애플이 제공하는 원격 서비스. 푸시 알림을 iOS 장치로 보내는 역할
iOS 단말 : 푸시 알림을 수신하는 사용자 단말
안드로이드 푸시 알림
안드로이드도 iOS와 유사한 구조로 동작. APNS대신 FCM(Firebase Cloud Messaging) 사용
SMS 메시지
트윌리오(Twilio), 넥스모(Nexmo) 같은 제3자 사업자의 서비스를 이용
이메일
샌드그리드(Sendgrid), 메일침프(Mailchimp) 와 같은 상용 서비스들이 있음
연락처 정보 수집 절차
알림을 보내려면 모바일 단말 토큰, 전화번호, 이메일 주소 등의 정보 필요
앱을 설치 하거나 처음으로 계정을 등록하면 API 서버는 해당 사용자 정보를 DB에 저장
알림 전송 및 수신 절차
설계안
1부터 N까지의 서비스
이 서비스 각각은 마이크로서비스, 크론잡, 분산 시스템 컴포넌트 등일 수 있음
사용자 납기일을 알리고자하는 과금 서비스, 배송 알림을 보내려는 쇼핑몰 웹사이트 등
알림 시스템
알림 시스템은 알림 전송/수신 처리의 핵심
알림 전송을 위한 API를 제공해야함
제3자 서비스에 전달할 알림을 만들어 낼 수 있어야 함
제3자 서비스
사용자에게 알림을 실제 전달하는 역할
제3자 서비스와 통합 시 유의할 것은 확장성
쉽게 새로운 서비스를 통합하거나 기존 서비스를 제거할 수 있어야 함
iOS, 안드로이드, SMS, 이메일 단말
사용자는 자기 단말에서 알림 수신
위 구조만으로는 다음과 같은 문제 존재
SPOF : 알림 서비스가 하나 밖에 없어 서버에 장애가 생기면 전체 장애가 됨
규모 확장성 : DB나 캐시 등 중요 컴포넌트의 규모를 개별적으로 늘릴 방법이 없음
개선된 설계안
DB와 캐시 알림 시스템이 주 서버에서 분리됨
알림 서버를 증설 하고 자동으로 수평적 규모 확장이 이루어짐
메시지 큐를 이용해 시스템 컴포넌트 사이의 강한 결합을 끊는다
알림 서버
알림 전송 API : 스팸 방지를 위해 보통 사내 서비스 또는 인증된 클라이언트만 이용 가능
알림 검증 : 이메일 주소, 전화 번호 등에 대한 기본적 검증 수행
데이터베이스 또는 캐시 질의 : 알림에 포함시킬 데이터를 가져오는 기능
알림 전송 : 알림 데이터를 메시지 큐에 넣는다
캐시
사용자 정보, 단말 정보, 알림 켐플릿 등을 캐시
데이터베이스
사용자, 알림, 설정 등 다양한 정보 저장
메시지 큐
시스템 컴포넌트 간 의존성 제거
다량의 알림 전송 시 버퍼 역할
작업 서버
메시지 큐에서 전송할 알림을 꺼내 제3자 서비스로 전달
제3자 서비스
iOS, 안드로이드, SMS, 이메일 단말
상세 설계
안정성
데이터 손실 방지
알림이 소실 되면 안된다
알림이 지연되거나 순서가 틀려도 괜찮지만 사라지면 문제
-> 알림 시스템은 알림 데이터를 DB에 보관하고 재시도 매커니즘을 구현해야함
-> 알림 로그 DB를 유지하는 것이 한 가지 방법
알림 중복 전송 방지
이벤트 ID를 검사하여 이전에 본적이 있는 이벤트인지 확인
알림 템플릿
알림 템플릿은 인자(parameter)나 스타일, 추적 링크를 조정하기만 하면 사전에 지정한 형식에 맞춰 알림을 만들어 내는 틀
알림 설정
사용자가 알림 설정을 상세히 조정할 수 있도록 제공
전송률 제한
너무 많은 알림이 보내지지 않도록 함
한 사용자가 받을 수 있는 알림의 빈도 제한
재시도 방법
알림 전송에 실패하면 해당 알림을 재시도 전용 큐에 넣는다
문제 지속 발생 시 개발자에게 통지
푸시 알림과 보안
인증되거나 승인된 클라이언트만 알림 전송 가능
큐 모니터링
큐에 쌓인 알림이 제대로 해소 되고 있는지 모니터링 필요
적절한 속도로 해소 되지 않는 경우 작업 스레드를 증설할 필요가 있음
이벤트 추적
알림 확인률, 클릭율, 실제 앱 사용으로 이어지는 메트릭은 사용자를 이해하는데 중요한 요소
수정된 설계안
참고
victor 님의 최신 블로그
더보기-

- 패키지 설치 없이 Python 스크립트를 즉시 실행하는 방법
- 많은 Python 개발자들이 간단한 자동화 스크립트를 작성할 때 “이 정도는 Bash나 Shell로 처리해야 하나?” 하는 고민을 한 번쯤 해봤을 겁니다. 특히 간단한 작업을 위해 프로젝트 디렉토리를 만들고, pyproject.toml을 준비하고, 가상환경을 구성하는 과정은 꽤나 번거롭게 느껴지는데요. 최근 이런 문제를 해결할 수 있는 표준과 도구들이 있어 소개해봅니다. 바로 PEP 723 (Inline Script Metadata)과 패키지 매니저 uv, 그리고 CLI 앱 생성을 도와주는 Typer를 활용한 방법입니다. PEP 723 – 스크립트에 메타데이터 넣기 기존에는 Python 스크립트가 어떤 패키지에 의존하는지 명시할 방법이 없었습니다. PEP 723은...
-

- USB-C처럼 연결되는 AI 인터페이스, MCP Server를 만들어보자
- MCP(Model Context Protocol)는 현재 기준으로 사실상 AI 모델 연동의 표준처럼 사용되고 있는 것 같습니다. 2024년 11월, Anthropic이 처음 공개한 이후 빠르게 주목을 받으며 성장세를 이어가고 있는데요. 아직 발전 중인 단계이지만, JSON-RPC 기반의 심플한 구조와 다양한 SDK, 프레임워크 제공 덕분에 개발자들에게 큰 관심을 받고 있습니다. MCP는 공식 소개 문서에서도 언급되듯이, ‘AI의 USB-C’로 비유되곤 합니다. 하나의 단일 인터페이스로 다양한 기기와 연결할 수 있는 USB-C처럼, MCP 역시 LLM이 다양한 외부 시스템(도구, 데이터 소스 등)과 일관된 방식으로 통신할 수 있게 해줍니다. 조금 다른 이야기이지만,...
-

- Python Poetry 대신 UV를 써보면서 느낀 점들
- UV는 정말 빠를까? 그리고 얼마나 실용적일까? 기존 프로젝트에서는 poetry를 패키지 매니저로 도입해 사용하고 있었지만, uv가 “빠르다”는 이야기를 듣고 테스트해보지 않을 이유가 없었습니다. 실제로 성능 차이를 체감할 수 있을지 궁금했기 때문입니다. FastAPI는 정말 Flask보다 빠를까? 잠깐 주제를 벗어나지만, 속도에 대한 이야기를 하다 보면 예전에 경험했던 FastAPI 도입 사례를 빼놓을 수 없습니다. 과거 저희 팀은 백엔드에 큰 트래픽이 없는 구조였기 때문에 초기에는 Flask로 REST API 서버를 구성했습니다. 그러다 FastAPI가 “속도가 빠르다”는 장점으로 각광받기 시작하면서 관심을 가지게 되었고, 실제로 FastAPI로의 전환을 시도...
-
- 2024년 OpenLab 상반기 스터디 운영 후기
- 3개월 동안 진행된 ‘대규모 시스템 설계 기초’ 스터디가 7월 15일을 마지막으로 종료되었습니다. 첫 킥오프 미팅은 4월 22일에 열렸고, 총 6회의 모임을 가졌습니다. 이번 스터디는 ‘가상 면접 사례로 배우는 대규모 시스템 설계 기초’ 책을 교재로 사용하여, 대규모 시스템을 이해하고 실무에 활용할 수 있는 능력을 기르는 것을 목표로 했습니다. 대규모 인프라와 백엔드를 모두 다뤄보는 스터디로 저의 경우 시스템 운영 경험이 많지 않다보니 학습이 쉽지 않았지만, 여러 개발자들이 모여 실무 사례와 경험을 공유하고 토론하는 기회를 가졌습니다. 이를 통해 대규모 서비스 운영에 대한 이해를 넓힐 수 있었습니다. 스터디를 마치며 운영자로서도 느낀 점이 있었는데요. 저는 이번에...
DEVOTEE 추천 블로그
-
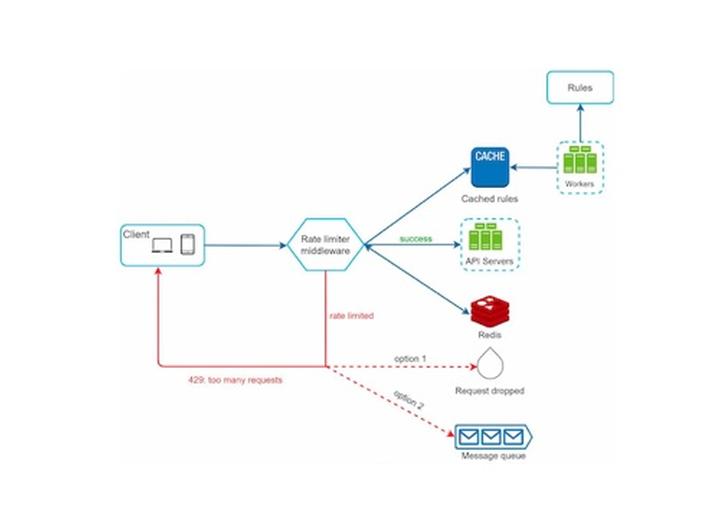
- OpenLab - 대규모 시스템 설계 기초 #2
- 안녕하세요! 〈대규모 시스템 설계 기초〉 스터디 두번째 글입니다. 1회차 : OpenLab - 대규모 시스템 설계 기초 #1 이번 스터디 주제는 3장 "시스템 설계 면접 공략법"과 4장 "처리율 제한 장치의 설계"에 관한 내용이었습니다. 저희는 실무 중심 스터디로 면접 준비를 위한 스터디는 아니기 때문에 3장은 가볍게 훑어보며 요약하고 넘어갔고 4장을 중점적으로 진행했습니다. 지난번과 달리 이번 스터디는 토론 방식으로 스터디를 진행했습니다. 1회 차 때는 모든 멤버가 동일한 스터디를 하고 랜덤으로 2명을 선정하여 발표하는 방식으로 스터디를 진행했습니다. 아무래도 다 같이 봤던 내용을 발표로 다시 보다 보니 '다 아는 내용이구만.' 하는 자세로 발표 내용을 듣게 되...
-
- OpenLab - 대규모 시스템 설계 기초 #6
- 〈대규모 시스템 설계 기초〉 스터디 여섯번째 글입니다! 저희 모임은 대략 3개월 간 진행되었고 이번 여섯번째 모임을 마지막으로 스터디가 종료되었습니다. 지난글 1회차 : OpenLab - 대규모 시스템 설계 기초 #1 2회차 : OpenLab - 대규모 시스템 설계 기초 #2 3회차 : OpenLab - 대규모 시스템 설계 기초 #3-1, #3-2 4회차 : OpenLab - 대규모 시스템 설계 기초 #4 5회차 : OpenLab - 대규모 시스템 설계 기초 #5 스터디 목차 1회차 1장 사용자 수에 따른 규모 확장성 2장 개략적인 규모 추정 2회차 4장 처리율 제한 장치의 설계 3회차 5장 안정 해시 설계 6장 키-값 저장소 설계 4회차 7장 분산 시스템을 위한...
-

- AI 서비스 개발을 위한 대규모 시스템 설계 스터디 (5회차 모임)
- 안녕하세요, AI 서비스 개발을 위한 대규모 시스템 설계 스터디 호스트 송의석입니다. 9월 23일에는 저희 스터디의 다섯 번째 모임을 진행하였습니다. 모임 이전에 각자 『데이터 중심 애플리케이션 설계』 도서의 챕터 7, 8을 읽어오고, 모임에서는 박영훈님과 오종해님이 한 챕터씩 맡아 발표를 진행해주셨습니다. 7장 트랜잭션 7장은 영훈님이 발표를 맡아주셨습니다. 트랜잭션은 데이터베이스에서 여러 연산을 하나의 논리적인 단위로 묶어서, 원자성·일관성·격리성·지속성, 흔히 말하는 ACID 특성을 만족하도록 보장하는 개념이라고 하셨습니다. 책에서는 실제 시스템에서 사용하는 다양한 고립 수준과 동시성 제어 기법들을 자세히 다뤘습니다. 직렬성 수준이 가장 강력하지만 성능 손해...
-

- AI 서비스 개발을 위한 대규모 시스템 설계 스터디 (6회차 모임)
- 안녕하세요, AI 서비스 개발을 위한 대규모 시스템 설계 스터디 호스트 송의석입니다. 11월 3일에는 오랜만에 저희 스터디의 여섯 번째 모임을 진행하였습니다. 추석 연휴도 있고, 회사에 이슈도 있어서 의도치 않게 한 달이 넘는 기간동안 스터디를 쉬게 되었네요. 모임 이전에 각자 『데이터 중심 애플리케이션 설계』 도서의 챕터 9, 10을 읽어오고, 모임에서는 저와 신일용님이 한 챕터씩 맡아 발표를 진행해주셨습니다. 9장 일관성과 합의 9장은 일용님이 발표를 맡아주셨습니다. 9장의 내용은 전반적으로 분산 시스템 환경에서 모든 사용자가 똑같은 데이터를 볼 수 있게 만드는 방법에 대해 다루었습니다. 책에서는 이를 "합의"라고 표현했는데요, 분산 시스템은 여러 대의 서버에...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.