
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab - OpenLLM, Llama-2 7B, FAISS, LangChain 활용한 RAG 구현
- DEVOTEE 요약
- OpenLLM 스터디 5차 오프라인 모임에서는 RAG 챗봇의 Pre/Post Retriever 코드 구현과 이상 시간 지연 문제를 논의했습니다. 이후 RAG 챗봇의 주요 컴포넌트를 설명하며, 특히 Remote LLM 서버 설정 및 코드 예제를 공유했습니다. 성능 테스트에서 현재 설정한 LLM이 제대로 동작함을 확인했으며, 앞으로 개선할 사항으로 Multi-query retriever 및 GPU 환경에서의 성능 테스트, 그리고 Ragas 프레임워크 통합을 계획하고 있습니다.
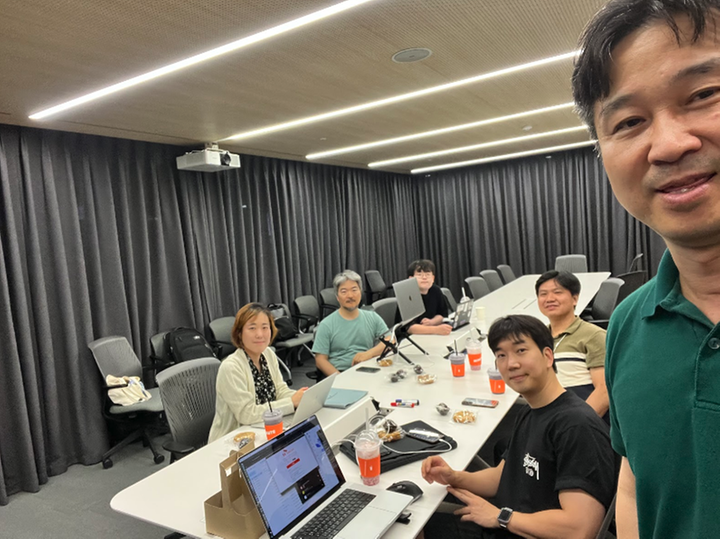
OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 RAG 챗봇 내용을 함께 공유드립니다.
스터디 모임 경과
- 주제 : OpenLLM 스터디 5차 오프라인 모임
- 일시 : 7/3 20:00 ~ 21:00
- 장소 : 판교사옥
- 참석 : 멤버 6명 중 4명
[+] 7명에서 1명 탈퇴(1명:취업)
- 스터디 내용
1) RAG 에서 Pre/Post Retriever 코드 구현 공유 및 의견 교환
2) 특이점 토의
ollama 로 모델이 배포되지 않은 경우 vllm 사용
pre/post retriever 부분에서 시간 지연이 큰 경우 정상동작하는 다른 멤버의 코드 참고
langchain 과 LlamaIndex 중 langchain 의 평가가 좋지 않은 것으로 보이지만 개념 이해를 위해 langchain 사용 가능
3) 6차 스터디 종료 준비
개인별로 업무에서 적용할 RAG 챗봇 개념 공유
완성된 챗봇 초안 코드 공유
코드에 대한 의견 공유
OpenLLM 스터디 4차 과제
OpenLLM 스터디 4차 과제를 수행하였습니다. 구현에 적용한 RAG 컴포넌트 들은 다음과 같습니다.
LLM - llama-2-7b-chat.Q4_K_M.gguf
Embedding model - BAAI/bge-m3
Rerank model - Dongjin-kr/ko-reranker
Vector search library - FAISS
Orchestration tool - LangChain
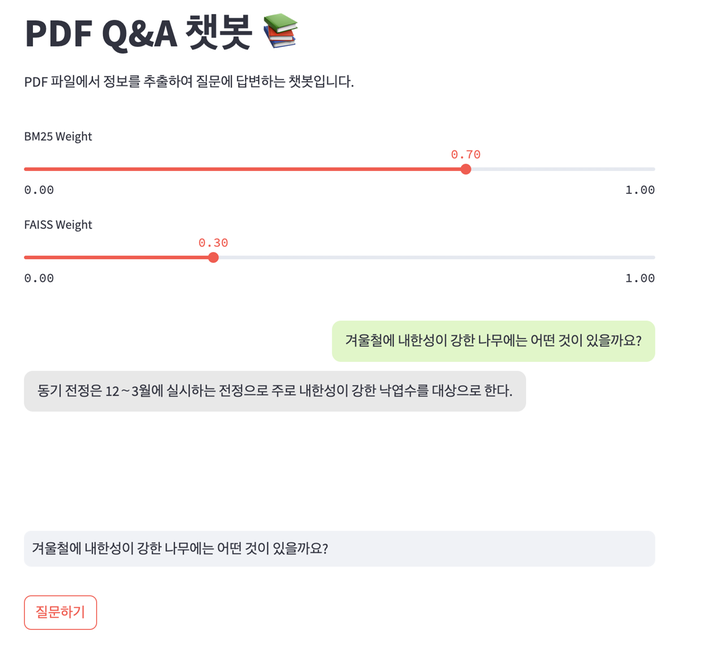
Chat UI - Streamlit
Embedding 자료 - Nexo_quickguide.pdf (현대자동차 웹 사이트에서 다운로드 받음)
OS - Windows 11
LLM Inference - CPU
LLM Server - LangServe, FastAPI, Uvicorn 활용해 분리
python - 3.8.19 (conda 환경)
python package - requirements.txt 첨부함
Streamlit Client - run_rag_rerank.py
기존 코드 동일하며, 아래 사항을 추가하였습니다.
from langserve import RemoteRunnable

# Request query to Remote LLM using FastAPI
def generate_response_remote(query):
    # single-query retriever 셋팅
    retriever = load_embedding_singlequery()

    #Set-up remote LLM
    llm = RemoteRunnable(url="http://localhost:8000/llm")
    template = """Use the following pieces of information to answer the user's question.
    If you don't know the answer, just say that you don't know, don't try to make up an answer.
    Context: {context}
    Question: {question}
    Only return the Korean answer below and nothing else.
    Korean answer:    """
    prompt = PromptTemplate(
        template=template,
        input_variables=['context', 'question'])

    qa_chain = (
        {
            'context': retriever,
            'question': RunnablePassthrough()
        }
        | prompt
        | llm
    )

    query = query
    print('input query: ' + query)
    #generate answer
    output = qa_chain.invoke(query)
    print(output)
    return output

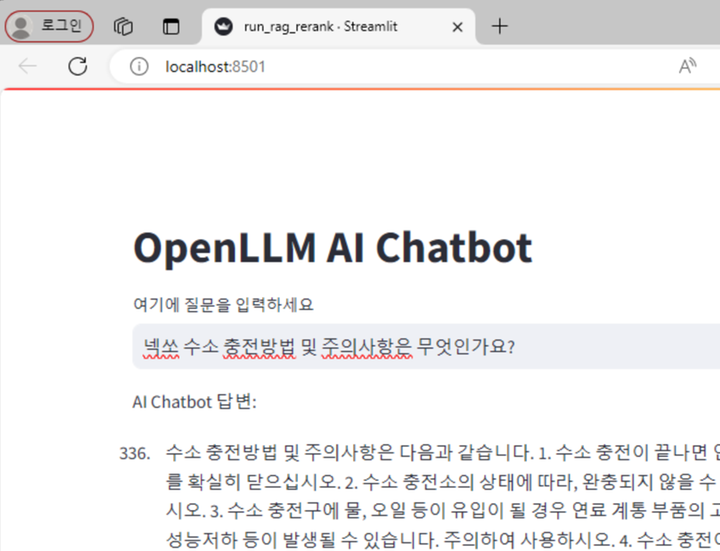
st.title("OpenLLM AI Chatbot")
user_input = st.text_input("여기에 질문을 입력하세요")
if user_input:
    #response = generate_response(user_input)
    #response = generate_response_rerank(user_input)
    #response = generate_response_multiquery(user_input)
    response = generate_response_remote(user_input)

    st.write("AI Chatbot 답변: ")
    st.write(response)
Remote LLM server - server.py
여동기 님의 기 구현하신 코드를 많이 참조하였습니다.
from fastapi import FastAPI
from fastapi.responses import RedirectResponse
from langserve import add_routes
from fastapi.middleware.cors import CORSMiddleware
from typing import List, Union
from langserve.pydantic_v1 import BaseModel, Field
from langchain_core.messages import HumanMessage, AIMessage, SystemMessage
# user-defined llm.py
from llm import llm as chain

# Set FastAPI
app = FastAPI()

# Set Cross-Origin Resource Sharing(CORS) config for FastAPI
app.add_middleware(
    CORSMiddleware,
    allow_origins=["*"],
    allow_credentials=True,
    allow_methods=["*"],
    allow_headers=["*"],
    expose_headers = ["*"],
)

# Re-direct to llm server when get event is triggered via chrome browser
@app.get("/")
async def redirect_root_to_llmserver():
    return RedirectResponse("/llm/playground")

# Set routes to call llm with LlamaCpp located in llm.py
add_routes(app, chain, path="/llm")

if __name__ == "__main__":
    import uvicorn

    uvicorn.run(app, host="0.0.0.0", port=8000)
아래와 같이 정상적으로 LLM 서버가 구동 됨을 확인하였습니다.
Remote LLM loader - llm.py
LlamaCpp를 이용하여 llama-2-7b-chat.Q4_K_M.gguf 를 로드하였습니다.
연산은 CPU로 설정하였습니다.
추후 Llama-3 8B Instruct 모델로도 테스트 예정입니다.
from langchain_community.llms import LlamaCpp
# LLM 경로 지정
MODEL_PATH = "C:\Work\GenAI\FoundationModel\llama-2–7b-chat\llama-2-7b-chat.Q4_K_M.gguf"
#MODEL_PATH = "C:\Work\GenAI\FoundationModel\Llama-3-8B-Instruct\Meta-Llama-3-8B-Instruct.Q4_K_M.gguf"

llm = LlamaCpp(
    model_path=MODEL_PATH,
    temperature=0.2,
    top_p=1,
    max_tokens=3072,
    verbose=True,
    n_ctx=3072,
)
테스트 결과
LLM을 분리 후에도 정상적인 결과가 나옴을 확인했습니다.
그런데 결과가 완전히 일관 되지는 않는 것 같습니다.^^;;
성능은 약 5 tokens per second 나왔습니다.
To Do list
Multi-query retriever 동작 확인
Llama-3로 변경하여 동작 확인
GPU 환경에서의 동작 및 성능 확인
Ragas 프레임워크를 integration 하여 정확도 수치 확인
sejinoh80 님의 최신 블로그
더보기-

- NVIDIA Dynamo: 차세대 분산 추론 프레임워크 리뷰
- NVIDIA Dynamo 개요 NVIDIA Dynamo는 GTC 2025에서 정식으로 발표된 high-throughput low-latency 오픈 소스 inference 프레임워크 입니다. Dynamo를 활용하면 NVIDIA Blackwell GPU에서 DeepSeek-R1 모델 실행 시 사용자 처리량을 최대 30배까지 늘릴 수 있다고 합니다. Dynamo는 Triton Inference Server 프레임워크의 후속이며, TensorRT-LLM, vLLM, SGLang을 포함한 주요 LLM engine을 backend로 지원하고, 다음과 같은 주요 feature들을 가지고 있습니다. Disaggregated prefill & decode inference Dy...
-
- OpenLab - OpenLLM, Llama-2 7B, FAISS, LangChain 활용한 RAG 구현
- OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 RAG 챗봇 내용을 함께 공유드립니다. 스터디 모임 경과 - 주제 : OpenLLM 스터디 5차 오프라인 모임 - 일시 : 7/3 20:00 ~ 21:00 - 장소 : 판교사옥 - 참석 : 멤버 6명 중 4명 [+] 7명에서 1명 탈퇴(1명:취업) - 스터디 내용 1) RAG 에서 Pre/Post Retriever 코드 구현 공유 및 의견 교환 2) 특이점 토의 ollama 로 모델이 배포되지 않은 경우 vllm 사용 pre/post retriever 부분에서 시간 지연이 큰 경우 정상동작하는 다른 멤버의 코드 참고 langchain 과 LlamaIndex 중 langchain 의 평가가 좋지 않은 것으...
-
- OpenAI Advanced RAG 사례 분석
- OpenAI DevDay 2023에서 소개된 OpenAI Advanced RAG 사례에 적용된 기술들을 분석해 보고자 합니다. OpenAI에서 제시한 Advanced RAG는 기본 RAG에 Data index 최적화, Pre-Retrieval(Query 최적화), Post-Retrieval(검색된 context 최적화) 기술이 추가되었습니다. 기본 RAG와 비교된 그림을 보면 다음과 같으며, 적용된 기술들 중, Pre-Retrieval(Query 최적화), Post-Retrieval(검색된 context 최적화) 기술들의 상세 사항을 살펴 보겠습니다. (소스 : https://youtu.be/ahnGLM-RC1Y) Pre-Retrieval - HyDE HyDE는 ...
-
- In-Memory Data Grid 기술 소개
- In-Memory Data Grid 개요 In-Memory Data Grid (IMDG)란 computing engine이 탑재된 In-memory distributed caching software 기술이다. IMDG 기술을 활용하여 다수의 물리 서버들이 서로 연결되어 클러스터가 구축되면 대용량 memory pool이 형성되고, memory 안에 대용량 데이터들이 적재 혹은 caching 이 이루어진다. IMDG는 IMDB(In-Memory Data Base) 기능을 기본적으로 탑재하고 있으며, Disked 기반 이기종 DB 들에 이미 저장되어 있는 데이터들을 memory에 caching함으로써 기존 시스템을 그대로 유지하면서 고성능 big data proces...
DEVOTEE 추천 블로그
-
- OpenLab - OpenLLM, Llama3-8b | LlamaIndex | qdrant 로 만들어본 RAG 요약 LLM
- 지난 5월22일 오후 8시~9시에 판교사옥에서 2차 오프라인 미팅을 진행하였습니다. 주제 : OpenLLM 스터디 2차 오프라인 모임 일시 : 5/22 20:00 ~ 21:30 장소 : 판교사옥 참석 : 멤버 9명 중 6명 스터디 내용 가. RAG, Langchain 1차 개발 경험 상호 공유 나. 향후 계획 RAG 2차 완성 코드 개발 개발 소스코드를 첨부하고 다른 사람의 코드를 모두 실행해 보면서, RAG와 Langchain의 정확한 이해 다. 스터디 목표 법 요약/문장요약/Q&A 에 대한 RAG 및 Fine-tuning 완료 완성 형태 : 챗봇 또는 Web 등 완성품 형태의 UI 포함 라. 일정 RAG : 6/5 또는 6/19 Fine-Tuning : 6/1...
-
- OpenLab - OpenLLM, LLaMA3 을 이용한 RAG 구축 + Ollama 사용법 정리
- 스터디 운영자님의 스터디 운영 경과와 함께 스터디 내용 요약 정리해보았습니다. 0. 스터디 운영 공지 대부분의 멤버가 OpenLLM을 이용한 RAG 코드 개념 이해하는 것으로 확인되어 다음 스터디(6/19) 전(6/16)까지 3개 주제별로 OpenLLM 을 이용한 챗봇까지 개발해서 충분한 주석을 포함하고 챗봇 화면을 캡처해서 완성된 코드 버전을 제출할 예정입니다. 1. RAG Llama3-KO 를 이용해 RAG 를 구현해 보겠습니다. RAG 에 사용할 PDF로 근로기준법을 다운로드하여 사용했습니다. https://www.law.go.kr/법령/근로기준법 필요한 라이브러리 임포트 import os import warnings warnings.filterwarning...
-
- OpenLab - OpenLLM, Ensemble Retriever(pre), Rerank(post)가 적용된 RAG 챗봇 구현하기
- OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 RAG 챗봇 내용을 함께 공유드립니다. 스터디 모임 경과 - 주제 : OpenLLM 스터디 4차 오프라인 모임 - 일시 : 6/19 20:00 ~ 21:00 - 장소 : 판교사옥 - 참석 : 멤버 7명 중 4명 10명에서 3명 탈퇴(1명:이직, 2명:업무변경) - 스터디 내용 1) RAG 에서 Pre/Post Retriever 코드 구현 공유 및 의견 교환 2) RAG 평가 ragas 공유 3) 다음 스터디까지 제출 코드(파이썬 가상환경 requirements 포함) openllm 별도 로딩 및 서비스 시작 파일 업로드: 질문에 답변할 문서 데이터셋(pdf)을 업로드 Splitter: 업로드된 파일을 분...
-
- OpenLab - OpenLLM, Advanced RAG를 이용한 chatbot 구현
- OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 Advanced RAG 챗봇 내용을 함께 공유드립니다. 스터디 모임 경과 주제 : OpenLLM 6차 오프라인 모임(종료) 일시 : 7/17 20:00 ~ 21:00 장소 : 판교사옥 참석 : 멤버 7명 중 7명 스터디 내용 1) 결론 : 각자 필요한 기능 구현 7명 중 6명 완료(7명 전원 코드 개념 이해) 2) 결론 정리 최초 모델은 EEVE-Korean-Instruct-10.8B-v1.0-GGUF 를 사용 임베딩 모델은 BAAI/bge-m3 사용 PDF 로딩에는 PyPDFLoader() 이 유연하다 post/pre retriever 를 사용하면 성능이 향상된다 3) 현업 활용 방장을 포함한 멤버 7...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.