
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab - LLMOps, GraphRAG의 Graph를 평가하는 방식과 LLM Reasoning 성능

- DEVOTEE 요약
- GraphRAG 평가 방식에 대해 다뤄봤습니다. GraphRAG는 subgraph extraction 결과물을 token 형태로 변형한 후 token-based retrieval evaluator를 적용해 평가합니다. 이를 위해 대표적인 그래프 형태로 LPG와 RDF를 활용하고, 그래프 구조에 따라 다양한 알고리즘과 규칙을 적용해 평가 지표를 사용합니다.
안녕하세요! 그래프맨 정이태입니다.
오늘은 GraphRAG 평가 방식에 대해 이야기해보려고 합니다. RAG 평가하면 흔히들 떠오르는 방식이 무엇이 있을까요?
먼저 retrieval, generation 두 분류로 나누어 평가 방식을 생각하시겠죠. Retrieval에서는 NDCG, MRR, MAP 등이 있겠고,
Generation에서는 Bleu, ROUGE, BERT Score, METEOR 등이 있겠습니다.
autorag documentation 기반 (https://github.com/Marker-Inc-Korea/AutoRAG)
또한 LLM을 평가주체로 활용한 single point, reference-based, pairwise-based scoring 방식도 있습니다. LLM as judge 방식뿐만 아니라,
ARES, RAGAS 같은 평가 프레임워크들은 정답을 만드는 LLM과 정답을 맞추는 LLM(RAG generation LLM)을 분리하여,
정답지 생성부터 평가까지 LLM에게 맡길 만큼 LLM에 대한 의존성이 점점 커져가는 트렌드를 보여줍니다.
그럼 여기서 과연 GraphRAG는 어떻게 평가할까요? 핵심은 subgraph extraction으로 나온 결과물을 token 형태로 변형한 뒤,
token-based retrieval evaluator를 적용하는 것이라고 할 수 있습니다.
Subgraph를 추출하기 전에 GraphRAG에서 활용하는 대표적인 subgraph 형태를 잠시 짚고 가보겠습니다.
대략적으로 두 가지 형태를 주로 활용하고, 이를 분류할 수 있겠네요.
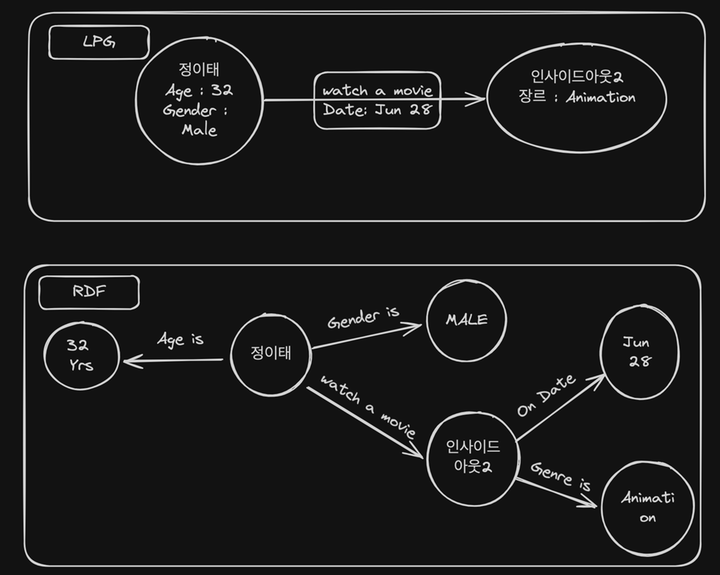
그림1. 데이터를 LPG 와 RDF 형태로 각각 표현했을때를 비교한 그림
첫 번째는 LPG(label property graph) 형태에서 용이한 문서-청크 형태의 unstructured graph입니다.
그림2. LPG 형태를 활용한 GraphRAG 그래프 모델링 예시
두 번째는 RDF(resource description framework) 형태에서 용이한 주어-서술어-목적어 형태의 logical reasoning graph입니다.
위 두 가지 LPG , RDF 형태처럼 그래프를 어떤 형태로 관리하고 활용할지에 따라 그래프 저장 방식을 구분할 수 있고, GraphRAG에서 활용할 수 있습니다.
그럼 이 subgraph를 어떻게 잘 추출할 수 있을까요? 첫 번째인 LPG에서는 그래프 내에 property라는 명목으로 데이터를 추가 저장할 수 있기에,
property 기반으로 추출하는 관점을 고려해 보아야 합니다.
텍스트 임베딩 값을 활용해 vector indexing을 한다거나, 프로퍼티 값들 중 하나를 메타로 지정해 meta filtering을 한다던지요.
혹은, 텍스트 그 자체의 값을 활용해 full text search와 같은 exact search 계열을 활용하여 연관성 있는 서브그래프를 추출할 수 있습니다.
두 번째 RDF에서는 주어-서술어-목적어와 같이 논리적인 구조를 띈 데이터들이 대다수이기에
주어부터 목적어까지 귀납적이나 연역적으로 추론하기 위한 추론 규칙들을 rule-based로 설계합니다.
혹은 RDF는 구조가 다양하기에 이를 고려하여 어디서부터 어디까지를 가져올지 선정하는 path finding 알고리즘과 graph structure를 조화롭게 배치하여
graph search 및 retrieval을 해야 만족스러운 값을 얻을 수 있습니다.
반면에 LPG는 구조보다 임베딩 기반 유사한 값들끼리 연관성을 적절하게 발견하여 새로운 연결을 만들어준 뒤,
community detection과 같은 클러스터링 알고리즘을 활용해 연관성 있는 지식그래프 클러스터를 만들어 준 뒤,
커뮤니티 내 intra-inter 위계를 활용해 총체적인 관점으로 답변을 내놓습니다.
*최근 Microsoft에서 공개한 GraphRAG 방식입니다.
최종적으로 이렇게 두 가지 관점으로 설계된 지식그래프로부터 subgraph를 추출합니다.
이를 통해 도출된 결과물들을 text (token) format으로 변경해주고 이를 token F1, recall 등과 같은 지표로 평가해주는 거죠.
좀 더 그래프 구조에 치중하여 이를 판단하고 개선하고 싶으시면 구글에서 최근 publish한 아래 논문을 추천드립니다.
설계된 지식그래프들이 결국엔 대다수 그래프 구조 중 하나의 형태를 띠기 때문입니다.
논문에서 그 구조마다의 특성 그리고 답변 결과에 얼마나 영향을 미칠것인가 사고 실험을 해보시고, 이에 따라 knowledge graph search를 어떻게 할 지 디자인해보는 거죠.
그림3. 대표적인 그래프 구조들
그림2에서 표현된 그래프 구조 7가지가 저희가 흔히 마주할 수 있는 그래프 구조들이라 할 수 있습니다.
RDF 혹은 LPG로 구성한 후, 서브그래프를 추출했을 때 다음 7가지 구조 중 하나에 속한 구조들을 마주할 확률이 높습니다.
그렇기에, 이 구조들 속에서 어떻게 유의미한 노드,엣지를 추출하는지가 핵심입니다.
그림4. 그래프 구조가 LLM performance에 유의미한 영향을 미친다를 설명한 단락
위 그림4 이외에도 Graph Encoding Function , Prompt Question Model Capacity 와 Graph Reasoning 간의 관계
그리고 Reasoning 시 Edge 의 부재에 따라 달라지는 성능 와 같은 다양한 실험들이 논문에 작성되어 있기 때문에,
관심 있으신 분들은 한 번 살펴보시는 걸 추천드립니다.
그래프 구조가 어떤 구조가 있으며, 이 구조마다 성능이 어떻게 달라짐을 논문의 그림 그리고 글을 통해 살펴봤습니다.
이를 통해, 기업의 데이터를 그래프 형태로 변환했을시 어떤 그래프 형태이며 이 그래프 형태가 LLM 성능에 유의미한 영향을 줄지를 유추해볼수 있는 하나의 근거로써 활용할 수 있음이
본 논문에서 얻을 수 있는 인사이트라고 할 수 있겠네요. 자세한 내용은 본 포스팅 끝에 작성되어있는 Reference 를 통해 살펴볼 수 있습니다.
오늘은 GraphRAG 평가를 위해 고려해야 할 요소들 그리고 어떻게 고려해야 할지에 대해 이야기해 봤습니다.
LPG와 RDF 관점으로 설계되는 지식그래프가 각각 다르며 이를 retrieval하는 그래프들도 다르기에 무엇을 목적으로 GraphRAG를 쓰는지 되새겨보고 이에 따라 설계해야 하며,
설계된 지식그래프는 token 형태로 관리하고 평가한다가 이 글의 골자입니다. RAG의 성능개선을 통해 많이들 GraphRAG를 활용하고자 고민이 많으신데,
본 포스팅을 통해 그 고민이 조금이나마 해소되었으면 하네요. 그럼 긴 글 읽어주셔서 감사합니다. 좋은 하루 되세요.
Reference
1.Edge, Darren, et al. "From local to global: A graph rag approach to query-focused summarization." arXiv preprint arXiv:2404.16130 (2024).
2.Fatemi, Bahare, Jonathan Halcrow, and Bryan Perozzi. "Talk like a graph: Encoding graphs for large language models." arXiv preprint arXiv:2310.04560 (2023).
그래프맨 님의 최신 블로그
더보기-
- OpenLab - LLMOps, GraphRAG의 Graph를 평가하는 방식과 LLM Reasoning 성능
- 안녕하세요! 그래프맨 정이태입니다. 오늘은 GraphRAG 평가 방식에 대해 이야기해보려고 합니다. RAG 평가하면 흔히들 떠오르는 방식이 무엇이 있을까요? 먼저 retrieval, generation 두 분류로 나누어 평가 방식을 생각하시겠죠. Retrieval에서는 NDCG, MRR, MAP 등이 있겠고, Generation에서는 Bleu, ROUGE, BERT Score, METEOR 등이 있겠습니다. autorag documentation 기반 (https://github.com/Marker-Inc-Korea/AutoRAG) 또한 LLM을 평가주체로 활용한 single point, reference-based, pairwise-based scoring 방식...
-
- OpenLab - Knowledge graph 스터디 참여 계기, 소개 및 온톨로지 모델 구축하는 방법 그리고 툴
- 안녕하세요. 오픈랩 Knowledge graph 스터디 참여하게된 정이태입니다. 저는 Graph Product Engineer 라는 직무로 일을 하고 있습니다. 그래프 기술을 활용하여 고객의 문제를 파악하고, 그래프를 사용하면 어떤 장점이 있는지를 설득하고 고객 문제를 해결하려는데 집중하는 업무를 맡고 있습니다. RAG로 인해 최근 Graph에 대한 관심이 급상승하며 GraphRAG 또한 덩달아 많은 주목을 받고 있는데요. 마침 GraphRAG 프로덕트 기획 및 구현을 하던도중 Openlabs 스터디를 알게되었고, 신청하게 되어 운이 좋게 선정되었습니다. 참고로, 저는 현재 LLMops 와 Knowledge graph 동시에 참여하고 있습니다. GraphRAG는 ...
DEVOTEE 추천 블로그
-
- LangChain LCEL과 RAGAS를 사용한 Native RAG 평가
- LangChain LCEL을 사용해서 Native RAG를 구현하고 RAGAS library를 사용해 평가를 진행해보겠습니다. 최근에 LangChain에 추가된 LCEL과 새로운 package 구조도 체험해보고, RAG 평가를 손쉽게 도와주는 RAGAS도 한번에 확인해보려고 합니다. 코드 예제는 Nayak님의 Medium 글을 참고하면서, 최신 LangChain 버전에 맞게 코드를 일부 업데이트 하였습니다. Azure LLM 과 Embedding 초기화 import os from langchain_openai import AzureChatOpenAI from langchain_openai import AzureOpenAIEmbeddings embeddings = ...
-
- OpenLab - Knowledge Graph 4번째 모임
- 오픈랩- 지식그래프 모임이 중반을 넘어서가고 있습니다. 갑작스럽게 RAG가 인기를 얻게 되고, 의미를 가진 객체간의 관계를 통한 RAG인 GraphRAG는 마치 우리가 그동안 갈망해왔던 모든 문제의 해결책을 담고 있는 것처럼 급히 부상하는 기술 주제가 되어버렸습니다. RAG, GraphRAG, Knowledge Graph. 이 세가지 용어에 대해서 다시한번 정의하고 가야할 것 같습니다. RAG는 문장 생성(task)에서 질의에 대한 답변을 생성할 때, 외부 지식 베이스(knowledge base)로부터 정보를 검색하고 이를 활용하여 보다 정확하고 풍부한 응답을 생성하는 기술입니다. GraphRAG는 정보의 관계성을 그래프로 표현하여 정보를 검색하는데 그래프 탐색을...
-
- OpenLab - LLMOps, AutoRAG에서 지원하는 다양한 노드&모듈
- OpenLab LLMOps 모임에서 살펴본 AutoRAG에서 지원하는 다양한 노드와 모듈에 대해 정리했습니다. Introduce AutoRAG 에서 지원하는 다양한 모듈에 대해서 살펴봅니다. Nodes & Modules Supporting Nodes & modules 1. Query Expansion 사용자 쿼리를 즉시 검색에 사용하지 않고 쿼리에 담긴 표현을 변형하여 검색결과의 관련성을 향상시키는 과정 → 다양한 쿼리 유형에 대응가능 & RAG 정확도 향상 Node Params N/A Strategy query_expansion 노드 결과만으로 노드의 성능을 측정할 수 없음 query_expansion이 적용된 쿼리로 검색 후에 검색 결과로 성능평가 Strate...
-
- RAG 기반 AI Agent 서비스 개발 - Microsoft GraphRAG 사용기
- Graph RAG를 이용한 AI Agent 시스템 구현의 1단계로, Microsoft의 GraphRAG를 이용하여 LLM을 이용한 Knowledge Graph 생성과 지식 검색을 테스트해보았다. 1. Microsoft GraphRAG란? Vector DB를 이용하는 기존 RAG 시스템과 달리, Microsoft GraphRAG는 정보 검색에 지식 그래프(Knowledge Graph를 활용하여 기존 RAG를 강화하는 프레임워크이다. 2. 주요 기능 LLM 기반 지식 그래프 생성: GraphRAG는 LLM모델을 사용하여 주어진 텍스트 데이터로부터 주요 개체(Entity)와 각 Entity간의 관계(Relationship)을 식별하고, 각각을 설명하는 의미적인 맥락을 ...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.