
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab - OpenLLM, Llama3-8b | LlamaIndex | qdrant 로 만들어본 RAG 요약 LLM
- DEVOTEE 요약
- OpenLLM 스터디 2차 오프라인 모임을 진행했습니다. RAG와 Langchain을 사용한 경험을 공유하고, 향후 계획 및 목표에 대해 논의했습니다. 또한 RAG 및 Fine-tuning 완료를 목표로 챗봇 형태의 완성품을 개발하는 일정을 확정했습니다.
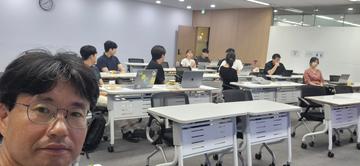
지난 5월22일 오후 8시~9시에 판교사옥에서 2차 오프라인 미팅을 진행하였습니다.
주제 : OpenLLM 스터디 2차 오프라인 모임
일시 : 5/22 20:00 ~ 21:30
장소 : 판교사옥
참석 : 멤버 9명 중 6명
스터디 내용
가. RAG, Langchain 1차 개발 경험 상호 공유
나. 향후 계획
RAG 2차 완성 코드 개발
개발 소스코드를 첨부하고 다른 사람의 코드를 모두 실행해 보면서, RAG와 Langchain의 정확한 이해
다. 스터디 목표
법 요약/문장요약/Q&A 에 대한 RAG 및 Fine-tuning 완료
완성 형태 : 챗봇 또는 Web 등 완성품 형태의 UI 포함
라. 일정
RAG : 6/5 또는 6/19
Fine-Tuning : 6/19 또는 7/3
데보션에 과제 제출 7/6
이 스터디 중 참가자 중에 한분이 작성한 블로그를 공개합니다.
--
이번에 저희 2차 LLM모임에서는 각 주제를 선정하여 RAG를 구현하기로 했습니다.
저는 이번에도 로컬을 먼저 진행하고, 그 다음에 코랩으로 옮겼습니다.
먼저 로컬진행을 할때는 3.11.9 파이썬 버전으로 진행을 했으며,
벡터디비의 경우 도커를 통해서 구현시켰으나,
코랩으로 옮긴 후에는 메모리로 지정하여 구현하였습니다.
RAG를 구현하는 많은 예제가 랭체인으로 되어있는데, 레딧에 의하여 랭체인은 많은 추상화를 했기 때문에
특별히 조작해야하거나 커스텀마이징이 필요할 경우 결국 안으로 파고들어야 하기 때문에 입문용 말고는
추천하지 않고 있었습니다.
그나마 랭체인에 비해 라마인덱스가 덜 추상화 되었다는 평이 있었기에 저는 라마인덱스 프레임워크를 사용했습니다.
또한 라마인덱스는 랭체인에 비해 데이터 검색 및 관리 작업에서 우수한 성능을 보인다고 합니다.
때문에 보다 RAG에 더 적합하다는 결론을 내렸습니다.
qdrant 는 하이퍼포머스라는 수식어를 달고 있고, 언어는 러스트로 작성되어있습니다. 또한 빠른 검색에 용이하며, 라마인덱스와 연계가 쉽게 된다는 점에서 이것을 선택했습니다.
먼저 의존성을 설치합니다.
llama-index
llama-index-llms-huggingface
llama-index-embeddings-fastembed
fastembed
Unstructured[md]
qdrant-client
llama-index-vector-stores-qdrant
einops
accelerate
sentence-transformers
transformers
llama-index-agent-openai
llama-index-cli
llama-index-core
llama-index-legacy
그 다음은 파일의 구조입니다.
저는 대체적으로 파일을 책임과 관심사별로 나눠 그 부분만 고치는 것을 좋아합니다. 주로 백엔드 개발을 할때 이렇게 나누게 되는데, 습관이 들어 LLM을 만들때도 대도록 나누고 있습니다.
config.py
HUGGING_TOKKEN = ""
BASE_MODEL = "MLP-KTLim/llama-3-Korean-Bllossom-8B"
DATASET = "content/Data"
FAST_EMBED_MODEL_NAME = "BAAI/bge-small-en-v1.5"
SYSTEM_PROMPT = "You are a Q&A assistant. Summarize the questions and answer accurately in Korean based on the given instructions and context."
QUERY_WRAPPER_PROMPT = "<|USER|>{query_str}<|ASSISTANT|>"
ENCODER_MODEL = "cross-encoder/ms-marco-MiniLM-L-2-v2"
보면 아시겠지만 이번에 라마3를 한국어 모델로 학습시킨 모델을 썼습니다.
dataset.py
from llama_index.core import SimpleDirectoryReader
from config import DATASET

class DataSetter:
  def __init__(self):
    self.dataset_dir = DATASET

  def load_dataset(self):
    print("Loading dataset...")
    return SimpleDirectoryReader(self.dataset_dir).load_data()
여기서 PDF를 로드합니다.
db.py - local
from llama_index.core import VectorStoreIndex
from llama_index.core import StorageContext
from llama_index.vector_stores.qdrant import QdrantVectorStore
from qdrant_client import QdrantClient

class Db:
    def __init__(self, documents):
        self.client = QdrantClient(host="localhost", port=6333)
        self.vector_store = QdrantVectorStore(client=self.client,collection_name="test")
        self.storage_context = StorageContext.from_defaults(vector_store=self.vector_store)
        self.documents = documents

    def get_index(self):
        return VectorStoreIndex.from_documents(self.documents,storage_context=self.storage_context)
로컬의 경우 아래의 도커 실행 명령어로 실행하면 됩니다.
docker run -p 6333:6333 -p 6334:6334 -v $(pwd)/qdrant_storage:/qdrant/storage:z qdrant/qdrant
db.py - colab
from llama_index.core import VectorStoreIndex
from llama_index.core import StorageContext
from llama_index.vector_stores.qdrant import QdrantVectorStore
from qdrant_client import QdrantClient

class Db:
    def __init__(self, documents):
        self.client = QdrantClient(location=":memory:")
        self.vector_store = QdrantVectorStore(client=self.client,collection_name="test")
        self.storage_context = StorageContext.from_defaults(vector_store=self.vector_store)
        self.documents = documents

    def get_index(self):
        return VectorStoreIndex.from_documents(self.documents,storage_context=self.storage_context)
embdding_setter.py
from llama_index.embeddings.fastembed import FastEmbedEmbedding
from llama_index.core import Settings
from config import FAST_EMBED_MODEL_NAME

class EmbedSettings:
  def __init__(self):
    self.embed_model = FastEmbedEmbedding(model_name=FAST_EMBED_MODEL_NAME)
    self.chunk_size = 512

  def set_and_get_liama_settings(self):
    print("Setting Llama settings...")
    Settings.embed_model = self.embed_model
    Settings.chunk_size = self.chunk_size
    return Settings
임베딩 모델을 설정합니다.
hugging.py
from huggingface_hub import login
from config import HUGGING_TOKKEN

class HuggingFaceNotebookLogin:
    def __init__(self ):
        self.token = HUGGING_TOKKEN

    def login(self):
        print("Logging in...")
        login(self.token)
load_llm.py - cpu
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from llama_index.llms.huggingface import HuggingFaceLLM
from config import BASE_MODEL

class LLMLoader:
    def __init__(self, system_prompt, query_wrapper_prompt):
        self.tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)
        self.stopping_ids = [self.tokenizer.eos_token_id, self.tokenizer.convert_tokens_to_ids("<|eot_id|>")]
        self.system_prompt = system_prompt
        self.query_wrapper_prompt = query_wrapper_prompt
        self.base_model = BASE_MODEL

    def load_llm(self):
        print("Loading LLM...")

        return HuggingFaceLLM(
                context_window=8192,
                max_new_tokens=256,
                generate_kwargs={"temperature": 0.7, "do_sample": False},
                system_prompt=self.system_prompt,
                query_wrapper_prompt=self.query_wrapper_prompt,
                tokenizer_name=self.base_model,
                model_name=self.base_model,
                device_map="cpu",  # CPU에서 실행되도록 설정 (필요시 'auto'로 변경)
                stopping_ids=self.stopping_ids,
                tokenizer_kwargs={"max_length": 4096},
                #model_kwargs={"torch_dtype": torch.float32}  # CPU에서 float32를 사용
                )
cpu의 경우 model_kwargs를 쓰지말라고 라마인덱스 홈페이지에 기재되어있습니다.
load_llm.py - gpu
import torch
from transformers import AutoModelForCausalLM, AutoTokenizer
from llama_index.llms.huggingface import HuggingFaceLLM
from config import BASE_MODEL

class LLMLoader:
    def __init__(self, system_prompt, query_wrapper_prompt):
        self.tokenizer = AutoTokenizer.from_pretrained(BASE_MODEL)
        self.stopping_ids = [self.tokenizer.eos_token_id, self.tokenizer.convert_tokens_to_ids("<|eot_id|>")]
        self.system_prompt = system_prompt
        self.query_wrapper_prompt = query_wrapper_prompt
        self.base_model = BASE_MODEL

    def load_llm(self):
        print("Loading LLM...")

        return HuggingFaceLLM(
                context_window=8192,
                max_new_tokens=256,
                generate_kwargs={"temperature": 0.7, "do_sample": False},
                system_prompt=self.system_prompt,
                query_wrapper_prompt=self.query_wrapper_prompt,
                tokenizer_name=self.base_model,
                model_name=self.base_model,
                device_map="auto",  # CPU에서 실행되도록 설정 (필요시 'auto'로 변경)
                stopping_ids=self.stopping_ids,
                tokenizer_kwargs={"max_length": 4096},
                model_kwargs={"torch_dtype": torch.float16}  # CPU에서 float32를 사용
                )
prompt_template.py
from llama_index.core import PromptTemplate
from config import SYSTEM_PROMPT, QUERY_WRAPPER_PROMPT

class PromptTemplates:
    def __init__(self):
        self.system_prompt = SYSTEM_PROMPT
        self.query_wrapper_prompt = PromptTemplate(QUERY_WRAPPER_PROMPT)

    def get_system_prompt(self):
        print("PromptTemplates.get_system_prompt()")
        return self.system_prompt

    def get_query_wrapper_prompt(self):
        print("PromptTemplates.get_query_wrapper_prompt()")
        return self.query_wrapper_prompt
템플릿을 설정해줍니다.
main.py
from llama_index.core.postprocessor import SentenceTransformerRerank

import time

from hugging import HuggingFaceNotebookLogin
from dataset  import DataSetter
from embdding_setter import EmbedSettings
from load_llm import LLMLoader
from prompt_template import PromptTemplates
from db import Db
from config import ENCODER_MODEL

print("hugging Login Start...")
HuggingFaceNotebookLogin().login()

print("load PDF Data Start...")
documents = DataSetter().load_dataset()

promptTP = PromptTemplates()
system_prompt = promptTP.get_system_prompt()
query_wrapper_prompt = promptTP.get_query_wrapper_prompt()

print("Setting Embed Model settings...")
settting = EmbedSettings().set_and_get_liama_settings()

print("Setting LLM settings...")
settting.llm = LLMLoader(system_prompt, query_wrapper_prompt).load_llm()

print("Setting db Index settings...")
dbIndex = Db(documents).get_index()

print("Setting SentenceTransformerRerank settings...")
rerank = SentenceTransformerRerank(model=ENCODER_MODEL, top_n=3)

print("Setting Query Engine settings...")
query_engine = dbIndex.as_query_engine(similarity_top_k=10, node_postprocessors=[rerank])
print("Query Engine Start...")
now = time.time()
response = query_engine.query("What is instruction finetuning?")
print(f"Response Generated: {response}")
print(f"Elapsed: {round(time.time() - now, 2)}s")
CPU의 버전의 경우 맥 M2에서 돌렸는데 CPU추론이 되질 않았습니다.
이것을 알 수 있는 이유가 맥의 CPU점유율이 증가하지 않았기 때문이죠.
때문에 할 수 없이 저는 다시 코랩으로 가서 GPU버전으로 돌렸습니다.
1차 결과
Response Generated:
Instruction tuning is the act of teach a model to follow specific instructions, like "be creative". It is a type of training data used in the field of natural language processing (NLP). The idea is to teach a model to follow specific " Prompts" or "Instructables" in order to solve various NLP tasks. This is useful for models that are not always exposed to the same training data, and need to be able to follow different instructions across different tasks.
Elapsed: 9.86s
저는 분명 한국어로 변환하는 시스템을 넣었지만 영어로 물었기 때문에 영어로 답변이 돌아왔습니다.
그래서 다시 질문 사항 자체에 한국어로 변환할 것을 요청했습니다.
now = time.time()
response = query_engine.query("What is instruction finetuning? and this answer transfer korean")
print(f"Response Generated: {response}")
print(f"Elapsed: {round(time.time() - now, 2)}s")
Response Generated:
"인스트럭션 피닝 튜닝"은 BERT와 같은 사전 훈련된 언어 모델의 파라미터를 조정하여 특정 다운스트림 작업에 적합한 방식으로 조정하는 작업입니다. 예를 들어, 질문 및 답변 형식의 데이터셋을 사용하여 Q&A 모델을 구축합니다. 이러한 작업은 대규모 언어 모델의 대중적 사용에 큰 영향을 미쳤습니다."
Elapsed: 6.01s
참조 문서
https://hypro2.github.io/langchain-llamaindex/
CPU버전 소스코드 첨부
gandalfzzing 님의 최신 블로그
더보기
DEVOTEE 추천 블로그
-
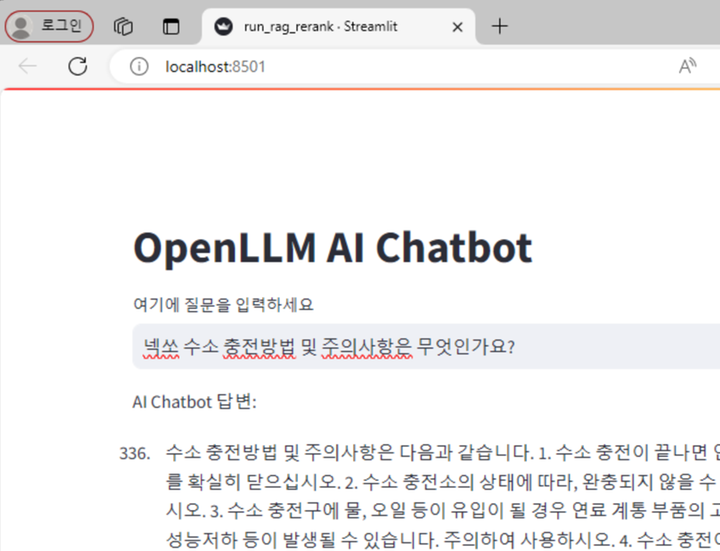
- OpenLab - OpenLLM, LLaMA3 을 이용한 RAG 구축 + Ollama 사용법 정리
- 스터디 운영자님의 스터디 운영 경과와 함께 스터디 내용 요약 정리해보았습니다. 0. 스터디 운영 공지 대부분의 멤버가 OpenLLM을 이용한 RAG 코드 개념 이해하는 것으로 확인되어 다음 스터디(6/19) 전(6/16)까지 3개 주제별로 OpenLLM 을 이용한 챗봇까지 개발해서 충분한 주석을 포함하고 챗봇 화면을 캡처해서 완성된 코드 버전을 제출할 예정입니다. 1. RAG Llama3-KO 를 이용해 RAG 를 구현해 보겠습니다. RAG 에 사용할 PDF로 근로기준법을 다운로드하여 사용했습니다. https://www.law.go.kr/법령/근로기준법 필요한 라이브러리 임포트 import os import warnings warnings.filterwarning...
-
- OpenLab - OpenLLM, Ensemble Retriever(pre), Rerank(post)가 적용된 RAG 챗봇 구현하기
- OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 RAG 챗봇 내용을 함께 공유드립니다. 스터디 모임 경과 - 주제 : OpenLLM 스터디 4차 오프라인 모임 - 일시 : 6/19 20:00 ~ 21:00 - 장소 : 판교사옥 - 참석 : 멤버 7명 중 4명 10명에서 3명 탈퇴(1명:이직, 2명:업무변경) - 스터디 내용 1) RAG 에서 Pre/Post Retriever 코드 구현 공유 및 의견 교환 2) RAG 평가 ragas 공유 3) 다음 스터디까지 제출 코드(파이썬 가상환경 requirements 포함) openllm 별도 로딩 및 서비스 시작 파일 업로드: 질문에 답변할 문서 데이터셋(pdf)을 업로드 Splitter: 업로드된 파일을 분...
-
- OpenLab - OpenLLM, Llama-2 7B, FAISS, LangChain 활용한 RAG 구현
- OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 RAG 챗봇 내용을 함께 공유드립니다. 스터디 모임 경과 - 주제 : OpenLLM 스터디 5차 오프라인 모임 - 일시 : 7/3 20:00 ~ 21:00 - 장소 : 판교사옥 - 참석 : 멤버 6명 중 4명 [+] 7명에서 1명 탈퇴(1명:취업) - 스터디 내용 1) RAG 에서 Pre/Post Retriever 코드 구현 공유 및 의견 교환 2) 특이점 토의 ollama 로 모델이 배포되지 않은 경우 vllm 사용 pre/post retriever 부분에서 시간 지연이 큰 경우 정상동작하는 다른 멤버의 코드 참고 langchain 과 LlamaIndex 중 langchain 의 평가가 좋지 않은 것으...
-
- RAG 기반 AI Agent 서비스 개발 (1회차 모임)
- 안녕하세요, 데보션 오픈랩 3기 "RAG 기반 AI Agent 서비스 개발"에 참여하게 된 염정입니다. 저희는 7월 20일에 온라인으로 먼저 킥오프 회의를 진행했는데요! 회의에서는 양필규 프로님께서 스터디 과제와 목표를 소개해주시고 이후 다 함께 오픈랩 프로젝트 계획을 수립했습니다. 또한, 각자 Padlet에 간단한 자기소개와 스터디에 기대하는 바를 작성하며 서로에 대해 소개하는 시간도 가졌습니다. 스터디 목표 과제1: RAG 기반 챗봇(AI Agent) 개발 과제2: AI 서비스를 활용한 요구사항 정의서 등 프로젝트 산출물 작성 및 다양한 AI 서비스의 결과물 비교 진행 방식 논의 다수의 소 과제 선정 후, 과제별 오너 중심으로 진행하고 결과물을 블로그에 작성하...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.