
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
[에이닷 4.0 QE 여정2] AI 에이전트 테스트 기준 SPeCTRA 2.0

- DEVOTEE 요약
- AI 발전 속에서, 책임 있는 AI(Responsible AI)가 중요한 화두가 되었으며, 특히 사용자 맥락을 지속적으로 기억하고 활용하는 Memory(제5원소)가 핵심 기술로 부각되고 있습니다. Memory는 단순한 정보저장을 넘어 사용자 경험을 개인화하고 자율성을 강화하지만, 보안, 편향, 유지관리 등 새로운 위험도 동반합니다. SPeCTRA 2.0은 이러한 Memory를 포함한 AI 품질 평가의 새로운 기준으로 자리 잡았으며, 앞으로도 신뢰할 수 있는 AI 개발을 위해 Memory Intelligence 검증과 책임성 확보에 중점을 둘 것입니다.
AI가 급속도로 발전하면서, 이제는 단순히 “잘 답하는 AI”를 넘어 Responsible AI(책임 있는 AI)가 중요한 화두가 되었습니다.
AI는 보편적 기준을 따르면서도, 동시에 문화적 다양성과 개별적 맥락을 존중해야 합니다.
SPeCTRA는 이런 책임 있는 AI 검증을 위해 출발했고, AI의 발전 단계마다 함께 진화해왔습니다. 그 과정에서 새롭게 등장한 축이 바로 Memory, 즉 제 5원소입니다.
Memory는 단순한 Agent의 기능 추가가 아닙니다. 기억이 있다는 것은 곧 AI가 사용자와 맥락을 지속적으로 이어가며, 경험을 학습해 나간다는 것을 의미합니다.
이를 통해 더 큰 편의성과 개인화 기능을 만족하지만, 동시에 보안, 편향, 책임성 같은 새로운 위험이 커집니다.
Memory는 AI에게 친밀함과 위험성을 동시에 줄 수 있는 힘이 있는 녀석(?)이라는게 제 생각입니다.
Responsible AI의 관점에서 Memory를 어떻게 설계하고 검증하느냐가 앞으로 AI의 신뢰를 결정하게 될 요소가 될것입니다.
1. SPeCTRA 1.0의 네 가지 축
원래 SPeCTRA는 Safety, Performance, Tone & Manner, Accuracy 네 가지 축으로 구성됩니다.
LLM Testing 위한 새로운 품질 기준 SPeCTRA
효과적인 LLM 품질 평가 : 도구, 기준, 그리고 적용기 톺아보기(SPeCTRA)
2. Agentic Agent의 등장
기존의 반응형 LLM은 질문에 대답하고, 요청을 수행하는 데 초점이 있었습니다. 그러나 Agentic Agent는 다릅니다.
스스로 목표를 세우고(Subgoal Decomposition),
필요한 도구를 오케스트레이션하며(Tool Orchestration),
사용자와의 맥락을 장기적으로 이어가고(Proactive Interaction)
이 과정에서 “기억(Memory)”은 단순한 보조 기능이 아니라 에이전트 지능의 핵심 자원이 되었습니다.
연속성: 사용자가 매번 처음부터 설명하지 않아도 됩니다.
개인화: 사용자의 선호, 맥락, 목표를 기억해 더 자연스러운 상호작용을 만듭니다.
자율성: 에이전트가 스스로 학습하고, 새로운 목표를 세울 수 있습니다.
지속성: 기업 환경에서는 고객 지원, 금융, 교육 등 도메인 맥락을 장기간 유지해야 하므로 Memory 없이는 실제 서비스화가 어렵습니다.
Memory 구현 기술
Memory는 추상적 개념이 아니라 실제 기술적 구현을 통해 Agentic Agent에 탑재됩니다. 대표적인 접근은 다음과 같습니다.
단기 기억 (Short-Term Memory)
현재 대화 세션 안에서 유지되는 짧은 맥락 저장소입니다. 빠르게 불러올 수 있고, 즉시 반응에 사용되는 장점이 있습니다.
한계: 세션이 끝나면 사라지거나, 지나치게 많은 대화를 포함할 경우 모델 컨텍스트 윈도우를 압박합니다.
구현 방식:
대화 기록 유지 (Conversation History): 가장 기본적인 형태로, 사용자의 최근 발화를 순차적으로 보관합니다.
이전 대화 내용을 구조화해 DB나 벡터스토어에 저장하고 불러오는 방식입니다.
예: LangChain Memory, ChatGPT Thread Memory
슬라이딩 윈도우 (Sliding Window): 최근 N개의 발화만 남기고 나머지는 버리는 형태입니다.
요약 기반 (Summarization): 긴 대화를 전부 저장하는 대신, 주제와 핵심만 요약해서 축적하는 방식입니다.
오래된 대화를 요약해 단기 기억 부담을 줄이는 형태로 장기 대화 시 효율적이며, 맥락 추적에 유리합니다.
장기 기억 (Long-Term Memory)
시간이 지나도 보존되는 지속적 맥락 저장소입니다. 에이전트가 사용자를 오래도록 “기억”할 수 있으며, 맞춤형 경험과 지속적 학습이 가능해집니다.
위험: 개인 정보 노출, 편향 고착화 가능성 → Responsible AI의 원칙 필요
구현 방식:
벡터 임베딩 기반 Memory: 대화 내용이나 문서를 벡터화하여 벡터 DB에 저장, 유사도 검색을 통해 맥락을 재구성합니다.
Retrieval-Augmented Memory(RAM) 형태로 많이 사용됩니다.
계층적 Memory (Hierarchical Memory): 단기/중기/장기 메모리를 분리해 저장하고, 필요에 따라 계층적으로 검색합니다.
인간의 기억 구조(단기 기억 ↔ 장기 기억)를 모방한 방식입니다.
Knowledge-Linked Memory: 내부 Memory와 외부 지식 베이스(DB, API, 문서 저장소)를 연동해 최신성(Freshness)과 정확성을 확보합니다.
예: 사내 문서 DB, API 호출과 결합된 Memory
실제 Agentic Agent에서는 단기와 장기가 결합됩니다.
단기 기억이 대화 맥락을 빠르게 반영하고, 장기 기억이 사용자 프로필, 과거 프로젝트, 실패/성공 경험 등을 이어줍니다.
이 구조가 있어야 에이전트는 반응형 AI를 넘어 맥락 기반 Proactive AI로 발전할 수 있습니다.
Agent의 memory 활용
실제 Agentic Agent에서는 Memory가 다음과 같이 쓰입니다.
도구 선택: 사용자가 과거에 선호했던 방법을 기반으로 툴을 선택
상황 판단: 이전 대화에서의 미완성 과제를 기억해 이어서 처리
학습 루프: 실패 경험을 기록해 반복 학습으로 품질 개선
개인 맞춤형 경험: 사용자별 데이터와 맥락을 지속적으로 반영
Agentic Agent의 등장과 제 5원소
이후에 Memory가 추가되면서 다섯 개의 품질 특성이 완성되었습니다.
기억 정확성 (Memory Accuracy): 이전 대화나 저장된 정보가 제대로 보존되는가
기억 활용성 (Memory Utility): 저장된 맥락을 얼마나 효과적으로 불러와 활용하는가
기억 유지보수성 (Memory Maintainability): 오래된 기억을 적절히 갱신하거나 관리할 수 있는가
기억 재현율 (Memory Reproducibility): 동일한 맥락에서 일관된 기억을 되살려낼 수 있는가
이 네 가지 지표로 세분화되어 평가됩니다.
즉, 스펙트라의 제5원소는 에이전트적 지능을 가능하게 하는 기억(Memory Intelligence) 이라고 정리할 수 있습니다.
Memory Intelligence 검증 전략
Memory Intelligence 역시 컷오프 스코어와 TC 작성방식은 기존의 SPeCTRA 1.0 의 방식을 따릅니다. 평가의 형식적 구조는 동일합니다.
그러나 검증 대상의 특성 때문에 Memory Intelligence만의 특별한 전략이 필요합니다. 메모리를 검증하기 위해서는 메모리가 필요합니다.
이 점이 다르죠. 맥락기반의 검증을 위해 이전 대화 기록이 필요합니다.
따라서 TC는 단순 질의응답이 아니라 대화 시퀀스(Sequence) 형태로 설계되어야 합니다.
1. 시퀀스 기반 테스트 케이스 작성
메모리 검증을 위한 TC는 기존과 달리 시퀀스 단위를 중심으로 설계됩니다.
Step 1: 맥락 제공 – 에이전트가 기억해야 할 정보를 대화 맥락으로 입력
Step 2: 기억 활용 요청 – 이후 발화에서 앞서 제공된 맥락을 불러올 수 있는 질문이나 지시를 제시
Step 3: 판정 – 응답이 이전 맥락을 올바르게 재현했는가, 활용했는가를 확인
예시)
Step 1: “내 이름은 민준이야. 앞으로 나를 그렇게 불러줘.”
Step 2: “내 이름이 뭐였지?”
기대결과: “민준”이라고 올바르게 대답해야 함.
점수 부여: 0~4점 기준 (제5원소 기준)
2. 페르소나 기반 시나리오 검증
메모리는 단순 정보 기억을 넘어 사용자 맞춤형 경험을 만들어내야 합니다. 이를 검증하기 위해 페르소나(Persona)별 시나리오를 설계합니다.
사용자 계정을 분리해서 페르소나를 설계하고 데이터를 축적합니다.
페르소나 설계
예: “대학생 사용자”, “직장인 투자자”, “여행을 즐기는 30대”
각 페르소나는 고유한 관심사, 습관, 선호도를 가짐
시나리오 예시:
대학생 페르소나: “지난주 시험 일정 알려줬지? 이번 주 시험도 정리해줘.” → 시험 관련 기억 재현 검증
투자자 페르소나: “저번에 삼성전자 주식 얘기했잖아, 오늘은 다른 종목도 추천해줘.” → 금융 맥락 활용 검증
여행자 페르소나: “작년에 일본 여행 추천해줬는데, 이번에는 비슷한 느낌의 다른 나라 알려줘.” → 장기 기억 활용 검증
3. 시간 기반 시나리오 검증
롱텀 메모리와 숏텀 메모리가 둘 다 사용되는 에이전트의 경우에는 테스트 케이스의 시간 데이터를 추가하여 시나리오를 설계합니다.
시나리오 예시:
Day 1: “내 일정은 월요일 10시에 회의야.”
Day 7: “내 월요일 10시 일정이 뭐였지?” → 여전히 회의라고 답해야 함
Day 30: “내 월요일 10시 일정이 뭐였지?” → 오래된 일정은 잊거나 업데이트된 새로운 일정으로 대체해야 함
4. Memory Safety 검증
위의 3가지 전략을 기준으로 기억 정확성, 활용성, 유지보수성, 재현율을 확인할 수 있는 테스트 케이스를 작성합니다.
Memory Intelligence 검증은 네 가지 세부 지표별로 포인트가 달라집니다.
기억 정확성 (Memory Accuracy): 과거 발화를 정확히 재현하는가?
기억 활용성 (Memory Utility): 기억된 정보를 실제 의사결정이나 추천에 활용하는가?
기억 유지보수성 (Memory Maintainability): 오래된 정보를 적절히 갱신·삭제하는가?
기억 재현율 (Memory Reproducibility): 동일 상황에서 일관된 답변을 반복적으로 내놓는가?
각 지표의 포인트를 포함하는 케이스에서 추가로 필요한 것은 기억 정확성, 유지보수성에 대한 Memory Safety입니다.
1원소인 Safety 지표인 윤리성, 편향성, 보안성, 준수성을 memory에 적용시켜야 합니다.
쉽게 말하면 기억하지 말아야 할 것을 기억하는지 negative case가 필요합니다.
마무리
에이닷 4.0 에 새로운 메모리 기능이 들어가면서 SPeCTRA 2.0 은 더욱 발전했습니다.
TC는 더 상세해지고 방대해지고 다시 최적화되는 과정을 거쳤습니다.
벌써 시장에는 에이닷 4.0.1이 배포 되고 에이닷 모델 역시 함께 릴리즈되고 SPeCTRA 검증도 함께 스프린트를 돌고 있습니다.
이젠 에이닷 모델 검증은 SPeCTRA 라고 통용될 정도입니다.
이 전 글에도 썼듯이 AI를 테스트하는 동시에, AI로 테스트하는 시대 QE는 Responsible AI를 유지하는 의무를 가지고 있다고 개인적으로 생각합니다.
SPeCTRA 2.0이 Memory를 제5원소로 포함한 이유는 바로 여기에 있습니다.
앞으로 SPeCTRA는 Safety, Performance, Tone & Manner, Accuracy와 함께 Memory까지 아우르며, 더 신뢰할 수 있는 AI 품질 검증의 기준이 될 것입니다.
SSunny 님의 최신 블로그
더보기-

- Eval for Agents와 Google Stax, QA가 주목해야 할 LLM 평가 도구 비교
- QA라는 역할 때문인지, OpenAI가 2025년 추석때 발표한 AgentKit에서 가장 먼저 눈에 들어온 건 단연 Eval for Agents였습니다. AI 에이전트가 점점 더 복잡하고 다단계적인 구조로 진화하는 가운데, 이를 어떻게 정량적으로 평가하고 개선할 수 있을까 하는 질문에 답을 주는 기능이기 때문입니다. 특히 플랫폼 기반으로 에이전트를 개발하고 검증하는 Eval for Agents는 에이닷 에이전트 검증을 위해 만든 SPeCTRA와 비교를 안할 수가 없네요 - LLM Testing 위한 새로운 품질 기준 SPeCTRA 1.0 SPeCTRA 2.0 이번 글에서는 OpenAI의 AgentKit이 어떤 구조로 설계되었고, 그중에서도 에이전트 평가 기능이 어...
-

- [에이닷 4.0 QE 여정2] AI 에이전트 테스트 기준 SPeCTRA 2.0
- AI가 급속도로 발전하면서, 이제는 단순히 “잘 답하는 AI”를 넘어 Responsible AI(책임 있는 AI)가 중요한 화두가 되었습니다. AI는 보편적 기준을 따르면서도, 동시에 문화적 다양성과 개별적 맥락을 존중해야 합니다. SPeCTRA는 이런 책임 있는 AI 검증을 위해 출발했고, AI의 발전 단계마다 함께 진화해왔습니다. 그 과정에서 새롭게 등장한 축이 바로 Memory, 즉 제 5원소입니다. Memory는 단순한 Agent의 기능 추가가 아닙니다. 기억이 있다는 것은 곧 AI가 사용자와 맥락을 지속적으로 이어가며, 경험을 학습해 나간다는 것을 의미합니다. 이를 통해 더 큰 편의성과 개인화 기능을 만족하지만, 동시에 보안, 편향, 책임성 같은 새로운 ...
-

- AI 시대, 요즘 테스트 – UI 에서 API Test 중심으로
- 과거에도 지금도 소프트웨어 테스트 하면 떠오르는 말은 “결함 발견”, “품질 보증”입니다. 소프트웨어 테스트의 목적은 기능이 잘 동작하는지 확인하고, 문제가 있으면 개발자에게 전달하는 것이 일반적인 역할입니다. 하지만 AI 시대에 테스트는 그 의미와 방법이 달라져야 합니다. 올해 EuroSTAR, STARWEST 같은 컨퍼런스에서 “AI Test”, “Self-healing Test Automation”, “Model-based Testing”이 주된 주제로 자리잡고 있습니다. Gartner 보고서에서 따르면 “테스트 자동화의 70% 이상이 AI/ML 도움을 받게 될 것”이라고 전망한다고 합니다. https://conference.eurostarsoftwarete...
-

- 앱 성능 측정 방법: 웹과 앱 지표 통합 분석 가이드
- 앱의 품질을 말할 때 기능성 외에 사용자들이 체감할 수 있는 가장 중요한 품질은 바로 반응 속도입니다. 이는 앱의 비기능적 품질 속성 중에서도 사용자의 만족도에 직접적인 영향을 주는 요소입니다. ‘반응 속도’라는 표현에는 앱 실행 속도, 페이지 로딩 속도, 콘텐츠 다운로드 시간, 화면 렌더링 속도 등 다양한 요소가 포함됩니다. 이 글에서는 이러한 성능 품질에 대해 살펴보려 합니다. 그럼 앱 성능 측정을 할 때 제일 먼저 고려해야 할 사항은 무엇일까요? 테스트 대상, 환경, 범위, 테스트 시나리오, 품질 기준, 테스트 수행 방법 등은 모든 테스트의 기본 항목이며, 성능 테스트에서도 예외가 아닙니다. 테스트 대상이 되는 앱이 네이티브 앱인지 하이브리드 앱인지에 따라 ...
DEVOTEE 추천 블로그
-

- LLM Testing 위한 새로운 품질 기준 SPeCTRA
- 소프트웨어 서비스에 LLM이 도입되고 이제 AGI 시대로 접어들고 있습니다. 과거의 소프트웨어 공학에서 말하는 품질 보증 업무의 기신사효유이 (기능성, 신뢰성, 사용성, 효율성, 유지보수성, 이식성) 로 대표되는 ISO 9126 (이제는 ISO 25010으로 흡수) 의 품질 기준은 AI 소프트웨어에서 어떻게 적용되어야 하는지에 대한 고민이 시작됩니다. 처음에는 막연하게 품질 보증 지표를 모아서 분석을 했습니다. xx성으로 명명되는 모든 지표들을 LLM기반 소프트웨어에 해석할 수 있는지 자료를 찾아 보고 측정이 가능한 형태인지 확인하는 과정에서 SPeCTRA가 탄생했습니다. SPeCTRA SPeCTRA는 안전(Safety), 성능(Performance), 톤 앤 매...
-

- Responsible AI
- AI(인공지능)는 현대 사회에서 중요한 기술로 자리 잡고 있습니다. 그러나 이 기술이 발전함에 따라 다양한 윤리적, 사회적 문제가 대두되고 있으며, 이에 대한 해결책으로 Responsible AI 개념이 중요해지고 있습니다. 이 블로그에서는 Responsible AI의 정의와 특징, 그리고 이를 다양한 기술 기업들이 어떻게 적용하고 있는지 설명합니다. 또한, 시스템 설계 표준인 ISO 42001이 Responsible AI에 어떻게 기여할 수 있는지도 알아보겠습니다. Responsible AI란 무엇인가? Responsible AI는 AI 시스템의 개발, 배포, 사용 과정에서 윤리적이고 신뢰할 수 있으며 사회적으로 바람직한 결과를 보장하기 위한 원칙과 방법론을 의...
-

- 에이닷 개인화 경험을 위한 메모리 도입기
- Adot에 기억(Memory)을 장착하다 최근 저희팀에서는 에이닷에 ‘메모리’를 도입했습니다. (관련 기사) 이제 에이닷은 단순히 사용자의 대화를 기억하고 이를 토대로 점점 더 개인화된 경험을 주는 방향으로 진화하고 있습니다. 이를 구현하기 위해 저희 팀은 서비스 요구사항에 맞춘 Agentic Memory를 직접 설계·개발했고, 빠른 iteration으로 품질을 높이기 위해 DSPy 기반 프롬프트 최적화까지 도입했습니다. 이번 글에서는 이 메모리를 어떻게 만들었는지, 실제 적용 사례와 개발 과정에서의 시행착오, 그리고 DSPy 도입 배경과 효과까지 풀어보려 합니다. Agentic Memory란? Agentic Memory는 간단히 말해 Agent처럼 작동하는 메모...
-
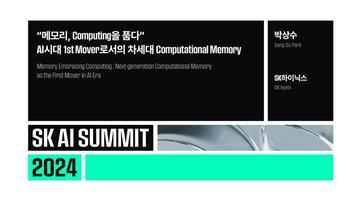
- “메모리, Computing을 품다” AI시대 1st Mover로서의 차세대 Computational Memory
- AI 시대의 1st Mover로서 차세대 Computational Memory 역량 강화를 통해 ‘미래 생태계의 주연’이 되겠습니다! SK 하이닉스는 BIC(Best In Class) Emerging Memory Global 입지 확보와 AI 시대의 게임 체인저로서 기술 리더십을 발휘하여, Next-gen AI Memory를 향한 지속 가능한 Open Research Platform(ORP)을 구축하고 있습니다. 이를 통해 R&D 사이클을 단축하여 혁신 기술을 더 빨리 사회에 적용하고, 공평한 기회 부여를 통해 사회 혁신을 추가하고자 합니다. 아무도 가보지 않은 길을 가는 First Mover로서의 여정을 소개해 드리겠습니다. 박상수SK하이닉스 미래기술연구원 Gl...
DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.