
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
- DEVOTEE 요약
- 사전 학습은 LLM의 언어 이해도를 높이는 단계이며, 지도 미세 조정은 사용자의 요청에 적절히 응답하도록 LLM을 추가 학습시킵니다. RLHF는 사람이 선호하는 데이터를 기반으로 강화 학습을 진행하지만, 리워드 모델과의 일관성 문제가 있을 수 있으며, 이를 보완하는 방법으로 기각 샘플링이 활용됩니다. DPO는 리워드 모델 없이 선호 데이터를 직접 학습하여 보다 안정적이고 효율적인 학습을 제공하며, 최근 RLHF보다 더 많이 사용되는 선호 학습 방법입니다.
말 잘 듣는 모델 만들기
Keyword: 사전 학습, 지도 미세 조정(supervised fine-tuning), 지시 데이터셋(instruction dataset)
강화 학습, RLHF(Reinforcement Learning from Human Feedback), PPO(Proximal Preference Optimization)
기각샘플링(rejective sampling), 직접 선호 최적화(Direct Preference Optimization, DPO)
사전 학습
LLM은 인터넷 상의 다양한 텍스트 데이터를 수집한 대용량의 텍스트로 사전 학습 수행
사전 학습 동안에는 LLM이 특정한 형태로 응답하거나 사용자의 요청에 따라 응답 하기를 기대하기는 어렵고,
LLM이 언어에 대한 전체적인 이해도가 높아지고 바로 다음에 올 단어를 잘 예측하게 하기 위한 단계
Llama-2: 10TB 분량의 코드, 블로그, 기사, 광고 등의 다양한 글이 섞인 텍스트 사용
지도 미세 조정
LLM이 사용자의 요청에 적절히 응답하기 위해 요청의 형식을 해석, 응답의 형태를 작성하여 요청과 응답이 잘 연결 및 정렬(aligment)되도록 추가 학습하는 것
지도(supervised): 학습 데이터에 정답(label)이 포함되어 있다는 의미
지시 데이터셋(instruction dataset): 지도 미세 조정에 사용하는 데이터셋. 사용자의 지시에 맞춰 응답한 데이터셋이라는 의미
지시사항(instruction): 사용자의 요구사항을 표현한 문장
입력(input): 답변을 하는데 필요한 데이터
출력(output): 지시사항과 입력을 바탕으로 한 정답 응답
텍스트(text): 지시사항, 입력, 출력을 정해진 포맷으로 하나로 묶은 데이터
{
"instruction": "Create a classification task by clustering the given list of items.",
"input": "Apples, oranges, bananas, strawberries, pineapples",
"output": "Class 1: Apples, Oranges\nClass 2: Bananas, Strawberries\nClass 3: Pineapples",
"text": "Below is an instruction that describes a task, paired with an input that provides further context. Write a response that appropriately completes the request.\n\n### Instruction:\nCreate a classification task by clustering the given list of items.\n\n### Input:\nApples, oranges, bananas, strawberries, pineapples\n\n### Response:\nClass 1: Apples, Oranges\nClass 2: Bananas, Strawberries\nClass 3: Pineapples",}
사전 학습, 지도 미세 조정 모두 인과적 언어 모델링(casual language modeling)을 사용하여 다음 단어를 예측하나 학습하는 데이터셋에 차이가 있을 뿐
지시 데이터셋
지시사항이 다양한 형태로 되어 있고 응답 데이터의 품질이 높을수록, 즉, 지시 데이터셋 품질이 높을수록 정렬한 모델의 답변 품질이 높아짐
Less is More for Alignment(정렬을 위해서는 적은 것이 더 낫다): 메타, 2023. Llama 모델을 정렬하는데 선별한 1,000개 정도의 지시 데이터셋 이용
Textbooks are All You Need(텍스트북이면 충분하다): 마이크로소프트, 2023. 파이썬 코드 생성 모델 파이(Phi)의 파라미터는 13억개
cf. 위자드코더(WizardCoder) 160억개, GPT-3.5 1,750억 개
선호 데이터셋(preference dataset)
사람이 더 선호하는 데이터를 선택한 데이터셋
ChatGPT: 선호 데이터(chosen data)에 비선호 데이터(rejected data)보다 높은 점수를 주어 생성된 답변의 점수를 평가하는 리워드 모델(reward model) 만듦
강화 학습 - RLHF
사람의 피드백을 활용한 강화 학습(Training Language from Human Feedback), OpenAI, 2022
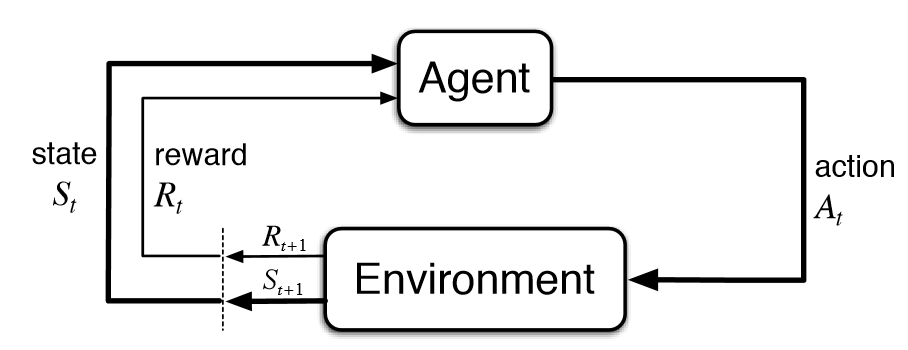
강화 학습에서 에이전트가 학습하는 방식
에이전트(agent)가 환경(environment)에서 행동(action)을 하고, 행동에 따라 환경의 상태(state)가 바뀌고 행동에 대한 보상(reward) 부여
에이전트가 연속적으로 수행하는 행동의 모음을 에피소드(episode)라고 지칭
언어모델이 RLHF를 통해 학습하는 과정을 대입하면 다음 단어를 예측하는 토큰을 하나씩 생성(action)하는데,
언어 모델이 텍스트를 모두 생성하면 리워드 모델(environment)이 텍스트를 평가하고 점수를 매김(reward)
생성한 문장의 점수가 높아지는 방향으로 학습(episode)
이 때, 보상을 높게 받는 데에만 집중하는 보상 해킹(reward haching)이 발생할 수 있음
PPO(Proximal Preference Optimization, 근접 정책 최적화): 보상 해킹 피하기
Proximal: 몸 쪽의, 가까운
지도 미세 조정 모델을 기준으로 학습하는 모델이 가까운 범위에서 리워드 모델의 높은 점수를 찾도록 한다는 의미
지도 미세 조정 모델을 기준으로 거리를 측정하므로 이를 참고 모델(reference mode)이라고 함
RLHF 단점
리워드 모델의 성능이 좋지 않으면 LLM이 일관성 없는 점수를 통해 학습하게 되면서 제대로 학습되지 않음
참고 모델, 학습 모델, 리워드 모델 총 3개의 모델이 필요하기 때문에 GPU 등 리소스가 더 많이 필요함
기각 샘플링(rejection sampling)
이미 지도 미세 조정을 마친 LLM을 통해 여러 응답을 생성하고 그 중 리워드 모델이 가장 높은 점수를 준 응답을 모아 다시 지도 미세 조정을 수행
강화 학습을 사용하지 않기에 학습이 비교적 안정적이고 간단하고 직관적인 방법이나 효과가 좋아 많이 활용
Llama-2:
a) 대용량의 학습 데이터를 사용해 자기 지도 학습
b) 지도 미세 조정을 통해 라마-2 챗 모델 생성
c) 사람의 피드백을 반영한 선호 데이터셋을 구축
d) 기각 샘플링 방법의 RLHF를 통해 선호 답변 학습
-> 강화 학습을 사용하는 PPO를 통해 모델이 사람의 선호를 학습하도록 하지 않고 기각 샘플링을 통해 언어 모델이 더 빠르고 안정적으로 사람의 선호도를 학습한 후 PPO를 사용
기각 샘플링은 그 자체로도 사람의 선호를 학습하는데 효과적
라마-2의 학습에서와 같이 강화 학습 전에 활용하여 학습을 더 안정적으로 만드는 방식에 활용
DPO(Direct Preference Optimization): 선호 데이터셋 직접 학습하기
RLHF는 선호 데이터셋으로 리워드 모델을 만들과 언어 모델의 출력을 평가하면서 강화 학습을 진행하지만 DPO에서는 선호 데이터셋을 직접 언어 모델에 학습
DPO에서는 학습이 잘 되고 있는지 확인하기 위해 학습 전 모델인 참고 모델(지도 미세 조정을 마친 모델)과 비교
-> 즉, 리워드 모델 x, 강화 학습 x. 2024년 기준 RLHF보다 더 많이 사용되는 선호 학습 방법
DPO를 활용한 사례
허깅페이스, 2023 제퍼-7B-베타
AI 평가를 사용해 DPO 학습 데이터 구축.
4개의 LLM이 생성한 결과를 AI가 평가하고 가장 높은 점수를 받은 선호 데이터와 나머지 3개 중 랜덤으로 선택한 비선호 데이터 쌍을 구축하여 dDPO를 수행
d는 다른 LLM이 생성한 데이터를 활용했으므로 지식 증류(knowledge distillation)를 했다는 의미
인텔, 2023. 뉴럴-챗-7B
사람이나 AI가 선호를 판단하지 않고 GPT-3.5 또는 GPT-4가 생성한 답변을 선호 데이터로, 라마-2-13B 모델이 생성한 답변을 비선호 데이터로 사용
단순히 더 성능이 뛰어난 모델의 생성 결과를 선호 데이터로 선택함으로써 학습 과정을 더 단순화
앨런 AI의 튈루-2
파라미터가 700억 개인 모델에서도 DPO를 통해 사람의 선호를 학습시킬 수 있다는 점을 확인
kyungmi.kim 님의 최신 블로그
더보기-

- 효율적인 GPU 메모리 사용을 위한 여러 기법
- 키워드: GPU(Graphic Processing Unit), OOM(Out of Memory) / 그레이디언트 누적(gradient accumulation), 그레이디언트 체크포인팅(gradient checkpointing) / 분산학습(distributed training), 데이터 병렬화(data parallelism), 모델 병렬화(model parallelism), 파이프라인 병렬화(pipeline parallelism), 텐서 병렬화(tensor parallelism) ZeRO(Zero Redundancy Optimizer) / 효율적인 학습 방법(PEFT: Parameter Efficient Fine-Tuning), LoRA(Low-Rank Adapt...
-

- 모델 정렬을 위한 효과적인 학습 전략
- 말 잘 듣는 모델 만들기 Keyword: 사전 학습, 지도 미세 조정(supervised fine-tuning), 지시 데이터셋(instruction dataset) 강화 학습, RLHF(Reinforcement Learning from Human Feedback), PPO(Proximal Preference Optimization) 기각샘플링(rejective sampling), 직접 선호 최적화(Direct Preference Optimization, DPO) 사전 학습 LLM은 인터넷 상의 다양한 텍스트 데이터를 수집한 대용량의 텍스트로 사전 학습 수행 사전 학습 동안에는 LLM이 특정한 형태로 응답하거나 사용자의 요청에 따라 응답 하기를 기대하기는 어렵고,...
DEVOTEE 추천 블로그
-
- Direct Alignment from Preferences | Part - 02.DAP
- Introdunction 지난 포스팅 "Direct Alignment from Preferences Part - 01.RLHF" 에서는 강화학습 (RL) 을 사용해 사람의 취향에 맞는 답변을 생성할 수 있게 된 언어모델을 학습하는 방법을 알아보았습니다. 하지만 RL 은 Supervised learning 과 비교했을 때 불안정한 학습 방법입니다. (학습이 hyperparameter 의 영향을 많이 받을 뿐더러 좋은 Reward 를 받을 수 있는 데이터를 확보할 수 있도록 엄청나게 많은 exploration 이 필요합니다. RL 의 불안정성에 대해서는 추후 기회가 되면 다뤄보도록 하겠습니다) 또한 RL 을 사용하는 방법론들은 Computation cost 가 높다는...
-

- 성숙한 LLM 만들기 : LLM Alignment (RLHF, DPO) ft. ChatML
- 개요 지난 포스팅 Gemma 한국어 요약 모델 파인튜닝 빠르게 해보기 Instruction tuning : LLM이 사람 말을 알아 듣는 방법 이전 포스팅을 통해 LLM의 사전 학습은 막대한 양의 데이터를 통해 텍스트 간의 관계와 패턴을 학습하는 과정이라는 것을 확인했습니다. 이 과정을 거쳐 생성된 모델은 문맥을 파악하는 능력을 갖추게 되었지만, 다양한 상황에 맞게 내재된 정보를 조합하여 적절하게 전달하는 능력은 아직 배우지 못했습니다. LLM이 기본적으로 주어진 입력에 대해 다음 토큰을 예측하는 확률 모델 이기 때문입니다. 그래서 우리는 모델이 원하는 답변을 생성하도록 파인튜닝 기법을 통해 출력을 조정하는 방법을 살펴보았습니다. 그러나 파인튜닝을 통해서도 생성된...
-

- AI 선생님과 제자의 대화: Teacher–Student 구조와 BERTScore, Classifier 활용법
- 최근 LLM 기반 에이전트가 다양한 분야(예: 고객 상담, 여행 추천, 지식 답변 등)에 활용되면서, 모델 성능과 효율성의 균형이 매우 중요해졌습니다. 가벼우면서도 작으면서도 잘되는 모델 어디 없나 하는 형태죠. 이때 자주 사용되는 전략이 바로 Teacher–Student 구조입니다. Teacher-Student 구조는 딥러닝 분야에서 널리 사용되는 방식으로, 일반적으로 Knowledge Distillation(지식 증류, KD) 기법을 통해 활용됩니다 Knowledge Distillation Knowledge Distillation이란 큰 모델(Teacher)의 지식을 작은 모델(Student)로 이전하는 방법입니다. 간단히 표현하면, "큰 모델이 작은 모델을 ...
DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.