
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
OpenLab - Knowledge Graph 킥오프 후기 및 지식그래프 소개

- DEVOTEE 요약
- 지식그래프에 대한 오픈랩이 시작되었으며, 4월 22일에 첫 킥오프 모임이 있었습니다. 이 분야는 예전부터 있었던 주제임에도 불구하고 여전히 많은 관심을 받고 있으며, 오픈랩을 통해 이 분야에 대한 더 깊은 이해와 공부의 기회를 제공할 예정입니다. 본 내용은 인공지능 및 자동화 시스템의 추론과 추리 능력을 강화하는 것에 초점을 맞추며, 심볼과 RDF, 지식그래프의 구조와 이를 통한 추론 과정에 대해 설명합니다.
드디어 오픈랩이 시작되었고, 지식그래프 모임은 4월 22일 킥오프를 진행하였습니다.
위 후기 글에서 밝혔듯, 지식그래프라는 분야는 꽤 오래된 주제로 여겼으나,
다양한 분야의 전문가와 이제 막 사회 생활을 시작한 초년생인 분들까지 관심을 주시는 것으로 보아 그렇지 않다는 것을 다시한번 확인하게 된 계기였습니다.
시맨틱 웹과 온톨로지가 정의되던 시기에 머물러 있던 것은 정작 저 자신이었던 같아 한번 반성하고,
오픈랩을 통해서 이 분야에 대해 좀더 같이 공부하는 계기가 될 수 있도록 각 과정을 데보션 블로그에 연재해 나갈 예정입니다.
본 글은 그 첫번째 순서로 지식그래프가 무엇인가를 설명하도록 하겠습니다.
인공지능과 추론
인공지능은 기계가 인간과 유사한 지능을 발휘할 수 있게 만드는 기술 분야 입니다.
특히 머신 러닝을 기반으로 한 인공지능은 학문과 산업의 구분을 지어서 말할 필요가 없을 정도로 급격한 발전을 하여 문제 해결에 있어서 탁월한 성과를 내고 있습니다.
그러나 여전히 인정할 수 밖에 없는 부분은, 학습 데이터 내에서 정의되지 않은 경우에 대해서 정확한 결과를 내지 못할 가능성이 있다는 것입니다.
학습하지 못한 상황에 대해서 문제를 해결하고자 할때, 인간은 이성적인 상황에서 추리(Reasoning)와 추론(Inferencing)을 하여 합리적으로 결정하려고 노력합니다.
이러한 기준을 가지고 인공지능 기술에 대해서 다음과 같이 분류 하기도 합니다.
재미있는 부분은 AI를 규칙을 통해 지능을 갖추는 비생물학적 시스템 이라고 정의한 것입니다. 좀더 간단한 단어로 말하자면, 자동화 시스템이라고 이야기할 수 있을 듯 합니다.

Fig. 1 인공지능 기술의 분류[1]
자동화 시스템(Automation System)은 인간의 개입을 최소화하면서 작업을 자동으로 수행하는 시스템입니다. 간단하게는 타이머를 이용한 스위치부터, 로보틱스, 인공지능 소프트웨어를 말할수 있습니다.
자동화 시스템에서 인간의 개입을 최소화하기 위해서는, 입력된 데이터로부터 논리적 결론을 도출하고, 문제를 해결하며, 불확실한 상황에서 예측을 하는 능력을 갖추어야 합니다.
이러한 능력은 추리와 추론에 의해서 달성할 수 있으며, 추리와 추론 능력이 강화될수록 자동화시스템은 더 지능적이고 독립적이라고 말할 수 있습니다.
기계가 하는 추론이란
사실 inferencing과 reasoning의 해석이 간혹 동일한 “추론”이라고 나오는데,
엄밀히 말하면 inferencing은 기존 사실과 일련의 규칙을 기반으로 새로운 사실을 도출하는 작업으로 정의할 수 있으며,
reasoning은 대상을 이해하고 문제 해결 및 의사 결정을 포함하는 더 넓은 범위의 인지 작업이라고 말할 수 있어, 인공지능에서 이야기할 때는 각각을 추론과 추리를 엄밀히 구분해야합니다.
다시 자동화 시스템을 정의하자면, 지능적인 자동화 시스템은 보다 높은 수준의 추리를 통한 문제 해결 능력을 보유한 시스템이며,
이러한 추리를 수행하기 위해서는 사실과 규칙을 잘 정의하여 추론할 수 있는 기능을 포함할 수 있어야 합니다.
추론기능은 논리로부터 시작하기 때문에, 삼단논법을 예로 들어보겠습니다.
사람은 죽는다.
카이사르는 사람이다.
고로, 카이사르는 죽는다.
첫번째 문장 “사람은 죽는다”는 다음과 같은 명제 논리 (Propositional Logic)으로 정의할 수 있습니다. 명제논리는 참과 거짓으로 말할 수 있는 명제로 구성된 것을 의미합니다.
H→D H \rightarrow D H→D
latex
그러나 위 명제 논리에 따르면, H와 D는 독립적으로 참이어도 성립합니다. 예를 들어, 사람이면, (사슴이) 죽는다도 성립하게 됩니다.
그렇기 때문에 개체 단위로 한정할 필요가 있습니다. 이는 술어 논리(Predicate Logic)으로 보다 정확하게 설명할 수 있습니다.
∀x(H(x)→D(x)) \forall x (H(x) \rightarrow D(x)) ∀x(H(x)→D(x))
latex
이제 모든 x에 대해서, x가 사람이면, 그 x는 죽는다 가 되어 첫번째 문장을 완벽하게 서술하는 것을 볼 수 있습니다.
두번째 문장인 카이사르는 사람이다 는 위 식에서 x를 Caesar로 한정하는 것을 의미하기 때문에 H(Caesar) 로 표현할 수 있게 됩니다.
그래서 우리는 당연히 Caesar가 D(Caesar) 로 되는 것을 추론할 수 있습니다.
기계가하는 추론을 구현하는 방법은 많지면, 여기서는 로직 솔버(logic solver)중에 하나인 clingo[2]를 통해 다음과 같이 작성해 보았습니다.
clingo는 ASP(Answer Set Programming) 도구로 심볼을 기반으로 한 규칙 기반의 비모노토닉(non-monotonic) 추론을 지원하고 있습니다.
비모노토닉 추론이란, 참이란 증거가 없는 경우 (여기서는 참이라는 규칙이 명확하게 제공되지 않는 경우) False로 간주하는 원리입니다.
% 사람이면 죽는다.
death(X) :- human(X).

% 카이사르는 사람이다.
human(caesar).

% 쿼리: 카이사르는 죽는가?
#show death/1.
쿼리인 #show death/1 은 clingo의 기능으로 인자를 1개 받는 death 심볼에 대한 해 집합(Answer Set)을 가져오는 구문입니다.
이 스크립트를 clingo를 통해 실행하면 다음과 같이 Caesar는 death라는 결과를 1개 얻을 수 있습니다.
% clingo caesar.clingo
clingo version 5.7.1
Reading from caesar.clingo
Solving...
Answer: 1
death(caesar)
SATISFIABLE

Models       : 1
Calls        : 1
Time         : 0.001s (Solving: 0.00s 1st Model: 0.00s Unsat: 0.00s)
CPU Time     : 0.001s
이렇듯, 사실로는 “사람은 죽는다”와 “카이사르는 사람이다”라는 두가지 정보를 주었지만, 로직 프로그래밍을 통해서 “카이사르는 죽는다”를 얻어낼 수 있으며, 이러한 과정을 추론이라고 부릅니다.
수와 기호를 사용하여 방정식을 만들고 해결하는 방안을 이야기하는 대수학(Algebra)에서는 계산하여 해를 얻는다고 표현하지만,
로직 프로그래밍에서 해를 얻는 과정을 추론이라고 이야기하는 이유는, 얻은 해를 새로운 사실로 사용할 수 있기 때문입니다.
심볼(Symbol)과 RDF(Resource Description Framework)
대수학이나, 일반적인 프로그래밍 언어에 익숙하다면 위의 예제가 시작부터 조금 의아할 수도 있을 것입니다. clingo 예제에서 나온 키워드는 death, human, caesar 입니다.
하지만 그 어디에도 이러한 키워드를 설명하지 않고 있습니다. 이는 기계가 하는 추론에서 매우 중요한 부분으로,
사실 기계는 이러한 키워드의 맥락(context)를 이해하지 않기 때문에, 예제에서 사용한 세가지 키워드를 아무런 의미가 없는, a, b, c로 바꾸어도 clingo는 해를 구하는 추론을 수행할 수 있습니다.
이것이 가능한 이유는 각 키워드 간의 관계를 기반으로 추론을 수행하기 때문입니다.
기계의 입장에서는 death, human, caesar는 단지 이 코드를 작성한 사람이 읽기 편하게 하기 위하여 부여한 특수한 기호일 뿐입니다.
맥락을 추가하기 위해서는 수식을 조금 수정해서 표현할 수 있습니다.
H(x)→diesD(x) H(x) \xrightarrow {dies} D(x) H(x)diesD(x)
latex
Predicate Logic 기준으로는, 변화한게 없이 부가 정보만 기술한 것이지만, 이로써 H 가 D로 변화하는 기전은 dies로 명확하게 정의된 것입니다.
이는 “사람은 죽는다”라는 문장을 다음과 같은 구성요소로 나누어 정보의 누락 없이, 각 정보를 심볼로 기록하는 것에 벗어나서 메타데이터를 기술 할 수 있는 구조로 모델링 했다는 큰 의의를 가집니다.
Subject: 사람(H)
Predicate: 죽다(dies)
Object: 죽음(D)
이러한 모델링은 RDF(Resource Description Framework)의 기본 아이디어가 됩니다.
RDF는 본래 웹에 있는 문서(자원)들에 대해서 메타데이터를 기술하기 위한 데이터 모델로, 주어(Subject), 술어(Predicate), 목적어(Object)의 트리플(Triple) 형태로 정보를 표현합니다.
그렇기 때문에 RDF를 기반으로 하는 데이터는 Triples라고 이야기하고, 이를 저장하는 공간을 Triple Store로 표현을 하고 있습니다.
Triples를 통해서 Predicate Logic에서 수행하듯, 추론을 수행할 수 있습니다. 이는 다음과 같은 파이썬 코드로 작성 가능합니다.
from rdflib import Graph, Literal, RDF, URIRef
from rdflib.namespace import FOAF, XSD

# RDF 그래프 초기화
g = Graph()

# 네임스페이스 정의
namespace = URIRef("http://example.org/")

# 리소스와 리터럴 정의
human = URIRef(namespace + "Human")
dies = URIRef(namespace + "dies")
death = URIRef(namespace + "Death")
caesar = URIRef(namespace + "Caesar")

# 트리플 추가
g.add((human, dies, death))
g.add((caesar, RDF.type, human))

# 추론: Caesar가 죽음에 이르는지 확인
if (caesar, dies, death) in g:
    print("Caesar dies.")
else:
    # RDF 추론 로직
    if (caesar, RDF.type, human) in g and (human, dies, death) in g:
        print("Caesar dies due to inference.")
    else:
        print("Caesar does not die.")
결론
정보를 심볼로 정의하고 술어 논리에 따라 해를 찾는 과정을 추론이라고 하며 이를 다루는 인공지능 분야는 전통적인 인공지능으로, 명확하게는 Symbolic AI라고 말할 수 있습니다.
심볼에는 사람이 인지할 수 있는 정보가 없기 때문에 심볼에 메타데이터를 추가하는 방법으로 나온 기술이 RDF이며,
RDF를 활용하여 Triples를 구성한 것은 결국 각 s, p, o를 통해 연결이 이루어지기 때문에 이를 지식그래프라고 부릅니다.
다만 지식그래프를 표현하는 방법은 RDF만 있는 것이 아니며, 심볼과 이를 설명할 수 있는 메타로 구성된 객체들이 서로 링크를 가지고 있는 경우로 포괄적인 의미로 통용되고 있습니다.
이러한 복잡한 개념의 지식그래프가 필요한 이유는 여러가지가 있을 수 있지만, 기계가 수행할 수 있는 추론을 가능하게 하는 가장 기본이 되는 단위라고 설명할 수 있습니다.
[1] https://github.com/rasbt/stat453-deep-learning-ss20/blob/master/L01-intro/L01-intro_slides.pdf
joykim 님의 최신 블로그
더보기-
- [AI 마케팅] 10. 온톨로지와 LLM으로 오프라인 광고시장을 더 가치있게 만들기
- 🌟 스터디 개요 및 학습 목표 오프라인 광고는 여전히 강력한 힘을 가진 채, 디지털과는 다른 방식으로 소비자에게 메시지를 전달하고 있습니다. 하지만 그 효과를 분석하고 개선하는 데는 여전히 한계가 많습니다. 비즈니스를 이해하는 것과 데이터를 이해하는 것은 어찌보면 서로 다른 방향으로 더 멀리 달려가는 것과도 유사하다고 느껴지기 때문입니다만, 이번 스터디는 바로 그 지점을 정조준합니다. 우리는 온톨로지와 LLM 기반 HAI(Human-Agent-Interaction) 기술을 통해, 오프라인 광고 데이터를 더 정교하게 분석하고, 비즈니스 가치를 끌어올릴 수 있는 방법을 함께 탐색합니다. 온톨로지는 데이터 해석의 구조를 만들고, HAI는 인간 관점에서 그 의미를 자연...
-
- OpenLab - Knowledge Graph 6번째 모임
- 오픈랩 - 지식그래프 스터디의 거의 막바지에 이르렀습니다. 그동안 온라인, 오프라인 둘중 하나만 선택해서 진행했는데, 이번 모임은 하이브리드로 진행을 해보았습니다. 역시 하이브리드는 정말 고려할게 많아서 진행에 어려움이 많았지만, 그래도 시공간의 제약을 벗어나서 건설적인(?) 대화를 진행할 수 있다는 것은 무시못할 장점인 듯합니다. 오프모임에 참석하신 분들만 중간에 멈추고 식사를 진행해서 어수선함을 극복하는 것도 과제이긴 했습니다. 시간이 지날수록 처음부터 이렇게 진행할 것을 하는 생각에 끊임없이 우왕좌왕 하였지만, 다음과 같은 접근 방법을 통해 스터디에서 문제 해결 방법의 실마리를 찾아가게 되었다는 것도 소득이긴 합니다. 그 시기가 좀 늦긴했지만요. 무언가 근사...
-
- OpenLab - Knowledge Graph 4번째 모임
- 오픈랩- 지식그래프 모임이 중반을 넘어서가고 있습니다. 갑작스럽게 RAG가 인기를 얻게 되고, 의미를 가진 객체간의 관계를 통한 RAG인 GraphRAG는 마치 우리가 그동안 갈망해왔던 모든 문제의 해결책을 담고 있는 것처럼 급히 부상하는 기술 주제가 되어버렸습니다. RAG, GraphRAG, Knowledge Graph. 이 세가지 용어에 대해서 다시한번 정의하고 가야할 것 같습니다. RAG는 문장 생성(task)에서 질의에 대한 답변을 생성할 때, 외부 지식 베이스(knowledge base)로부터 정보를 검색하고 이를 활용하여 보다 정확하고 풍부한 응답을 생성하는 기술입니다. GraphRAG는 정보의 관계성을 그래프로 표현하여 정보를 검색하는데 그래프 탐색을...
-
- OpenLab - Knowledge Graph 킥오프 후기 및 지식그래프 소개
- 드디어 오픈랩이 시작되었고, 지식그래프 모임은 4월 22일 킥오프를 진행하였습니다. 오픈랩 후기 글: https://skdevocean.page.link/9hBx2hUU2785WbW59 위 후기 글에서 밝혔듯, 지식그래프라는 분야는 꽤 오래된 주제로 여겼으나, 다양한 분야의 전문가와 이제 막 사회 생활을 시작한 초년생인 분들까지 관심을 주시는 것으로 보아 그렇지 않다는 것을 다시한번 확인하게 된 계기였습니다. 시맨틱 웹과 온톨로지가 정의되던 시기에 머물러 있던 것은 정작 저 자신이었던 같아 한번 반성하고, 오픈랩을 통해서 이 분야에 대해 좀더 같이 공부하는 계기가 될 수 있도록 각 과정을 데보션 블로그에 연재해 나갈 예정입니다. 본 글은 그 첫번째 순서로 지식그래...
DEVOTEE 추천 블로그
-
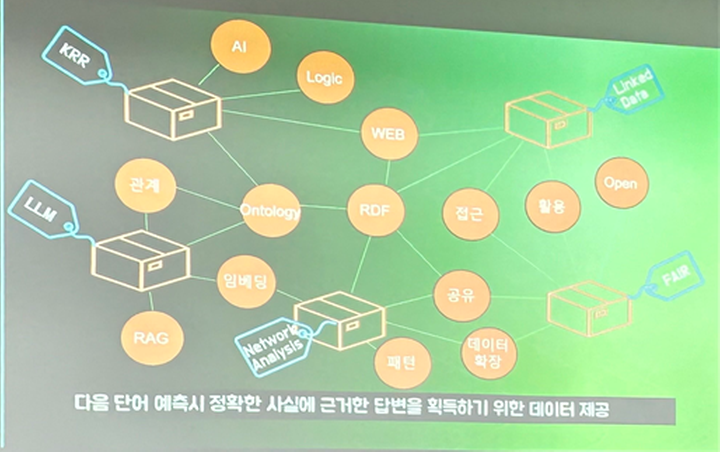
- OpenLab - Knowledge Graph # 지식 그래프란?
- 안녕하세요 OpenLab-Knowledge Graph 참여하고 있는 김지영입니다😃 저는 대학원에서 자연어처리를 공부하고 있는데요. 지식그래프(온톨로지)를 이용해 언어 모델의 정확도를 높일 수 있을지에 관해 관심을 가지고 스터디에 참여하게 되었습니다! 관심 있다고는 했지만 사실 지식그래프에 대해 자세히 배워본 적이 없어서 걱정이 많았는데요. 마침 저희 팀 홍수님께서 OT 느낌으로 지식그래프가 무엇인지에 대해 발표해주셨습니다. 저는 이 설명이 지식그래프를 이해하는 데 도움이 많이 돼서 제가 이해한 내용을 바탕으로 발표 내용을 포스팅을 해보겠습니다 제가 잘못 이해한 부분이 있다면 편하게 말씀해주세요! 피드백은 언제나 환영입니다🙌🏻 지식그래프? 다양한 출처의 지식을...
-
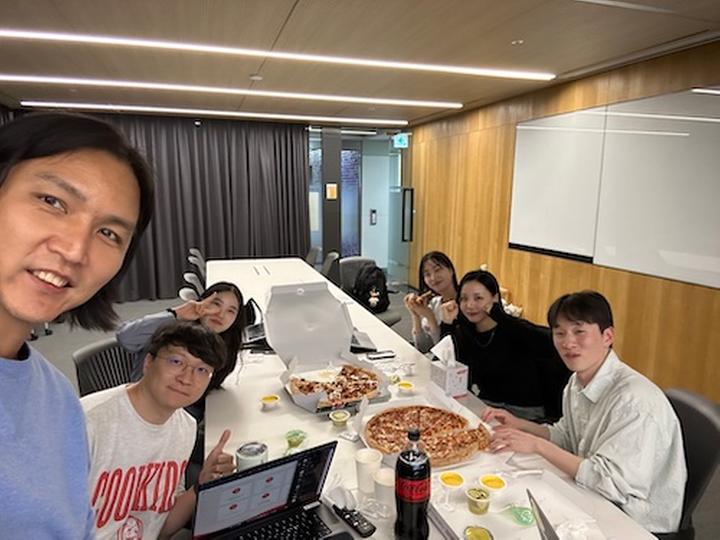
- OpenLab - Generative AI 스터디 1번째 모임
- 오픈랩 - Generative AI Study모임의 첫 모임을 4/29 가졌습니다. 처음이라, 미흡한 부분이 많았지만 7월까지 차근차근 진행하면 모두 좋은 결과 얻을거라 생각됩니다. 저희 모임은 6시에 판교 SK텔리콤 사옥에서 진행되었구요. 진행 내용은 다음과 같습니다. 팀원간 소개 고준석님의 Diffusion Model 발표 NCSN, DDPM, Diffusion Model beat GAN on Image Synthesis, Calssifere free guidance, Stable diffusion, ControlNet 등의 내용을 명확하게 소개하였습니다. 피자와 함께하는 토론 시간 다음 일정 / 스터디 목표 수립 최근 SORA의 발표로 비디오 생성모델에 관심...
-
- OpenLab - Knowledge Graph 6번째 모임
- 오픈랩 - 지식그래프 스터디의 거의 막바지에 이르렀습니다. 그동안 온라인, 오프라인 둘중 하나만 선택해서 진행했는데, 이번 모임은 하이브리드로 진행을 해보았습니다. 역시 하이브리드는 정말 고려할게 많아서 진행에 어려움이 많았지만, 그래도 시공간의 제약을 벗어나서 건설적인(?) 대화를 진행할 수 있다는 것은 무시못할 장점인 듯합니다. 오프모임에 참석하신 분들만 중간에 멈추고 식사를 진행해서 어수선함을 극복하는 것도 과제이긴 했습니다. 시간이 지날수록 처음부터 이렇게 진행할 것을 하는 생각에 끊임없이 우왕좌왕 하였지만, 다음과 같은 접근 방법을 통해 스터디에서 문제 해결 방법의 실마리를 찾아가게 되었다는 것도 소득이긴 합니다. 그 시기가 좀 늦긴했지만요. 무언가 근사...
-
- Advanced RAG Technique 기반 생성형AI 서비스 개발에 대한 연구 (1회차: 연구 여정의 첫걸음)
- 어제 Open Lab 1회차 모임을 가졌습니다. 앞으로 약 4개월간 "Advanced RAG Technique 기반 생성형AI 서비스 개발에 대한 연구" 를 주제로 연구모임을 진행하게 됩니다. 생각보다 너무 많은 분들이 신청을 주셨으나, 산업 현장에서 전문성을 바탕으로 과업을 수행하시는 4분의 직장인과 앞으로의 미래가 창창한 학생분들 6분으로 구성된 10명의 정예 멤버를 선정하였습니다. 먼저 Orientation을 통해 모임 개요를 살펴보고 개인별 소개를 통해 어색함을 푸는 시간을 가졌구요. 이어서 Host인 제가 "생성형AI와 RAG Motivation - LLM에 외부지식을 더하다" 라는 주제로 준비한 모임 첫번째 세션을 진행하였습니다. 저희 모임은 앞으로 약...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.