
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
Vector Database(Milvus) 도입 검토를 위한 Quick Start
- DEVOTEE 요약
- LangChain은 LLM 기반의 AI 대화형 채봇을 개발하면서, 세맨틱 검색과 RAG(retrieval-augmented generation) 기술을 활용하기 위해 Pinecone Vector DB 를 사용했습니다. 하지만, 서비스가 확장됨에 따라 Pinecone의 성능과 비용이 부담되어 오픈소스 기반의 Vector DB로 전환하기로 결정하였습니다. 이에, 다양한 옵션 중 성능이 검증되었으며, 클라우드 네이티브 환경에서 DevOps 가능한 Milvus를 선택하여 사용하게 되었습니다.
Milvus 빠르게 시작하기
소개
최근 LangChain 을 이용하여 LLM 기반의 AI 대화형 채봇을 개발하는 과정에서 Semantic search and RAG(retrieval-augmented generation) 기술을 활용하기 위해
Pinecone Vector DB LLM의 전두엽으로 활용했습니다.
Pinecone 은 간단히 테스트하는 수준에서는 문제가 없지만, 데이터의 양이 커지고 검색&쿼리 속도가 중요한 환경에서는 PaaS 기반의 서비스이기 때문에
비용&성능측면에서 부담으로 다가왔습니다.
따라서 DevOps 관점에서 Vector DB 를 오픈소스 기반으로 내재화하여 상용화에 대한 필요성을 느꼈고, Vector DB 비교/분석을 통해 여러 솔루션의 대안 중 Milvus를 선택했습니다.
Milvus를 선택한 가장 큰 이유는 업계에서 상용화 서비스를 위해 내재화하여 주요기능과 성능 측면에서 이미 검증 되었고,
또한 오픈소스 기반으로 내재화하여 Cloud Native 환경에서 DevOps 가능하기 때문입니다.
본 글에서는 Milvus 의 python SDK (PyMilvus) 를 활용하여 Milvus 주요기능에 대해 빠르게 테스트 할 수 있는 방법에 대해 소개하겠습니다.
사전지식
주요내용
Milvus 접속
Collection 생성
데이터 삽입
인덱스 생성
검색(Search) & 쿼리(Query) & 필터링(filter)
Pagination
하이브리드 검색
데이터(Entity) 삭제
Collection 삭제
사전작업
Milvus 를 테스트하기 위해서는 사전에 다음과 같은 환경이 미리 구성되어야 합니다.
Python 3 (3.7.1 or later)
Milvus 설치
Milvus 2.3.1 버전 설치를 위해 공식 사이트에서 이미 제공하는 Docker Compose 를 이용하여 편리하게 설치하여 테스트 진행합니다.
1. Milvus 다운로드
docker-compose yaml 파일 다운로드
wget https://github.com/milvus-io/milvus/releases/download/v2.3.1/milvus-standalone-docker-compose.yml -O docker-compose.ymldocker-compose.yaml 파일을 다운로드하여 Milvus 를 container 기반으로 쉽게 구축 가능합니다.
docker-compose.yaml 파일 내용을 살펴보면,
Milvus 를 위해 필요한 3개의 서비스 컨테이너 서비스 etcd, minio, milvus-standalone 에 대해 어떻게 서로 연동하여 동작해야 하는지 자세히 기술되어있고,
이 구성을 기반으로 Milvus 를 컨테이너 기반으로 쉽게 실행하여 테스트할 수 있습니다.
# docker-compose.yaml
version: '3.5'

services:
  etcd:
    container_name: milvus-etcd
    image: quay.io/coreos/etcd:v3.5.5
    environment:
      - ETCD_AUTO_COMPACTION_MODE=revision
      - ETCD_AUTO_COMPACTION_RETENTION=1000
      - ETCD_QUOTA_BACKEND_BYTES=4294967296
      - ETCD_SNAPSHOT_COUNT=50000
    volumes:
      - ${DOCKER_VOLUME_DIRECTORY:-.}/volumes/etcd:/etcd
    command: etcd -advertise-client-urls=http://127.0.0.1:2379 -listen-client-urls http://0.0.0.0:2379 --data-dir /etcd
    healthcheck:
      test: ["CMD", "etcdctl", "endpoint", "health"]
      interval: 30s
      timeout: 20s
      retries: 3

  minio:
    container_name: milvus-minio
    image: minio/minio:RELEASE.2023-03-20T20-16-18Z
    environment:
      MINIO_ACCESS_KEY: minioadmin
      MINIO_SECRET_KEY: minioadmin
    ports:
      - "9001:9001"
      - "9000:9000"
    volumes:
      - ${DOCKER_VOLUME_DIRECTORY:-.}/volumes/minio:/minio_data
    command: minio server /minio_data --console-address ":9001"
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:9000/minio/health/live"]
      interval: 30s
      timeout: 20s
      retries: 3

  standalone:
    container_name: milvus-standalone
    image: milvusdb/milvus:v2.3.1
    command: ["milvus", "run", "standalone"]
    environment:
      ETCD_ENDPOINTS: etcd:2379
      MINIO_ADDRESS: minio:9000
    volumes:
      - ${DOCKER_VOLUME_DIRECTORY:-.}/volumes/milvus:/var/lib/milvus
    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:9091/healthz"]
      interval: 30s
      start_period: 90s
      timeout: 20s
      retries: 3
    ports:
      - "19530:19530"
      - "9091:9091"
    depends_on:
      - "etcd"
      - "minio"

networks:
  default:
    name: milvus
2. Milvus 실행
다운로드 받은 docker-compose.yaml 파일을 이용하여 Milvus 를 실행합니다.
docker compose up -dCreating milvus-etcd ... done
Creating milvus-minio ... done
Creating milvus-standalone ... done이후 docker compose 명령어를 통해 각 컨테이너 서비스들의 실행결과를 확인할 수 있습니다.
$ docker compose ps
NAME                IMAGE                                      COMMAND                  SERVICE             CREATED             STATUS                 PORTS
milvus-etcd         quay.io/coreos/etcd:v3.5.5                 "etcd -advertise-cli…"   etcd                22 hours ago        Up 5 hours (healthy)   2379-2380/tcp
milvus-minio        minio/minio:RELEASE.2023-03-20T20-16-18Z   "/usr/bin/docker-ent…"   minio               22 hours ago        Up 5 hours (healthy)   0.0.0.0:9000-9001->9000-9001/tcp
milvus-standalone   milvusdb/milvus:v2.3.1                     "/tini -- milvus run…"   standalone          22 hours ago        Up 5 hours (healthy)   0.0.0.0:9091->9091/tcp, 0.0.0.0:19530->19530/tcp
3. 접속테스트
Milvis-standalone 에서 제공하는 컨테이너의 서비스 포트 0.0.0.0:19530->19530/tcp 에 대해 접속 테스트를 진행합니다.
docker port milvus-standalone 19530/tcpPython 설치 (옵션)
python (> 3.7.1) 이상의 버전이 설치되어 있을 경우 아래 과정은 생략해도 됩니다.
만약 설치가 필요한경우, 파이썬 관리도구 pyenv를 통해 설치 관리가 가능하고, 이후 pipenv 이용하여 각 파이썬 버전별 virtualenv 환경을 구성하고
그 가상환경 안에서 필요한 파이썬 패키지를 설치하여 효율적으로 프로젝트를 관리할 수 있습니다.
1. pyenv 설치
brew 를 이용하여 pyenv 를 설치합니다.
$ brew install pyenv~/.zshrc 편집
if command -v pyenv 1>/dev/null 2>&1; then
  eval "$(pyenv init -)"
fi
PATH=$(pyenv root)/shims:$PATH
zsh 재시작하여 pyenv 설정을 활성화 합니다.
exec zshpyenv 정상동작 확인을 위해 현재 설치된 파이썬 버전을 확인합니다.
$ pyenv versions
  system
* 3.10.0 (set by /Users/xxxxxx/.pyenv/version)
  3.10.0/envs/gstt
2. python 설치
pyenv 이용하여 내가 원하는 특정 파이썬 버전 설치가 가능합니다. 여기서는 python 3.10.0 버전을 설치합니다.
pyenv install 3.8.10python 버전이 정상설치 여부를 확인합니다.
$ pyenv versions
system
*** 3.10.0 (set by /Users/xxxxxx/.pyenv/version)**
3. pipenv 설치
이 항목은 옵션으로써 pipenv 도구를 통해 특정 파이썬 버전을 이용하여 가상환경(virtualenv)를 생성하고,
이 공간에 나에게 필요한 파이썬 패키지(e.g: PyMilvus)를 설치하여 효율적으로 프로젝트를 관리할 수 있습니다.
pipenv 설치
$ brew install pipenv
$ brew upgrade pipenv
위에서 설치한 python 1.10.0 버전을 이용하여 파아썬 가상환경 생성
pipenv --python 1.10.0만약 현재 디렉토리(./milvus)에서 가상환경이 정상적으로 설치가 되었으면 shell prompt 에 다음과 같이 milvus-XXXX(e.g: milvus-rPlMn7vE) 형식의 가상환경 이름이 활성화 된것을 확인할 수 있습니다. 저의 맥 개발환경의 경우 zsh 의 여러 플러그인으로 프롬프트에 다양한 정보들이 포함되어 있지만, 대부분의 경우 심플하게 milvus-xxxxx 와 같이 나만의 파이썬 가상환경 이름을 확인할 수 있습니다.
devot on main [!] via 🐍 3.10.0 via **milvus-rPlMn7vE** at ☸️ admin@syshome (gitlab-runner) PyMilvus 설치
1. pipenv 이용한 설치방법
Milvus 에서 제공하는 PyMilvus(Python Milvus SDK) pipenv 도구를 이용하여 설치합니다.
$ pipenv install pymilvus이후, 해당 프로젝트 루트 디렉토리에 Pipfile 확인이 가능하며, 열어보면 pymilvus 패키지 안에 있는 모든 모듈이 설치된 것을 확인할 수 있습니다.
# Pipfile
[[source]]
url = "https://pypi.org/simple"
verify_ssl = true
name = "pypi"

[packages]
...
requests = "*"
**pymilvus = "*"**

[dev-packages]

[requires]
python_version = "3.11"
python_full_version = "3.11.0"
2. pip 이용한 설치 방법
pip 패키지 도구를 이용하여 다음과 같이 설치 가능합니다.
python3 -m pip install pymilvus==Milvus 빠른시작
테스트를 진행할 프로젝트 루트 경로명에 Milvus 를 빠르게 테스트하기 위한 샘플 코드를 다운로드 합니다.
이후 해당 코드를 기반으로 Milvus 의 주요기능을 살펴보겠습니다.
wget https://raw.githubusercontent.com/milvus-io/pymilvus/master/examples/hello_milvus.pyPyMilvus 패키지
import pymilvus 모듈
from pymilvus import (
    connections,
    utility,
    FieldSchema,
    CollectionSchema,
    DataType,
    Collection,
)
pymilvus 패키지 주요기능
connections: Milvus 네트워크 접속 기능 제공
utility: Milvus 주요 리소스(Collection, Index, User ..)를 관리하기 위한 유틸리티 기능 제공
FieldSchema: Collection의 각 필드 타입(VarChar, Double, FloatVector..)을 정의하기 위한 스키마
CollectionSchema: 여러개의 필드를 하나의 Row Document 로 관리하기 위한 스키마
DataType: 각 필드의 데이터타입을 정의
Collection: RDB의 테이블과 비슷한 스키마를 기반으로 데이터를 저장하는 공간
PyMilvus 접속
docker compose 명령어를 통해 3개의 MSA 기반의 서비스들이 동작하고 있고,
그 중 milvus-standalone 서비스 포트 19530 포트에 다음과 같이 connection 모듈을 통해 접속 가능합니다.
connections.connect("default", host="localhost", port="19530")Collection 생성
Collection 은 전통적인 RDB(MySQl, MSSQL..) 에서의 테이블과 비슷한 개념입니다.
따라서 Collection 에 데이터를 저장하기 위해서는 기본적인 스키마 구조 설계가 필요하고, 각 Collection 에 저장될 하나의 Document 에 대한 각 데이터의 필드스키마 정의가 필요합니다.
# We're going to create a collection with 3 fields.
# +-+------------+------------+------------------+------------------------------+
# | | field name | field type | other attributes |       field description      |
# +-+------------+------------+------------------+------------------------------+
# |1|    "pk"    |   VarChar  |  is_primary=True |      "primary field"         |
# | |            |            |   auto_id=False  |                              |
# +-+------------+------------+------------------+------------------------------+
# |2|  "random"  |    Double  |                  |      "a double field"        |
# +-+------------+------------+------------------+------------------------------+
# |3|"embeddings"| FloatVector|     dim=8        |  "float vector with dim 8"   |
# +-+------------+------------+------------------+------------------------------+
본 샘플 예제에서는 위 Collection Schema 구조를 기반으로 Collection(hello_milvus) 를 생성했습니다.
fields = [
    FieldSchema(name="pk", dtype=DataType.INT64, is_primary=True, auto_id=False),
    FieldSchema(name="random", dtype=DataType.DOUBLE),
    FieldSchema(name="embeddings", dtype=DataType.FLOAT_VECTOR, dim=8)
]
schema = CollectionSchema(fields, "hello_milvus is the simplest demo to introduce the APIs")
hello_milvus = Collection("hello_milvus", schema)
Collection 데이터 삽입
위에서 생성한 Collection의 스키마 구조에 맞게 3000개의 random 샘플링 데이터를 삽입하겠습니다.
import random
entities = [
    [i for i in range(3000)],  # field pk
    [float(random.randrange(-20, -10)) for _ in range(3000)],  # field random
    [[random.random() for _ in range(8)] for _ in range(3000)],  # field embeddings
]
insert_result = hello_milvus.insert(entities)
hello_milvus.flush()
Collection 에 저장될 데이터셋을 entities 집합으로 정의하였고, 각 entity 는 Collection 스키마의 데이터 타입에 맞게 구성하여 삽입합니다.
여기서는 3000개의 데이터에 대해 각 데이터 필드 pk, random, embeddings 에 들어갈 데이터를 random 함수를 통해 중복되지 않도록 샘플링 했습니다.
pk 필드값은 auto_id=False 로 설정되어 자동 증분하지 않고, 임의로 시퀀스한 숫자 0 ~ 2999 값 3000개를 넣어주었고,
random 필드값은 random 함수로 double 값으로 샘플링하여 유니크한 값으로 넣어주었습니다.
마지막으로 가장 중요한 embedding 필드는 float 타입의 8차원 값을 Array 형태로 넣어주었습니다.
여기서 중요한 것은 원천데이터를 별도 embedding 모델을 통해 벡터화 하지 않고, random 함수를 이용하여 샘플링된 float 타입의 dim(8차원) 데이터를 테스트 데이터로 활용하는 과정을 이해하는 것입니다.
최종적으로 구성된 3000개의 데이터(entities) 를 Collection(hello_milvus) 에 삽입하고, flush 하여 마무리 합니다.
Index 생성
위에서 생성한 Collection 을 Index에 맵핑하여 Search & Query 에 필요한 검색 알고리즘에 활용합니다.
여기서는 위에서 생성한 Collection(hello_milvus)을 위해 IVF_FLAT 타입의 Index(embedding)를 생성합니다.
print(fmt.format("Start Creating index IVF_FLAT"))
index = {
    "index_type": "IVF_FLAT",
    "metric_type": "L2",
    "params": {"nlist": 128},
}

hello_milvus.create_index("embeddings", index)
Milvus에서는 유사성 메트릭을 사용하여 벡터 간의 유사성을 측정합니다.
좋은 거리 측정법을 선택하면 분류 및 클러스터링 성능이 크게 향상됩니다.
본 예제 샘플 코드에서 확인할 수 있듯이 embeddings 필드(type=float, dim=8)와 같이 Floating Point embeddings 에 적용할 수 있는
Similarity Metric과 Index Type 을 하단 그림을 통해서 확인 가능합니다.
위 샘플코드에서는 사용한 인덱스 생성 방법은 다음과 같습니다.
index_type: IVF_FLAT (VF_FLAT divides vector data into
nlistcluster units)metric_type: L2 (Euclidean Distance)
params
nlist: number of cluster unit (1~65536, default=128)
Similarity Metric
Index Loading & Similarity Search
hello_milvus.load()
vectors_to_search = entities[-1][-2:]
search_params = {
    "metric_type": "L2",
    "params": {"nprobe": 10},
}
result = hello_milvus.search(vectors_to_search, "embeddings", search_params, limit=3, output_fields=["random"])
hello_milvus.load() 로딩 함수를 이용하여 collection 데이터를 메모리에 로딩하고, 이후 임베딩한 데이터 vectors_to_search 값을 milvus 에서 유사도 검색합니다.
vectors_to_search 값은 entities 리스트 구조에서 맨 마지막에 있는 embeddings 데이터 리스트 구조에서 마지막 끝에 있는 데이터 2개(entities[-1][-2:])를 의미합니다.
vectors_to_search
array([
[0.64756871, 0.01197686, 0.5924749 , 0.80828321, 0.70348865, 0.27177397, 0.90567045, 0.67848907],
[0.31415601, 0.15629844, 0.85363175, 0.77644426, 0.0821534, 0.07103991, 0.25484217, 0.46181565]
])
또한 search_params 값으로 유사도 메트릭은 L2를 이용하고, nprobe: 10 개로 설정하여 nlist 에서 설정한 클러스터 128개(default) 중에서
가장 가까운 클러스터 10개를 방문하여 검색을 수행하고, top-k 개를 가져옵니다.
search_params 을 이용하여 output_fields 로 random 필드값을 가져오고, limit=3 으로 설정하여 검색결과 중
스코어링하여 소팅한 것 중 상위 Top 3개만 가져오도록 pagination 합니다.
검색결과 확인
for hits in result:
    for hit in hits:
        print(f"hit: {hit}, random field: {hit.entity.get('random')}")
vectors_to_search 에 검색하고자 하는 벡터 2개와 가장 유사한 벡터 레코드를 각각 3개씩 가져온 결과를 아래와 같이 확인 가능합니다.
하단 검색결과에서 첫번째 검색결과 3개는 첫번째 벡터에 대한 검색결과이고, 그 다음 나머지 3개는 2번째 벡터에 대한 검색결과입니다.
검색 결과값 id(2998)은 distance: 0.0 으로 첫번째 벡터 검색과 유사도가 정확히 일치함을 확인할 수 있고, 그 다음 유사도가 높은 순으로 id(1262), id(1265) 레코드를 확인할 수 있습니다.
또한 벡터 검색하는데 소요된 시간 Latency (0.1795s) 값을 확인할 수 있습니다.
=== Start searching based on vector similarity ===

hit: id: 2998, distance: 0.0, entity: {'random': 0.9728033590489911}, random field: 0.9728033590489911
hit: id: 1262, distance: 0.08883658051490784, entity: {'random': 0.2978858685751561}, random field: 0.2978858685751561
hit: id: 1265, distance: 0.09590047597885132, entity: {'random': 0.3042039939240304}, random field: 0.3042039939240304
hit: id: 2999, distance: 0.0, entity: {'random': 0.02316334456872482}, random field: 0.02316334456872482
hit: id: 1580, distance: 0.05628091096878052, entity: {'random': 0.3855988746044062}, random field: 0.3855988746044062
hit: id: 2377, distance: 0.08096685260534286, entity: {'random': 0.8745922204004368}, random field: 0.8745922204004368

search latency = 0.1795s
Filtering & Query
백터 공간에서 유사도 기반 알고리즘을 기반으로 가장 유사한 가까운 데이터를 Scoring&Sotring 검색할 수도 있지만,
정확히 벡터 값이 아닌 일반 필드 값 기준으로 고전적인 SQL 문법과 비슷하게 Filter & Query 할 수 있는 방법도 가능합니다.
print(fmt.format("Start querying with `random > 0.5`"))

start_time = time.time()
result = hello_milvus.query(expr="random > 0.5", output_fields=["random", "embeddings"])
end_time = time.time()

print(f"query result:\n-{result[0]}")
print(search_latency_fmt.format(end_time - start_time))
위 쿼리는 random 필드 값이 > 0.5 이상인 모든 데이터를 필터링하여 데이터를 가져오고,
결과값 중 첫번째 데이터(result[0])에 대한 random, embeddings 2개의 필드만 가져와서 출력합니다.
출력 결과를 확인해보면 다음과 같습니다.
=== Start querying with `random > 0.5` ===

query result:
-{'random': 0.6378742006852851, 'embeddings': [0.20963514, 0.39746657, 0.12019053, 0.6947492, 0.9535575, 0.5454552, 0.82360446, 0.21096309], 'pk': '0'}
search latency = 0.4640s
Pagination
벡터 쿼리에 대한 출력 레코드에 대한 Pagination 을 위해 offset, limit 파라미터 값을 이용하여 원하는 특정 영역의 레코드를 가져올 수 있습니다.
예를 들어 100개의 레코드를 각 페이지당 10개의 레코드로 관리하고, 2번째 페이지를 가져오고 싶은 경우 offset=11, limit=10 으로 설정하여 Pagination 이 가능합니다.
# pagination
r1 = hello_milvus.query(expr="random > 0.5", limit=4, output_fields=["random"])
r2 = hello_milvus.query(
    expr="random > 0.5", offset=1, limit=3, output_fields=["random"]
)
print(f"query pagination(limit=4):\n\t{r1}")
print(f"query pagination(offset=1, limit=3):\n\t{r2}")
위 코드는 limit=4 인 경우와, offset=1 && limit=3 으로 설정하여 쿼리 결과값을 비교하기 위한 코드입니다.
offset=1, limit=3 쿼리 결과값의 경우 offset=1 을 기준으로 pagination 하기 때문에 {'pk': '0', 'random': 0.6378742006852851} 레코드는 제왿된 것을 확인할 수 있습니다.
# limit=4
uery pagination(limit=4):
        [
					{'pk': '0', 'random': 0.6378742006852851},
					{'pk': '100', 'random': 0.5763523024650556},
					{'pk': '1000', 'random': 0.9425935891639464},
					{'pk': '1001', 'random': 0.7893211256191387}
				]

# offset=1, limit=3
query pagination(offset=1, limit=3):
        [
					{'pk': '100', 'random': 0.5763523024650556},
					{'pk': '1000', 'random': 0.9425935891639464},
					{'pk': '1001', 'random': 0.7893211256191387}
				]
Hybrid Search
검색(Search), 쿼리(Query)를 하이브리드 형태로 활용 가능합니다. 아래와 같이 search() 함수에 검색&쿼리에 필요한 정보를 파라미터로 넣어 검색 수행이 가능합니다.
vector_to_search: 검색하고자 하는 벡터 데이터
embeddings: 검색할 인덱스
search_params: 검색 파라미터정보
limit: 각 검석 데이터에 대한 결과 레코드 최대값 설정
expr: query &filter 에 필요한 표현
output_field: 검색 결과에서 출력되는 필드값 정의
# hybrid search
print(fmt.format("Start hybrid searching with `random > 0.5`"))

start_time = time.time()
result = hello_milvus.search(
    vectors_to_search,
    "embeddings",
    search_params,
    limit=3,
    expr="random > 0.5",
    output_fields=["random"],
)
end_time = time.time()

for hits in result:
    for hit in hits:
        print(f"hit: {hit}, random field: {hit.entity.get('random')}")
print(search_latency_fmt.format(end_time - start_time))
하이브리드 검색 결과를 다음과 같이 확인할 수 있습니다.
=== Start hybrid searching with `random > 0.5` ===

hit: id: 2998, distance: 0.0, entity: {'random': 0.9728033590489911}, random field: 0.9728033590489911
hit: id: 747, distance: 0.14606498181819916, entity: {'random': 0.5648774800635661}, random field: 0.5648774800635661
hit: id: 2527, distance: 0.1530652642250061, entity: {'random': 0.8928974315571507}, random field: 0.8928974315571507
hit: id: 2377, distance: 0.08096685260534286, entity: {'random': 0.8745922204004368}, random field: 0.8745922204004368
hit: id: 2034, distance: 0.20354534685611725, entity: {'random': 0.5526117606328499}, random field: 0.5526117606328499
hit: id: 958, distance: 0.21908017992973328, entity: {'random': 0.6647383716417955}, random field: 0.6647383716417955
search latency = 0.4039s
Delete Entities
###############################################################################
# 6. delete entities by PK
# You can delete entities by their PK values using boolean expressions.
ids = insert_result.primary_keys

expr = f'pk in ["{ids[0]}" , "{ids[1]}"]'
print(fmt.format(f"Start deleting with expr `{expr}`"))

result = hello_milvus.query(expr=expr, output_fields=["random", "embeddings"])
print(f"query before delete by expr=`{expr}` -> result: \n-{result[0]}\n-{result[1]}\n")

hello_milvus.delete(expr)

result = hello_milvus.query(expr=expr, output_fields=["random", "embeddings"])
print(f"query after delete by expr=`{expr}` -> result: {result}\n")
index 스키마 구조에서 pk 필드에 시퀀스 넘버 (0~2999) 값을 넣어 float point 값을 임베딩 데이터로 활용하여 collection 에 저장했습니다.
데이터가 로딩되어 메모리에 적재된 상황에서 위 코드를 통해 특정 pk 필드값(ids[0], ids[1])의 entity 를 삭제하는 방법을 보여주고 있습니다.
아래와 같이 실행결과를 확인해보면 ids[0], ids[1] 데이터에 대해 entity 삭제를 수행하여 삭제하기 전/후 데이터를 출력을 통해 비교할 수 있습니다.
삭제 이후 ids[0], ids[1]에 대한 쿼리 데이터 결과값이 없는 것을 확인할 수 있습니다.
=== Start deleting with expr `pk in ["0" , "1"]` ===

query before delete by expr=`pk in ["0" , "1"]` -> result:
-{'pk': '0', 'random': 0.6378742006852851, 'embeddings': [0.20963514, 0.39746657, 0.12019053, 0.6947492, 0.9535575, 0.5454552, 0.82360446, 0.21096309]}
-{'pk': '1', 'random': 0.43925103574669633, 'embeddings': [0.52323616, 0.8035404, 0.77824664, 0.80369574, 0.4914803, 0.8265614, 0.6145269, 0.80234545]}

query after delete by expr=`pk in ["0" , "1"]` -> result: []
Delete Collection
PyMilvus 에서 제공하는 uility 모듈의 drop_collection 함수를 이용하여 특정 collection을 삭제할 수 있습니다.
삭제 이후, 특정 collection(hello_milvus)이 존재하는지 체크 가능하며, 모든 collection을 출력하여 삭제 정상여부를 확인할 수 있습니다.
sysmoon 님의 최신 블로그
더보기-
- 멀티모달 기반 AI 챗봇 기술 연구&개발 (6회차, Dify & Morphik MCP 연동테스트 방법)
- 소개 DEVOCEAN OpenLab 2025 프로젝트의 일환으로 진행된 '멀티모달 기반 AI 챗봇 기술 연구 및 개발' 중 Dify와 Morphik MCP(Model Context Protocol) 연동 테스트 결과를 자세히 공유합니다 [i]. 이 글은 MCP가 무엇인지부터 실제 연동 과정에서 발생한 기술적 문제, 그리고 성능 분석을 통해 얻은 향후 개선 방향을 소개합니다. 세미나 발표자료 파일 첨부하여 드립니다. (Dify & Morphik MCP 연동테스트 결과) 1. AI와 외부 도구 연결의 핵심: MCP(Model Context Protocol)란? AI 모델이 단순히 질문에 답하는 것을 넘어 외부 서비스나 도구를 활용하려면 표준화된 통신 방식이 필요합니다...
-
- 멀티모달 기반 AI 챗봇 기술 연구&개발 (5회차, Agno로 에이전트 구축하기)
- 안녕하세요! 이번 포스팅에서는 에이전트 오케스트레이션(Agent orchestration)에 특화된 Agent 프레임워크 Agno에 대해 소개합니다. Agent Framework TOP 5 에 속하지는 않지만, Agno 의 발전속도와 미래를 보면 LangGraph 와 같이 사용할 경우 큰 시너지를 낼 수 있다고 생각합니다. 각자의 상황에 맞게 전략적으로 활용해보시면 좋을 것 같습니다. 첨언하면 아시는 분은 아시겠지만 Agno 는 Phidata 프로젝트에서 시작해서 Agno 로 새롭게 브랜딩 된 프로젝트 입니다. Phidata 를 유심히 지켜보신 분들은 아마 Agno 의 멀티에이전트 철학에 대해 이해하고 쉽게 접근하실 수 있을 것입니다. Agno (Agent Fra...
-
- 멀티모달 기반 AI 챗봇 기술 연구&개발 (4회차, VLM(ColPali) & MUVERA 기술 소개)
- 오늘은 Morphik(Multimodal Agent Framework) 에 대해 소개하고, 이 기술의 핵심인 VLM 을 이용하여 문서 청킹/파싱 과정 없이 시각적으로 맥락을 이해하기 위한 ColPali 와 멀티벡터를 빠르게 인덱싱&검색하기 위한 MUVERA 기술에 대해 소개합니다. Morphik의 핵심 기술 심층 분석 (ColPali & MUVERA) Morphik은 복잡한 문서(PDF, 이미지)를 정확하고 빠르게 검색하기 위해 설계된 멀티모달 프레임워크이며, 특히 전통적인 RAG 시스템의 한계였던 시각 정보 처리 및 멀티 벡터 검색 속도 문제를 해결하는 데 중점을 둡니다. 1. ColPali: 시각적 맥락을 이해하는 멀티모달 검색 엔진 ColPali는 ColBE...
-
- Morphik - 멀티모달티를 위한 ColPali와 MUVERA 기술에 대하여
- 목차 서론 ColPali MUVERA 1. 서론 지난글애서는 Morphik - 멀티모달티를 위한 RAG에서 문서 파싱 없이 이미지를 사용하는 방법 에 대해서 소개했고, 오늘은 이어서 Morphik 을 이용한 멀티 모달 기반 문서 검색 시스템의 핵심 기술인 ColPali & MUVERA & Late Interaction 개념에 대해 자세히 소개합니다. 우리가 흔히 사용하는 텍스트 추출 기반 RAG는 꽤 똑똑하지만, 현실에서는 몇 가지 아쉬움이 있습니다. PDF를 파싱하거나 OCR, 캡처링을 거치면서 중요한 정보가 사라지거나 오류가 생기기 쉽습니다. 문서를 제대로 다루려면 복잡한 전처리 과정이 필요하고, 시간과 비용이 상당히 소요됩니다. 결국, 단순 텍스트만 활용하는...
DEVOTEE 추천 블로그
-
- LangChain LCEL과 RAGAS를 사용한 Native RAG 평가
- LangChain LCEL을 사용해서 Native RAG를 구현하고 RAGAS library를 사용해 평가를 진행해보겠습니다. 최근에 LangChain에 추가된 LCEL과 새로운 package 구조도 체험해보고, RAG 평가를 손쉽게 도와주는 RAGAS도 한번에 확인해보려고 합니다. 코드 예제는 Nayak님의 Medium 글을 참고하면서, 최신 LangChain 버전에 맞게 코드를 일부 업데이트 하였습니다. Azure LLM 과 Embedding 초기화 import os from langchain_openai import AzureChatOpenAI from langchain_openai import AzureOpenAIEmbeddings embeddings = ...
-
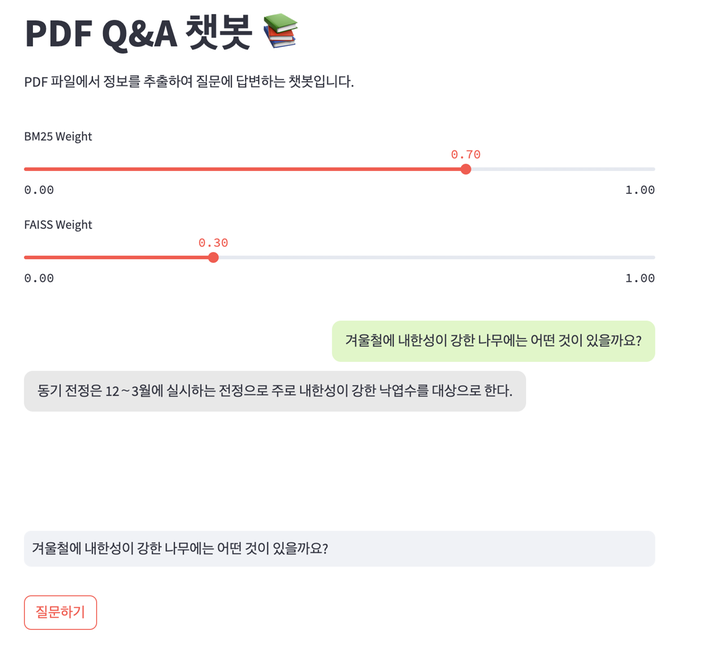
- OpenLab - OpenLLM, Ensemble Retriever(pre), Rerank(post)가 적용된 RAG 챗봇 구현하기
- OpenLLM 스터디 모임 경과를 정리하면서 현재까지 구현된 RAG 챗봇 내용을 함께 공유드립니다. 스터디 모임 경과 - 주제 : OpenLLM 스터디 4차 오프라인 모임 - 일시 : 6/19 20:00 ~ 21:00 - 장소 : 판교사옥 - 참석 : 멤버 7명 중 4명 10명에서 3명 탈퇴(1명:이직, 2명:업무변경) - 스터디 내용 1) RAG 에서 Pre/Post Retriever 코드 구현 공유 및 의견 교환 2) RAG 평가 ragas 공유 3) 다음 스터디까지 제출 코드(파이썬 가상환경 requirements 포함) openllm 별도 로딩 및 서비스 시작 파일 업로드: 질문에 답변할 문서 데이터셋(pdf)을 업로드 Splitter: 업로드된 파일을 분...
-

- 에이닷 RAG 기능 개발을 위한 Qdrant 벡터 DB 구축 (from source tarball)
- 에이닷에서 파인튜닝을 통해 각 도메인별 특화 데이터를 추가 학습시켜 맞춤형 모델을 만들고 있지만 실시간으로 업데이트 되는 동적인 데이터에 대한 대응 그리고 할루시네션 억제, 모델 외부 데이터의 대한 접근을 위해서는 RAG 기능 활용하는게 옳은 선택이라고 합니다. RAG 기능 구현에 있어 VectorDB는 필수 솔루션이며, 여러 VectorDB 중에서 현재 플랫폼에서 스테이징으로 이용하고 있는 Qdrant 구축 내용을 공유하고자 합니다. 일반적인 Cloud 솔루션, Kubernetes , Docker 방식이 아닌 정통(?) 방식의 source tarball를 이용한 컴파일 및 Qdrant Cluster 구성방식 입니다. On-premise에서 Qdrant 구축 방법...
-

- RAG 시대, Vector DB 비교 가이드: Vespa vs Milvus vs Qdrant
- 0. 개요 요즘 RAG(Relevant Augmented Generation)가 트렌드로 자리 잡으면서, 이를 구현하기 위한 핵심 기술인 벡터 검색에 대한 관심도 높아지고 있습니다. 다양한 Vector Database 들이 등장하고 있는 가운데, 각각의 특징을 직접 비교해보며 더 깊이 있게 이해해보고, 실무에 활용할 Database 선택에 참고될 만한 내용들을 정리해 보고자 합니다. Vector Search? 전통적인 키워드 기반 검색이 문자 단위의 단순 매칭에 집중했다면, 벡터 검색은 데이터의 의미론적 유사도를 기반으로 더욱 정확하고 직관적인 검색 결과를 제공합니다. 텍스트뿐 아니라 이미지·오디오·행동 패턴 등 다양한 형태의 비정형 데이터를 빠르게 분석하고 검색...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.