
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
텍스트 마이닝과 워드클라우드를 사용해서 키워드 한눈에 파악하기
블로그 목적
R언어을 사용한 텍스트 마이닝과 워드클라우드 통해서 글 속의 주요 키워드를 손쉽게 파악해본다.
블로그 요약
텍스트 마이닝에 대해서 간단하게 알아본다.
워드클라우드를 만드는 방법을 알아본다.
텍스트마이닝과 워드클라우드 통해서 글의 주요키워드를 분석해 본다.
블로그 상세 내용
우선, 텍스트 마이닝(Text mining)에 대해서 한마디로 간단하게 정리해보자면요.
텍스트 마이닝 : 문자로 된 데이터에서 가치있는 정보를 얻어내는 분석기법을 말합니다.
그럼 텍스트 마이닝을 하려면 어떻게 해야 할까요?
우선, 문장을 구성하는 어절들이 어떤 품사로 되어 있는지 파악을 해야 하는데요...
이것을 우리는 보통 "형태소 분석(Morphology Analysis)" 이라고 말을 하곤 하지요...
다시말해서, 형태소 분석으로 어절들의 품사를 파악한 후 명사,동사, 형용사 등 의미를 지닌 품사의 단어들을 추출해 각 단어가 얼마나 많이 등장했는지 확인하면 되고요..
(텍스트 마이닝을 이용해서 SNS 나 웹사이트에 올라온 글을 분석하면 사람들이 어떤 이야기를 나누고 있는 한눈에 파악할 수 있습니다. )
블로그글도 한눈에 키워드로 파악할 수 있겠죠?? ^^;
그럼, 저와함께 텍스트 마이닝을 하기 위해서 초기 작업을 차근차근 준비해 볼까요?
우선, 한글 자연어 분석 패캐지가 필요한데요...
KoNLP(Korean Natural Language Processing)을 이용하면 한글 데이터로 형태소 분석이 가능합니다.
참고로, KoNLP는 Java 가 설치되어 있어야 사용할 수 있다는 사실 머릿속에 넣어두시고요..
만약 Java가 설치가 안되어 있으신 분께서는 꼭 Java 를 설치하시고 해당 블로그의 내용을 같이 시작하시길 추천 드립니다.
Java 설치는 아래 페이지에서 하시면 되고요..
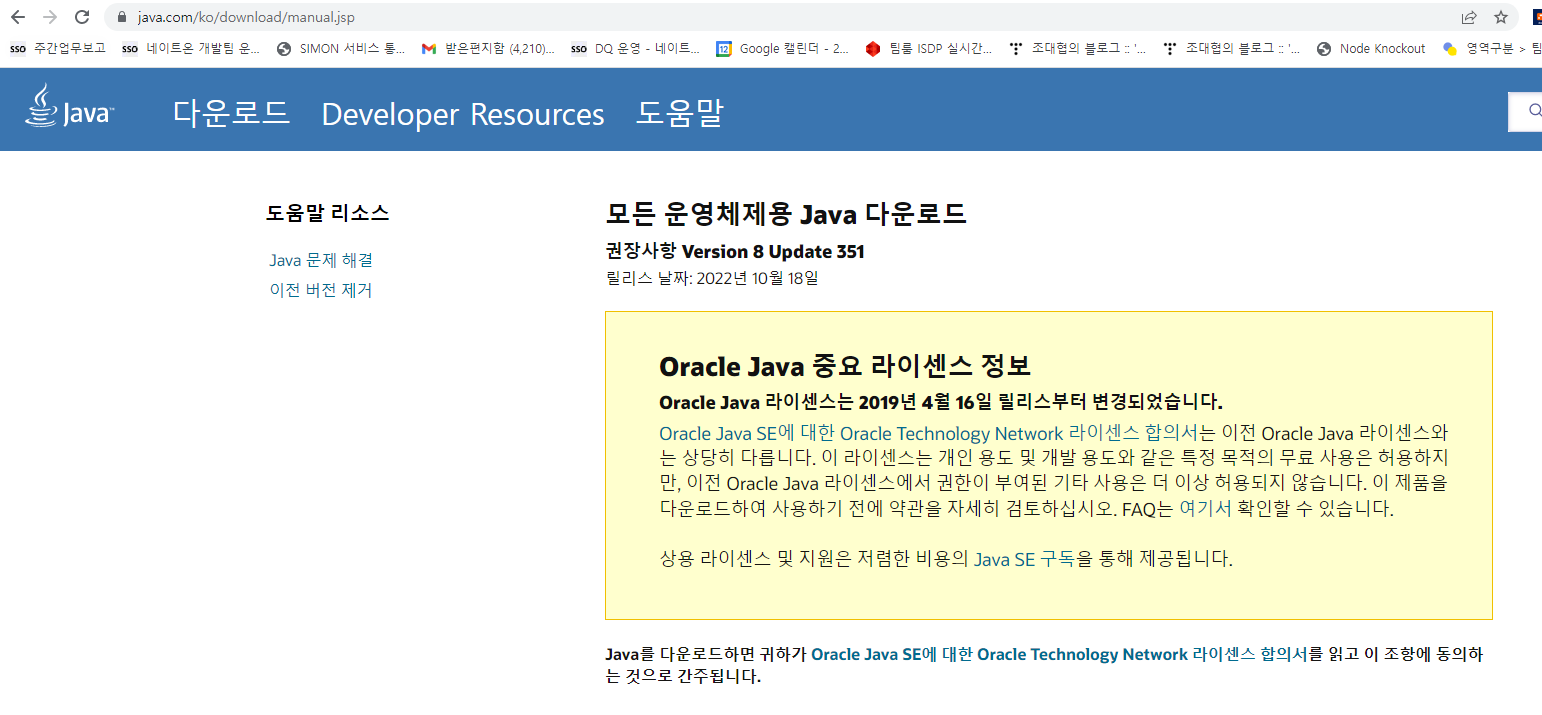
(이제 모두 Java가 설치되었다는 가정하에 다음 글을 이어나가보겠습니다. ㅎㅎ)
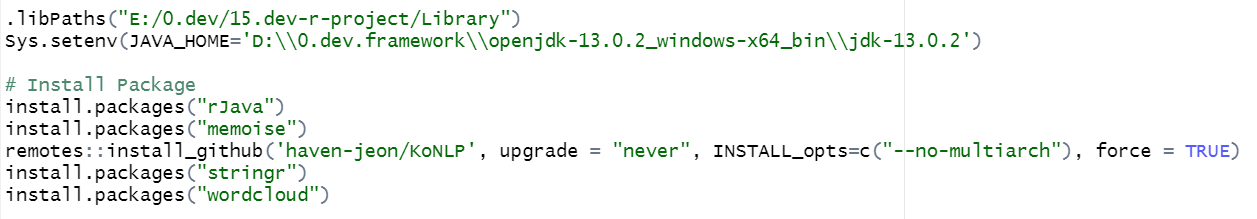
그리고, KoNLP 를 사용하려면 아래 패키지가 설치되어 있어야 합니다.
- rJava 패캐지
- memoise 패캐지
위의 두 패캐지를 꼭 설치하신후에 KoNLP 를 설치하시고요...
KoNLP 가 설치되셨으면, 워드 클라우드를 사용하기 위해서 wordcloud 패캐지 도 같이 설치합니다.
워드클라우드 : 많은 데이터들 중에서 특정한 키워드가 얼마나 더 중요한지 임팩트 있게 보여주는 것을 말한다고 머릿속에 넣어두시면 될것 같네요..
KoNLP 와 wordcloud 패키지 설치는 아래와 같이 진행하시면 됩니다.
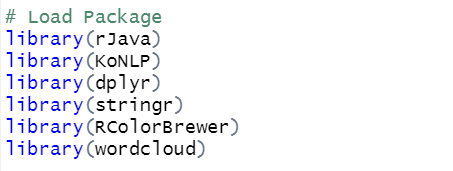
그리고, 설치를 했으니 패캐지를 사용하려면 당연히 로드 해야 겠죠?
(로드는 아래와 같이 하시면 됩니다. )
정말 간단하죠!! ㅎㅎ
아마도 궁금하실텐데요....지금까지 로드한 패캐지가 무엇을 뜻하는거지? 라고요..
그럼, 이제까지 로드한 주요 패캐지에 대해서 간단하게 설명드려볼께요 ㅎㅎ
우선, rJava 패키지는 java의 풍부한 생태계를 R에서 사용하기 위해 꼭 필요한 인터페이싱 패키지입니다.
비슷한 부류로 python의 reticulate, C++의 Rcpp 등이 있죠.
(참고로, 모두 각각의 언어를 설치하고 경로 설정을 해줘야 하는 단계를 가지고 있습니다. 이 부분 머릿속에 넣어두시고요..)
그리고 dplyr 패캐지는 전처리 작업에 사용하려고 합니다.
한마디로, dplyr 패키지는 Hadley Wickham가 작성한 데이터 처리에 특화된 R 패키지라고 머릿속에 넣어두시면 되고요..
이어서, stringr 이라는 패캐지가 눈에 들어오실텐데요...
stringr 패캐지는 특수문자를 제거하기 위해서 사용하는데요.
만약 문장에 이모티콘이나 특수문자가 포함되어 있으면 오류가 발생할 수 있겠죠??
(그래서 해당 패키지를 통해서 특수문자제거작업을 할 예정입니다. )
마지막으로 RColorBrewer 는 색조를 사용해서 시각적으로 표현할 때 사용하는 패키지라고 머릿속에 넣어두시면 되고요..
여기서 잠깐!!
책을 읽다가 한가지 공유하고 싶은 한마디가 있어서요 ㅋㅋ 쌩뚱맞지만 주위를 한번 환기(?)시키고 가시죠
캐린할러가 지은, "컬러의 힘"에는 아래 구절이 나옵니다.
"우리가 색에 얼마나 많이 의존하는지 알아보고 싶다면, 잠시동안 세상의 색이 모두 사라진다고 상상해보자!!"
(잠깐 눈감고 생각을 해보실까요? 저는 생각해봤는데 색이 없다면 모든 것이 무미 건조할것 같네요...
그래서 결론은 RColorBrewer 패캐지는 꼭! 설치하시고 로드하시길 추천드립니다. ㅎㅎ)
그럼, 오늘의 한마디 삼천포(?)에서 다시 본글로 넘어 올께요~~
이제 사전작업이 마무리 되었으니깐요...본격적으로 프로그래밍을 해보죠...
(참고로, 아래와 같이 진행할 건데요..)
텍스트 마이닝
사전설정하기
데이터준비및 불러오기
특수문자제거하기
가장 많이 사용된 단어 확인
명사추출하기
단어빈도표만들기
워드 클라우드 만들기
단어색상목록만들기
난수 고정하기
워드 클라우드 만들기
우선, 제가 작성한 텍스트 마이닝코드는 아래와 같습니다.
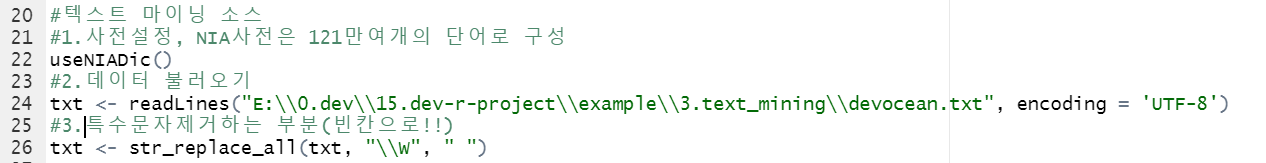
위의 텍스트 마이닝 관련 위의 코드를 간단하게 설명하자면요..
- NIA사전을 설정하는 부분이 존재하고요.. (22번줄)
- 부연설명하자면요.. NIA사전은 무려 121만여개의 단어로 구성되어 있고요
- 형태소 분석을 하는데 해당 사전을 이용합니다.
- 데이터를 불러오는 부분..(24번줄)
- readLines() 함수를 통해서 데이터를 불러오고요..
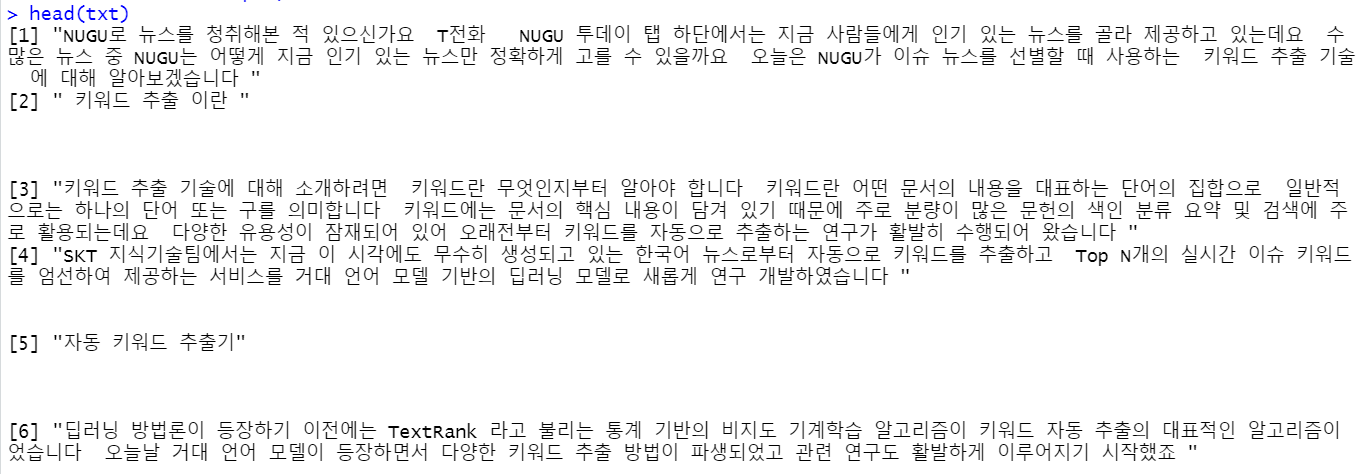
- head 함수를 사용하면 아래와 같이 정상적으로 텍스트를 로딩했는지 확인할 수 있고요..
아래는 head 와 tail 에 대해서 부연 설명인데요...한번꼭 타자처서 실행해보시길 추천드립니다. ㅎㅎ
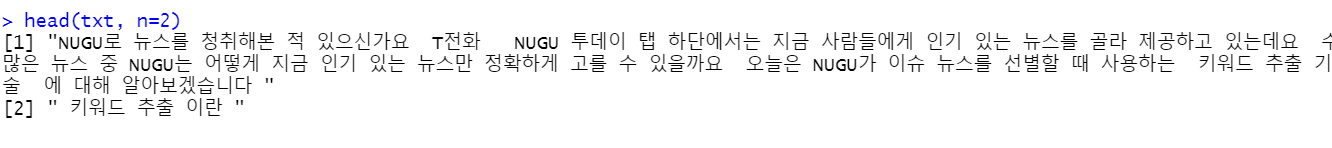
참고로, 위로부터 2줄만 보고 싶다그러면 아래와 같이 명령하시면 됩니다.
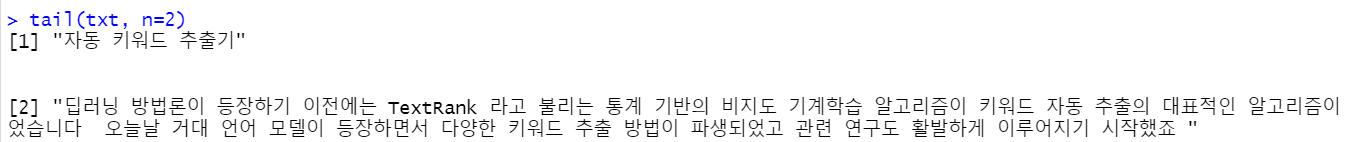
뒤에서 2줄은 tail 이겠죠?
- 마지막으로 특수문자제거하는 부분으로 구성되어 있습니다. (26번줄)
- stringr의 str_replace_all() 함수를 이용해서 문장에 들어있는 특수문자를 빈칸으로 수정합니다.
- 참고로, "\\W" 는 특수문자를 의미하는 정규표현식(Regular Expression) 이고요..
그럼, 드디어 가장 많이 사용된 단어를 확인하러 가 볼까요? 코드는 아래와 같습니다.
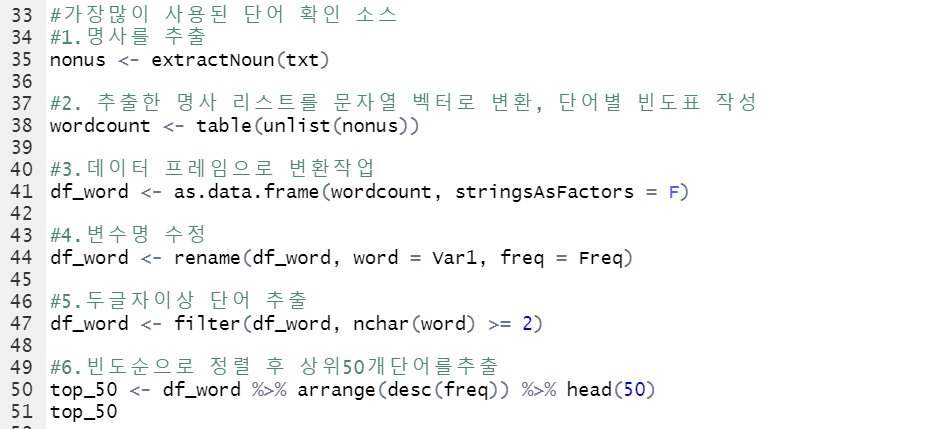
간단하게 소스를 정리해 보자면 요..아래와 같이 정리할 수 있겠군요..
- 명사추출하기
- 위의 소스 35줄을 보시면, extractNoun() 함수를 사용하시면 문장에서 명사를 추출하실 수 있고요..
- 단어빈도표만들기
- 38번줄에서 추출한 빈도표는 테이블구조니깐요..
- 41번줄에서 데이터 프레임으로 변환한거고요...(참고로 44번줄로 변수명도 수정해주었습니다. 사용하기 편리하게요 ㅎㅎ)
- 47번줄에서 두글자이상 단어를 추출했고요...
- 50번줄에서 빈도순으로 정렬후, 50개의 단어를 추출했습니다.
이제 간단하게 텍스트 마이닝은 끝났습니다. ㅎㅎ
(그럼 시각적으로 한눈에 확인하기위해서 워드 클라우드를 생성해볼건데요...이어서 보시죠~~)
그럼, 마지막으로 워드 클라우드를 만들어 보겠습니다.
워드클라우드로 생성하면 한눈에 바로 해당 글이 무엇을 중점으로 나타내고 있는지 확인할 수 있겠죠?
워드 클라우드 소스는 아래와 같고요..

제가 작성한 워드 클라우드 소스관련 위의 코드를 간단하게 설명 드리자면 요
- 단어색상목록만들기
- 55번줄에서 RColorBrewer 패캐지의 brewer.pal() 함수를 사용해서 단어의 색깔을 지정할 때 사용할 색상코드 목록을 만들고요..
- 참고로, Dark2 색상 목록에서 8개 색상을 추출하는 코드입니다.
- 난수 고정하기
- wordcloud() 함수는요 실행할 때마다 난수를 이용해서 매번 다른 모양의 워드 클라우드를 만들어내기때문에
57번줄을 사용해서 난수를 고정해서, 항상 동일한 워드클라우드가 생성되도록 합니다.
- 워드 클라우드 만들기
- 59번줄은 바로 워드클라우드를 만드는것이고요..wordcloud 의 파라미터들은 워드 클라우드 모양을 결정하게됩니다.
아래는 이해하기 쉽도록 주석을 한번 달아봤습니다.
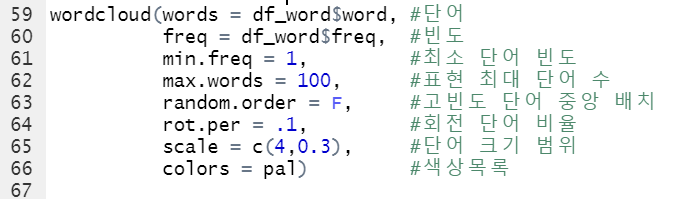
전체 소스는 아래와 같고요..
.libPaths("E:/0.dev/15.dev-r-project/Library")
Sys.setenv(JAVA_HOME='D:\\0.dev.framework\\openjdk-13.0.2_windows-x64_bin\\jdk-13.0.2')

# Install Package
install.packages("rJava")
install.packages("memoise")
remotes::install_github('haven-jeon/KoNLP', upgrade = "never", INSTALL_opts=c("--no-multiarch"), force = TRUE)
install.packages("stringr")
install.packages("wordcloud")

# Load Package
library(rJava)
library(KoNLP)
library(dplyr)
library(stringr)
library(RColorBrewer)
library(wordcloud)

#텍스트 마이닝 소스
#1.사전설정, NIA사전은 121만여개의 단어로 구성
useNIADic()
#2.데이터 불러오기
txt <- readLines("E:\\0.dev\\15.dev-r-project\\example\\3.text_mining\\devocean.txt", encoding = 'UTF-8')
head(txt)
tail(txt, n=2)
txt

#3.특수문자제거하는 부분(빈칸으로!!)
txt <- str_replace_all(txt, "\\W", " ")
txt

#가장많이 사용된 단어 확인 소스
#1.명사를 추출
nonus <- extractNoun(txt)

#2. 추출한 명사 리스트를 문자열 벡터로 변환, 단어별 빈도표 작성
wordcount <- table(unlist(nonus))

#3.데이터 프레임으로 변환작업
df_word <- as.data.frame(wordcount, stringsAsFactors = F)

#4.변수명 수정
df_word <- rename(df_word, word = Var1, freq = Freq)

#5.두글자이상 단어 추출
df_word <- filter(df_word, nchar(word) >= 2)

#6.빈도순으로 정렬 후 상위50개단어를추출
top_50 <- df_word %>% arrange(desc(freq)) %>% head(50)
top_50

#워드클라우드만들어보기
#1.단어색상목록생성
pal <- brewer.pal(8,"Dark2")
#2.난수고정하기
set.seed(1234)
#3.워드 클라우드 생성
wordcloud(words = df_word$word, #단어
          freq = df_word$freq,  #빈도
          min.freq = 1,         #최소 단어 빈도
          max.words = 100,      #표현 최대 단어 수
          random.order = F,     #고빈도 단어 중앙 배치
          rot.per = .1,         #회전 단어 비율
          scale = c(4,0.3),     #단어 크기 범위
          colors = pal)         #색상목록
위의코드를 RStudio를 통해서 실행해 보시면 아래와 같이 워드 클라우드를 만나실 수 있습니다.
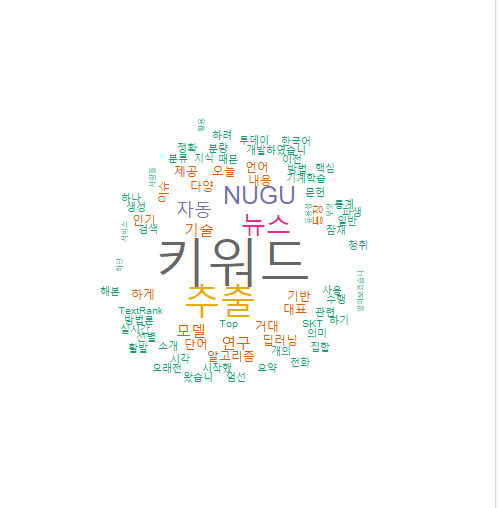
아무튼 오늘 블로그는 여기까지고요..
항상 믿고 봐주셔서 감사합니다..
결론
텍스트마이닝이란?
텍스트 마이닝은 문자로 된 데이터에서 가치있는 정보를 얻어내는 분석기법을 말합니다.
워드클라우드란?
워드클라우드는 많은 데이터들 중에서 특정한 키워드가 얼마나 더 중요한지 임팩트 있게 보여주는 것을 말합니다.
이제까지 R언어를 이용해서 글속에 주요 키워드를 분석해보았습니다.
긴글 읽어주셔서 진심으로 감사합니다.!!
다음에 더 좋은 컨텐츠로 찾아뵐 수 있도록 더욱 노력하는 제가 되겠습니다. !!
( I'll be back !! )
나의 목표 및 다짐을 항상 내곁에 두기
목표
나의 강점을 바탕으로 나의 일을 잘해냄으로써 타인과 사회를 아릅답게 만든다.
현재 내가 가진 능력으로 누군가에 도움이 될 수 있을까? 에 대해서 항상 생각하기
나는 블로그 생태계에서 IT 테크관련 파워블로거가 반드시 된다!
유튜브 시장(?)을 호령하는 100만 유튜버가 반드시 된다!! (feat. 100만 유튜버가 반드시 될 매직!!)
나는 꾸준히 공부하고 공부한것을 실천하는 창의적인 개발자가 된다.! (feat. devocean 개발&운영자가될 매직!!)
목표를 이루기 위한 실천방안
꾸준한 블로깅/기록법/독서법으로 넘버원이 아닌 온리원이 되보자.
천사불여일행(千思不如一行)을 항상생각하며 체화 및 각인시키자.
"천번 생각하는것보다 한번 행동하는 것이 더 중요하다."
기기일약 불능십보(騏驥一躍 不能十步) / 노마십가 공재불사(駑馬十駕 功在不舍)
천리마도 한번에 열걸음을 뛸 수 없고, 느리고 둔한말이라도 열흘이면 하룻길을 간다.
모든 실수에는 마술이 숨어 있다. 따라서 나는 실수하면 실수할수록, 그런 실수에서 더 많이 배울수록 삶에서 더 많은 마술을 갖는다.
매직 님의 최신 블로그
더보기-

- Koyeb 에 docker 로 나만의 서비스 배포하기
- 블로그 목적 Koyeb 플랫폼을 활용해 Docker로 나만의 서비스를 손쉽게 배포하는 방법에 대해서 공부및 정리후 나만의 노하우와 지식을 공유한다. 블로그 요약 1. Koyeb에 대해서 알아본다. 2. Koyeb 및 docker 를 활용해 간단하게 나만의 서비스를 배포하는 방법을 정리해본다. 블로그 상세내용 클라우드의 새로운 가능성? Koyeb과 Docker의 조합 클라우드 컴퓨팅 시대에 효율적이고 간단한 서비스 배포는 더 이상 선택이 아닌 필수가 되었습니다. 이번 블로그에서는 Koyeb 플랫폼을 활용해 Docker로 나만의 서비스를 손쉽게 배포하는 방법을 안내드립니다. Koyeb 소개? 왜 Koyeb인가? Koyeb은 서버리스 클라우드 플랫폼으로, 빠르고 간편하...
-

- Tmap OpenAPI 와 텔레그램 봇을 활용한 주변 맛집 검색 기능 간단 구현!
- 블로그 목적 Tmap OpenAPI 와 텔레그램 봇을 활용한 주변 맛집 검색 기능 구현에 대해서 공부및 정리후 나만의 노하우와 지식을 공유한다. 블로그 요약 1. Tmap OpenAPI 에 대해서 알아본다. 2. Tmap OpenAPI 와 텔레그램 봇을 활용한 주변 맛집 검색 기능을 간단하게 구현해 본다. 블로그 상세내용 요즘에 제가 Tmap OpenAPI 에 대한 관심이 생겨서 해당 OpenAPI를 공부해서 어떤 기능을 개인적으로 구현해 볼까? (고민하던 중 ....) 역시나 관심있게 보던 텔레그램 봇을 활용해서 내가 검색하고자 하는 위치의 맛집과 음식점들을 텔레그램 봇 메시지로 전송해보면 어떨까? 해서 바로 Tmap OpenAPI를 공부한 지식을 토대로 기능을...
-
- 첫공부! Rust 란 무엇인가? Hello world는 찍어봐야죠?
- 블로그 목적 Rust 에 대해서 공부및 정리 후 나만의 노하우와 지식을 공유한다 블로그 요약 Rust 에 대해서 정리해본다. Rust 를 통해서 첫 프로그램을 작성해본다. Hello World ? 블로그 상세내용 Rust 란 무엇인가? Rust는 현대적이고 안전한 시스템 프로그래밍 언어로, 메모리 안전성과 병행성을 강조하는 특징을 가지고 있다고 하네요. Mozilla에서 개발된 이 언어는 C나 C++과 같은 저수준 언어의 성능을 유지하면서도 메모리 안전성과 스레드 안전성을 보장한다고 하고요. 이러한 Rust의 특징은 시스템 프로그래밍, 웹 개발, 임베디드 시스템 등 다양한 분야에서 널리 사용되고 있다고 하니 개발자로써 한번 써봐야겠죠? 참고로 홈페이지는 아래와 같...
-
- Golang과 텔레그램 봇(bot)을 활용한 전송 기능 개발기
- 블로그 목적 Golang 과 텔레그램 봇(bot)을 활용한 오늘의 한마디 전송 기능에 대해서 공부및 정리 후 나만의 노하우와 지식을 공유한다. 블로그 요약 1. 텔레그램 봇(Bot)를 생성해본다. 2. Golang 을 사용해서 오늘의 한마디 openapi 를 연동하고 텔레그램 봇을 통해 메시지를 전송해본다. 블로그 상세내용 우선, 텔레그램 봇 부터 생성해 볼께요~ 아래와 같이 텔레그램 검색창에 @BotFather 를 검색해봅니다. 검색하면요.... 위와 같이 유사한 bot이 많이 나오는데요... 저는 가장 위에 나오는 @BotFather 를 선택해서 진행하도록 할께요~ 선택하면, 아래와 같이 나오고요.. 맨 하단의 START(시작) 을 클릭합니다. 시작버튼을 누르...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.