
로그인 선택
미리보기
커뮤니티

 23.06.15
글 등록
DEVOTEE를 활성화 시키면
지금 작성한 커뮤니티 글에 대해 1개의 댓글을 달아줍니다.
버튼을 누르면 글 수정 시 ChatGPT가 작성한 댓글이 수정됩니다.
임시저장함
최대 20건까지 저장합니다.
| 컨텐츠 유형 | 제목 | 저장일 | 삭제 |
|---|

본인인증
고객님의 소중한 개인정보보호를 위해
본인인증을 진행해주세요. 본인인증 미 진행 시 로그인이 제한됩니다.
본인인증 로그인에 실패하였습니다.
회원이 아니시거나 본인인증 등록이
완료되지 않은 사용자입니다.
회원정보 연결
5G DNA(Digital Network Automation) 기술 개발 - 논문 리뷰 (2) MTGNN

안녕하세요! 5G DNA* 기술 개발 (*Digital Network Automation)이라는 주제로 SKT AI Fellowship 4기에서 활동 중인 팀 DNA(다나와) 입니다.
이전 연구 계획 글에서 저희 팀의 목표는 네트워크로부터 수집 되는 빅데이터를 이용하여 고객의 체감을 개선하는 것으로, 이를 위해 서비스 품질 예측 모형을 개발하고자 한다고 전해드렸습니다. 특히, 해당 모델은 일반적으로 결과에 대한 설명이 불가능한 인공지능 모델에서 한 단계 발전하여 결과에 대한 설명이 가능하다는 점을 강조 드렸는데요, 이러한 모델을 구현해내기 위해 저희 팀에서는 다양한 관련 논문에 대해 survey를 진행하고 그 중 중요한 논문에 대해서는 내부 세미나를 진행하고 있습니다.
두번째로 저희가 공유해 드릴 논문의 제목은 Connecting the Dots: Multivariate Time Series Forecasting with Graph Neural Networks(KDD'20)입니다.
다변량 시계열 데이터를 통한 시계열 예측과 함께 변수들간의 uni-directive한 관계성을 파악할 수 있는 특징을 가지고 있습니다.
1.Introduction
해당 논문은 다변수 시계열 예측 문제를 다룰때는 본질적으로 변수들간의 interdependency가 있다고 가정합니다. 즉, 각 변수는 해당 변수의 과거 데이터 뿐만 아니라 다른 변수들에도 영향을 받는다고 생각합니다. 하지만 기존의 방법론들은 이러한 변수들간의 latent interdependency를 효과적으로 활용하지 못했다고 생각하여 그래프를 활용하여 문제를 해결하고자 합니다.
그래프는 서로 다른 entity간의 관계를 묘사하는 데이터의 특별한 형태로, 최근 그래프 구조를 통해 정보를 전파하여 그래프의 각 노드가 이웃 노드들의 context를 파악하는 Graph Neural Network (이하 GNN)가 주목받고 있습니다. GNN은 그래프를 통해 인공지능 모델에 대한 설명력을 제공합니다.
다변량 시계열은 자연스럽게 그래프의 관점으로 바라볼 수 있습니다. 각 변수들을 그래프에서 노드로 보고 hidden dependency relationship을 통해 상호 연결되어 있다고 생각하면 다변량 시계열을 GNN을 통해 모델링함으로 시계열간의 interdependency를 exploit하면서 temporal한 특성도 보존하는 것이 가능합니다.
다변량 시계열에 대해 가장 적합한 GNN은 spatial‐temporal GNN입니다. 다변량 시계열과 함께 외부의 그래프 구조를 input으로 입력 받는데, 이러한 구조 정보를 이용하지 않는 다른 방법론들에 비해 향상된 성능을 보입니다.
spatial‐temporal GNN을 사용한 기존 방법들도 두가지 단점이 존재합니다.
첫째로 해당 방법은 미리 정의된 그래프 구조에 많이 의존하는데 대부분의 다변수 시계열은 확실한 구조를 가지고 있지 않다는 점.
둘째로 모델을 학습할 때 사용하는 그래프 구조가 optimal한 그래프 구조가 아니고 학습 과정에서 update될 수 있다는 사실을 간과한다는 점입니다.
따라서 해당 논문은 모델의 학습과 그래프 구조의 학습을 end‐to‐end로 동시에 진행하는 방법인 MTGNN을 제안합니다. 자세한 구조는 Framework 챕터에서 설명 드리겠습니다.
2.Problem Formulation
을 time step t 에서의 N 개의 변수값이라고 하겠습니다.
P개의 time step에 대해 데이터가 주어졌다고 할 때 이고 목표는 Q step 뒤까지의 future value 를 예측하는 것입니다.
일반적으로 input은 시간,날짜 등의 auxiliary feature와 함께 사용될 수 있고 이러한 auxiliary feature를 concatenate한 표현은 이고, 로 D는 총 auxiliary feature의 차원입니다. (논문에서는 NxD로 표현되어 있지만 N+D라고 생각합니다.)
우리는 를 Y로 mapping하는 을 찾는것을 목표로 합니다. 이때 loss는 l2 regularization을 가지는 absolute loss입니다.
그래프와 관련된 notation은 아래와 같습니다.
그래프는 로 표현할 수 있고 는 노드들의 set, 는 edge들의 set입니다. 은 그래프에서 노드의 개수를 의미합니다.
를 노드라고 하고 를 u에서 v로 향하는 edge라고 하면, 노드 v의 이웃들은 로 표현 됩니다. 이는 v로 향하는 edge들의 시작점들로 생각할 수 있습니다.
Adjaceny matrix는 그래프의 수학적 표현으로 이고 으로 표현됩니다.
그래프 관점에서 보면 다변량 시계열에서 변수들은 노드이고, adjaceny matrix를 이용해서 노드들 간의 관계를 표현합니다. 변수들 사이의 관계성에 대한 명확한 지식이 없는 경우, 본 논문의 방법론은 인공지능을 통해 Adjacency matrix를 학습할 수 있다는 점에서 가치가 있습니다.
3.Framework of MTGNN
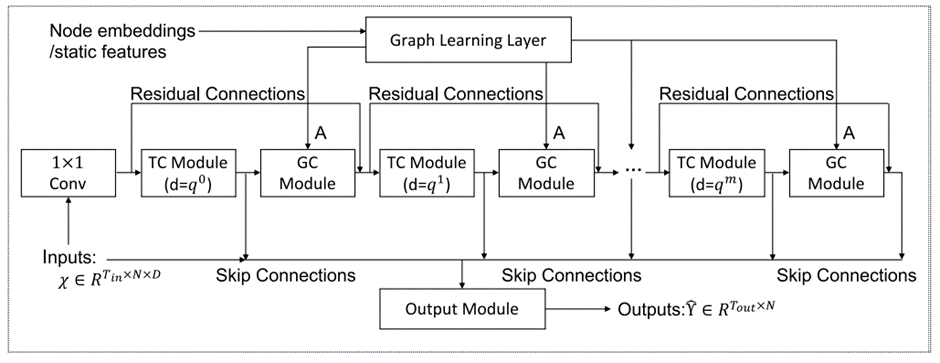
MTGNN은 앞서 말한 두 가지 단점을 해결하는 방법론을 제시합니다.
3가지 구성요소 Graph learning layer, Graph Convolution module(이하 GC), Temporal Convolution module(이하 TC)로 이루어져 있습니다.
첫 번째 단점을 해결하기 위해 Graph learning layer에서 데이터에 근거한 sparse graph adjacency matrix를 추출합니다.
추출한 matrix가 주어진 상태에서 변수들간의 spatial dependency를 다루기 위해 GC를, temporal pattern을 다루기 위해 TC를 제안합니다.
이때 TC와 GC가 서로 사이에 끼어지게 되는 구조를 가지며 gradient vanishing 문제를 해결하기 위해 residual connection이 TC의 input에서 GC의 output으로 더해지고, 각 TC가 끝날 때 마다 Skip connection이 더해집니다.
사용되는 모든 파라미터들이 gradient descent를 통해 학습이 가능하기 때문에 end‐to‐end로 다변량 시계열을 모델링함(GNN학습)과 동시에 내부의 그래프 구조도 학습할 수 있습니다. 이를 통해 두 번째 단점도 해결이 가능합니다.
이어서는 모듈 별 상세한 설명을 진행하도록 하겠습니다.
Graph learning layer
그래프를 만들기 위해 기존의 방법론 들은 노드 들 간의 similarity를 내적이나 Euclidean distance등의 distance metric을 이용했습니다.
이러한 방법론은 의 time and space complexity를 갖기 때문에 큰 그래프를 다루지 못하게 됩니다. 이를 해결하기 위해 sub‐graph structure를 학습하는 방법을 사용하는데 뒤의 Proposed Learning Algorithm에서 자세하게 다루도록 하겠습니다.
Distance metric의 다른 단점은 symmetric한 결과를 얻는다는 점입니다. 해당 논문은 어느 노드의 state변화가 다른 노드의 state변화를 일으킬 것이라고 기대했기 때문에 학습된 relation은 uni‐directional 해야 한다고 생각했습니다. 따라서 해당 graph learning layer는 아래와 같이 uni‐directional한 relationship을 추출하도록 제안 되었습니다.
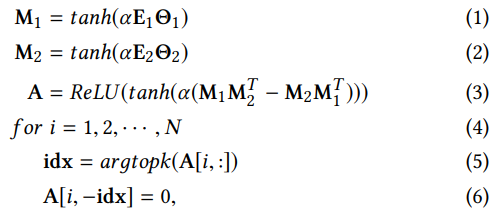
여기서 는 학습이 가능한 랜덤하게 initialized된 노드 embedding이고 는 모델의 파라미터, 는 activation function의 saturation정도를 조절하는 하이퍼 파라미터입니다. 을 통해 각 행백터들에 대해 topk개의 largest value에 대응하는 index를 추출합니다.
eq3에서 와 RELU를 통해 만약 가 positive하면 는 0이 되도록하여 해당 논문에서 학습되는 graph adjacency matrix A는 asymmetric한 특성을 잘 가집니다.
eq5‐6에서 각 노드에 대해 가까운 k개의 이웃을 제외한 나머지의 weight를 0으로 하여 이어지는 GC에서 연산량을 줄이게끔 해줍니다.
추가적으로 Graph learning layer의 input은 꼭 node embedding(E)가 아니여도 됩니다. 각 노드들에 대한 특성이 주어져있다면 static feature matrix Z로 대체하여도 됩니다. ()
adjacency matrix A가 asymmetric하기 때문에 bi‐directional한 경우보다 더 우수한 설명력을 가진다고 볼 수 있습니다.
Graph Convolution Module
GC는 그래프에서 spatial dependency를 다루기 위해 특정 노드의 정보와 해당 노드 이웃의 정보를 합치는 것을 목표로 합니다. GC의 구조는 노드를 통해 얻어지는 Inflow 정보와 outflow정보를 다루는 2개의 mix‐hop propagation layer로 이루어져 있습니다.
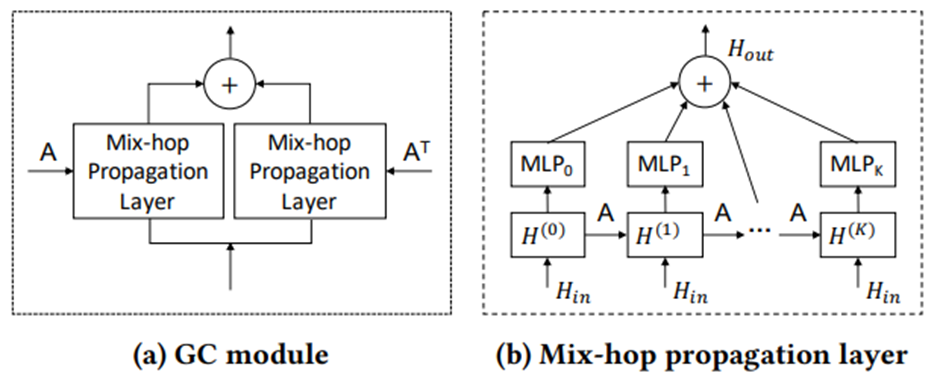
Mix‐hop propagation layer
A가 주어진채로 spatially dependent한 노드들간의 정보 흐름을 다루기 위해 제안된 layer입니다.
해당 layer는 information propagation step과 information selection step으로 구성됩니다.
Information propagation step은 로 표현되는데 이때 는 노드의 original state를 유지하는 정도를 결정하는 hyper parameter이고 , 입니다.
Information selection step은 로 표현되는데 이때 으로 이전 layer에서 얻어진 hidden sate를 의미합니다.
즉, horizontal하게 정보를 전파시키고 이를 vertical하게 select한다고 볼 수 있습니다.
각 step에 대해 좀 더 자세하게 살펴보면 Information propagtion step과정은 graph 구조에 따라 reculsive하게 노드 정보를 propagate하는 과정 입니다. 이때의 심각한 단점은 많은 layer를 가질 경우 random walk’s limit distribution에 도달하기 때문에 첫 노드 state와 상관없이 노드의 hidden state가 하나의 point로 수렴한다는 점입니다. 따라서 Information propagation step은 eq7에서 볼 수 있듯이 propagation 과정에서 노드의 original state을 일부 보존하는 방식을 사용합니다. 이를 통해 locality를 보존함과 동시에 deep한 이웃들에 대한 정보까지 담을 수 있습니다.
하지만 만약 이렇게 Information propagation step만 진행할 경우 노드 정보가 일부 왜곡될 수 있습니다. 예를 들어 노드 들 간의 spatial dependency가 전혀 존재 하지 않는 극단적인 상황이라고 하면, eq7의 propagation을 통해 이웃 정보를 aggregating하는 것은 단순히 각 노드에 필요 없는 noise를 더하는 상황밖에 되지 않습니다.
따라서 해당 논문에서는 Information selection step을 도입하여 각 hop에서 생성된 중요한 정보를 필터링 하는 과정을 추가하였습니다. 이를 통해 앞의 예시 상황에서도 를 통해 original 노드의 정보를 온전하게 보존할 수 있습니다.
Temporal Convolution Module
TC는 2개의 dilated inception layer로 구성되어 있습니다. 한 layer는 tanh의 activation function로 이어지고 통과 후 정보에 대해 필터 역할을 하고, 나머지 하나는 sigmoid의 activation function로 이어지고 필터링 된 정보를 다음 모듈로 얼만큼 넘길 건지를 조절하는 역할을 합니다.
각 dilated inception layer 에서는 high‐level temporal feature들을 추출하기 위해 standard dilated 1D convolution filter들을 적용합니다.
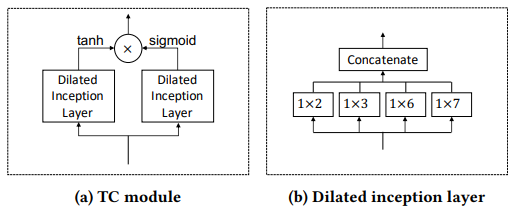
Dilated Inception Layer
다양한 범위의 pattern을 다루고 긴 sequence를 다루기 위해 convolutional neural network에서 주로 쓰는 방법인 multiple size의 filter를 사용하는 dilated convolution을 적용하였습니다. 이때 몇 가지 문제점들이 존재합니다.
첫 번째 문제는 적절한 kernel size의 선택입니다.
이미지 처리에서는 1x1,3x3,5x5의 kernel size를 가지는 2D convolution filter의 output을 concatenate하는 전략을 사용하는데 이를 inception이라고 부릅니다. 이러한 inception의 input을 2D의 이미지에서 1D의 시계열으로 바꾸면 1x1,1x3,1x5의 filter size를 가지게 되는데 이는 7,12,24,28,60 등의 내재적인 period를 가지는 temporal signal에 본질적으로 적합하지 않습니다. 따라서 해당 논문에서는 1x2,1x3,1x6,1x7의 filter size로 구성된 temporal inception layer를 제안합니다. 앞서 언급한 period들은 이러한 filter의 조합으로 다룰 수 있게 됩니다. 예를 들어 모델은 첫번째 temporal inception layer로부터 1x7 filter를 ,두번째 temproal inception layer에서 1x6 filter를 통과시킴으로 period 12를 표현할 수 있습니다.
두번째 문제는 convolutional network의 receptive field size는 네트워크의 깊이와 필터의 kernel size에 따라 선형적으로 증가한다는 점입니다.
kernel size가 c인 1D convolution layer m개를 가지는 일반적인 convolutional network를 고려하면 해당 네트워크의 receptive field size R은 입니다. 즉, 매우 긴 sequence를 다루기 위해서는 deep한 network 혹은 매우 큰 filter가 필요하다는 것을 알 수 있습니다. 이는 모델의 complexity를 크게하기 때문에 대신, dilated convolution을 채택하였습니다.
Dilated convolution은 특정 frequency의 down‐sampled input에 대해 standard convolution filter를 사용하는 것을 말합니다.
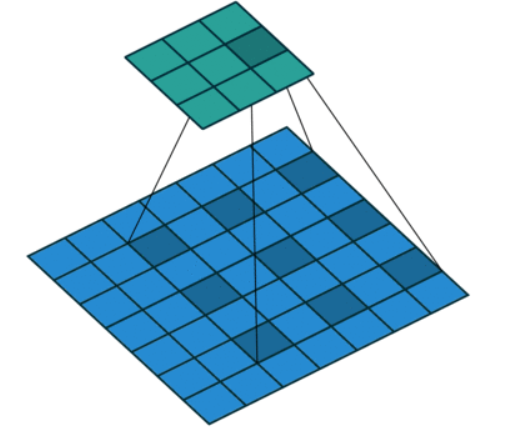
예를 들어 dilation factor가 2라면 위 이미지와 같이 input의 매 2 step들에 대해 standard convolution을 적용합니다.
해당 논문은 각 layer 마다 dilation factor가 q의 rate로 지수적으로 증가하게 하여 receptive field size도 로 지수적으로 증가하게 하여 dilation을 사용하기 전보다 훨씬 긴 sequence를 다룰 수 있게 합니다.
Dilated Inception Layer를 통과하는 과정은 으로 4개의 필터링 결과 중 가장 큰 결과를 기준으로 truncated 된 후 concatenated됩니다. 이 때 는 dilated convolution으로 로 표현됩니다.(d는 dilation factor)
결과적으로 해당 논문에서의 Dilated Inception Layer는 이미지 데이터에 주로 사용되는 inception과 dilation 개념을 시계열 데이터에 적절하게 적용되도록 한 모듈로 생각할 수 있습니다.
Skip connection Layer & Output Module
Skip connection Layer
앞서 매 TC모듈 이후 skip connection layer가 진행 된다고 하였는데 i번째 skip connection layer에서 의 standard convolution을 진행합니다.
는 i번째 layer의 input의 길이로, 의 standard convolution을 통과하면 input의 길이와 상관 없이 길이가 1인 값을 얻게 됩니다.
Output Module
2개의 1x1 standard convolution layer로 구성됩니다.
이를 통해 input의 dimension을 원하는 크기의 output dimension으로 만들어 줍니다. 이를 통해 단 한 개의 future step을 예측하고 싶다면 ouput dimension을 1로, Q개의 step을 예측하고 싶다면 Q가 되게끔 설정하여 조절할 수 있습니다.
Proposed Learning Algorithm
일반적으로 그래프를 학습하는 과정(graph learning layer)은 모든 노드의 intermediate state를 메모리에 보관하는 것을 필요로 합니다. 그렇기 때문에 만약 그래프가 크다면 메모리 overflow를 야기합니다.
따라서 해당 논문에서는 학습 iteration마다 랜덤하게 노드 들을 몇 개의 그룹으로 나눈 후 이렇게 나눠진 sub‐graph structure를 학습하는 알고리즘을 사용합니다.
랜덤하게 나누어지기 때문에 모든 노드가 다른 노드와 하나의 그룹에 속할 확률이 존재하므로, 노드 간의 similarity 가 모두 계산되고 업데이트 될 수 있습니다. 추가적으로 노드를 s개의 그룹으로 나눴기 때문에 time and space complexity가 매 iteration마다 에서 으로 줄여주는 효과를 가집니다.
또한 해당 논문에서는 multi‐step forecasting task에서 long‐term prediction이 short‐term prediction보다 모델 performance측면에서 더 나은 결과를 얻게 되는 경우를 종종 볼 수 있는데, 이를 long‐term prediction이 short‐term prediction보다 더 높은 loss를 생성하는데 이러한 loss를 줄이기 위해 모델이 long‐term prediction의 accuracy를 향상 시키는데 더 집중하기 때문이라고 주장합니다. 따라서 이러한 문제를 해결하기 위해 curriculum learning strategy라는 것을 제안합니다.
해당 알고리즘은 easiest 문제를 푸는 것 즉, next one‐step only를 예측하는 것으로 시작하여 iteration이 증가함에 따라 모델의 prediction length를 점진적으로 늘려나가는 방법을 사용합니다. 이러한 방법을 통해 multi‐step forecasting에서 long‐term 과 short‐term prediction에 대해 균형 잡힌 성능을 만들어 냅니다.
제안된 모델 MTGNN의 성능은 통계적 모델인 Auto‐Rregressive model,Gaussian Process model과 RNN,GRU,LSTM등 딥러닝 기반 모델들에 대해 single‐step 과 multi‐step forecasting을 진행했을때 준수한 성능을 기록하였습니다. 정확한 성능은 생략하고 해당 논문에서 제안한 MTGNN을 통해 학습이 된 graph가 얼마나 잘 학습이 되는가를 마지막으로 살펴보고 마무리하고자 합니다.
3.Study of the Graph Learning Layer
traffic prediction에 사용되는 데이터인 METR‐LA dataset을 활용하여 실험을 진행하였는데 먼저 다양한 수식을 통해 graph adjacency matrix A를 형성하고 그에 대한 성능을 비교하였습니다.
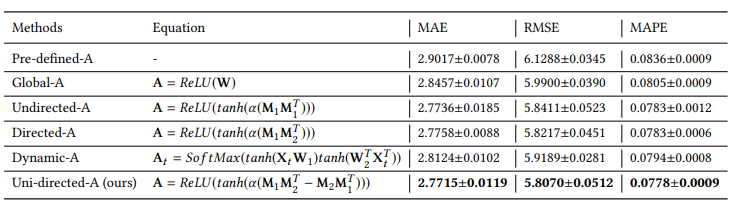
다른 graph learning방법으로 predefined‐A는 데이터셋에서 노드간의 distance에 의해 만들었고 Global‐A는 N2개의 파라미터를 가지는 parameter matrix를 가정하여 만들었고 Unidirected‐A와 Directed‐A는 node embedding의 similarity score를 통해 계산됐습니다. 마지막으로 Dynamic‐A는 각 time step의 spatial dependency가 노드 input에 의존적이라고 가정하여 만들어졌습니다.
성능 표를 확인해보면 해당 논문에서 제안하는 방법이 다른 방법론들에 비해 좋은 성능을 가짐을 확인할 수 있었습니다. 또한 학습된 A를 살펴보기 위해 진행한 case study를 보면 다음과 같습니다.
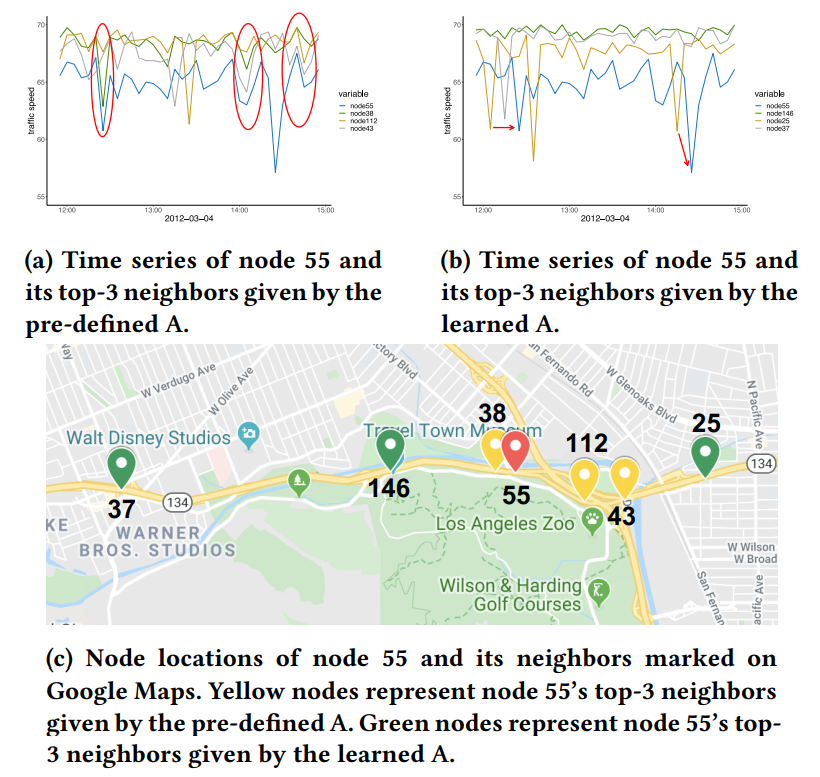
Figure (a)에서는 node 55와 pre‐defined된 그래프에서의 3개의 이웃의 시계열 데이터를 plotting한 것이고 Figure (b)에서는 학습된 그래프에서 얻어진 3개의 이웃과의 시계열 데이터를 plotting 한 이미지입니다. Figure (c)는 노드들의 geo‐location을 나타낸 것인데 노란색 노드는 pre‐defined된 그래프에서의 3개의 이웃노드, 초록색 노드는 학습된 그래프에서의 3개의 이웃노드 입니다.
pre‐defined된 그래프에서의 이웃노드들이 지도상에서 중심 노드와 더 가까운 반면에 학습된 그래프에서의 3개의 이웃노드들은 중심 노드와 멀어진 대신에 같은 도로상에 위치한다는 것을 알 수 있습니다.
traffic prediction이라는 목적하에서는 거리상 가까운 이웃노드들 보다 같은 도로상의 위치한 이웃노드들이 더 의미가 있음으로 학습된 그래프가 pre‐defined된 그래프보다 적절하다고 생각할 수 있습니다.
이렇게 두 번째 내부 세미나 논문인 MTGNN에 대한 리뷰를 마무리 짓겠습니다.
일반적인 통계적 모델을 사용할 때와 달리 Stationary가정이 필요 없는 딥러닝 모델, 그중에서도 관계성 파악에 있어 좋은 성능을 보인다는 Graph Neural Network를 이용했다는 점과 변수 간의 uni-directive한 관계성을 얻는다는 점에서 본 연구팀의 연구 방향성과 일치하였고, 위 논문 리뷰 및 구현을 통해 많은 인사이트를 얻을 수 있었습니다.
무선망 데이터의 성질, 산업현장의 도메인 지식과 같이 다양한 요소를 반영하고, 실질적인 Pain point를 해결하기 위해 다나와 팀은 다양한 논문들에 대해 리뷰를 열심히 진행하고 있습니다. 이에 대한 내용도 계속 블로깅을 진행할 예정이니 많은 관심 부탁드립니다. 감사합니다!
팀원소개
Reference
Wu, Z., Pan, S., Long, G., Jiang, J., Chang, X., & Zhang, C. (2020, August). Connecting the dots: Multivariate time series forecasting with graph neural networks. In Proceedings of the 26th ACM SIGKDD international conference on knowledge discovery & data mining (pp. 753-763).
Dilation 이미지
https://zzsza.github.io/data/2018/02/23/introduction-convolution/
hwangyj9 님의 최신 블로그
더보기-
- 5G DNA(Digital Network Automation) 기술 개발 - 연구결과 (3)
- 안녕하세요! 5G DNA* 기술 개발 (*Digital Network Automation)이라는 주제로 SKT AI Fellowship 4기에 참여하게 된 팀 DNA(다나와) 입니다. 프로젝트를 시작한게 엊그제 같은데 벌써 5개월간의 여정이 마무리 되었습니다. 중간 과정(2) 글에서 저희가 개발한 모델에 대한 상세한 설명을 드렸었기 때문에 이번 글에서는 달라진 점과 좀 더 넓은 관점에서를 중점으로 그동안의 연구 내용을 설명드리고자 합니다. 연구 목표 이전 글을 통해 저희의 연구 목표는 설명가능한 인공지능을 통한 무선망 운용 최적화라고 말씀드렸습니다. 망 안정성 확보를 위해서 선제적 무선망 품질관리가 필수적입니다. 저희는 선제적 무선망 품질관리를 달성하기 위해 예측...
-

- 5G DNA(Digital Network Automation) 기술 개발 - 연구과정(2)
- 안녕하세요! 5G DNA* 기술 개발 (*Digital Network Automation)이라는 주제로 SKT AI Fellowship 4기에 참여하게 된 팀 DNA(다나와) 입니다. 프로젝트를 시작한게 엊그제 같은데 벌써 중반부를 넘어가고 있습니다. 처음 연구계획 글을 작성할 때만 하더라도 추상적으로 "어떠어떠한 특징을 가진 모델을 만들겠다" 정도를 보여드린 것 같은데 이러한 모델을 만들기 위해 다양한 관련 논문 survey 및 회의를 통해 어느정도 목적을 이룬 저희 팀의 모델을 완성하였고, 이에 대한 중간 발표까지 마치게 되어 기쁩니다. 저희 팀의 경우 현재 저희 모델을 만들어 내기까지 survey한 논문들 중 중요한 논문들에 대해 이해가 뒷받침될 수 있도록 ...
-

- 5G DNA(Digital Network Automation) 기술 개발 - 논문 리뷰 (3) VAE
- 안녕하세요! 5G DNA* 기술 개발 (*Digital Network Automation)이라는 주제로 SKT AI Fellowship 4기에서 활동 중인 팀 DNA(다나와) 입니다. 이전 연구 계획 글에서 저희 팀의 목표는 네트워크로부터 수집 되는 빅데이터를 이용하여 고객의 체감을 개선하는 것으로, 이를 위해 서비스 품질 예측 모형을 개발하고자 한다고 전해드렸습니다. 특히, 해당 모델은 일반적으로 결과에 대한 설명이 불가능한 인공지능 모델에서 한 단계 발전하여 결과에 대한 설명이 가능하다는 점을 강조 드렸는데요, 이러한 모델을 구현해내기 위해 저희 팀에서는 다양한 관련 논문에 대해 survey를 진행하고 그 중 중요한 논문에 대해서는 내부 세미나를 진행하고 있습...
-

- 5G DNA(Digital Network Automation) 기술 개발 - 논문 리뷰 (2) MTGNN
- 안녕하세요! 5G DNA* 기술 개발 (*Digital Network Automation)이라는 주제로 SKT AI Fellowship 4기에서 활동 중인 팀 DNA(다나와) 입니다. 이전 연구 계획 글에서 저희 팀의 목표는 네트워크로부터 수집 되는 빅데이터를 이용하여 고객의 체감을 개선하는 것으로, 이를 위해 서비스 품질 예측 모형을 개발하고자 한다고 전해드렸습니다. 특히, 해당 모델은 일반적으로 결과에 대한 설명이 불가능한 인공지능 모델에서 한 단계 발전하여 결과에 대한 설명이 가능하다는 점을 강조 드렸는데요, 이러한 모델을 구현해내기 위해 저희 팀에서는 다양한 관련 논문에 대해 survey를 진행하고 그 중 중요한 논문에 대해서는 내부 세미나를 진행하고 있습...

DEVOTEE를 활성화 시키면
지금 작성한 댓글에 AI가 댓글을 달아줍니다.